8장 — 분배함수와 자유에너지
이 장의 물음
VAE(변분 자기부호화기)를 한 번이라도 학습해 본 사람은 그 손실 함수가 두 항으로 되어 있다는 것을 안다. 디코더가 입력을 얼마나 잘 되살리는지 재는 재구성 항과, 인코더가 내놓은 잠재변수의 분포가 사전분포 N(0, I)에서 얼마나 멀어졌는지 재는 KL 항이다. 이 둘의 합에 마이너스를 붙인 양을 ELBO(evidence lower bound)라 부르고, 교과서는 이것이 데이터의 로그우도 ln p(x)의 하한이라고 가르친다. 그런데 왜 하필 이 두 항일까? 하한과 참값 사이의 틈은 무엇이고, KL 항 앞에 계수 β를 붙이는 β-VAE는 대체 무엇을 조절하는 걸까?
이 물음에 답하려면 조금 멀리 돌아가야 한다. 이 장은 다음 물음들에 차례로 답하면서 VAE의 손실로 돌아온다.
- 볼츠만 분포에서 상태 하나는 에너지가 낮을수록 흔한데, 실제로 관찰되는 에너지는 왜 가장 낮은 에너지가 아닐까?
- 우리가 정규화 상수라며 나눠 버리던 합 Z의 로그는 그 관찰되는 에너지에 대해 무엇을 알고 있을까?
- 볼츠만 분포가 아닌 분포, 이를테면 인코더가 내놓는 분포에도 같은 잣대를 댈 수 있을까?
- 고차원 가우시안에서 뽑은 샘플의 에너지 ‖x‖²/2는 왜 확률밀도가 가장 높은 원점이 아니라 d/2 근처에 모일까?
- 분류기가 매번 계산하고 버리던 logsumexp는 입력에 대해 무엇을 말해 줄까?
역사: 꺼내 쓸 수 있는 에너지, 제곱 항마다 같은 몫
이 장의 두 주인공인 자유에너지와 등분배 정리는 19세기 후반에 따로 자랐다. 앞의 것은 화학 반응에서 일을 얼마나 뽑아낼 수 있느냐는 실용적인 질문에서, 뒤의 것은 기체 분자들이 에너지를 어떻게 나눠 갖느냐는 이론적인 질문에서 나왔다. 그 흐름을 연도순으로 정리하면 다음과 같다.
| 연도 | 사람 | 내용 |
|---|---|---|
| 1845 | 워터스턴 | 섞인 기체에서 분자들의 평균 운동에너지가 같다는 기체 운동론 논문을 왕립학회에 냈으나 거절됨 |
| 1860~1876 | 맥스웰, 볼츠만 | 운동의 종류(자유도)마다 평균 에너지가 같다는 등분배 정리를 세움 |
| 1882 | 헬름홀츠 | 「화학 과정의 열역학」에서 에너지를 「자유에너지」와 「묶인 에너지」로 나눔 |
| 1892 | 레일리 | 왕립학회 문서고에서 워터스턴의 논문을 찾아 출간 |
| 1900 | 켈빈 | 왕립연구소 강연에서 등분배 정리를 열과 빛의 동역학 이론 위에 드리운 두 구름 가운데 하나로 꼽음 |
| 1902 | 깁스 | 『통계역학의 기본 원리』에서 정준 분포를 e^((ψ − ε)/Θ)로 적음 |
| 1998 | 닐, 힌턴 | EM 알고리즘을 「음의 자유에너지를 닮은 함수」의 번갈아 최대화로 해석 |
| 2013 | 킹마, 웰링 | VAE. 신경망 인코더와 재매개화로 ELBO를 직접 경사 상승 |
헬름홀츠는 전지처럼 온도가 거의 변하지 않은 채 화학 반응이 전기 일을 해내는 장치를 보고, 반응이 내놓는 에너지 가운데 일로 바꿀 수 있는 몫과 그렇지 않은 몫을 구별해야 한다고 생각했다. 1882년 베를린 학술원에 낸 논문에서 그는 앞의 것을 자유에너지(freie Energie), 뒤의 것을 묶인 에너지(gebundene Energie)라 불렀고, 온도가 일정할 때 저절로 일어나는 변화는 자유에너지가 줄어드는 쪽으로만 간다는 결론을 얻었다. 오늘날의 식으로 쓰면 묶인 에너지가 TS이고 자유에너지가 E − TS다. 에너지 가운데 온도 × 엔트로피만큼은 열의 형태로 주변과 얽혀 있어서 마음대로 꺼내 쓸 수 없다는 뜻이니, 「자유」는 「꺼내 쓸 수 있는」이라는 뜻의 이름이었던 셈이다.
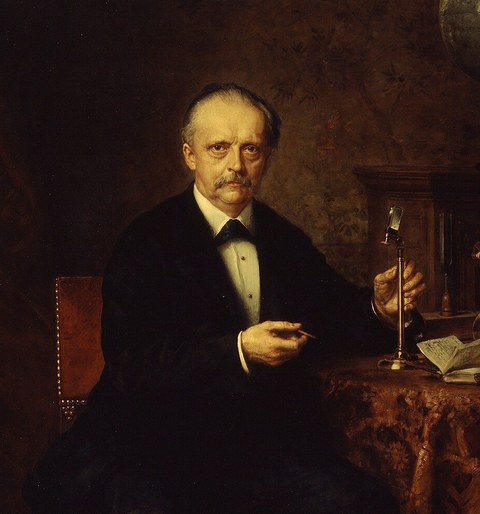
20년 뒤 깁스는 정준 분포를 오늘날처럼 「볼츠만 인자를 Z로 나눈 것」으로 쓰지 않고, 확률을 e^((ψ − ε)/Θ)로 적은 뒤 합이 1이 되도록 상수 ψ를 정했다(ε는 에너지, Θ는 오늘날의 kT). 깁스에게 정규화 상수는 나눠 버리는 숫자가 아니라 지수 안에서 에너지와 나란히 서는 에너지였고, 이 장에서는 그 ψ가 헬름홀츠의 자유에너지와 같은 양이라는 것을 확인한다.
등분배 정리가 걸어온 길은 덜 순탄했다. 스코틀랜드의 기술자 워터스턴은 1845년, 섞인 기체에서 무거운 분자와 가벼운 분자의 평균 운동에너지가 같다는 내용을 담은 논문을 왕립학회에 보냈다. 심사위원은 「이 논문은 헛소리일 뿐」이라는 평을 남겼다고 전해진다. 논문은 문서고에 묻혔다가 워터스턴이 세상을 떠난 뒤인 1892년에야 레일리가 찾아내 출간했다. 그사이 맥스웰과 볼츠만은 같은 결론을 일반화해 에너지에 제곱으로 들어가는 변수 하나마다 평균 에너지가 ½kT씩 돌아간다는 등분배 정리를 세웠는데, 이 정리로 기체의 비열을 계산하면 측정값과 맞지 않았다. 분자가 진동할 수 있다면 진동의 몫까지 비열에 더해져야 하는데 실제 비열은 그보다 작았던 것이다. 켈빈은 1900년 4월 강연에서 이 어긋남을 19세기 물리학의 하늘에 남은 두 구름 가운데 하나로 꼽았고, 이 구름은 에너지가 덩어리로만 오가는 양자역학이 나온 뒤에야 걷혔다. 등분배 정리가 언제 맞고 언제 틀리는지는 이 장의 대화 연습에서 직접 따져 본다.
표의 마지막 두 줄은 ML의 이야기다. 닐과 힌턴은 1998년 논문 초록에 「음의 자유에너지를 닮은 함수를 제시하고, M 단계는 이 함수를 모델 매개변수에 대해, E 단계는 관측되지 않은 변수의 분포에 대해 최대화한다는 것을 보인다」고 적었다. 15년 뒤 킹마와 웰링의 VAE는 같은 함수를 신경망으로 최대화했고, 그 함수가 오늘날 ELBO라 부르는 양이다.
작은 문제: 에너지와 경우의 수의 겨루기
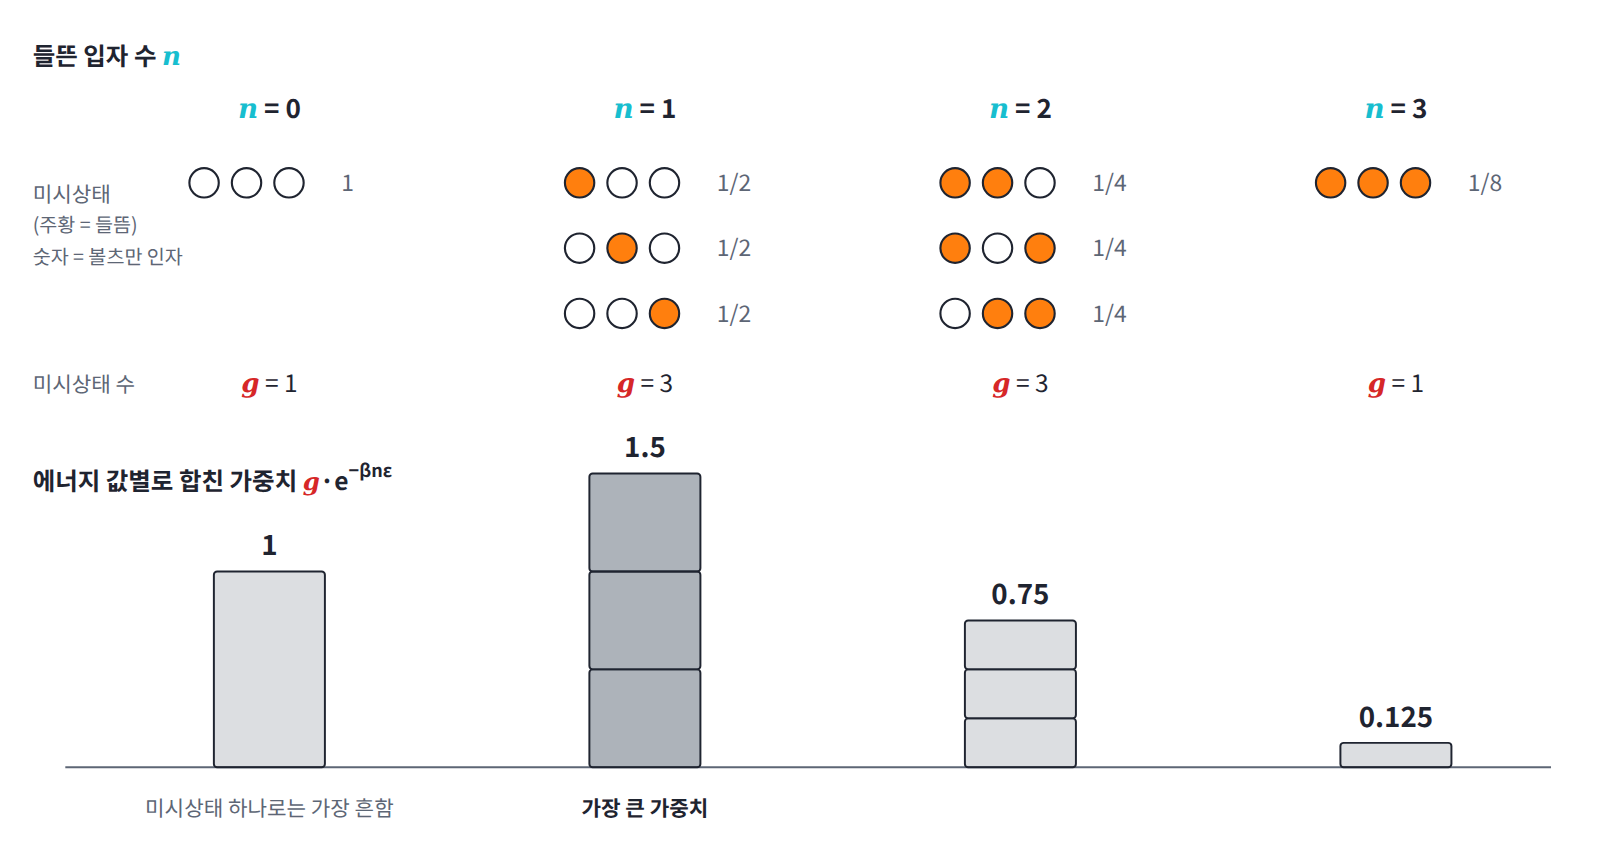
에너지 0인 바닥 상태와 에너지 ε인 들뜬 상태, 이렇게 두 상태만 가질 수 있는 입자 N개가 온도 T인 열원과 맞닿아 있다고 하자. 입자끼리는 에너지를 주고받지 않는다. 계산을 쉽게 하려고 βε = ln 2인 온도, 곧 들뜬 상태의 볼츠만 인자 e^(−βε)가 정확히 1/2인 온도를 고른다.
입자가 세 개이면 미시상태는 2³ = 8개다. 미시상태 하나하나로 보면 모두 바닥 상태인 미시상태의 볼츠만 인자가 1로 가장 크고, 입자 하나가 들뜬 미시상태는 1/2로 그 절반이다. 그런데 입자 하나가 들뜬 미시상태는 세 개이므로, 에너지가 ε인 쪽의 가중치는 합쳐서 3 × 1/2 = 1.5가 되어 바닥 상태의 1을 이긴다. 에너지 값별로 정리하면 다음과 같다.
| 들뜬 입자 수 n | 미시상태 수 g | 볼츠만 인자 e^(−βnε) | 가중치 g·e^(−βnε) | 점수 ln g − βnε |
|---|---|---|---|---|
| 0 | 1 | 1 | 1 | 0 |
| 1 | 3 | 0.5 | 1.5 | 0.405 |
| 2 | 3 | 0.25 | 0.75 | −0.288 |
| 3 | 1 | 0.125 | 0.125 | −2.079 |
마지막 열은 가중치의 로그다. 로그를 취하면 곱이 합으로 바뀌어서, 에너지 값마다 경우의 수가 주는 점수 ln g와 에너지가 매기는 벌점 βnε가 따로 보인다. 에너지를 올리면 벌점이 늘지만 그만큼 상태의 수도 늘어 점수를 벌어 온다. 이 차이를 앞으로 에너지 값의 「점수」라 부르자. 점수가 가장 큰 에너지 값이 가장 자주 관찰되며, 여기서는 n = 1이다.
입자를 30개로 늘려 같은 계산을 하면 다음 표를 얻는다. 입자들이 서로 독립이라 분배함수는 입자 하나의 분배함수를 거듭제곱한 Z = (1 + e^(−βε))^N = 1.5^N이고, 마지막 열의 확률은 가중치를 이 Z로 나눈 것이다.
| n | ln g | −βnε | 점수 | 확률 |
|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0.0000 |
| 5 | 11.867 | −3.466 | 8.401 | 0.0232 |
| 9 | 16.476 | −6.238 | 10.238 | 0.1457 |
| 10 | 17.218 | −6.931 | 10.287 | 0.1530 |
| 11 | 17.816 | −7.625 | 10.191 | 0.1391 |
| 15 | 18.860 | −10.397 | 8.462 | 0.0247 |
| 20 | 17.218 | −13.863 | 3.355 | 0.0001 |
| 30 | 0 | −20.794 | −20.794 | 0.0000 |
에너지만 보면 n = 0이 가장 좋고, 경우의 수만 보면 절반이 들뜬 n = 15가 가장 좋다. 실제 승자는 그 사이의 n = 10, 곧 입자의 3분의 1이 들뜬 상태다. 입자 하나가 들떠 있을 확률이 1/(1 + e^(βε)) = 1/3이었으니 당연한 결과이기도 하다.
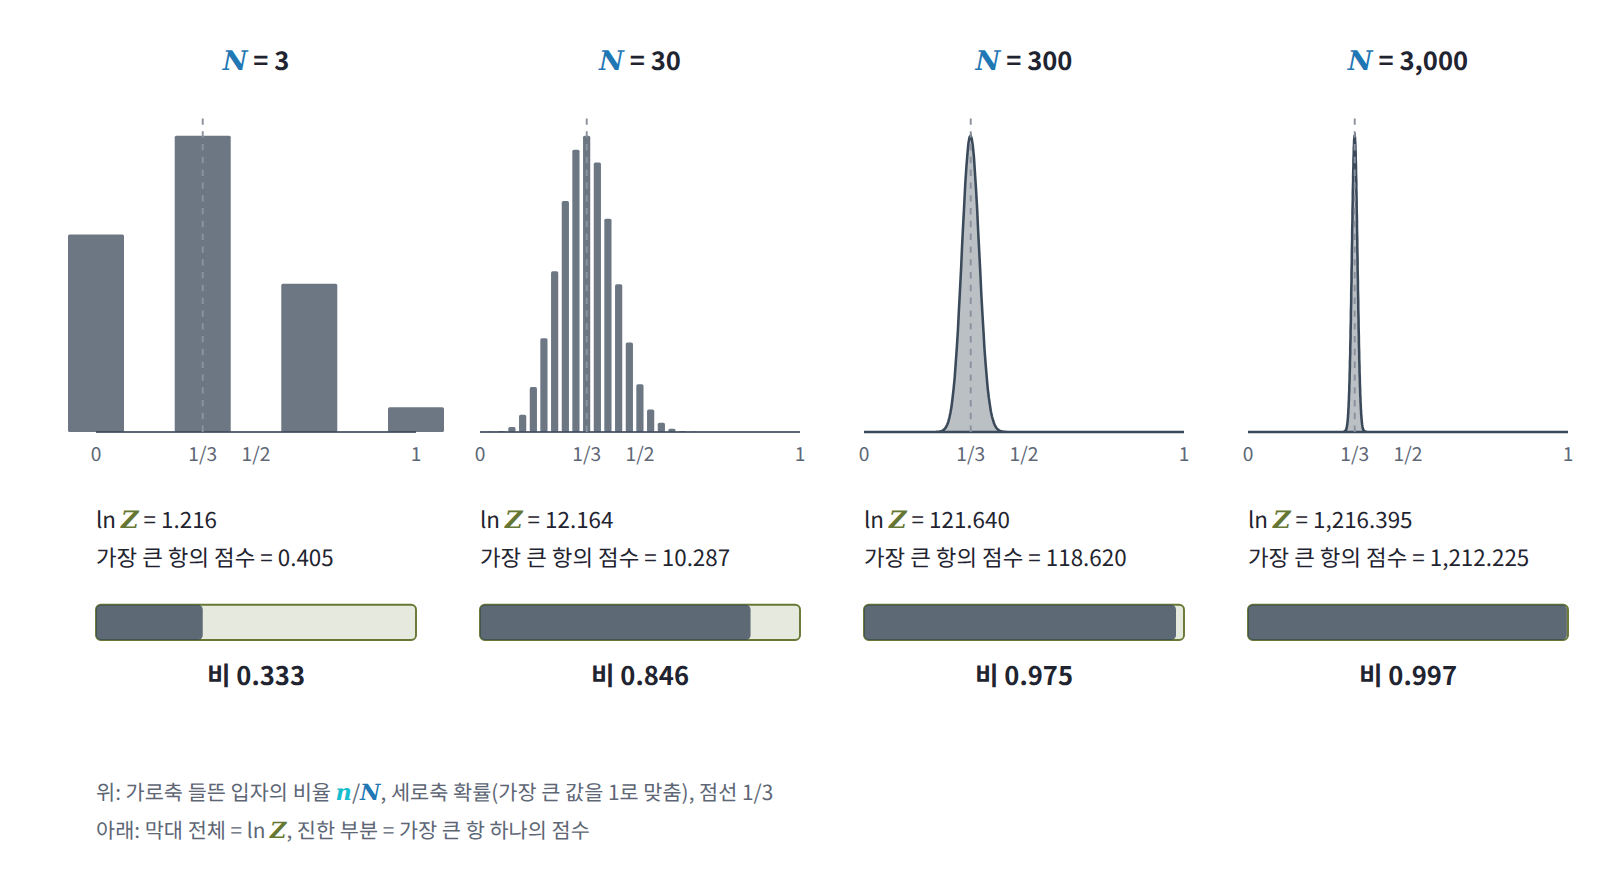
이번에는 모든 항을 더한 ln Z와 가장 큰 항 하나의 점수를 나란히 놓고 입자 수를 늘려 보자.
| N | ln Z | 승자 n | 최대 점수 | 차이 | 최대 점수 / ln Z |
|---|---|---|---|---|---|
| 3 | 1.216 | 1 | 0.405 | 0.811 | 0.333 |
| 30 | 12.164 | 10 | 10.287 | 1.877 | 0.846 |
| 300 | 121.640 | 100 | 118.620 | 3.020 | 0.975 |
| 3000 | 1216.395 | 1000 | 1212.225 | 4.170 | 0.997 |
입자가 세 개일 때는 가장 큰 항이 ln Z의 3분의 1밖에 설명하지 못하지만, 입자가 3,000개이면 99.7%를 설명한다. 차이도 조금씩 자라기는 하지만, ln Z가 입자 수에 비례해 열 배씩 커지는 동안 차이는 1.1 남짓씩만 늘어난다. Z는 N + 1개의 항을 모두 더한 것인데, 입자가 많아지면 왜 그 로그가 가장 큰 항 하나로 거의 정해질까? 그리고 그 가장 큰 항의 점수는 물리적으로 무엇일까?
패턴: 합의 로그는 가장 큰 항이 정한다
분배함수를 에너지 값별로 묶어 쓰면 Z = Σ_E g(E)e^(−βE)이고, 각 항을 지수 하나로 모으면 Z = Σ_E e^(ln g(E) − βE)가 된다. 괄호 안이 바로 작은 문제의 점수다. 그러니 ln Z는 점수들의 logsumexp이고, ML을 해 본 독자라면 logsumexp가 max를 부드럽게 만든 함수라는 것을 알고 있을 것이다. 이 사실을 부등식으로 적어 두자. 더하는 항은 모두 양수이므로 합은 가장 큰 항보다 크고, 항이 M개이면 합은 가장 큰 항의 M배를 넘지 못한다.
2준위 입자 N개에서는 에너지 값이 N + 1개뿐이므로, ln Z와 최대 점수의 차이는 ln(N + 1)을 넘지 못한다. 반면 점수 자체는 입자 수에 비례해 커진다. N = 3,000이면 차이의 상한은 ln 3001 = 8.0이고 실제 차이는 4.17인데, ln Z는 1,216이다. 입자 수가 아보가드로수쯤 되면 ln Z는 10²³의 크기이고 차이는 기껏해야 수십이므로, 둘을 구별할 방법이 없다. 실제 차이가 상한의 절반쯤인 것은 승자 근처의 항들이 승자와 거의 같은 크기로 함께 더해지기 때문인데, 그 차이가 정확히 무엇을 재는지는 보기 절의 코드에서 확인한다.
이제 점수를 물리의 말로 옮겨 보자. 경우의 수의 로그에 볼츠만 상수를 곱한 것이 엔트로피 S(E) = k ln g(E)이므로, 점수에 −kT를 곱하면 E − TS(E)가 된다. 점수를 가장 크게 하는 것은 이 양을 가장 작게 하는 것과 같으므로 다음을 얻는다.
E − TS는 에너지와 엔트로피의 겨루기를 한 줄로 적은 것이다. 에너지 항은 계를 바닥 상태 쪽으로 끌어내리고, −TS 항은 상태가 많은 쪽으로 끌어당기며, 온도 T가 엔트로피 1 단위를 에너지 몇 단위로 쳐 줄지 정하는 환율 노릇을 한다. 온도가 낮으면 환율이 낮아 에너지 항이 이기므로 계는 바닥 상태 근처에 머물고, 온도가 높으면 엔트로피 항이 이겨 가장 상태가 많은 에너지, 2준위 입자라면 절반이 들뜬 곳으로 간다. 미시상태 하나하나로 보면 늘 바닥 상태가 가장 흔한데도 관찰되는 에너지는 온도에 따라 옮겨 가는 이유가 여기 있다.

승자의 위치는 E − TS(E)를 E로 미분해 0으로 놓으면 나온다. 그러면 dS/dE = 1/T, 곧 「계 자신의 온도가 열원의 온도와 같아지는 에너지」가 승자다. 이 최소화에는 더 직접적인 뜻도 있다. 계가 에너지 E를 가지면 열원은 그만큼을 내준 것이므로 열원의 엔트로피는 E/T만큼 줄어 있다. 따라서 계와 열원을 합친 전체 엔트로피는 S(E) − E/T + (상수)이고, 여기에 −T를 곱한 것이 E − TS(E)다. E − TS를 가장 작게 하는 것은 계와 열원을 합친 전체의 경우의 수를 가장 크게 하는 것과 같은 일이다. 새로운 원리가 생긴 것이 아니라, 에너지를 주고받는 두 계는 전체 경우의 수가 가장 큰 분배에서 멈춘다는 원리를 열원의 몫까지 계산에 넣어 계 쪽의 말로만 다시 쓴 것이다.
정의: 자유에너지
큰 계에서는 −kT ln Z가 승자의 E − TS와 거의 같았다. 그런데 입자가 세 개일 때는 가장 큰 항이 ln Z의 3분의 1밖에 설명하지 못했으니, 이 근사는 작은 계에서는 쓸 수 없다. 그렇다면 −kT ln Z 자체를 계의 크기와 상관없이 에너지와 엔트로피의 겨루기로 정확히 적을 수는 없을까? 승자 하나의 에너지와 엔트로피 대신 볼츠만 분포의 평균 에너지와 엔트로피를 쓰면 등호가 정확히 성립한다. 그래서 온도 T인 열원과 맞닿은 계에 대해 −kT ln Z를 자유에너지 (에너지와 엔트로피의 겨루기 결과, Helmholtz free energy)라 하고 F로 쓴다.
등호는 한 줄로 확인된다. 볼츠만 분포에서 ln pᵢ = −βEᵢ − ln Z이므로, 이것을 pᵢ로 평균해 −k를 곱하면 S = kβ⟨E⟩ + k ln Z이고, 양변에 T를 곱해 정리하면 ⟨E⟩ − TS = −kT ln Z다. βε = ln 2인 2준위 입자 하나라면 ⟨E⟩ = 0.231kT, S = 0.636k이므로 ⟨E⟩ − TS = −0.405kT가 되어 −kT ln 1.5와 맞는다.
같은 식을 거꾸로 풀면 볼츠만 분포를 Z 없이 적을 수 있다. ln Z = −βF를 대입하면 다음과 같다.
역사 절에서 본 깁스의 e^((ψ − ε)/Θ)가 바로 이 식이고, 깁스의 ψ가 자유에너지 F다. 둘째 식은 ML 독자에게 특히 쓸모가 있다. 상태 하나의 놀라움 −ln pᵢ는 그 상태의 에너지가 자유에너지보다 kT의 몇 배만큼 높은지와 같다. softmax 분류기라면 온도 1에서 에너지가 −로짓이고 자유에너지가 −logsumexp(z)이므로, 교차 엔트로피 손실 −ln p_c = −z_c + logsumexp(z)는 「정답 클래스의 에너지가 자유에너지보다 얼마나 높은가」를 잰 값이다. 자유에너지는 모든 상태의 에너지보다 낮은 곳에 있으므로 이 손실은 항상 양수다.
일반화: 르장드르 변환
자유에너지는 열원의 온도 T를 변수로 삼는 양이다. 그런데 경우의 수를 세는 계산은 에너지를 변수로 삼았다. 에너지의 함수로 적힌 계를 온도의 함수로 옮기는 일은 어떻게 이루어지고, 왜 그런 옮김이 필요할까? 실험실의 계는 대개 방이라는 열원에 맞닿아 있어서 우리가 손에 쥐는 손잡이는 에너지가 아니라 온도다. 그러니 계를 온도의 함수로 적은 양이 필요하고, 그것을 만드는 방법이 르장드르 변환이다.
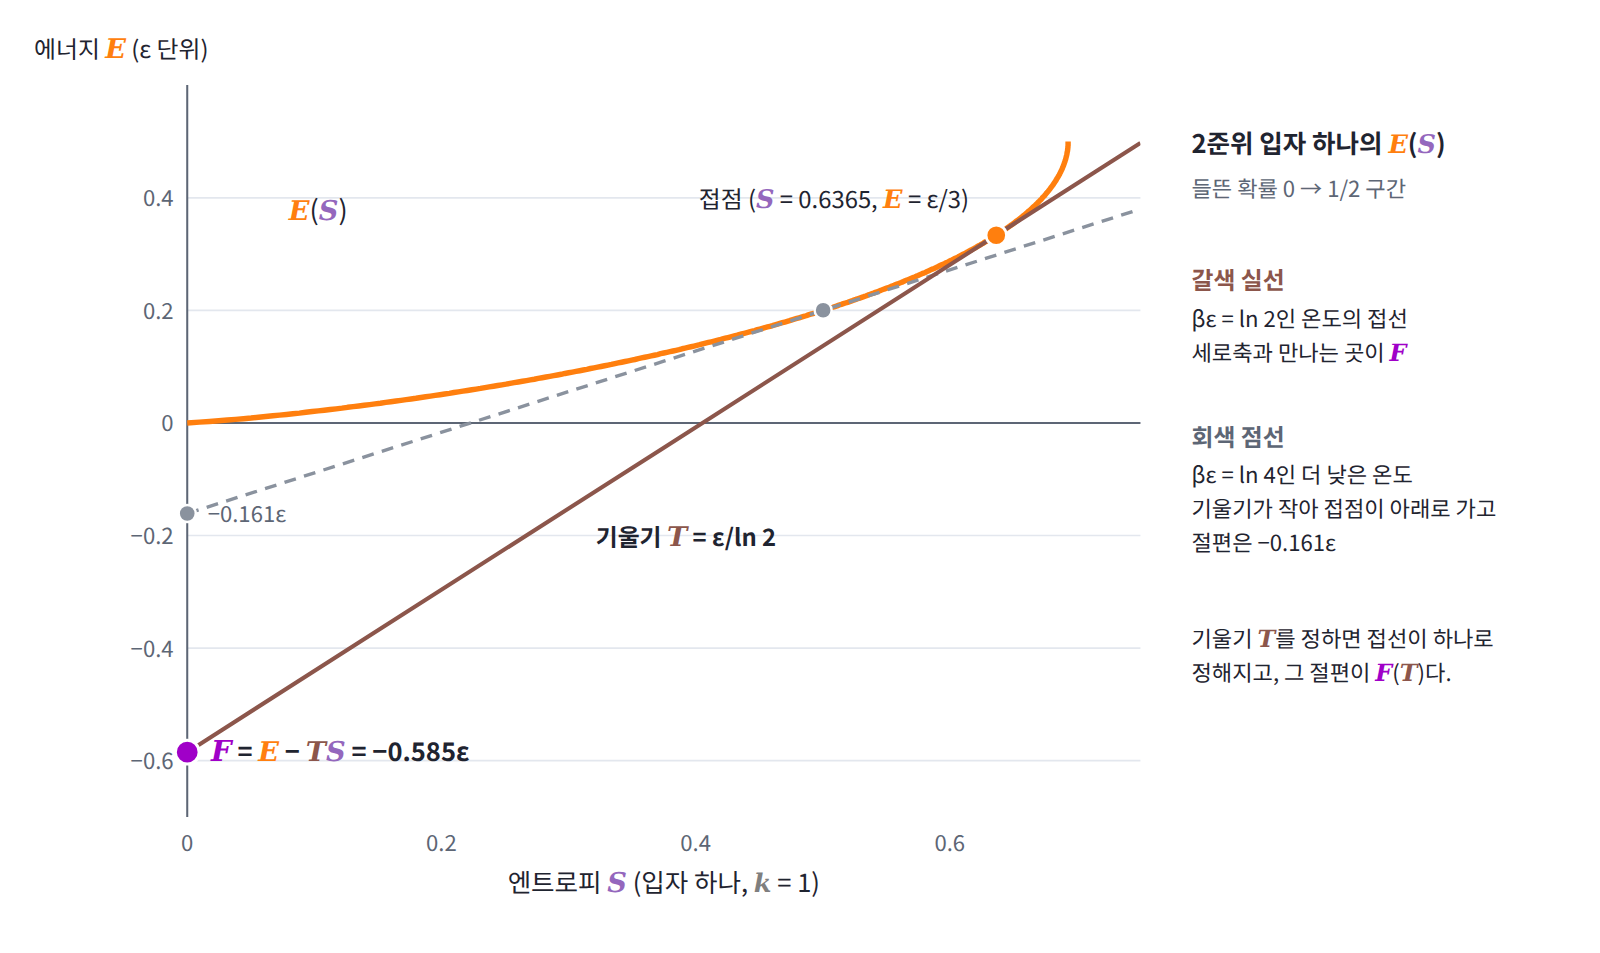
에너지를 엔트로피의 함수 E(S)로 보자. 보통의 계는 에너지를 넣을수록 엔트로피가 늘되 느는 속도가 점점 줄어들므로, 거꾸로 E(S)는 볼록한 증가 함수이고 그 기울기 dE/dS가 온도 T다. 르장드르 변환의 두 단계를 그대로 밟으면, 기울기 T를 새 변수로 삼고 「새 변수 × 원래 변수 − 원래 함수」인 TS − E를 새 함수로 삼는다. 물리학은 이 새 함수에 마이너스를 붙인 것을 쓰는데, 그것이 자유에너지다.
미분 대신 최솟값으로 적으면 F(T) = min_S(E(S) − TS)이고, 이것이 가장 큰 항을 다룬 절에서 찾은 min_E(E − TS(E))와 같은 식이다. 셋째 식은 「변환한 함수를 새 변수로 미분하면 옛 변수가 나온다」는 르장드르 변환의 성질에 부호가 붙은 것이다. 역학에서 라그랑지안을 속도 대신 운동량의 함수로 다시 적어 에너지를 얻는 것도 이 변환이니, 같은 도구가 운동을 적을 때와 열을 적을 때 모두 쓰이는 셈이다. 엔트로피가 에너지에 대해 오목하지 않은 구간이 있으면 두 번 변환했을 때 그 구간이 곧은 선으로 메워지는데, 물이 끓는 것 같은 상전이에서 실제로 이 일이 일어난다.
같은 짝을 ML 쪽 말로 적으면 더 익숙하다. 가장 큰 항을 다룬 절의 식은 ln Z(β) = max_E(S(E)/k − βE)이므로, 로그 분배함수 ln Z와 엔트로피 S/k는 역온도 β를 기울기 변수로 하는 르장드르 쌍이다. 로짓의 함수인 logsumexp의 켤레가 확률의 함수인 음의 엔트로피라는 사실과 같은 모양인데, 이번에는 로짓 벡터 자리에 역온도 하나가, 확률 벡터 자리에 에너지 하나가 선다.
일반화: ln Z의 기울기
ln Z와 엔트로피가 역온도 β를 기울기 변수로 하는 짝이라면, ln Z를 β로 미분하면 무엇이 나올까? 변환한 함수의 기울기가 옛 변수라는 성질을 ln Z에 적용하면 승자의 에너지가 나와야 한다. 사실은 근사 없이도 성립한다. Σᵢe^(−βEᵢ)를 β로 미분하면 각 항에서 −Eᵢ가 내려오고, 이것을 Z로 나누면 볼츠만 확률로 평균한 에너지에 마이너스를 붙인 것이 된다.
2준위 입자 하나에서는 ln Z = ln(1 + e^(−βε))이므로 ⟨E⟩ = ε/(e^(βε) + 1)이고, βε = ln 2에서 ε/3이다. 엔트로피는 ln 1.5 + ln 2 × 1/3 = 0.6365(k 단위)인데, 이 값은 작은 문제에서 경우의 수를 직접 세어 얻는 입자 하나당 엔트로피, 곧 N이 클 때 ln C(N, N/3)/N이 다가가는 −(1/3)ln(1/3) − (2/3)ln(2/3) = 0.6365와 같다. 경우의 수를 한 번도 세지 않고 Z만 미분해서 엔트로피를 얻은 것이다.
이제 정규화 상수라며 나눠 버리던 Z가 에너지와 경우의 수의 겨루기에 대해 무엇을 아는지 정리할 수 있다. ln Z의 값은 승자의 점수(−βF)이고, β에 대한 기울기에 마이너스를 붙이면 승자의 에너지 ⟨E⟩이며, 이 둘을 합치면 승자의 엔트로피가 나온다. 에너지 안에 매개변수 θ가 들어 있으면 θ로 미분해도 같은 방식으로 −β⟨∂E/∂θ⟩가 나온다. 정규화 상수로만 보이던 Z는 미분 한 번으로 온갖 평균을 내주는 함수였던 것이다.
일반화: 아무 분포에 매기는 자유에너지
지금까지 자유에너지는 볼츠만 분포 하나에만 붙은 숫자였다. 그런데 ⟨E⟩ − TS라는 모양은 어떤 분포에도 계산할 수 있다. 볼츠만 분포가 아닌 분포에 같은 셈을 하면 그 값은 볼츠만 분포의 F보다 클까 작을까, 그리고 얼마나 차이가 날까? 미시상태 위의 아무 분포 p에 대해 평균 에너지에서 온도 × 엔트로피를 뺀 값을 p의 자유에너지라 부르자. 그러면 다음 등식이 성립한다.
증명은 KL의 정의에 볼츠만 분포의 로그 ln pᵢ = −βEᵢ − ln Z를 넣기만 하면 된다. D_KL(p‖p_볼츠만) = Σpᵢ ln pᵢ − Σpᵢ ln p_볼츠만,ᵢ = −H(p) + β⟨E⟩_p + ln Z이고, 여기에 kT를 곱하면 ⟨E⟩_p − kT H(p) + kT ln Z, 곧 F[p] − F다.
이 등식에서 세 가지를 읽을 수 있다. 첫째, KL은 0 이상이고 두 분포가 같을 때만 0이므로, 모든 분포 가운데 자유에너지가 가장 낮은 것은 볼츠만 분포 하나뿐이고 그 최솟값이 F다. 가능한 모든 분포를 후보로 놓고 어떤 양을 최소로 만드는 분포를 찾는 이런 원리를 변분 원리 (분포 전체를 후보로 두는 최적화 원리, variational principle)라 한다. 둘째, 볼츠만 분포에서 벗어난 분포는 KL 1 nat마다 kT만큼 자유에너지를 더 치른다. 셋째, 온도는 엔트로피 항 앞에 붙은 계수다. k = 1로 두고 에너지를 로짓의 마이너스 Eᵢ = −zᵢ, 온도를 τ로 쓴 뒤 양변에 마이너스를 붙이면 다음을 얻는다.
왼쪽은 −F이고, 오른쪽의 최댓값은 온도 τ인 softmax에서 얻어진다. 로짓의 평균을 키우려는 힘과 엔트로피를 키우려는 힘이 겨룰 때, 엔트로피 쪽에 붙는 가중치가 바로 온도다. 온도가 0으로 가면 엔트로피 항이 사라져 argmax만 남고, 온도가 크면 엔트로피 항이 이겨 분포가 고르게 퍼진다.

일반화: 등분배 정리
지금까지의 상태는 하나씩 셀 수 있었다. 변수가 실수 전체를 끊김 없이 움직이는 계에서는 평균 에너지가 얼마일까? 에너지에 제곱으로 들어가는 변수 하나는 온도 T에서 에너지를 얼마나 받고, 그 몫은 제곱 항의 계수가 클수록 커질까? ln Z를 β로 미분하면 평균 에너지가 나온다는 사실을 가장 단순한 연속 계에 써 보자. 에너지가 한 변수의 제곱에 비례하는 E = ax²/2이고 x가 실수 전체를 움직일 수 있다면, 분배함수는 가우스 적분이다.
계수 a는 ln Z에 β와 상관없는 상수 −½ ln a로만 들어가므로 미분하면 사라진다. 그래서 제곱 항 하나가 받는 평균 에너지는 그 계수와 상관없이 ½kT다. 에너지가 제곱 항 f개의 합이면 Z가 곱으로 쪼개지고 ln Z가 합이 되므로 평균 에너지는 f × ½kT가 된다. 이것이 등분배 정리 (제곱 항마다 같은 몫, equipartition theorem)다. 그네 하나는 운동량과 위치의 제곱 항이 둘이라 kT를, 이상기체 원자 하나는 운동량 세 성분의 제곱 항이 셋이라 (3/2)kT를 갖는다. 다만 이 계산은 두 가지를 가정했다. 에너지가 변수의 제곱이라는 것과, 그 변수가 끊김 없이 실수 전체를 움직인다는 것이다. 어느 하나라도 깨지면 몫이 달라지는데, 그것은 대화 연습에서 따져 본다.

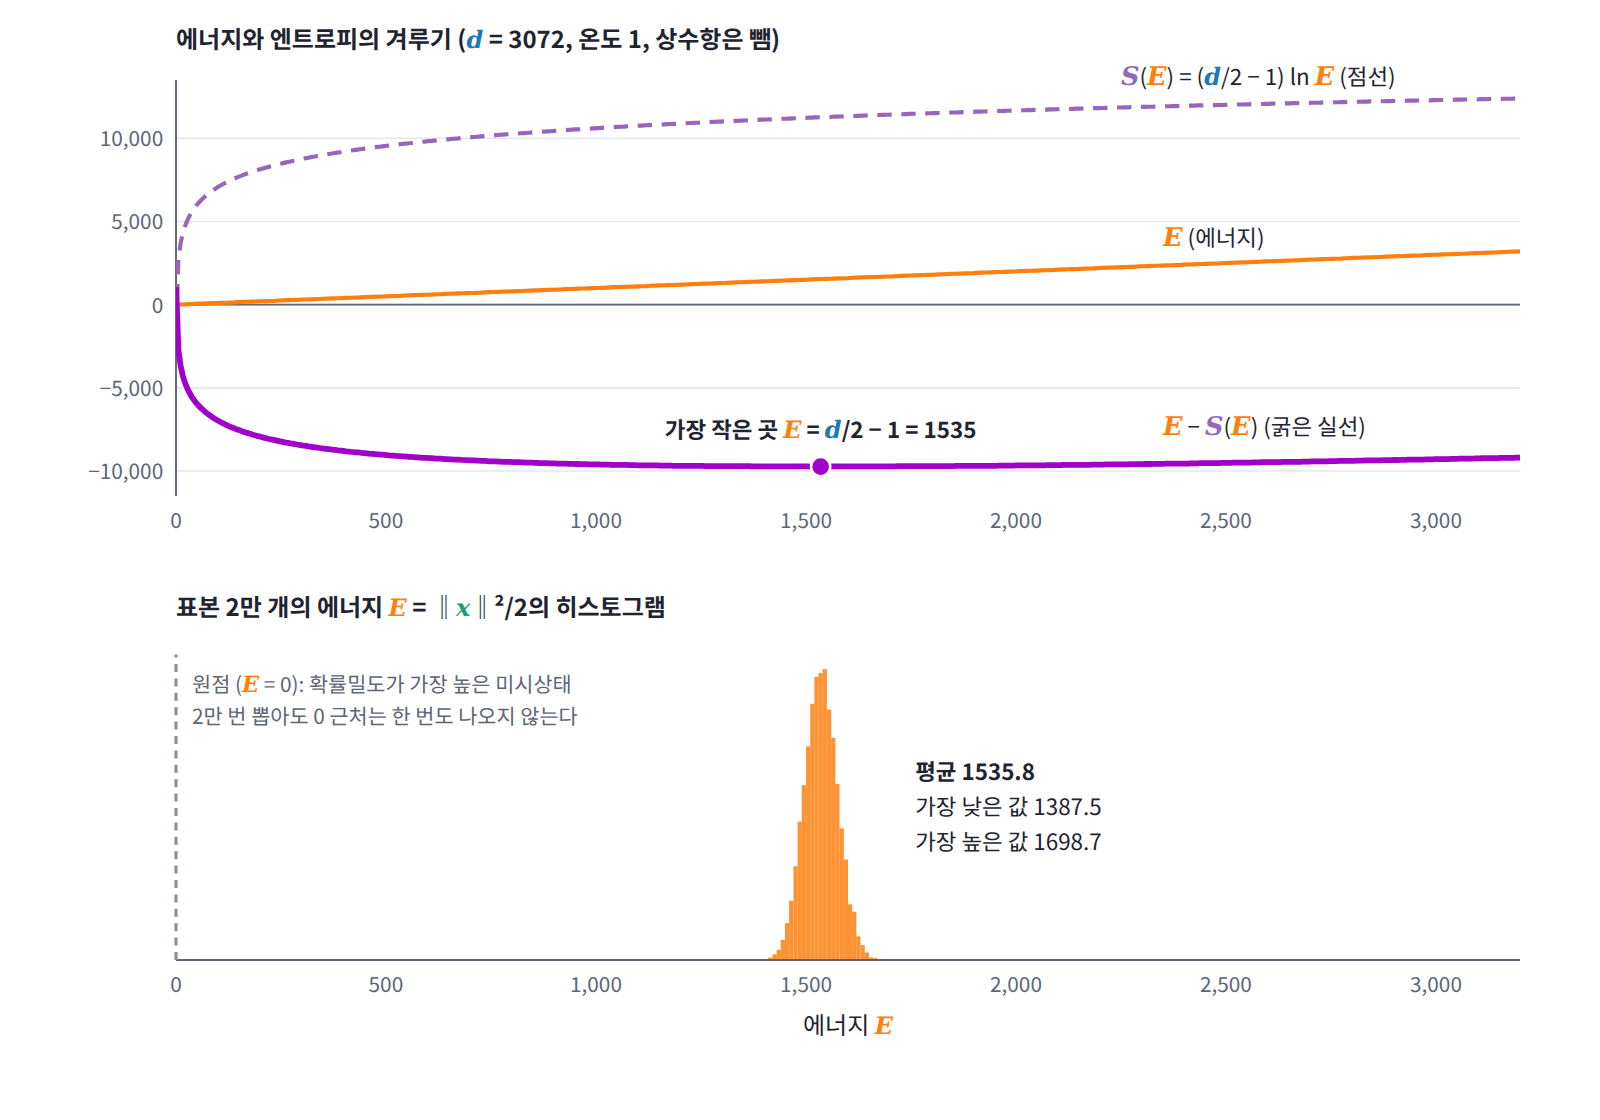
이제 d차원 표준정규분포 N(0, I)를 에너지 E = ‖x‖²/2, 온도 1인 볼츠만 분포로 보자. 에너지는 제곱 항 d개의 합이므로 평균 에너지는 정확히 d/2다. 자유에너지의 겨루기로 보아도 같은 곳이 나온다. 에너지가 E 근처인 상태들은 반지름 √(2E)인 구면의 얇은 껍질을 이루고, 그 부피는 E^(d/2 − 1)에 비례한다.
d = 3072라면 겨루기의 승자는 1535, 평균은 1536이고, 실제로 샘플 2만 개를 뽑으면 에너지의 평균은 1535.8, 가장 낮은 것조차 1387.5다. 확률밀도가 가장 높은 원점은 미시상태 하나로서는 누구보다 흔하지만, 에너지가 d/2 근처인 상태들의 엄청난 수에 밀려 한 번도 뽑히지 않는다.
일반화: 합쳐 없앤 변수의 자유에너지
상태가 두 부분 (x, h)로 되어 있고 우리가 관심 있는 것은 x뿐이라고 하자. 분류기의 입력과 라벨, 잠재변수 모델의 관측값과 잠재변수가 모두 이런 짝이다. 결합 분포가 볼츠만 분포일 때 h를 모두 더해 없애면, 남은 x의 분포는 어떤 모양이 되고 그 에너지 자리에는 무엇이 남을까? 계산해 보면 x의 분포도 볼츠만 분포의 모양을 한다. 다만 그 에너지 자리에는 x를 고정하고 h만의 분배함수를 계산해 얻은 자유에너지가 들어선다.
h를 합쳐 없애면 h의 에너지만 남는 것이 아니라 h가 가질 수 있는 상태의 수도 함께 남는다. 그래서 F(x)는 가장 낮은 에너지 min_h E(x, h)보다 항상 낮고, 그 차이는 kT × ln(유효한 h의 개수)다. 세 가지 예가 모두 이 모양이다. HMC에서 위치와 운동량의 결합 분포 e^(−βℋ)에서 운동량을 합쳐 없애면 F(q) = U(q) − kT ln Z_p인데, 운동량 쪽 분배함수 Z_p가 위치와 상관없는 상수라서 위치의 분포는 e^(−βU)를 그대로 따른다. 분류기에서 입력과 라벨의 에너지를 E(x, y) = −z_y(x)로 두고 라벨을 합쳐 없애면 F(x) = −logsumexp_y z_y(x)이다. 잠재변수 모델에서 온도 1의 에너지를 E(x, h) = −ln p(x, h)로 두고 잠재변수를 합쳐 없애면 F(x) = −ln p(x), 곧 데이터의 음의 로그우도다. 숨은 변수의 자유에너지가 보이는 변수의 에너지가 되는 것이다.
보기: 코드
가장 큰 항과 ln Z, 그리고 ln Z의 기울기
작은 문제의 마지막 표를 코드로 다시 만들어 보자. 2준위 입자 N개에서 에너지 값마다 점수 ln g − βE를 계산해 승자를 찾고, 정확한 ln Z = N ln 1.5와의 차이를 출력한다. 뒤쪽에서는 PyTorch의 자동 미분으로 입자 하나의 ln Z를 β로 미분해 평균 에너지와 엔트로피를 얻고, 경우의 수를 세어 얻는 값과 비교한다.
import torch
from math import lgamma, log, pi

beta_eps = log(2)                      # βε = ln 2, 들뜬 상태의 볼츠만 인자 e^(−βε) = 1/2

def score(N, n):                       # ln g(E) − βE, 들뜬 입자 n개인 에너지 값의 「점수」
    return lgamma(N + 1) - lgamma(n + 1) - lgamma(N - n + 1) - n * beta_eps

print(" N      ln Z    승자 n   최대 점수     차이   ½ln(2πN·p(1−p))")
for N in (3, 30, 300, 3000):
    lnZ = N * log(1 + 0.5)                                  # Z = (1 + e^(−βε))^N
    n_best = max(range(N + 1), key=lambda n: score(N, n))
    gap = lnZ - score(N, n_best)
    print(f"{N:5d} {lnZ:9.3f} {n_best:6d} {score(N, n_best):11.3f} {gap:8.3f} "
          f"{0.5 * log(2 * pi * N * (1/3) * (2/3)):9.3f}")

# ln Z를 β로 미분해 입자 하나의 평균 에너지와 엔트로피 얻기 (ε = 1, k = 1)
beta = torch.tensor(beta_eps, requires_grad=True)
lnZ1 = torch.log(1 + torch.exp(-beta))                      # 입자 하나의 ln Z
lnZ1.backward()
E_mean = -beta.grad.item()                                  # ⟨E⟩ = −∂ln Z/∂β
S = lnZ1.item() + beta.item() * E_mean                      # S/k = ln Z + β⟨E⟩
H_count = -(1/3) * log(1/3) - (2/3) * log(2/3)              # 세어서 얻은 ln C(N, N/3)/N의 극한
print(f"⟨E⟩ = {E_mean:.4f},  S = {S:.4f},  세어서 얻은 값 = {H_count:.4f}")
#  N      ln Z    승자 n   최대 점수     차이   ½ln(2πN·p(1−p))
#     3     1.216      1       0.405    0.811     0.716
#    30    12.164     10      10.287    1.877     1.867
#   300   121.640    100     118.620    3.020     3.019
#  3000  1216.395   1000    1212.225    4.170     4.170
# ⟨E⟩ = 0.3333,  S = 0.6365,  세어서 얻은 값 = 0.6365
차이 열의 값은 입자가 열 배 늘 때마다 약 1.15씩, 곧 ½ ln 10씩 늘어나고, 마지막 열의 ½ ln(2πN·p(1 − p))와 N이 커질수록 소수 셋째 자리까지 맞는다. 여기서 p = 1/3은 입자 하나가 들떠 있을 확률이고, Np(1 − p)는 들뜬 입자 수의 분산이다. 그러니 ln Z와 가장 큰 항의 차이는 승자 근처에서 함께 더해지는 항들이 몇 개쯤인지, 곧 봉우리 폭의 로그를 잰 값이다. 폭은 √N으로만 자라므로 그 로그는 N에 비하면 무시할 만하다. 아래 줄은 경우의 수를 한 번도 세지 않고 ln Z의 기울기만으로 평균 에너지 1/3과 엔트로피 0.6365를 얻었음을 보여 준다.
재매개화로 자유에너지 내리기
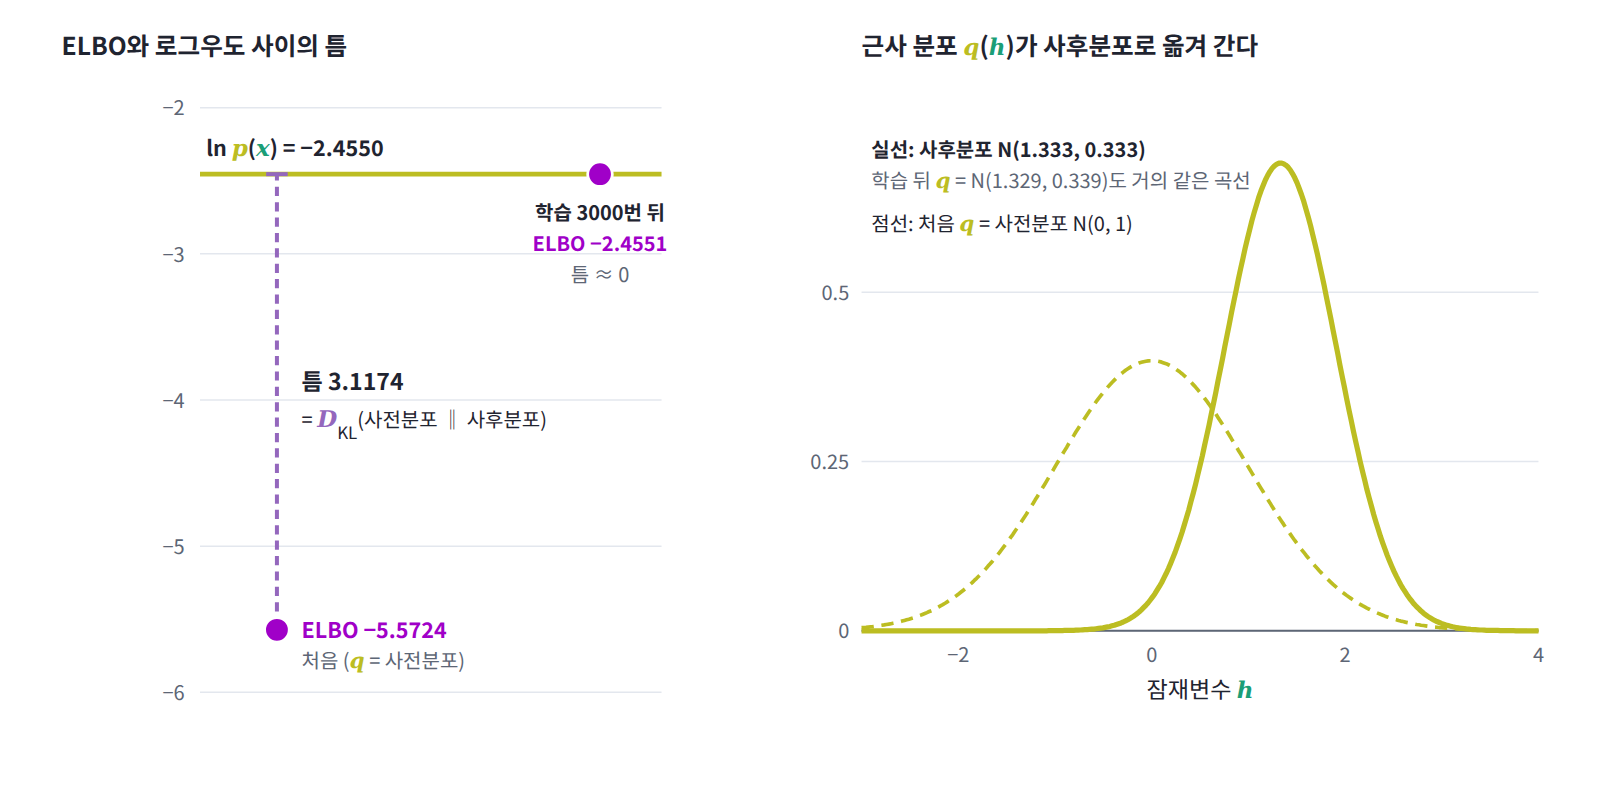
이번에는 자유에너지를 직접 최소화해 보자. 잠재변수 h가 표준정규분포를 따르고 관측값이 x | h ~ N(h, 0.5)인 모델에서 x = 2를 관측했다고 하자. x를 고정하면 에너지는 E(h) = −ln p(x, h)이고, 이 에너지의 분배함수가 p(x), 볼츠만 분포가 사후분포 p(h | x)다. 정규분포 q(h) = N(m, s²)를 후보로 두고, 앞 절의 F[q] = ⟨E⟩_q − H(q)를 줄이는 방향, 곧 그 마이너스인 ELBO를 키우는 방향으로 m과 s를 학습한다. 기댓값 ⟨E⟩_q는 q에서 뽑은 256개 표본으로 어림하는데, 표본을 h = m + s·ε(ε는 표준정규 잡음)로 만들어 m과 s로 미분할 수 있게 하는 것이 VAE의 재매개화 기법이다. 정규분포 q의 엔트로피는 ln s + ½ ln(2πe)로 정확히 알려져 있으므로 그대로 쓴다.
import torch, math
torch.manual_seed(0)

x, s2 = 2.0, 0.5                        # 관측값 x, 잡음 분산: h ~ N(0, 1), x | h ~ N(h, 0.5)

def log_joint(h):                       # ln p(x, h) = −E(h)  (온도 1)
    return (-0.5 * h**2 - 0.5 * (x - h)**2 / s2
            - 0.5 * math.log(2 * math.pi) - 0.5 * math.log(2 * math.pi * s2))

def exact_elbo(m, v):                   # q = N(m, v)일 때 ⟨ln p(x,h)⟩_q + H(q)를 적분으로
    return (-0.5 * (m**2 + v) - 0.5 * ((x - m)**2 + v) / s2
            - 0.5 * math.log(2 * math.pi) - 0.5 * math.log(2 * math.pi * s2)
            + 0.5 * math.log(2 * math.pi * math.e * v))

m = torch.tensor(0.0, requires_grad=True)          # q(h) = N(m, s²), 처음엔 사전분포와 같다
log_s = torch.tensor(0.0, requires_grad=True)
opt = torch.optim.Adam([m, log_s], lr=0.02)
print(f"시작  ELBO {exact_elbo(0.0, 1.0):.4f}  (q = 사전분포)")

for step in range(1, 3001):
    h = m + torch.exp(log_s) * torch.randn(256)     # 재매개화: 표본을 m, s의 함수로 만든다
    entropy = log_s + 0.5 * math.log(2 * math.pi * math.e)
    elbo = log_joint(h).mean() + entropy            # 몬테카를로로 어림한 −F[q]
    opt.zero_grad(); (-elbo).backward(); opt.step()
    if step % 1000 == 0:
        v = math.exp(2 * log_s.item())
        print(f"{step:5d}  ELBO {exact_elbo(m.item(), v):.4f}  m {m.item():.3f}  s² {v:.3f}")

log_px = -0.5 * math.log(2 * math.pi * (1 + s2)) - 0.5 * x**2 / (1 + s2)
print(f"ln p(x) = {log_px:.4f},  사후분포: 평균 {x/(1+s2):.3f}, 분산 {s2/(1+s2):.3f}")
# 시작  ELBO -5.5724  (q = 사전분포)
#  1000  ELBO -2.4550  m 1.338  s² 0.332
#  2000  ELBO -2.4557  m 1.326  s² 0.350
#  3000  ELBO -2.4551  m 1.329  s² 0.339
# ln p(x) = -2.4550,  사후분포: 평균 1.333, 분산 0.333
q를 사전분포 N(0, 1)로 둔 처음에는 ELBO가 −5.5724로 참값 ln p(x) = −2.4550보다 3.1174만큼 낮다. 이 틈은 사전분포와 사후분포 사이의 KL과 정확히 같다. 학습이 진행되면 q는 사후분포 N(1.333, 0.333)으로 다가가고 ELBO는 ln p(x)에 소수 셋째 자리까지 붙는다. 자유에너지 F[q]의 최솟값이 −ln Z, 곧 −ln p(x)라는 사실을 표본과 경사 하강만으로 확인한 것이다. 출력에 남은 소수 넷째 자리의 흔들림은 표본 256개로 기울기를 어림한 탓이다.
ML에서 만나는 곳
자유에너지는 ML에서 잠재변수 모델의 학습 목표인 ELBO로, 그리고 숨은 변수를 합쳐 없앤 입력의 에너지로 나타난다. 둘 다 「x를 고정하고 나머지를 합쳐 없앤다」는 같은 계산이다.
ELBO는 음의 자유에너지다 (움직이는 것: 근사 분포와 모델의 매개변수)
잠재변수 모델 p_θ(x, h)가 관측값 x를 설명한다고 하자. x를 고정하고 잠재변수 h만 미시상태로 보면, 온도 1에서 에너지는 E(h) = −ln p_θ(x, h)이고 그 분배함수는 Σ_h p_θ(x, h) = p_θ(x)다. 이렇게 번역하면 잠재변수 모델의 용어가 하나씩 통계역학의 용어와 짝을 이룬다.
| 통계역학 | 잠재변수 모델 (x 고정) |
|---|---|
| 미시상태 | 잠재변수 h |
| 에너지 E(h) | −ln p_θ(x, h) |
| 분배함수 Z | 증거 p_θ(x) |
| 자유에너지 F = −ln Z | 음의 로그우도 −ln p_θ(x) |
| 볼츠만 분포 | 사후분포 (x가 주어졌을 때 h의 분포) |
| 아무 분포의 자유에너지 F[q] | −ELBO |
| F[q] − F = D_KL(q ‖ 볼츠만 분포) | 틈 = D_KL(q ‖ 사후분포) |
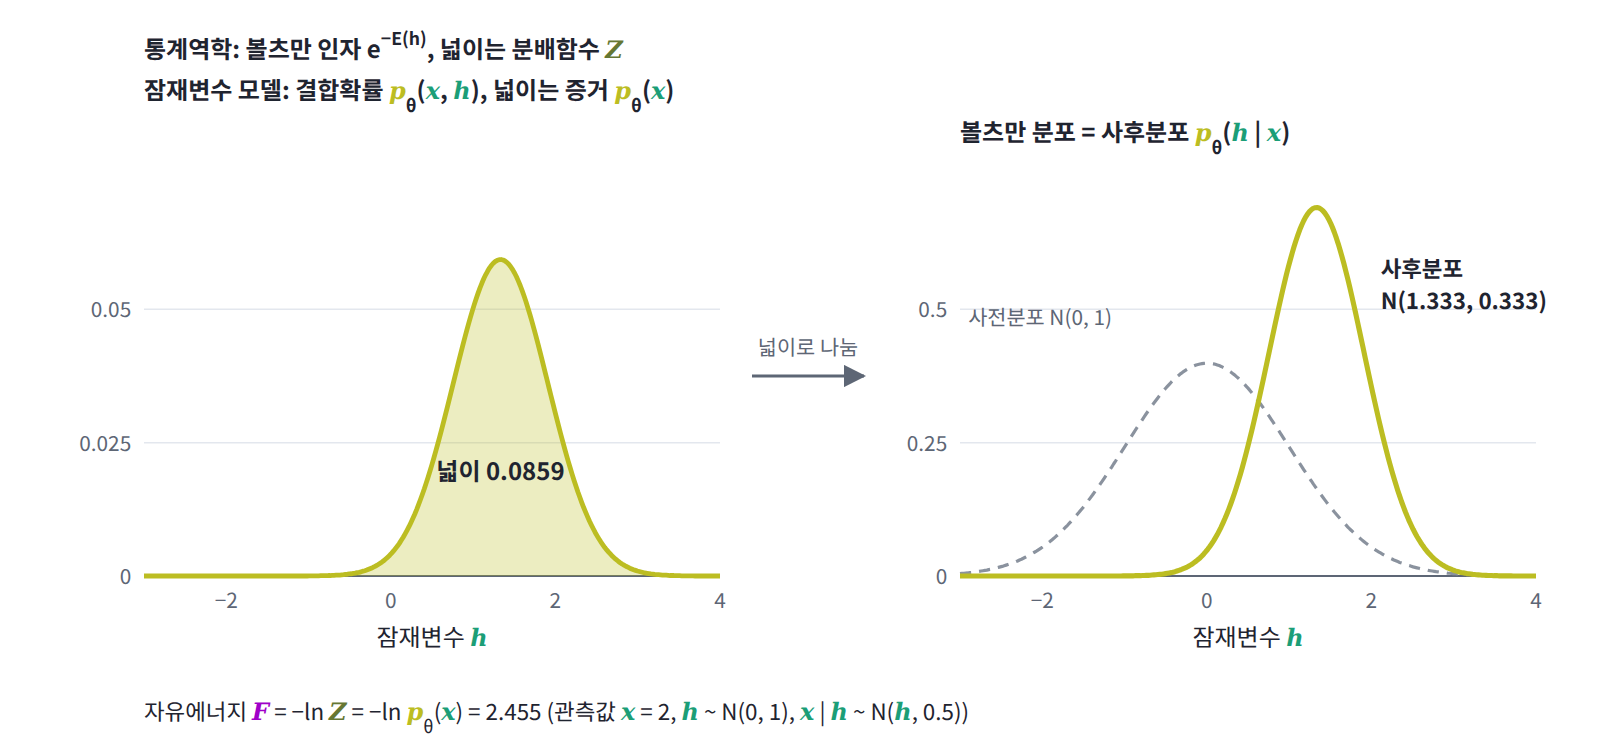
표의 마지막 두 줄을 식으로 적으면 다음과 같다. 앞 절의 F[q] = F + kT·D_KL에 온도 1과 이 번역을 넣은 것뿐이다.
KL은 0 이상이므로 ELBO는 로그우도의 하한이고, 틈은 q가 사후분포에서 벗어난 만큼의 KL이다. ELBO의 첫 항은 평균 에너지에 마이너스를 붙인 것이고 둘째 항은 엔트로피이니, ELBO를 키운다는 것은 에너지를 낮추면서 엔트로피를 지키는 자유에너지 최소화 그 자체다. VAE 논문이 쓰는 모양은 에너지를 디코더 몫과 사전분포 몫으로 나눠 −ln p_θ(x, h) = −ln p_θ(x | h) − ln p(h)로 쓰고, 사전분포 몫을 엔트로피와 묶은 것이다.
킹마와 웰링(2013)의 논문은 첫 식을 「log p_θ(x) = D_KL(q_φ(z|x) ‖ p_θ(z|x)) + L(θ, φ; x)」로 적고, 위의 둘째 식과 같은 모양을 학습 목표로 삼았다(논문의 z가 이 책의 h다). 이 장을 마친 독자는 이 식을 「근사 분포 q의 자유에너지는 참 자유에너지 −ln p(x)보다 정확히 KL만큼 높다」로 읽게 된다. 인코더가 내놓는 q는 대개 대각 정규분포로 모양이 묶여 있어서 사후분포와 완전히 같아질 수 없고, 그래서 VAE에서는 이 틈이 끝까지 남는다.
역사 절에 옮긴 닐과 힌턴(1998)의 초록은 EM 알고리즘을 같은 식으로 읽은 것이다. 이 장을 마친 독자는 그 문장을 「EM은 자유에너지 F[q, θ]를 q와 θ에 대해 번갈아 내리는 좌표 하강이다. E 단계는 q를 이 계의 볼츠만 분포인 사후분포로 바꿔 틈을 0으로 만들고, M 단계는 그 q를 고정한 채 평균 에너지 ⟨−ln p_θ(x, h)⟩_q를 θ에 대해 낮춘다」로 읽는다. q를 사후분포로 정확히 옮길 수 없는 큰 모델에서는 q를 신경망으로 두고 두 단계를 한 번의 경사 하강으로 합치는데, 그것이 VAE다. Higgins 외(2017)의 β-VAE는 KL 항 앞에 계수 β를 붙여 잠재변수가 더 잘 분리되도록 했는데, 이 β가 무슨 일을 하는지는 대화 연습의 마지막 문제에서 계산한다.

분류기가 버리던 logsumexp는 입력의 자유에너지다 (움직이는 것: 에너지 함수의 매개변수)
분류기의 로짓으로 입력과 라벨 쌍의 에너지를 E(x, y) = −z_y(x)로 정하면, 라벨을 합쳐 없앤 입력의 자유에너지는 F(x) = −logsumexp_y z_y(x)이고 입력의 분포는 e^(−F(x))에 비례한다. Grathwohl 외(2020)의 JEM이 입력의 에너지로 쓴 −logsumexp가 바로 이 자유에너지다. Liu 외(2020)는 같은 양 −T·ln Σ_y e^(z_y(x)/T)를 「헬름홀츠 자유에너지」라 부르고, 학습 분포에서 벗어난 입력을 가려내는 점수로 썼다. 이 논문의 핵심 관찰은 「log max_y p(y|x) = E(x; f) + f_max(x)」라는 한 줄의 등식인데, 논문의 E(x; f)는 이 책의 F(x)이고 f_max는 가장 큰 로짓이다. 이 장을 마친 독자는 이 등식을 「softmax 신뢰도의 로그는 −(가장 낮은 라벨 에너지 − 자유에너지), 곧 −ln(유효 라벨 수)이다. 신뢰도는 라벨들끼리의 겨루기만 보고, 입력 자체가 얼마나 흔한지는 자유에너지가 따로 본다」로 읽게 된다. 두 양이 어떻게 엇갈리는지는 대화 연습에서 숫자로 확인한다.
제한된 볼츠만 머신(RBM)의 학습 코드에 흔히 있는 free_energy 함수도 같은 계산이다. 보이는 유닛 v가 정해지면 숨은 유닛들은 서로 독립인 2준위계라서 분배함수가 곱으로 쪼개지고, 합쳐 없앤 결과는 −Σᵢaᵢvᵢ − Σⱼln(1 + e^(bⱼ + Σᵢvᵢwᵢⱼ))라는 닫힌 식, 곧 편향 항에서 softplus들의 합을 뺀 식이 된다.
대화 연습
선생님의 수업. 김민준(학부 3학년, ML 강의 몇 개 수강)과 이서연(수학과 3학년)이 문제를 풀고, 선생님이 틀린 곳을 짚는다.
문제 1. 엔트로피 항의 계수
로짓 z = (2, 0)에 대해 Σpᵢzᵢ + τH(p)를 가장 크게 하는 분포 p와 그 최댓값을 τ = 0.5, 1, 2에서 구하라. 가장 큰 로짓에 몰아준 분포 (1, 0)과 균등 분포 (0.5, 0.5)의 값과도 비교하라.
이서연제가 숙제로 가져간 거예요. 엔트로피 항에 계수를 붙이면 균형점이 옮겨 갈 거라고 했었죠. p₁ = t, p₂ = 1 − t로 두고 t로 미분하면 z₁ − z₂ + τ ln((1 − t)/t) = 0이니까 t/(1 − t) = e^((z₁ − z₂)/τ)예요. 온도가 τ인 softmax가 맞아요.
김민준그럼 최댓값은 바로 나오지. τ = 1일 때 최댓값이 ln Z였으니까 τ = 0.5면 ln(e^(2/0.5) + e⁰) = ln(e⁴ + 1) = 4.018이에요.
이서연잠깐, 그건 나올 수가 없는 숫자야. p가 뭐든 로짓 평균은 2를 못 넘고, 두 칸짜리 분포의 엔트로피는 ln 2 = 0.693을 못 넘어. τ = 0.5면 최댓값이 2 + 0.347 = 2.347 이하여야 하는데 4.018이 나왔잖아.
김민준어… 그럼 직접 넣어 볼게. softmax(z/0.5) = (0.982, 0.018)이고 로짓 평균이 1.964, 엔트로피가 0.0901이니까 1.964 + 0.5 × 0.0901 = 2.009. 4.018의 딱 절반이네?
선생님왜 절반인지 찾아봐요. 최대화하는 식 전체를 τ로 나누면 무엇이 되죠?
김민준Σpᵢ(zᵢ/τ) + H(p)요. 로짓이 z/τ인 원래 식이니까 최댓값이 ln Σe^(zᵢ/τ)이고… 아, τ로 나눈 식의 최댓값이니까 τ를 다시 곱해야 해요. τ ln Σe^(zᵢ/τ) = 0.5 × 4.018 = 2.009예요.
이서연단위로 봐도 그래. ln Σe^(z/τ)는 nat 단위고, τ를 곱해야 로짓 단위가 돼. 물리에서 ln Z에 kT를 곱해야 에너지가 되는 거랑 똑같아.
선생님그래요. 계수 τ를 붙인 식의 최댓값은 τ ln Σe^(z/τ), 곧 온도 τ인 계의 −F예요. τ = 2도 해 볼까요?
이서연softmax(z/2) = (0.731, 0.269)이고 1.462 + 2 × 0.582 = 2.627, 2 ln(e + 1)도 2.627이에요. 그런데 이번엔 균등 분포가 1 + 2 ln 2 = 2.386으로 argmax의 2를 이겨요. τ = 0.5에서는 argmax가 2, 균등이 1 + 0.5 ln 2 = 1.347이라 순서가 반대였는데요.
선생님온도가 엔트로피 1 nat을 로짓 몇 점으로 쳐 줄지 정하는 환율이라서, 환율이 오르면 고르게 퍼진 분포가 더 비싸게 쳐지는 거예요. 서연 학생의 숙제는 이걸로 풀렸어요.
김민준LLM 샘플링에서 temperature를 올리는 게 엔트로피 값을 올려 쳐 주는 거였네요. 저는 그냥 「랜덤하게 만드는 손잡이」인 줄 알았어요.
문제 2. 딱딱한 용수철과 무른 용수철
온도 T인 열원에 두 용수철이 맞닿아 있다. 하나의 위치에너지는 x²/2, 다른 하나는 100x²/2이다. (가) 각각의 평균 위치에너지를 구하라. (나) 위치에너지가 |x|이거나 x⁴이면 어떻게 되는가? (다) 에너지 0과 ε만 가질 수 있는 2준위 입자에서 βε = 10이면?
김민준딱딱한 용수철은 조금만 늘어나도 에너지가 100배니까 평균 에너지도 훨씬 크겠죠. numpy로 T = 1에서 백만 개씩 뽑아 볼게요. x는 분산이 T/a인 정규분포니까… 무른 쪽이 0.5015, 딱딱한 쪽이 0.4999. 어? 똑같아요.
이서연딱딱한 쪽은 x의 표준편차가 0.1로 열 배 좁아서 x²가 100분의 1이야. 계수가 100배 커진 걸 정확히 상쇄하는 거지.
선생님ln Z로도 확인해 봐요.
김민준Z = √(2π/(βa))니까 ln Z = −½ ln β − ½ ln a + (상수)예요. β로 미분하면 a는 사라지고 ⟨E⟩ = 1/(2β) = ½kT. 제가 추측한 「제곱 항 하나에 ½kT」가 맞았어요!
선생님추측 자체는 맞았어요. 숙제는 그게 언제 맞느냐였죠. (나)로 가 봐요.
이서연|x|면 Z = ∫e^(−β|x|)dx = 2/β라서 ln Z = −ln β + (상수)이고 ⟨E⟩ = kT예요. x⁴면 x = β^(−1/4)u로 바꾸면 Z가 β^(−1/4)에 비례하니까 ⟨E⟩ = kT/4고요. 일반적으로 |x|ⁿ이면 kT/n이에요. ½은 지수 2에서 나온 숫자였네요.
김민준(다)는 ⟨E⟩ = ε/(e^(βε) + 1)이니까 βε = 10이면 4.5 × 10⁻⁵ε, kT로 바꾸면 4.5 × 10⁻⁴kT예요. ½kT의 천분의 일도 안 되는데요?
이서연2준위는 변수가 연속이 아니잖아. 에너지가 한 덩어리 단위로만 오가는데 그 덩어리가 kT의 열 배면 거의 들뜨지를 못하는 거야.
선생님켈빈이 말한 두 번째 구름이 바로 그거예요. 분자의 진동은 제곱 항이 두 개라서 등분배대로라면 kT를 받아야 해요. 그런데 양자역학에서는 진동 에너지도 덩어리로만 오가고, 실온에서는 그 덩어리가 kT보다 훨씬 커요. 그래서 진동은 거의 얼어붙어 비열에 끼지 못했던 거죠. 등분배는 에너지가 제곱 항이고, 그 변수가 kT에 비해 촘촘하게, 곧 연속으로 움직일 수 있을 때만 맞아요.
김민준그럼 d차원 가우시안 노이즈는 좌표마다 제곱 항이 하나씩이니까 좌표마다 ½씩, 합쳐서 d/2요. 샘플 에너지가 d/2 근처에 있던 게 등분배였네요.
이서연너 추측 맞았다고 너무 좋아하지 마. 조건은 절반밖에 안 맞혔어.
문제 3. 자유에너지에서 엔트로피 꺼내기
(가) 2준위 입자 하나의 자유에너지 F = −kT ln(1 + e^(−ε/kT))에서 S = −∂F/∂T로 βε = ln 2일 때의 엔트로피를 구하라. (나) 온도 1에서 로짓 z = (2, 1, 0)인 softmax의 엔트로피를 logsumexp와 로짓 평균만으로 구하라.
김민준F = −kT ln Z를 T로 미분하면 −k ln Z니까 S = k ln Z = k ln 1.5 = 0.405k예요.
이서연작은 문제에서 경우의 수를 세어 얻은 입자 하나당 엔트로피는 0.6365였어. 모자라는데.
선생님Z는 무엇의 함수죠?
김민준1 + e^(−ε/kT)… 아, T가 들어 있어요. 곱의 미분이라 한 항이 더 나와야 해요. −kT × ∂ln Z/∂T인데 ∂ln Z/∂T = ⟨E⟩/(kT²)이니까 S = k ln Z + ⟨E⟩/T = 0.405k + 0.231k = 0.636k. 이제 맞아요.
이서연정규화 상수라고 부르니까 상수인 줄 안 거지. 온도를 바꾸면 Z도 바뀌어.
김민준(나)는 T = 1에서 S = ln Z + β⟨E⟩에 E = −z를 넣으면 H = logsumexp(z) − ⟨z⟩_p예요. 2.4076 − 1.5752 = 0.8324.
선생님−Σp ln p로 계산하면 확률이 0에 가까운 클래스에서 ln 0을 조심해야 하지만, 이 식은 logsumexp 한 번과 가중 평균 한 번이면 끝나요. 로짓만 있으면 되죠.
이서연이 식은 −ln pᵢ = Eᵢ − F를 p로 평균한 거네요. 놀라움의 평균이 엔트로피고, 놀라움 하나하나는 에너지가 자유에너지보다 얼마나 높은지니까요.
문제 4. 확신이 높은 입력이 더 흔한 입력인가
세 클래스 분류기가 입력 x_a에 로짓 (2, 1, 0)을, 입력 x_b에 로짓 (2, −3, −3)을 내놓았다. 에너지를 E(x, y) = −z_y(x), 온도를 1로 둔다. (가) 각 입력의 softmax 최대 확률을 구하라. (나) 라벨을 합쳐 없앤 자유에너지 F(x)와 p(x_a)/p(x_b)를 구하라. (다) x_a의 로짓 전체에 상수 c를 더하면 (가)와 (나)의 답은 어떻게 되는가?
김민준(가)는 x_a가 0.665, x_b가 0.987이에요. 두 입력 모두 가장 큰 로짓이 2라서 에너지는 −2로 같고, x_b 쪽이 훨씬 확신하니까 학습 데이터에 흔한 전형적인 입력이겠죠. p(x_b)가 더 클 거예요.
이서연라벨을 합쳐 없애면 가장 낮은 에너지만 남는 게 아니잖아. F(x_a) = −ln(e² + e + 1) = −2.408이고 F(x_b) = −ln(e² + 2e⁻³) = −2.013이야. x_a 쪽이 더 낮으니까 p(x_a)/p(x_b) = e^(2.408 − 2.013) = 1.48이야.
김민준헉, 거꾸로네요. 확신이 낮은 x_a가 1.5배 더 흔한 입력이라고요?
선생님두 입력 모두 가장 좋은 라벨의 에너지는 −2로 같아요. 차이는 나머지 라벨들에서 나요. x_a는 다른 라벨들의 에너지도 꽤 낮아서 유효한 라벨 수가 1 + e⁻¹ + e⁻² = 1.503개이고, x_b는 1 + 2e⁻⁵ = 1.013개예요. F(x) = (가장 낮은 에너지) − ln(유효 라벨 수)라서 상태가 많은 쪽의 자유에너지가 낮아요.
이서연그런데 softmax 최대 확률의 로그도 −ln(유효 라벨 수)잖아요. 같은 양이 두 점수를 반대 방향으로 움직이는 거네요. 유효 라벨 수가 많으면 신뢰도는 떨어지고 자유에너지도 떨어져서 입력은 더 흔해져요.
김민준(다)는 쉬워요. 로짓에 상수를 더해도 softmax는 그대로니까 신뢰도는 안 바뀌고, 에너지 기준점을 옮긴 거니까 F도… 아니다, F는 −logsumexp라서 c만큼 그대로 내려가요. 그럼 p(x_a)는 e^c배가 되고요.
이서연이상한데. 에너지에 상수를 더해도 확률은 안 바뀐다며. 기준점은 마음대로 옮길 수 있다고 했잖아.
선생님모든 상태에 같은 상수를 더할 때만 그래요. 여기서 상태는 (x, y) 쌍 전체예요. x_a의 로짓에만 c를 더하면 x_a에 딸린 상태들의 에너지만 내려가고 다른 입력은 그대로니까, 공통 기준점을 옮긴 게 아니라 x_a의 에너지를 바꾼 거예요. softmax는 입력 하나 안에서만 정규화하니까 이 변화를 보지 못하는 거고요.
김민준그럼 분류 손실만으로 학습하면 입력마다 로짓의 기준점이 제멋대로 떠 있어도 손실은 똑같겠네요. 그 F(x)를 믿어도 돼요?
선생님좋은 의심이에요. 그래서 JEM은 분류 손실에 입력의 로그우도 항을 함께 넣어 학습했어요. 분류만 학습한 모델의 자유에너지를 점수로 쓴 Liu 외(2020)도 softmax 신뢰도보다는 학습 분포 밖의 입력을 잘 가려냈다고 보고했지만요.
문제 5. 잠재변수 세 개짜리 ELBO
잠재변수 h가 1, 2, 3 가운데 하나이고 사전분포는 p(h) = (0.5, 0.3, 0.2)이다. 관측값 x 하나에 대한 우도는 p(x | h) = (0.1, 0.4, 0.8)이다. (가) ln p(x)를 구하라. (나) q가 사전분포일 때, 사후분포일 때, h = 3에 몰린 분포 (0, 0, 1)일 때 각각 ELBO = ⟨ln p(x | h)⟩_q − D_KL(q‖p(h))와 ln p(x)와의 틈을 구하라. (다) β-VAE처럼 KL 항에 β를 곱한 목적 함수를 가장 크게 하는 q와 그 최댓값을 β = 0.5, 2에서 구하라.
김민준(가)는 p(x) = 0.5 × 0.1 + 0.3 × 0.4 + 0.2 × 0.8 = 0.33이고 ln p(x) = −1.1087이에요. (나)는 사전분포를 q로 두면 KL 항이 0이라 계산이 제일 편해요. ELBO = 0.5 ln 0.1 + 0.3 ln 0.4 + 0.2 ln 0.8 = −1.4708. KL 벌점이 0이니까 이게 가장 좋은 q겠죠. 그러니까 ln p(x) ≈ −1.47이에요.
이서연너 방금 (가)에서 −1.1087이라며. 같은 걸 두 번 계산했는데 답이 다르잖아.
김민준어… 하한이니까 작게 나오는 건 맞는데, KL이 0이면 틈도 0 아니에요?
선생님틈은 어느 두 분포 사이의 KL이었죠?
김민준q와… 사후분포요. 제가 0이라고 한 건 q와 사전분포 사이의 KL이고요. 둘이 다른 KL이었네요.
이서연사후분포는 사전분포 × 우도를 정규화한 거니까 (0.05, 0.12, 0.16)/0.33 = (0.152, 0.364, 0.485)야. 사전분포와 사후분포 사이의 KL이 0.3621이고, −1.4708 + 0.3621 = −1.1087. 딱 맞아.
선생님그럼 q가 사후분포면요?
이서연재구성 항이 −0.7903, KL 항이 0.3184라서 ELBO = −1.1087, 틈이 0이에요. 사전분포에 비해 재구성은 좋아지고 KL 벌점은 늘었는데, 그 합이 가장 커지는 곳이 사후분포예요.
김민준그럼 재구성을 끝까지 밀어붙이면요? 우도가 제일 큰 건 h = 3이니까 q = (0, 0, 1)이면 재구성 항이 ln 0.8 = −0.2231로 압도적이에요.
이서연KL(q‖p(h)) = ln(1/0.2) = 1.6094야. ELBO는 −1.8326이고 틈이 0.7239. 사전분포를 그대로 쓴 것보다도 나빠.
김민준한 곳에 몰았더니 엔트로피를 통째로 잃었네요. softmax 자리에 argmax를 넣었을 때랑 똑같은 실수예요.
선생님번역해 보면 에너지 −ln p(x, h)가 가장 낮은 상태는 h = 3이지만, 이 계의 볼츠만 분포인 사후분포는 그 하나에 몰리지 않아요. EM의 E 단계가 하는 일이 방금 서연 학생이 한 것, q를 사후분포로 바꿔 틈을 0으로 만드는 일이에요. 이제 (다)로 가죠.
이서연목적 함수가 ⟨ln p(x | h)⟩_q − βD_KL(q‖p(h))예요. 이걸 β로 나누면 ⟨ln p(x | h)/β⟩_q − D_KL(q‖p(h))인데, 르장드르 변환 배울 때 본 ln⟨e^z⟩_q = max_p(⟨z⟩_p − D_KL(p‖q))에서 기준 분포를 사전분포로, z를 ln p(x | h)/β로 둔 모양이에요. 그러면 답은 사전분포에 e^z = p(x | h)^(1/β)를 곱해 정규화한 분포이고, 최댓값은 β를 다시 곱해서 β ln Σ_h p(h)p(x | h)^(1/β)예요.
김민준β = 1이면 사후분포와 ln p(x)로 돌아오네요. β = 0.5면 우도를 제곱해서 (0.028, 0.265, 0.707)이고, β = 2면 제곱근을 곱해서 (0.300, 0.360, 0.340)… 이건 거의 사전분포예요.
이서연문제 1이랑 똑같은 구조다. β는 KL 항, 곧 사전분포를 기준으로 잰 엔트로피 쪽에 붙은 계수니까 온도야. β를 키우면 q가 사전분포 쪽으로 녹고, 0으로 보내면 h = 3 하나로 얼어붙어. β-VAE는 온도를 올려서 인코더를 사전분포 쪽에 붙잡아 두는 거네.
선생님한 가지만 조심해요. β가 1이 아니면 그 최댓값은 더 이상 ln p(x)의 하한이 아니에요. 계산해 보면 β = 2에서 −1.2821, β = 0.5에서 −0.8546인데, 뒤의 것은 ln p(x) = −1.1087보다 커요. 온도를 바꾸면 다른 계의 자유에너지를 재는 셈이니까요.
김민준β를 작게 잡으면 목적 함수 숫자가 좋아 보이는데 로그우도가 좋아진 건 아니네요. β가 다른 모델끼리 그 숫자를 비교하면 안 되겠어요.
이서연결국 VAE 손실도 한 줄이었어. 평균 에너지 빼기 온도 곱하기 엔트로피.
자주 하는 실수와 요약
자주 하는 실수
| 실수 | 나온 문제 | 바로잡는 법 |
|---|---|---|
| 계수 τ를 붙인 식의 최댓값을 ln Σe^(z/τ)로 씀 | 1 | 최댓값은 τ ln Σe^(z/τ). nat에 온도를 곱해야 로짓(에너지) 단위가 된다 |
| 딱딱한 용수철이 평균 에너지를 더 받는다고 봄 | 2 | 제곱 항 하나에 ½kT, 계수와 상관없다 |
| 등분배를 모든 에너지 모양에 씀 | 2 | 제곱 항이고 변수가 연속일 때만. 절댓값의 n제곱이면 kT/n, 덩어리가 kT보다 크면 얼어붙는다 |
| 자유에너지를 온도로 미분할 때 ln Z를 상수로 둠 | 3 | Z는 온도의 함수다. S = k(ln Z + β⟨E⟩) |
| softmax 신뢰도가 높은 입력을 흔한 입력으로 봄 | 4 | 입력이 얼마나 흔한지는 F(x) = −logsumexp가 잰다. 신뢰도의 로그는 −ln(유효 라벨 수) |
| 입력마다 로짓에 다른 상수를 더하는 것을 기준점 이동으로 봄 | 4 | 기준점은 모든 (x, y)에 같은 상수를 더할 때만 자유롭다 |
| q와 사전분포의 KL이 0이면 ELBO가 로그우도라고 봄 | 5 | 틈은 q와 사후분포 사이의 KL이다 |
| 우도가 가장 큰 잠재변수 하나에 q를 몰아줌 | 5 | 엔트로피를 잃는다. 최적의 q는 이 계의 볼츠만 분포인 사후분포다 |
| β가 다른 목적 함수의 최댓값을 로그우도처럼 비교함 | 5 | β ≠ 1이면 다른 온도의 자유에너지다 |
요약
미시상태 하나의 확률은 에너지가 정하지만, 관찰되는 에너지는 에너지와 그 에너지를 가진 상태의 수가 함께 정한다. 에너지 값마다 점수 ln g(E) − βE를 매기면 ln Z는 점수들의 logsumexp이고, 계가 크면 가장 큰 점수로 거의 정해진다. 여기에 −kT를 곱한 자유에너지 F = −kT ln Z는 큰 계에서 min_E(E − TS(E)), 곧 온도를 환율 삼아 에너지와 엔트로피가 겨룬 결과이며, 이 최소화는 계와 열원을 합친 전체 엔트로피의 최대화와 같다. 볼츠만 분포로는 F = ⟨E⟩ − TS가 정확히 성립하고, F(T)는 E(S)를 기울기 T로 다시 쓴 르장드르 변환이며, ln Z를 β로 미분하면 평균 에너지와 엔트로피가 나온다. 아무 분포 p의 자유에너지 ⟨E⟩_p − kT H(p)는 F보다 정확히 kT·D_KL(p‖볼츠만 분포)만큼 크므로, 볼츠만 분포가 유일한 최솟값이고 엔트로피 항의 계수가 온도다. 제곱 항 하나는 계수와 상관없이 ½kT를 받지만 변수가 연속일 때만 그렇고, 변수 일부를 합쳐 없애면 남은 변수는 합쳐 없앤 쪽의 자유에너지를 에너지로 갖는다. ML에서는 ELBO가 근사 분포의 음의 자유에너지이고 그 틈이 사후분포와의 KL이며, β-VAE의 β는 온도다. 분류기의 −logsumexp와 RBM의 free_energy는 라벨이나 숨은 유닛을 합쳐 없앤 입력의 자유에너지다.
막힌 곳
이제 우리는 에너지와 경우의 수의 겨루기에서 누가 이기는지 안다. 승자는 E − TS를 가장 작게 하는 에너지이고, 그 최솟값이 자유에너지 −kT ln Z이며, ln Z를 역온도로 한 번 미분하면 승자의 에너지가 마이너스를 달고 나온다. 그런데 승자 혼자서 Z를 채운 것은 아니었다. ln Z와 가장 큰 항의 차이는 입자 수가 열 배 늘 때마다 ½ ln 10씩 자랐고, 그 차이는 승자 근처에서 함께 더해지는 항들이 이루는 봉우리의 폭을 재고 있었다. 3072차원 가우시안 샘플의 에너지도 정확히 1536이 아니라 샘플마다 수십씩 흔들렸다. 평형에 있는 계의 에너지는 평균 주위로 얼마나 흔들리는가? 우리는 ln Z를 한 번만 미분했는데, 흔들림의 크기도 ln Z 어딘가에 적혀 있을까? 그리고 온도를 조금 올렸을 때 평균 에너지가 얼마나 늘어나는지와 이 흔들림은 무슨 관계일까?