10장 — 최대 엔트로피 원리
이 장의 물음
클래스가 세 개인 로지스틱 회귀를 규제 항 없이 끝까지 학습시킨 뒤 두 가지를 세어 보자. 학습 데이터에 클래스별로 400개, 250개, 150개의 샘플이 있었다면, 모델이 샘플마다 내놓은 예측 확률을 클래스별로 모두 더한 값도 소수점 셋째 자리까지 400, 250, 150이다. 그리고 학습이 끝난 교차 엔트로피 손실은 모델이 샘플마다 내놓은 예측 분포의 엔트로피를 평균한 값과 넷째 자리까지 같다. 모델은 정답을 맞히려고 했을 뿐인데, 어째서 데이터에서 센 개수를 그대로 되풀이하고, 손실은 모델 자신의 불확실성과 같아질까?
같은 일은 더 단순한 모델에서도 일어난다. 실수 x 위의 에너지 기반 모델 E_θ(x) = θx²/2를 데이터 {−2, −1, 1, 2}에 최대우도로 맞추면 답은 θ = 0.4이고, 이것은 모델의 x² 평균을 데이터의 x² 평균 2.5에 맞춘 값이다. 데이터에서 모델로 넘어간 것은 이 평균 하나뿐이다. 게다가 softmax도, 에너지 기반 모델도 모두 e^(−에너지)를 합이 1이 되게 나눈(정규화한) 모양을 하고 있다. 곁에 열원이 없는 ML 모델이 왜 이 모양을 해야 하며, 평균을 맞추려고 조정한 매개변수는 왜 역온도와 같은 자리에 서는 것일까?
이 장은 다음 물음에 차례로 답한다.
- 평균 하나만 알고 나머지는 모를 때, 확률을 어떻게 매겨야 모르는 것을 단정하지 않을까?
- 그렇게 매긴 확률은 왜 지수 모양이 될까?
- 평균을 맞추려고 조정한 계수는 왜 역온도와 같은 양일까?
- 최대우도로 학습한 모델은 왜 데이터의 평균을 되풀이하고, 손실이 자신의 불확실성과 같아질까?
- 평균을 듣기 전부터 믿던 분포가 따로 있으면 답이 어떻게 달라질까?
평균만 아는 주사위: 세어서 매기는 확률
친구가 주사위를 수천 번 던지고 나서 기록은 잃어버렸고 평균 눈이 4.5였다는 것만 기억한다고 하자. 공정한 주사위라면 평균이 3.5여야 하니 큰 눈 쪽으로 치우친 주사위임은 분명하다. 다음 한 번을 던질 때 각 눈이 나올 확률을 어떻게 적어야 할까?
역사: 브랜다이스 주사위 문제
이 물음은 미국의 물리학자 에드윈 제인스가 1962년 브랜다이스 대학의 여름학교 강의에서 던진 것이다(강의록은 이듬해 책으로 나왔다). 제인스는 두 준위만 가진 원자가 빛과 에너지를 주고받는 제인스–커밍스 모형(1963)으로도 이름을 남긴 현역 물리학자였다. 주사위를 여러 번 던졌더니 평균 눈이 공정한 주사위의 3.5가 아니라 4.5였다고 할 때, 각 눈의 확률을 어떻게 매겨야 하는가? 이후 「브랜다이스 주사위 문제」라 불리게 된 이 질문에 그가 내놓은 답은 0.054, 0.079, 0.114, 0.165, 0.240, 0.347이었다. 이 답이 어디서 나오는지는 짐작하지 않고 세어서 확인할 수 있다.
후보들과 세어서 얻은 분포
평균 4.5를 지키는 분포는 얼마든지 있다. 몇 가지 후보를 적고, 각 후보가 얼마나 고르게 퍼져 있는지를 엔트로피(nat)로 재어 보자.
| 후보 | 1 | 2 | 3 | 4 | 5 | 6 | 엔트로피 |
|---|---|---|---|---|---|---|---|
| 가. 4와 5만 반반 | 0 | 0 | 0 | 0.5 | 0.5 | 0 | 0.693 |
| 나. 3과 6만 반반 | 0 | 0 | 0.5 | 0 | 0 | 0.5 | 0.693 |
| 다. 3~6을 고르게 | 0 | 0 | 0.25 | 0.25 | 0.25 | 0.25 | 1.386 |
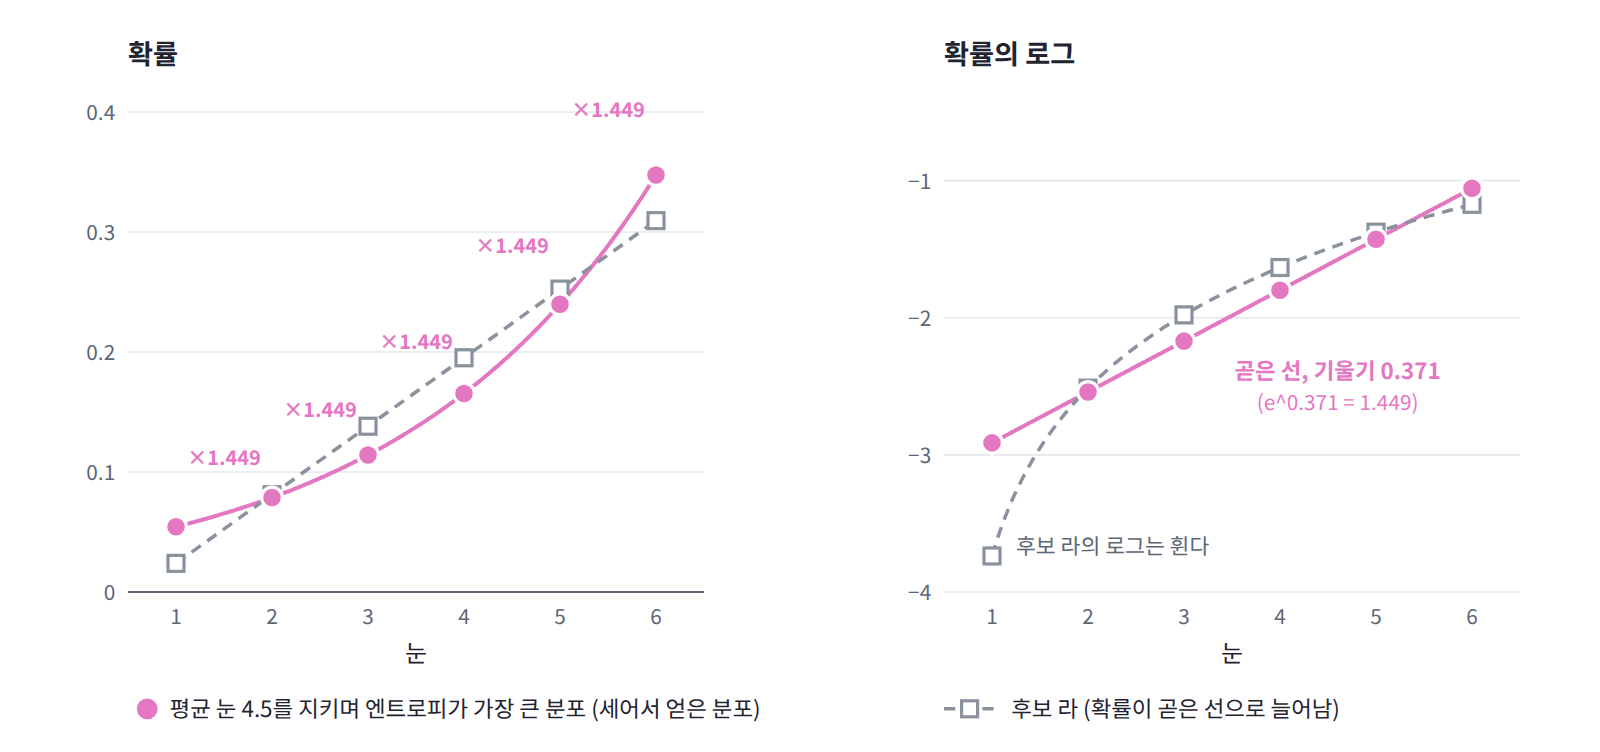
| 라. 곧은 선으로 늘어나게 | 0.024 | 0.081 | 0.138 | 0.195 | 0.252 | 0.310 | 1.595 |
넷 모두 평균은 정확히 4.5다. 그런데 가와 나는 친구가 말하지 않은 것을 단정한다. 1, 2, 3, 6이 한 번도 나오지 않았다는 말은 들은 적이 없는데 확률을 0으로 적었기 때문이다. 다도 1과 2를 지웠다. 라는 모든 눈을 살려 두었지만, 확률이 눈에 대해 곧은 선으로 늘어난다는 가정은 어디서 왔는지 알 수 없다. 어느 후보도 평균 말고는 아무것도 가정하지 않았다고 말하기 어렵다.
그래서 이번에는 짐작하지 말고 세어 보자. 주사위를 N번 던져 나올 수 있는 눈의 수열은 6^N가지이고, 평균 말고는 아무것도 모르므로 이 수열들 사이에 차별을 두지 않는다. 그중 평균이 정확히 4.5인 수열, 곧 눈의 합이 4.5N인 수열만 남기고, 남은 수열 가운데 첫 굴림이 1, 2, …, 6인 것이 각각 몇 개인지 센다. N = 2이면 합이 9인 수열은 (3, 6), (4, 5), (5, 4), (6, 3) 네 개뿐이므로 첫 굴림은 3~6이 4분의 1씩이고, 후보 다와 같다. N = 4이면 합이 18인 수열은 80개이고, 첫 굴림이 1~6인 것은 차례로 3, 6, 10, 15, 21, 25개다. 굴림 수를 늘려 가며 같은 비율을 계산하면 다음과 같다.
| N | 1 | 2 | 3 | 4 | 5 | 6 | 엔트로피 |
|---|---|---|---|---|---|---|---|
| 4 | 0.0375 | 0.0750 | 0.1250 | 0.1875 | 0.2625 | 0.3125 | 1.6058 |
| 10 | 0.0473 | 0.0770 | 0.1191 | 0.1755 | 0.2473 | 0.3338 | 1.6123 |
| 100 | 0.0537 | 0.0786 | 0.1146 | 0.1664 | 0.2405 | 0.3462 | 1.6136 |
| 1000 | 0.0543 | 0.0788 | 0.1142 | 0.1655 | 0.2398 | 0.3474 | 1.6136 |
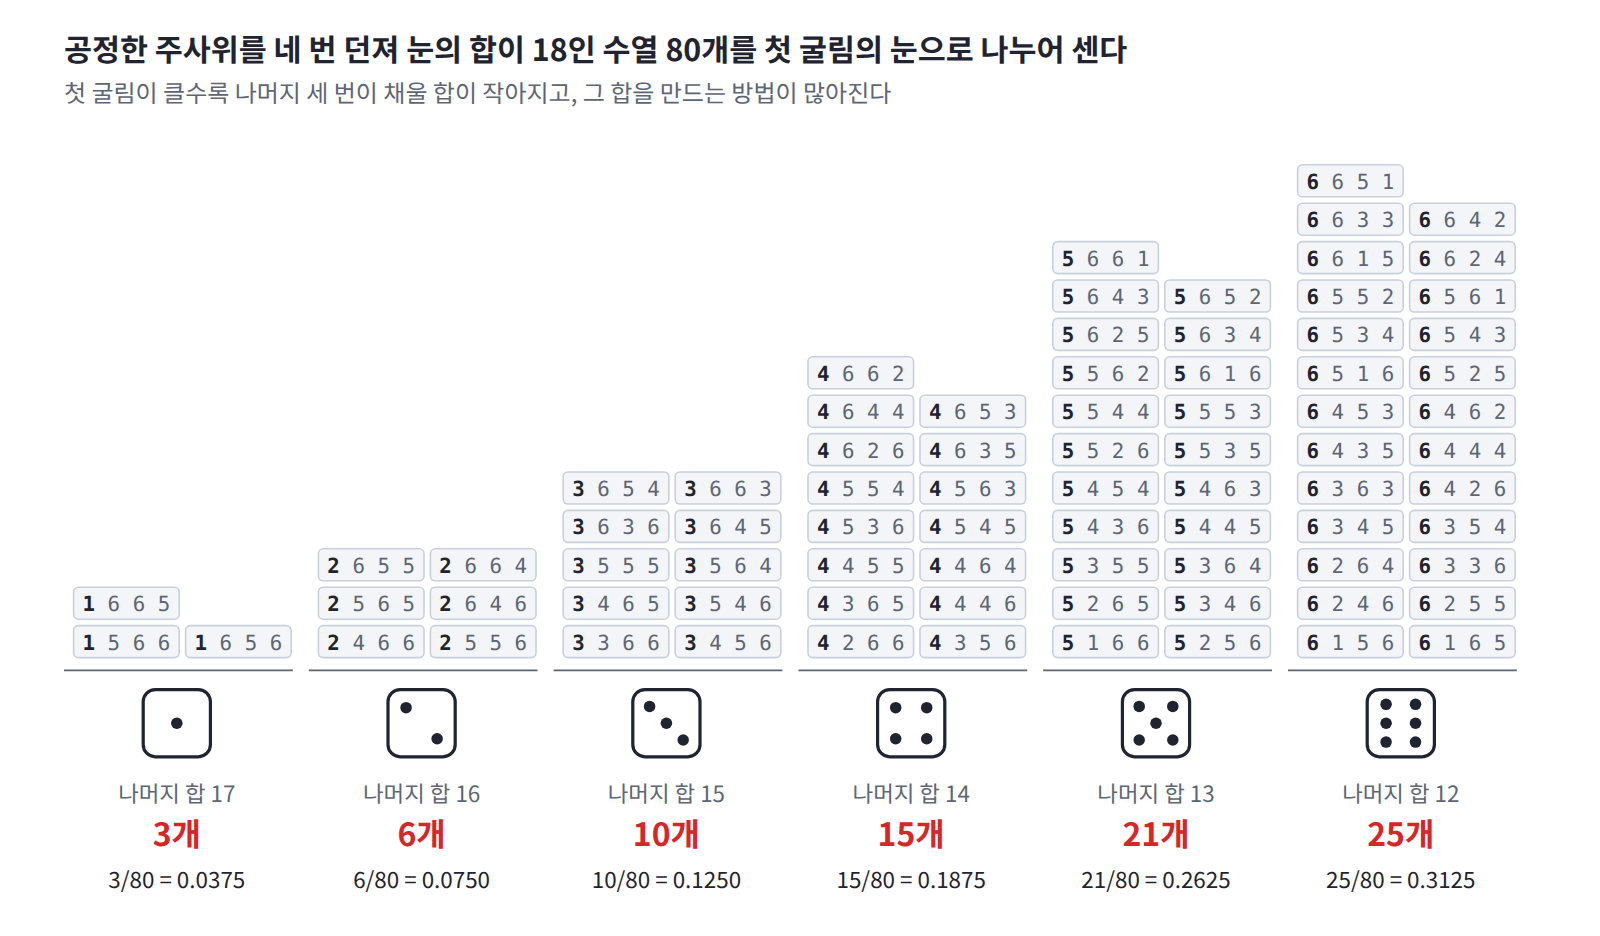
N = 1000이면 평균이 정확히 4.5인 수열만 해도 10⁶⁹⁸개가 넘지만, 첫 굴림의 비율은 넷째 자리에서만 조금씩 움직일 뿐 한 분포에 자리를 잡는다. 제인스가 내놓은 답과 같은 분포다. 이 분포의 엔트로피 1.6136은 네 후보 어느 것보다 크고, 후보 라의 1.595보다도 크다. 세어서 얻은 분포는 어떤 모양일까? 후보 라처럼 눈에 대해 곧은 선으로 늘어날까?
이웃한 눈의 확률 비
세어서 얻은 비율에서 이웃한 두 눈의 확률 비, 곧 (눈 2의 확률)/(눈 1의 확률), (눈 3의 확률)/(눈 2의 확률), …을 차례로 계산해 보자.
| N | 2/1 | 3/2 | 4/3 | 5/4 | 6/5 |
|---|---|---|---|---|---|
| 10 | 1.628 | 1.547 | 1.474 | 1.409 | 1.350 |
| 100 | 1.465 | 1.458 | 1.452 | 1.445 | 1.439 |
| 1000 | 1.451 | 1.450 | 1.450 | 1.449 | 1.448 |
굴림 수가 늘어날수록 다섯 개의 비가 한 값 1.449로 모인다. 눈이 하나 커질 때마다 확률이 같은 배수로 늘어난다는 뜻이므로, 확률은 눈의 지수함수이고 그 로그는 눈에 대해 곧은 선이다. 1.449 = e^0.371이므로 한 번의 굴림에서 눈 k가 나올 확률은 e^(0.371k)에 비례하고, 여섯 값의 합이 1이 되도록 나누면 (0.0544, 0.0788, 0.1142, 0.1654, 0.2398, 0.3475)를 얻는다. 곧은 선으로 늘어나는 것은 확률 자체가 아니라 확률의 로그였다. 후보 라는 곧은 선을 잘못된 곳에 그은 셈이다.
왜 지수함수가 나오는지는 센 방법을 다시 보면 알 수 있다. 첫 굴림이 f이면 나머지 N − 1번의 굴림이 합 4.5N − f를 채워야 하므로, 첫 굴림이 f인 수열의 수는 나머지 굴림이 그 합을 만드는 방법의 수와 같다. 첫 굴림의 눈이 1 늘면 나머지 굴림이 채워야 할 합은 1 준다. 그 합은 나머지 굴림이 공정하게 나올 때의 평균(굴림마다 3.5)보다 크므로, 합이 작아질수록 그 합을 만드는 방법은 많아진다. N = 10에서 실제로 세어 보자.
| 첫 굴림 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| 나머지 아홉 번이 채울 합 | 44 | 43 | 42 | 41 | 40 | 39 |
| 그 합을 만드는 방법의 수 | 39,303 | 63,999 | 98,979 | 145,899 | 205,560 | 277,464 |
| 방법의 수의 로그 | 10.579 | 11.067 | 11.503 | 11.891 | 12.234 | 12.533 |
로그는 이웃끼리 0.488, 0.436, 0.388, 0.343, 0.300씩 늘어난다. 늘어나는 양이 고르지 않으니 이웃한 눈의 확률 비 e^0.488 = 1.628, e^0.436 = 1.547, …도 고르지 않고, 이것이 위 비 표의 N = 10 줄이다. 나머지가 아홉 번뿐이라 첫 굴림 하나가 나머지 굴림이 채울 합을 눈에 띄게 바꾸기 때문이다. 나머지가 99번(N = 100)이면 같은 차이가 0.382, 0.377, 0.373, 0.368, 0.364로 거의 같아지고, 굴림 수가 더 늘면 모두 0.371에 다가간다. 로그가 같은 양씩 늘면 방법의 수는 같은 비율로 늘고, 그 비율이 이웃한 눈의 확률 비로 나타난다. 열원과 맞닿은 작은 계에서 볼츠만 인자가 나오는 것과 같은 계산이고, 여기서는 나머지 굴림들이 열원 노릇을 한다.
ML에서: 로짓은 확률의 로그다
softmax는 로짓 zᵢ를 받아 pᵢ = e^(zᵢ)/Σⱼe^(zⱼ)를 내놓으므로, 두 클래스의 확률 비는 e^(zᵢ − zⱼ)이다. 로짓이 1 커질 때마다 확률은 e ≈ 2.718배가 되고, 로짓은 확률의 로그에서 모든 클래스에 공통인 상수를 뺀 것이 된다. 주사위에서 곧은 선으로 늘어나는 것이 확률이 아니라 확률의 로그였듯, 선형 분류기가 입력의 일차식으로 다루는 것도 확률 자체가 아니라 확률의 로그다.
문제 1. 평균 2,500원짜리 빵집
동네 빵집은 1천 원, 2천 원, 3천 원짜리 빵 세 가지만 팔고, 손님은 빵을 하나씩만 산다. 주인은 오늘 손님 한 사람이 평균 2,500원을 썼다는 것만 기억한다. (가) 손님이 넷이었고 넷이 쓴 돈이 모두 1만 원이라면, 첫 손님이 산 빵이 1천·2천·3천 원짜리일 확률은 각각 얼마인가? 네 사람이 산 빵의 목록으로 가능한 것을 모두 똑같이 믿고 세어 보라. (나) 손님이 아주 많았다면 그 확률은 어떻게 되는가?
평균이 2,500원이면 2천 원짜리와 3천 원짜리가 반반 팔렸다고 보면 딱 맞아요. 첫 손님은 2천 원 0.5, 3천 원 0.5, 1천 원은 0이요.

1천 원짜리를 산 손님이 아무도 없었다는 말은 들었나요? 넷이 1만 원을 쓰는 목록을 하나도 빼지 말고 세어 볼까요?

첫 손님이 1천 원이면 나머지 셋이 9천 원이라 셋 다 3천 원, 한 가지예요. 2천 원이면 나머지가 8천 원이라 (2, 3, 3)을 늘어놓는 세 가지고요. 3천 원이면 나머지가 7천 원이라 (1, 3, 3)이 세 가지, (2, 2, 3)이 세 가지로 여섯 가지예요. 모두 10가지니까 (0.1, 0.3, 0.6)이네요.
이웃끼리 비를 보면 0.3/0.1 = 3, 0.6/0.3 = 2라서 같지가 않아. 주사위에서는 굴림이 많아지면 이웃 비가 한 값으로 모였잖아. 손님이 넷뿐이라 그런 건가?

손님 수를 늘려서 확인해 볼래요?

코드로 세어 보니 손님 열 명이면 (0.107, 0.285, 0.607), 백 명이면 (0.115, 0.269, 0.615), 천 명이면 (0.116, 0.268, 0.616)이에요. 이웃 비가 2.306과 2.301로 거의 같아졌어요.
그럼 손님이 아주 많을 때의 답은 직접 풀 수 있어. 이웃 비를 r로 두면 확률은 1 : r : r²에 비례하고, 평균이 2.5니까 (1 + 2r + 3r²)/(1 + r + r²) = 2.5야. 정리하면 r² − r − 3 = 0이라 r = (1 + √13)/2 = 2.303이고, 확률은 (0.116, 0.268, 0.616)이야.

제가 처음에 1천 원을 0으로 둔 건 손님이 둘뿐일 때의 답이었네요. 둘이 5천 원이면 정말 (2, 3), (3, 2)밖에 없으니까요.
조별 과제 평균이 B+라는 것만 듣고 「그럼 다들 B 아니면 A를 받았겠네」 하는 거랑 같아요. C를 받은 사람이 없다는 말은 아무도 안 했는데요.