코드 길이: 예측기가 곧 압축기
이 장의 물음
결과마다의 놀라움 −log₂ p를 확률로 평균한 엔트로피는 평균 코드 길이가 내려갈 수 있는 바닥이다. 하지만 앞에서는 비율이 마침 1/2, 1/4, 1/8인 약어 사전에 코드 하나를 주어 보았을 뿐, 길이를 어떻게 정해야 하는지, 0.322비트처럼 1비트보다 짧은 길이는 어떻게 내는지는 해 보지 않았다. 확률이 정해 주는 길이를 실제 비트열로 내려면 무엇이 필요하고, 그 길이는 바닥에 얼마나 붙을 수 있을까?
언어 모델을 학습시켜 본 사람은 학습 기록에 스텝마다 찍히는 손실 값이라는 숫자 하나를 매일 들여다본다. 논문은 같은 모델의 성능을 퍼플렉서티로 적고, 압축 대회는 「바이트당 비트」로 적는다. 다음 토큰을 잘 맞히는 모델이 글을 짧게 줄인다는 말도 자주 듣는다. 하지만 모델이 내놓는 것은 「다음 토큰이 '다’일 확률」 같은 확률이지 0과 1로 된 비트열이 아니다. 확률이 어떻게 실제 파일의 길이가 될까?
- 0과 1로 말을 적을 때, 왜 모든 말에 짧은 코드를 줄 수는 없을까?
- 말마다 나오는 비율을 알면 코드의 길이를 어떻게 정해야 평균이 가장 짧을까? 그 길이가 1.4비트처럼 정수가 아니면 어떻게 할까?
- 다음 글자의 확률을 내는 예측기 하나를 그대로 압축기로 쓸 수 있을까? 거꾸로 압축기는 예측기일까?
- 언어 모델의 손실, 퍼플렉서티, 바이트당 비트는 서로 어떤 관계일까?
크래프트 부등식: 짧은 코드는 나눠 가질 수밖에 없다
휴대폰 문자에서 자주 쓰는 말을 단축어로 등록해 두면 글이 짧아지는데, 0과 1만 쓰는 통신에서도 같은 생각을 할 수 있다. 네 가지 말 「가」「나」「다」「라」를 0과 1의 줄로 바꿔 보낸다고 하자. 어떤 말을 0과 1로 바꾸는 규칙과 그렇게 나온 0·1의 줄을 코드라 부르고, 코드의 0·1 하나를 1비트로 센다. 모든 말에 한 비트짜리 코드를 주면 가장 짧겠지만, 0과 1 두 가지로는 말 두 개밖에 가르지 못한다. 그렇다면 「가」에 0, 「나」에 1, 「다」에 01을 주면, 받는 사람에게 「01」이 왔을 때 「가나」인지 「다」인지 알 수 없다. 끊어 읽을 표시 없이 코드를 이어 보내려면, 어떤 말에 짧은 코드를 주는 대가로 다른 말은 길어져야 한다. 그 대가는 얼마일까?
역사: 쉼표 없이 보내기
전신 시대의 모스 부호도 같은 고민을 안고 있었다. 영어에서 가장 흔한 E에는 점 하나, T에는 선 하나를 주는 식으로 흔한 글자에 짧은 코드를 주었다. 그 대신 글자와 글자 사이를 잠깐 쉬어야 했다. 점과 선만으로는 「점 하나 뒤 선 하나」가 E 다음 T인지, 점과 선으로 된 다른 글자인지 구분할 수 없기 때문이다. 글자 사이의 쉼은 사실상 셋째 기호이고, 그만큼 시간을 쓴다.
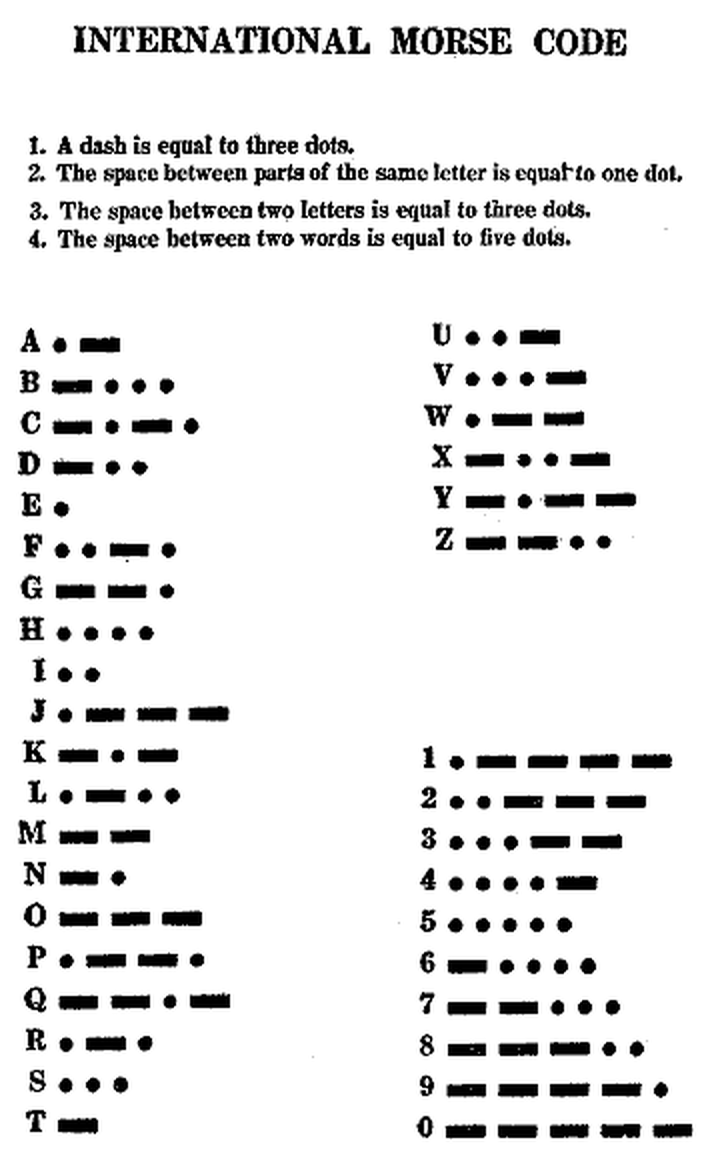
1948년 섀넌(Claude Shannon)이 통신의 수학 이론을 낸 바로 뒤, MIT 전기공학과의 크래프트(Leon G. Kraft)는 1949년 석사 논문 「진폭 변조 펄스를 양자화하고 묶어 코딩하는 장치」에서 쉼 없이 끊어 읽을 수 있는 코드가 어떤 길이를 가질 수 있는지를 한 줄의 조건으로 적었다. 제목만 보면 장치를 만드는 논문인데, 오늘날 정보 이론 교과서는 끊어 읽을 수 있는 코드의 길이 조건에 그의 이름을 붙여 부른다.
끊어 읽기가 문제면 말 사이에 구분 기호를 하나 넣으면 되잖아요. 파일도 줄을 바꿀 때 줄바꿈 문자를 넣고요.
모스 부호가 한 일이 그거예요. 글자 사이를 잠깐 쉬었죠. 그런데 그 쉼도 전선 위에서 시간을 써요. 점, 선, 쉼 세 가지를 쓰면 더는 두 기호만 쓰는 코드가 아니고요.
그럼 쉼 없이 점과 선만으로 끊어 읽히게 짜면 되겠네요. 그런데 길이를 미리 정해 두고, 그 길이로 그런 코드가 나오는지는 어떻게 알아요? 하나하나 만들어 봐야 하나요?
크래프트가 조건을 한 줄로 적기 전에는 만들어 보는 것 말고 알려진 기준이 없었어요. 섀넌이 정보를 비트로 측정하는 이론을 낸 것도 바로 한 해 전이었고요. 코드의 길이를 예산처럼 계산하는 말 자체가 막 생기던 때예요.
말이 수십 개면 길이를 이렇게 저렇게 바꿔 가며 만들어 보는 데만 한참 걸리겠네요. 안 되는 길이 목록이면 끝까지 해 봐도 안 되는 거고요.
길이 목록만 보고 된다, 안 된다를 판별하려면, 코드 하나가 무엇을 얼마나 차지한다고 계산해야 할까요?
네 말에 코드 주기
앞의 실패에서 무엇이 문제였는지 보자. 「다」의 코드 01이 「가」의 코드 0으로 시작했다. 그래서 받는 사람은 0을 읽은 순간 「가」로 끝낼지 다음 비트를 더 읽을지 정할 수 없다. 이런 일이 없으려면 어떤 코드도 다른 코드의 앞부분이 되지 않게 하면 되는데, 이런 코드를 프리픽스 코드(prefix code)라 한다. 크로스 엔트로피를 셀 때 쓴 약어 사전의 코드표 가 = 0, 나 = 10, 다 = 110, 라 = 111이 그런 코드다.
이 코드표로 0101100111을 받았다고 하자. 앞에서부터 읽다가 코드표에 있는 줄이 나오는 순간 끊으면 0 | 10 | 110 | 0 | 111, 곧 「가나다가라」다. 0으로 시작하면 「가」뿐이고, 10은 「나」뿐이므로 망설일 자리가 없다.
코드 하나를 이진 소수의 앞자리로 읽어서 이 코드표가 [0, 1) 구간을 어떻게 나눠 갖는지 보면 대가가 보인다. 0으로 시작하는 이진 소수 0.0…은 모두 [0, 0.5)에 있으니, 코드 0이 가리키는 구간은 [0, 0.5)이고 길이는 1/2이다. 10으로 시작하는 0.10…은 [0.5, 0.75)에 있으니 코드 10의 구간 길이는 1/4, 110은 1/8이다. 이렇게 한 코드로 시작하는 이진 소수가 모두 들어 있는 구간을 그 코드의 구간이라 부르자. 길이가 ℓ비트인 코드의 구간 길이는 늘 2^(−ℓ)이다. 프리픽스 코드라면 한 코드가 다른 코드로 시작하지 않으므로 코드 구간들이 서로 겹치지 않는다. 겹치지 않는 구간의 길이를 모두 더하면 [0, 1)의 길이 1을 넘을 수 없다.
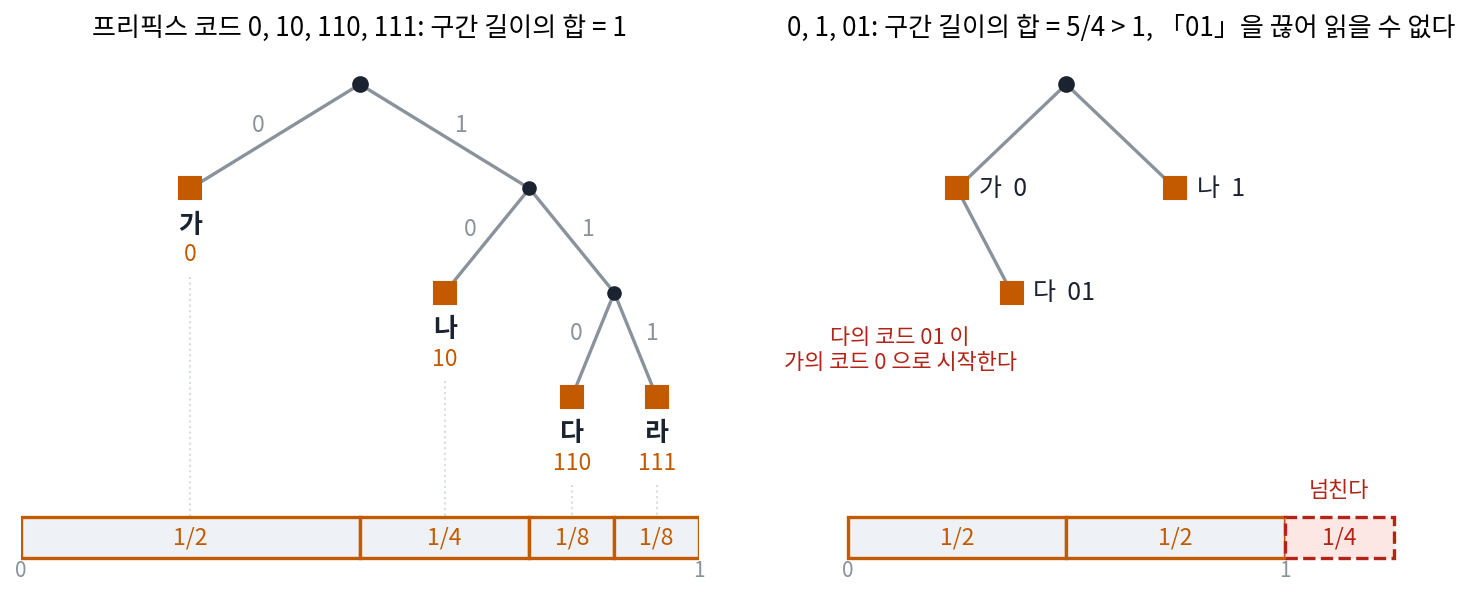
거꾸로 구간 길이 2^(−ℓ)의 합이 1을 넘지 않으면 프리픽스 코드를 늘 만들 수 있다. 짧은 코드부터 차례로 [0, 1)의 왼쪽부터 길이 2^(−ℓ)짜리 구간을 붙여 놓으면 된다. 짧은 것부터 놓으므로 각 구간의 왼쪽 끝은 늘 그 구간 길이로 나누어떨어지는 수에 오고, 그 왼쪽 끝을 이진 소수로 적은 앞 ℓ자리가 코드가 된다. 이렇게 길이 목록만 보고 프리픽스 코드가 있는지를 판별하는 조건을 크래프트 부등식 (코드 길이의 예산, Kraft inequality)이라 한다.
가나다라의 코드표는 1/2 + 1/4 + 1/8 + 1/8 = 1로 예산을 꼭 맞게 썼다. 그래서 이 코드표에 말을 하나 더 넣으려면 누군가의 코드를 늘려야 한다. 0, 1, 01은 1/2 + 1/2 + 1/4 = 5/4로 예산을 넘었으니, 어떻게 0과 1을 고쳐 배치해도 이 길이로는 프리픽스 코드를 만들 수 없다.
코드 구간의 길이 2^(−ℓ)은 모두 양수이고 합이 1 이하이므로 확률처럼 보인다. 실제로 길이 ℓ을 준다는 것은 그 말에 확률 2^(−ℓ)을 부여한다는 것과 같고, 거꾸로 확률을 부여하면 길이 −log₂(확률)이 정해진다. 1비트는 확률 1/2, 3비트는 1/8이다. 코드의 길이를 정하면 확률이 정해지고 확률을 정하면 코드의 길이가 정해진다는 이 관계가 이 장 전체의 기반이다.
ML에서: 소프트맥스의 합은 왜 1일까?
언어 모델은 다음 토큰의 확률을 소프트맥스로 내므로, 어휘가 5만 개라면 5만 개의 확률을 모두 더해 1이 되게 나눈다. 크래프트 부등식의 눈으로 보면, 이 나눗셈은 5만 개 토큰이 길이 1인 [0, 1)을 코드 구간으로 나눠 갖게 하는 일이다. 모델이 한 토큰의 확률을 높여 그 코드를 짧게 하면 다른 토큰의 확률은 그만큼 낮아지고 코드는 길어진다. 학습이 손실을 줄인다는 것은 이 고정된 예산을 실제로 자주 나오는 토큰 쪽으로 옮기는 일이다. 합이 1이라는 조건을 빼면 무슨 일이 생기는지는 아래 문제 3에서 검토한다.
문제 1. 국가 번호는 왜 겹치지 않을까
국제 전화를 걸 때 누르는 국가 번호는 북미 여러 나라가 함께 쓰는 1, 러시아·카자흐스탄의 7처럼 한 자리인 것과 한국 82, 일본 81, 중국 86처럼 두 자리인 것이 섞여 있다. 그런데 「8」 한 자리나 「820」 세 자리 국가 번호는 없다. (가) 한 자리 「8」과 세 자리 「820」이 국가 번호로 쓰이지 않는 것은 왜인지 코드의 말로 설명하라. (나) 1이나 7로 시작하는 번호가 모든 전화번호 가운데 차지하는 비율은 얼마이고, 두 자리 국가 번호는 많아야 몇 개까지 둘 수 있는가?
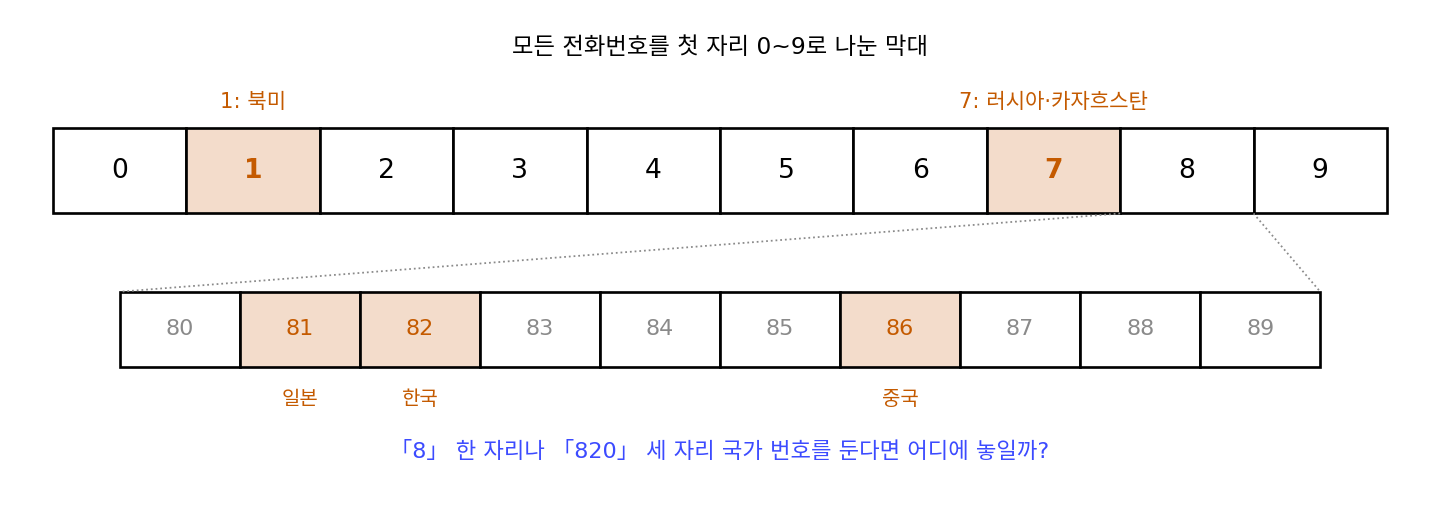
「820」이 국가 번호라면, 82를 누른 순간 교환기는 한국으로 넘길지 0을 더 기다릴지 정할 수가 없어요. 82가 한국으로 정해져 있으니 그 뒤에 오는 0은 한국 안의 번호로 읽히고요.
「8」 한 자리도 같은 이유겠네. 8을 누르자마자 그 나라로 넘어가 버리면 81, 82, 86을 못 쓰잖아.
그래요. 어떤 국가 번호도 다른 국가 번호의 앞부분이 아니에요. 프리픽스 코드죠. 그럼 (나)는요? 이번에는 0부터 9까지 열 가지 숫자로 적는 코드예요.
한 자리 번호 하나가 모든 전화번호의 10분의 1씩이니까, 1과 7로 시작하는 번호가 5분의 1이에요.
남은 5분의 4에 두 자리 번호를 채운다면 몇 개나 들어갈까요?
두 자리 번호 하나가 100분의 1이니까 80개요. 크래프트 부등식에서 2 대신 10을 쓴 거네요. 한 자리 둘이 2/10, 두 자리 80개가 80/100, 더하면 꼭 1이고요.
실제로는 세 자리 국가 번호도 많아요. 두 자리를 80개 다 쓰지 않으면 어떻게 될까요?
비워 둔 두 자리 하나마다 세 자리 번호 열 개가 들어갈 자리가 생기네요. 85를 국가 번호로 안 쓰면 850~859를 쓸 수 있고요. 북한 850, 홍콩 852가 그렇게 들어간 번호겠네요.
문제 2. 이 길이로 코드를 만들 수 있을까
말 몇 개에 다음 길이의 프리픽스 코드를 주려 한다. 각각 만들 수 있는가? 만들 수 있으면 코드를 하나 적어라. (가) 네 말에 1, 2, 2, 3비트 (나) 다섯 말에 2, 2, 2, 3, 3비트 (다) (나)의 다섯 말에 여섯째 말을 더해 3비트를 주고 싶다.
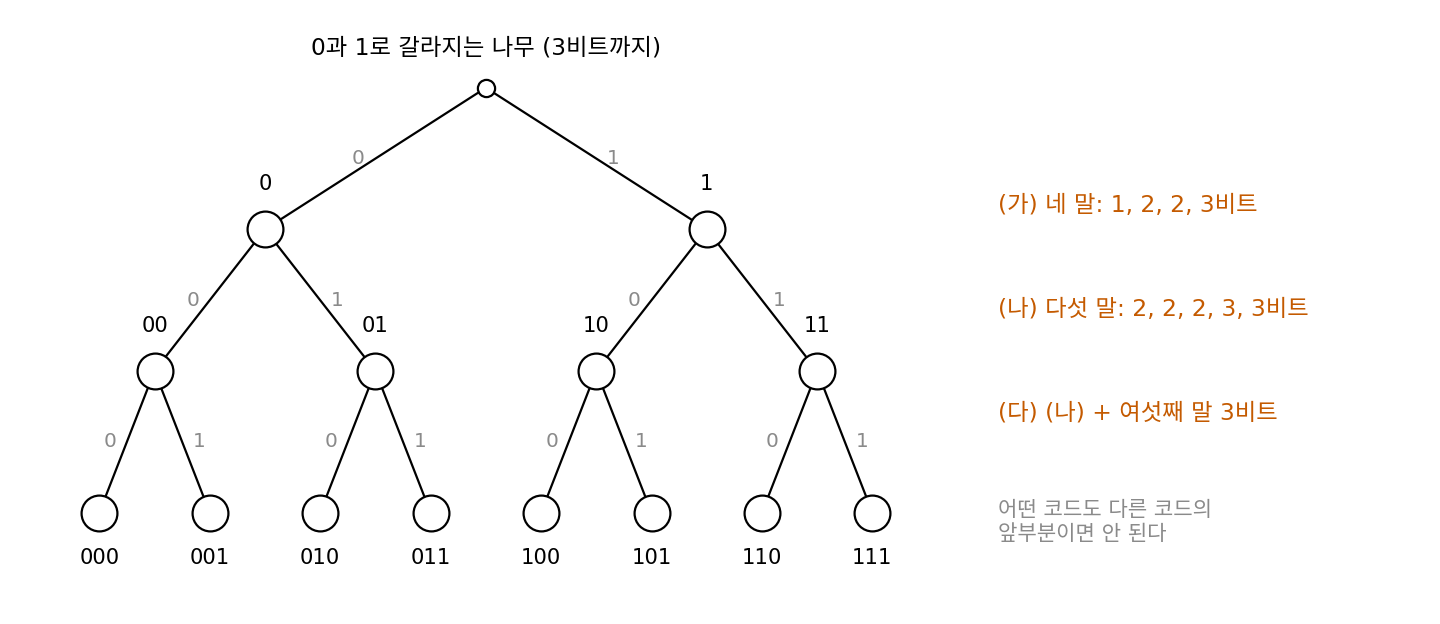
구간 길이 2^(−ℓ)부터 더해 볼게요. (가)는 1/2 + 1/4 + 1/4 + 1/8 = 9/8이에요. 1을 넘으니까 안 돼요.
정말 어떤 배치로도 안 될까요? 코드를 놓는 순서를 바꾸면요?
[0, 1)에서 1비트 코드가 절반, 2비트 둘이 4분의 1씩 가져가면 그것만으로 [0, 1)이 꽉 차요. 어디에 놓든 3비트 코드가 들어갈 8분의 1이 안 남아요.
(나)는 1/4 셋이 3/4, 1/8 둘이 1/4이라서 딱 1이에요. 00, 01, 10, 110, 111로 하면 돼요.
그럼 (다)는요? 여섯째 말에 3비트를 주려면요?
그대로 더하면 9/8이라 안 돼요.
기존 말의 코드를 바꿔도 된다면요?
음… 길이를 줄이면 합이 더 커지니까 늘려야겠네요. 2비트 하나를 3비트 둘로 쪼개면 1/4이 1/8 + 1/8이 돼서 합이 다시 1이에요. 10을 100과 101로 나누고 하나를 여섯째 말에 주면 돼요.
그 대가는 누가 치르나요?
10을 쓰던 말이 1비트를 더 써요. 예산이 꽉 찬 코드표에 말을 더하려면 누군가 한 자리씩 늘어나야 하네요.
여행 가서 방 다섯 개를 다섯 명이 하나씩 쓰는데 한 명이 더 오면, 누군가 자기 방을 나눠 써야 하는 거랑 같네요.
문제 3. 합이 1이 아닌 확률로 만든 코드
어떤 모델이 어휘 네 토큰에 소프트맥스 대신 토큰마다 따로 시그모이드를 내서 0.9, 0.8, 0.7, 0.6을 주었다. 네 값을 확률로 믿고 코드 길이 −log₂(값)을 주면 네 토큰의 길이는 각각 몇 비트인가? 이 길이로 프리픽스 코드를 만들 수 있는가? 이 모델을 「정답 토큰의 −log₂(값)」으로 학습시키면 어떤 일이 생기겠는가?
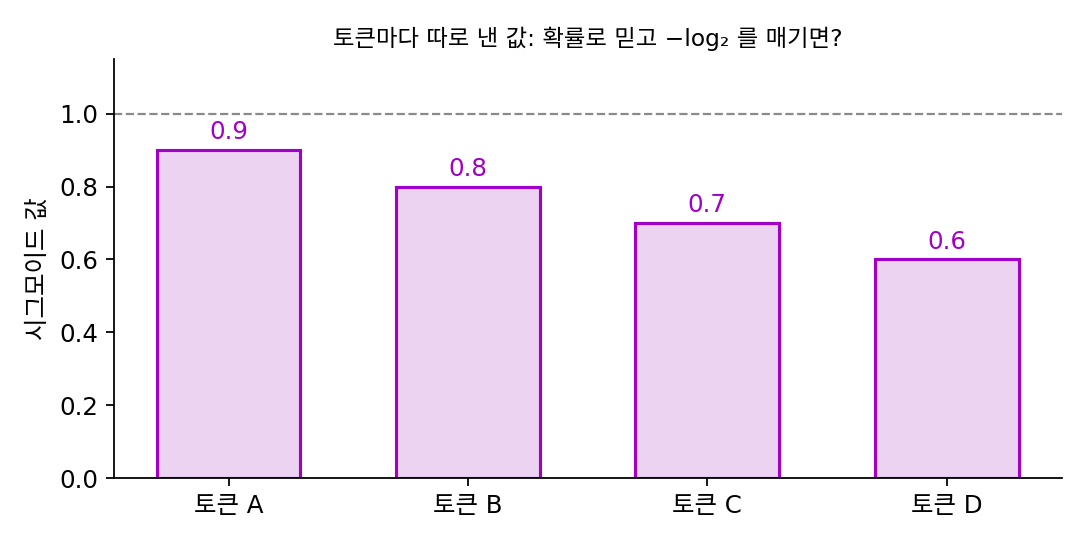
−log₂ 0.9 = 0.152, −log₂ 0.8 = 0.322, −log₂ 0.7 = 0.515, −log₂ 0.6 = 0.737비트예요. 어느 토큰이 와도 1비트가 안 되네요. 좋은 모델 아니에요?
그 길이로 크래프트 부등식을 확인해 볼까요?
길이가 −log₂(값)이니까 2^(−ℓ)을 하면… 로그를 되돌리는 거라 그냥 원래 값이 나오네요. 그럼 0.9 + 0.8 + 0.7 + 0.6 = 3.0이에요.
3.0이면 예산 1을 얼마나 넘은 거야?
세 배를 쓴 거야. 이런 코드는 있을 수가 없어. 문제 2의 (가)는 9/8만 돼도 안 됐잖아.
그럼 손실이 낮게 나와도 그건 실제로 낼 수 없는 코드 길이였던 거네요. 좋은 모델이라고 한 건 성급했어요. 이대로 학습시키면… 정답이 뭐든 네 값을 모두 1로 올리면 손실이 다 0이 되겠는데요?
그래요. 합이 1이라는 묶음이 없으면, 모든 토큰의 확률을 함께 올리는 쉬운 길이 열려요. 그러면 모델은 무엇이 정답인지 하나도 배우지 않고도 손실을 줄일 수 있어요. 합으로 나눠 확률을 만들면 어떻게 되나요?
3.0으로 나누면 0.3, 0.267, 0.233, 0.2가 되고 길이는 1.737, 1.907, 2.100, 2.322비트예요.
나누기 전의 길이와 하나씩 비교해 볼까요?
0.152가 1.737이 됐으니까… 차이가 1.585비트. 다른 것도 다 그만큼이에요. 모든 길이에 log₂ 3.0 = 1.585비트가 똑같이 더해졌어요. 나누기 전의 손실은 그만큼을 빼먹고 있었던 거예요.
별점을 모든 가게에 다섯 개씩 주는 친구가 있으면, 그 친구의 다섯 개는 아무 가게도 선택해 주지 못하잖아요. 어딘가에는 덜 줘야 별점이 무언가를 말해 주는데, 확률의 합이 1이라는 게 그 묶음이네요.