디노이징과 조건부 디노이징: 고치다 보면 만들게 된다
이 장의 물음
휴대폰 사진 앱에는 사진 속 지나가는 사람을 손가락으로 문지르면 지우고, 그 자리를 뒤의 배경으로 채워 주는 기능이 있다. 오래된 가족사진의 긁힌 자국을 메워 주는 서비스도 있다. 이런 「고치기」를 가르치는 일은 의외로 쉽다. 멀쩡한 사진에 일부러 흠집을 내면, 흠집 난 사진과 고쳐야 할 정답(원래 사진)이 한꺼번에 생긴다. 정답이 하나로 분명하니 신경망에게 그 정답을 맞히라고 하면 된다.
새 그림을 「만들기」는 그렇지 않았다. 「3을 하나 그려 봐」에는 정답이 하나로 정해지지 않아서, 오토인코더는 그림 자신을 정답으로 삼았고, VAE 는 잠재 변수가 놓일 자리를 사전분포 N(0, I) 안으로 모으는 장치까지 붙여야 했다. 그러고도 디코더는 뽑은 잠재 변수 하나에서 784칸을 한 번에 그려야 했다. 고치기는 쉽고 만들기는 어렵다. 그렇다면 고치는 법만 가르쳐서 만들게 할 수는 없을까? 이 장은 다음 물음을 따라간다.
- 일부러 망가뜨린 그림을 되살리도록 배운 신경망은 무엇을 배울까? 많이 망가뜨릴수록 되살린 그림은 어떻게 될까?
- 얼마나 망가졌는지를 함께 알려 주면 고치는 솜씨가 달라질까?
- 고치는 법만 배운 신경망에 아무 그림도 담기지 않은 순수한 잡음을 주면 무엇이 나올까?
디노이징 오토인코더: 일부러 망가뜨린 그림을 되살리기
오토인코더는 받은 그림을 그대로 되살리도록 배운다. 가운데를 좁은 목으로 조이지 않으면 받은 것을 그대로 내보내는 지루한 함수가 되고, 아무것도 배우지 않는다. 시험에 비유하면 문제지에 답을 적어 주고 답을 쓰라는 셈이다. 같은 문제지라도 빈칸을 뚫어 놓으면 사정이 달라진다. 앞뒤 문맥을 알아야 빈칸을 채울 수 있다. 목을 조이는 대신 입력을 일부러 망가뜨려 베끼지 못하게 하면, 신경망은 무엇을 배우게 될까?
역사: 가려도 알아보는 특징
2008년 몬트리올 대학교의 뱅상(Pascal Vincent), 라로셸(Hugo Larochelle), 벤지오(Yoshua Bengio), 만자골(Pierre-Antoine Manzagol)이 국제 머신러닝 학회(ICML)에 낸 논문 「잡음을 걷어 내는 오토인코더로 튼튼한 특징을 뽑고 쌓기(Extracting and Composing Robust Features with Denoising Autoencoders)」가 이 물음에서 출발했다. 그때는 층이 깊은 신경망을 처음부터 학습하기가 어려워서, 층마다 먼저 라벨 없이 쓸 만한 중간 표현을 배워 두고 그 위에서 학습을 시작하는 방법이 쓰였다. 그런데 무엇이 「쓸 만한 표현」인지는 거의 알려지지 않았다. 네 사람은 입력이 일부 부서져도 거의 같은 표현이 나와야 한다는 기준을 내세웠고, 사람이 가려지거나 망가진 그림도 알아본다는 것을 그 근거로 들었다. 방법은 단순했다. 입력 칸 가운데 정해진 비율을 무작위로 골라 0으로 지우고, 지우기 전의 입력을 되살리게 했다.
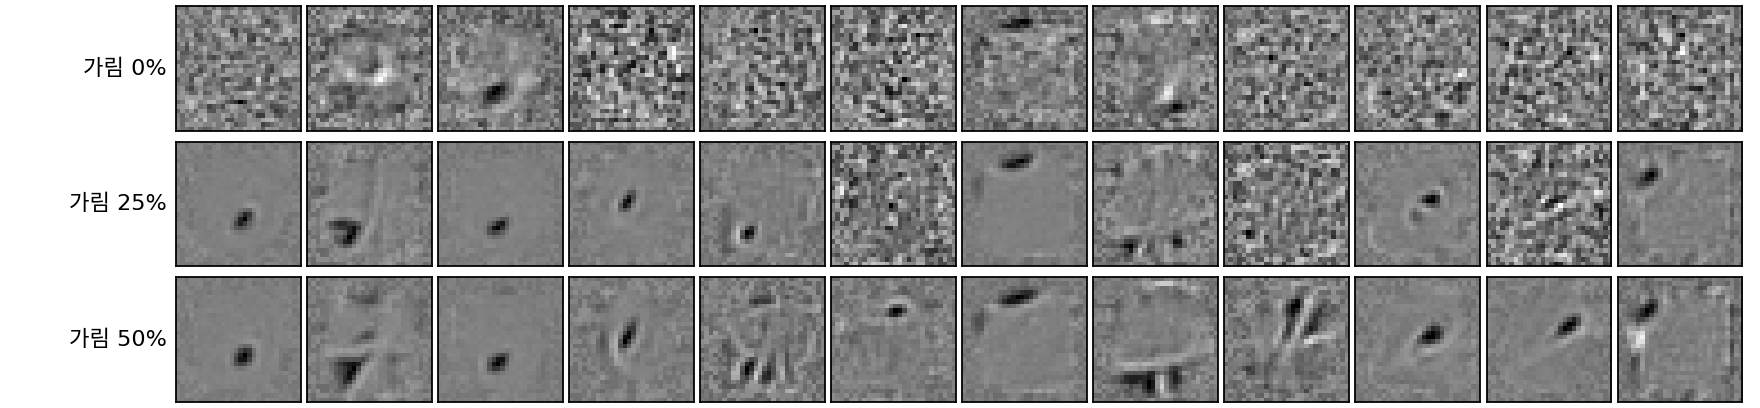
결과는 필터에서 드러났다. 지우지 않고 배운 오토인코더의 필터는 상당수가 뜻 없는 얼룩이었는데, 지우는 비율을 올리자 점과 획을 찾는 필터가 늘었다. 숨은 층을 입력(784칸)보다 넓은 2,000칸으로 잡아도 베끼기로 빠지지 않았다. 논문은 오토인코더로 잡음을 걷는 일 자체는 1987년 르쿤(Yann LeCun)과 갈리나리(Patrick Gallinari) 등이 먼저 했다고 밝히고, 자기들의 목표는 좋은 잡음 제거기가 아니라 좋은 표현이라고 적었다.
가리고, 흔들고, 되살리기
손글씨 숫자(MNIST, 칸마다 밝기 0은 바탕, 1은 잉크)로 해 보자. 먼저 시험 그림마다 칸의 절반을 무작위로 0으로 지우고, 784 → 1024 → 1024 → 1024 → 784 MLP 가 지우기 전의 그림을 맞히도록 제곱 오차로 학습했다. 지운 칸을 0으로 둔 채 재면 지운 칸의 제곱 오차 합이 그림 한 장에 40.63인데, 고친 그림에서는 3.98이다.
다음은 지우는 대신 흔든다. 칸마다 표준정규 잡음 ε(엡실론)에 잡음 크기 σ(시그마)를 곱해 더한다. σ = 0.5 이면 칸마다 밝기가 ±0.5쯤 흔들린다. σ 마다 따로 학습한 복원기(망가진 그림을 받아 원래 그림을 내놓는 신경망)의 결과가 아래 그림이다.
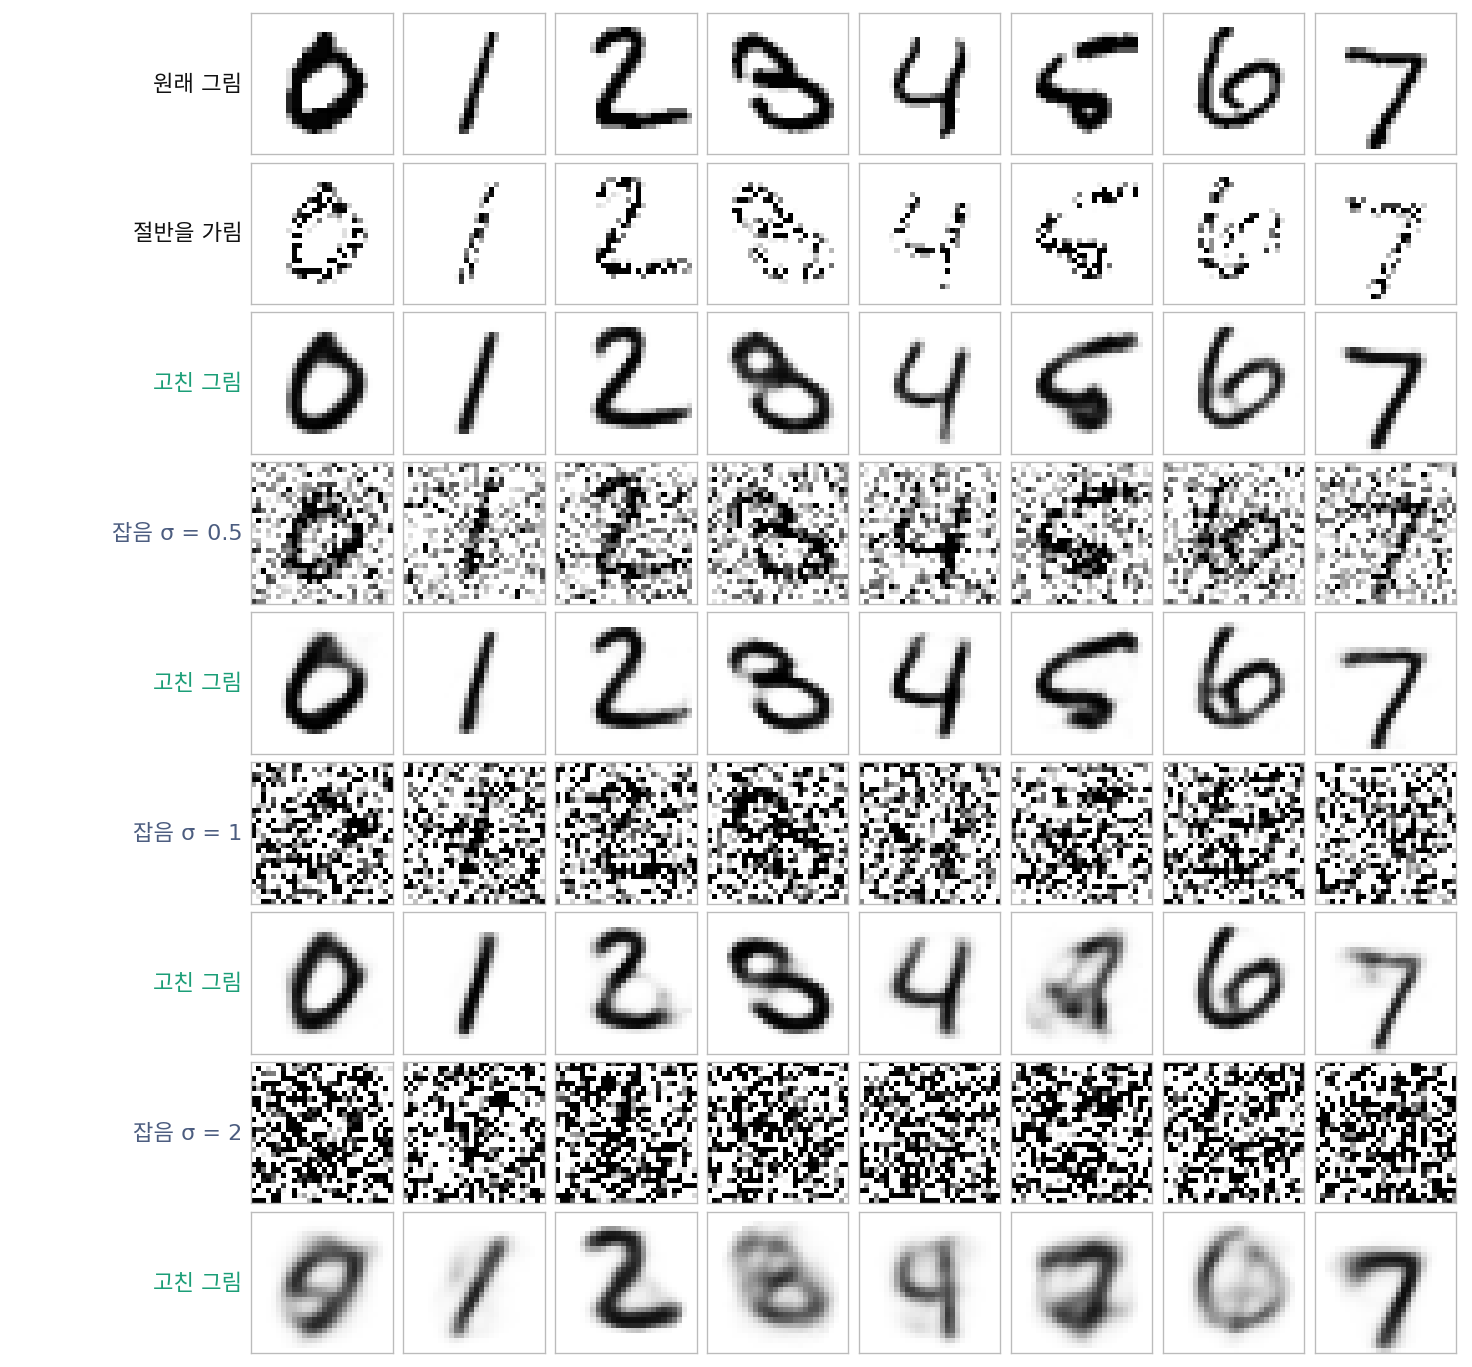
σ 가 커질수록 고친 그림이 흐려진다. 밝기 0.2 ~ 0.8 인 회색 칸이 시험 그림에는 6.1%인데, 고친 그림에서는 σ = 0.5 에서 7.7%, 1 에서 11.6%, 2 에서 20.0%다. 고친 그림과 학습 그림 전체의 평균 그림 사이의 제곱 거리도 42.88, 33.97, 17.05로 줄어든다(시험 그림 자체는 평균 그림과 50.51 떨어져 있다).
까닭은 학습 목표에 있다.
라벨을 넣고 그림을 받는 MLP가 그 라벨의 그림들을 평균 낸 것과 같은 일이다. 입력 하나에 정답이 여럿 붙어 있으면, 제곱 오차로 배운 신경망은 정답들의 평균, 곧 조건부 평균을 내놓는다. 여기서는 입력이 망가진 그림이다. 조금 망가진 그림은 원래 그림을 거의 하나로 가리키지만, 많이 망가진 그림은 수많은 원래 그림과 어울리고, 그 평균은 흐리다. 이렇게 일부러 망가뜨린 입력을 받아 원래 입력을 되살리도록 배우는 오토인코더를 디노이징 오토인코더 (잡음 제거 오토인코더 / denoising autoencoder)라 한다. 디노이징(denoising)은 잡음(noise)을 걷어 낸다는 말이고, 이 장은 칸을 지우는 것처럼 다른 방식으로 망가뜨린 것을 되살리는 일까지 이 말로 부른다.
ML에서: 가린 낱말 맞히기
2018년 구글의 데블린(Jacob Devlin)과 동료들이 내놓은 언어 모델 BERT 는 문장의 토큰(낱말 조각) 가운데 15%를 무작위로 골라 가리고, 가린 낱말을 맞히도록 사전학습한다. 논문은 「디노이징 오토인코더(빈센트와 동료들, 2008)와 달리 입력 전체를 되살리지 않고 가린 낱말만 맞힌다」고 적어, 같은 생각에서 갈라져 나왔음을 밝혔다.
문제 1. 번진 키 기록
어느 반 학생 20명의 키(cm)는 158, 161, 163, 165, 166, 168, 169, 171, 172, 172, 174, 175, 176, 177, 178, 180, 181, 183, 185, 188 이다. 한 학생의 기록 카드에 물이 번져 키가 「17□」로만 보인다. (가) 이 학생의 키를 숫자 하나로 짐작해 제곱 오차의 평균을 가장 작게 하려면 얼마라고 해야 하는가? (나) 더 번져서 「1□□」만 보이면? (다) 두 짐작은 이 반에 실제로 있는 키인가?
170대 학생은 171, 172, 172, 174, 175, 176, 177, 178 이렇게 여덟 명이에요. 가운데쯤인 174나 175 아닐까요?
제곱 오차의 평균을 가장 작게 하는 값은 뭐였죠?
평균이에요. 여덟 명의 평균은 174.375. 174로 짐작하면 제곱 오차 평균이 5.875인데 174.375면 5.734로 조금 더 작아요.
(나)는 반 전체가 다 「1□□」에 맞으니까 20명 평균, 173.1이요.
(다)는요?
174.375도 173.1도 반에 없는 키네요. 번진 게 적을 때는 여덟 명의 평균, 많이 번지면 반 전체의 평균. 많이 망가질수록 더 많은 학생을 섞어서 반 평균 쪽으로 끌려가요.
위의 숫자 그림에서 σ 가 커질수록 고친 그림이 평균 그림 쪽으로 다가간 거랑 똑같아. 망가진 정도가 「몇 명이 후보로 남았나」를 정하는 거야.
문제 2. 네 칸짜리 그림
가로세로 2칸짜리 흑백 그림 세상에 그림이 네 가지뿐이고, 모두 같은 비율로 나온다: 왼쪽 세로 획, 오른쪽 세로 획, 위 가로 획, 아래 가로 획(획이 지나는 칸은 1, 나머지는 0). 칸 일부를 가리고, 제곱 오차를 가장 작게 하는 복원기로 가린 그림을 되살린다. (가) 왼쪽 위 칸만 보이고 그 값이 1이면 복원기는 무엇을 내놓는가? (나) 그 그림은 네 가지 그림 가운데 하나인가? (다) 두 칸만 보여 준다면, 어느 두 칸을 보여 줘야 언제나 그림 하나로 정해지는가?
왼쪽 위가 1인 그림은 왼쪽 세로 획과 위 가로 획 둘이에요. 둘의 평균이니까 왼쪽 위 1, 오른쪽 위 0.5, 왼쪽 아래 0.5, 오른쪽 아래 0이에요.
그럼 (나)는 아니네요. 0.5인 칸이 둘이나 있는 그림은 세상에 없어요. 그래도 복원기가 틀린 건 아니죠? 시킨 대로 평균을 낸 거니까.
맞아요. (다)는 어때요? 보여 줄 두 칸을 아무렇게나 골라도 될까요?
왼쪽 위랑 오른쪽 아래를 보여 주면… 왼쪽 세로 획도 위 가로 획도 (1, 0)이 나와요. 이 쌍은 안 되네요.
같은 줄이나 같은 칸에 있는 두 칸이면 네 그림이 모두 다르게 보여. 대각선으로 마주 본 두 칸만 안 돼. 가린 칸 수만이 아니라 어디를 가렸는지가 남는 후보 수를 정하는구나.
선형대수에서 미지수가 넷인데 식 두 개를 고를 때, 어떤 두 식은 서로 독립이고 어떤 두 식은 같은 정보를 두 번 말하는 거랑 비슷해.
문제 3. 망가진 정도를 잘못 알고 고치면
위의 MNIST 실험에서 σ = 0.25 로만 학습한 복원기와 σ = 1 로만 학습한 복원기를 서로 바꿔 써 본다. 시험 그림 한 장의 제곱 오차 합 평균은 아래와 같다(고치지 않으면 784σ², 곧 σ = 0.25 에서 49, σ = 1 에서 784).
σ = 0.25 그림을 고침 σ = 1 그림을 고침 σ = 0.25 로 배운 복원기 3.61 34.73 σ = 1 로 배운 복원기 9.52 16.86 (가) 어느 쪽으로 잘못 쓰든 오차가 두 배 넘게 커진다. 그래도 고치지 않는 것보다는 나은가? (나) 두 실수는 고친 그림에서 각각 어떻게 다르게 보일까? (다) 사진 앱이라면 이 문제를 어떻게 풀겠는가?
(가)는 쉬워요. 9.52는 49보다, 34.73은 784보다 훨씬 작으니까 잘못 써도 고치긴 하네요.
(나)를 보려면 고친 그림을 재 봐야 해요. 회색 칸 비율은 σ = 0.25 그림을 제 복원기로 고치면 6.3%, σ = 1 복원기로 고치면 10.0%예요. 거꾸로 σ = 1 그림을 σ = 0.25 복원기로 고치면, 원래 바탕이던 칸의 밝기가 평균 0.050으로 제 복원기(0.023)의 두 배가 넘어요.
σ = 1 복원기는 「많이 망가졌을 것」이라고 믿으니까 조금 흔들린 그림도 후보를 넓게 잡아 평균을 내. 그래서 멀쩡한 획까지 흐려. 반대로 σ = 0.25 복원기는 「조금만 흔들렸을 것」이라고 믿으니까 큰 잡음을 획으로 착각하고 남겨 둬. 바탕에 얼룩이 남는 거고.
그럼 σ 마다 복원기를 하나씩 만들어야 해요? σ 가 0.01부터 4까지면 몇 개를 만들어야 하죠?
(다)를 다시 봐요. 사진 앱은 복원기를 수백 개 들고 다닐까요?
사진 앱에는 「잡음 제거 강도」 슬라이더가 있어요! 복원기 하나에 강도를 숫자로 알려 주는 거네요. 우리도 σ 를 입력으로 같이 넣으면 되겠다.
조교님한테 과제를 낼 때 「급하게 했어요」라고 한마디 붙이면 채점 기준이 달라지는 거랑 같아요.