상호정보량: 짝을 섞어 재는 KL
이 장 첫머리의 주장, 곧 신경망 하나로 샘플만 써서 KL을 잰다는 주장을 직접 확인할 차례다. 표현 학습에서는 두 변수가 서로에 대해 얼마나 알려 주는지를 재고 싶은데, 손에 있는 것은 (입력, 특징) 쌍의 샘플뿐이다. 이 양도 KL로 쓸 수 있을까?
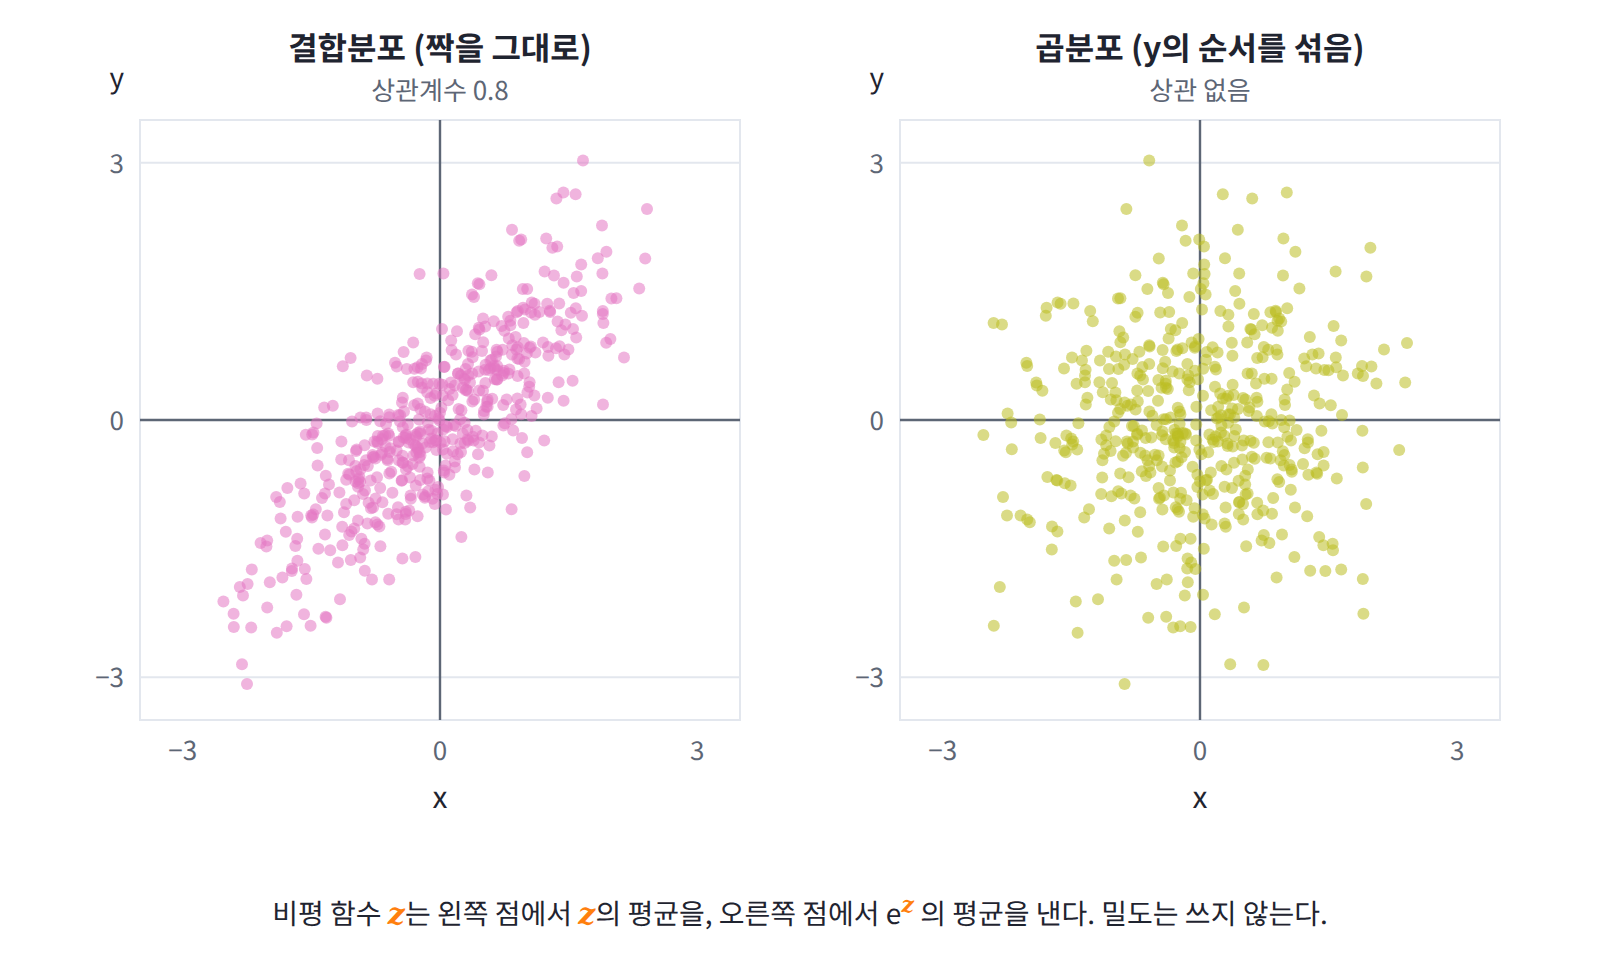
상관계수 0.8인 두 정규분포
상관계수가 0.8인 두 정규분포 변수 x, y를 생각하자. 참값을 식으로 구할 수 있어서 추정값과 견줄 수 있기 때문에 고른 예다. 한 변수를 알 때 다른 변수에 대해 줄어드는 불확실성을 상호정보량 (함께 아는 정보의 양, mutual information)이라 하는데, 이 경우에는 −½ ln(1 − 0.8²) ≈ 0.511 nat이다. 상호정보량은 결합 분포(두 변수를 함께 본 분포, joint)와 「두 주변 분포(한 변수씩 따로 본 분포, marginal)의 곱」 사이의 KL이므로, 결합 분포의 샘플은 (x, y) 쌍 그대로, 곱분포의 샘플은 y의 순서를 섞어 짝을 끊은 쌍으로 얻는다. 코드는 밀도를 한 번도 쓰지 않는다. 비평 함수 역할을 하는 신경망 z(x, y) 하나를 두고, 결합 분포에서의 z 평균에서 곱분포에서의 e^z 평균의 로그를 뺀 값, 곧 돈스커–바라단 표현의 괄호 안을 키우도록 학습할 뿐이다.
import math, torch
torch.manual_seed(0)
corr = 0.8                                 # 두 변수의 상관계수
def sample(n):
    x = torch.randn(n, 1)
    y = corr * x + math.sqrt(1 - corr**2) * torch.randn(n, 1)
    return x, y

critic = torch.nn.Sequential(              # 비평 함수 z(x, y)
    torch.nn.Linear(2, 64), torch.nn.ReLU(), torch.nn.Linear(64, 1))
opt = torch.optim.Adam(critic.parameters(), lr=1e-3)

def dv_bound(x, y):
    joint = critic(torch.cat([x, y], 1)).mean()                 # <z>_결합분포
    y_shuf = y[torch.randperm(len(y))]                           # 짝을 섞으면 곱분포
    marg = critic(torch.cat([x, y_shuf], 1)).squeeze(1)
    return joint - (torch.logsumexp(marg, 0) - math.log(len(y)))  # - ln<e^z>_곱분포

for step in range(3000):
    x, y = sample(512)
    loss = -dv_bound(x, y)                  # 하한을 최대화
    opt.zero_grad(); loss.backward(); opt.step()

with torch.no_grad():
    x, y = sample(200000)
    print(dv_bound(x, y).item())            # 0.5071 (MINE 추정값)
print(-0.5 * math.log(1 - corr**2))         # 0.5108 (참값)
추정값은 0.5071로 참값 0.5108에 가까우며, 시드를 1, 2, 3으로 바꿔도 0.504~0.506 사이에 머물렀다. 추정값이 참값보다 조금 작게 나오는 것은 우연이 아니다. 이 양은 비평 함수가 완벽할 때만 KL과 같고 그 밖에는 항상 작은 하한이기 때문이다. dv_bound 함수 마지막 줄의 logsumexp에서 ln N을 뺀 것은 「e^z의 표본 평균의 로그」를 수치적으로 안전하게 계산하는 방법이다.
ML에서: MINE
이 방법이 Belghazi 외(2018)의 MINE이다. 이름은 Mutual Information Neural Estimation, 곧 「신경망으로 상호정보량 재기」의 머리글자다. MINE은 상호정보량 I(X; Y)가 결합 분포와 주변 분포의 곱 사이의 KL이라는 사실에 돈스커–바라단 표현을 적용했다. 논문의 핵심 정리는 「상호정보량 ≥ ⟨T⟩ − ln⟨e^T⟩」 한 줄인데, 이 장을 마친 독자는 이것을 「KL의 켤레를 두 번 취한 식이고, 비평 신경망 T는 밀도 비의 로그를 배운다」로 읽게 된다. 논문의 T는 이 책의 z와 같은 것이다. 논문은 DV 하한을 미니배치로 계산하면 기울기가 한쪽으로 치우친다는 점도 짚고, 분모 쪽 평균을 지수 이동 평균으로 바꿔 그 치우침을 줄였다. 대조 학습에서 쓰는 InfoNCE 손실도 같은 가족의 상호정보량 하한이라는 것이 Poole 외(2019)의 정리로 알려져 있다.
문제 12. 짝을 섞지 않고 재면
민준이 위 코드를 줄이려다 y의 순서를 섞는 줄을 빼 버렸다. 그래서 ⟨z⟩도, ln⟨e^z⟩도 같은 결합 분포의 쌍으로 계산하게 되었다. (가) 비평 함수를 z(x, y) = xy/4로 고정했을 때, 섞은 경우와 섞지 않은 경우의 값을 샘플로 구해 견주라. (나) 비평 신경망을 학습시키면 섞지 않은 쪽은 어디로 가는가?

샘플 800만 개로 돌려 보니 섞은 쪽은 0.168, 섞지 않은 쪽은 −0.075예요. 음수면 상호정보량이 음수라는 건가요?
상호정보량은 KL이라 음수가 될 수 없어. 비평 함수를 대충 골라서 그런 거지. 학습시키면 섞은 쪽처럼 0.5 근처로 올라갈 거야.
학습시켜 봤는데요, 섞지 않은 쪽은 0.0000에서 멈춰요. 3000걸음을 다 돌려도요.
섞지 않으면 두 평균을 내는 샘플이 같은 분포에서 나와요. 돈스커–바라단 표현으로 읽으면 이 값은 무엇과 무엇 사이의 KL의 하한이죠?
결합 분포와 결합 분포 자신 사이요. 같은 분포끼리의 KL은 0이니까 아무리 학습해도 0을 넘을 수 없네요. 비평 함수 탓이 아니었어요.
그래서 짝을 섞는 한 줄이 이 방법의 핵심이에요. 섞어야 두 변수가 서로 모르는 세계, 곧 주변 분포의 곱에서 뽑은 샘플이 생기거든요.
대조군 없이 실험군끼리만 비교한 실험 보고서랑 같네요. 차이가 0으로 나오는 게 당연하고요.