교차 엔트로피: 정답을 넣은 펜헬–영 틈
분류 모델은 로짓을 먼저 내놓고, 정답은 그 뒤에 주어진다. 로짓과 정답은 서로 딱 맞는 짝이라는 보장이 없는 두 값이다. 로그 분배함수 ψ와 그 켤레 ψ*로 펜헬–영 틈을 만들고 여기에 로짓과 정답을 넣으면 어떤 값이 나올까?
정답을 넣은 틈
로그 분배함수와 그 켤레로 만든 틈에 로짓과 정답을 넣으면 어떤 손실이 나올까? ψ(z) + ψ*(y) − Σ yᵢzᵢ는 항상 0 이상이고, y가 z의 기울기인 softmax일 때만 0이다. 여기에 정답 클래스가 c인 원-핫 벡터 y를 넣으면, 원-핫 벡터의 엔트로피는 0이므로 ψ*(y) = 0이다. 그러면 남는 것은 우리가 매일 쓰는 손실이다.
교차 엔트로피 손실은 펜헬–영 부등식의 틈 그 자체다. 그렇다면 이 손실을 로짓으로 미분하면 무엇이 나올까? 역전파 코드를 짜 본 사람이라면 답을 외우고 있겠지만, 그 답이 어디서 오는지는 아래 문제 8에서 함께 따라가 보자.
이진 분류: sigmoid와 logit
클래스가 두 개인 이진 분류에서는 같은 이야기가 더 익숙한 모습으로 나타난다. 로짓이 하나라면 로그 분배함수는 ln(1 + e^z)이다. 이 함수는 ReLU를 매끄럽게 편 모양이라 softplus라고 부르고, 그 기울기가 sigmoid다. 켤레는 이진 엔트로피에 마이너스를 붙인 p ln p + (1 − p) ln(1 − p)이고 그 기울기는 ln(p/(1 − p)), 곧 logit 함수다. 숫자로 확인하면, 로짓 1을 sigmoid에 넣으면 0.7311이 나오고, 0.7311을 logit에 넣으면 ln(0.7311/0.2689) = 1로 처음 로짓이 돌아온다. 켤레 쌍의 두 도함수는 서로 역함수이므로, sigmoid와 logit이 서로 역함수인 것은 공장 문제에서 한 개를 더 만드는 비용 c′(x)(경제학의 한계비용)와 이윤 곡선의 기울기가 서로 역함수였던 것과 같은 이유다.
지수족의 두 좌표
로짓과 확률의 이런 짝은 softmax만의 일이 아니다. 정규분포, 푸아송 분포처럼 확률이 「매개변수와 특징의 곱」의 지수함수에 비례하는 분포 가족(지수족, exponential family)에서도, 지수에 들어가는 매개변수와 특징의 평균이 원래 변수와 기울기 변수의 짝이고 둘 사이를 오가는 변환이 르장드르 변환이다. 모델이 로짓을 출력하고 손실은 확률로 계산하는 일상적인 학습은 사실 이 두 좌표를 오가는 일이다.
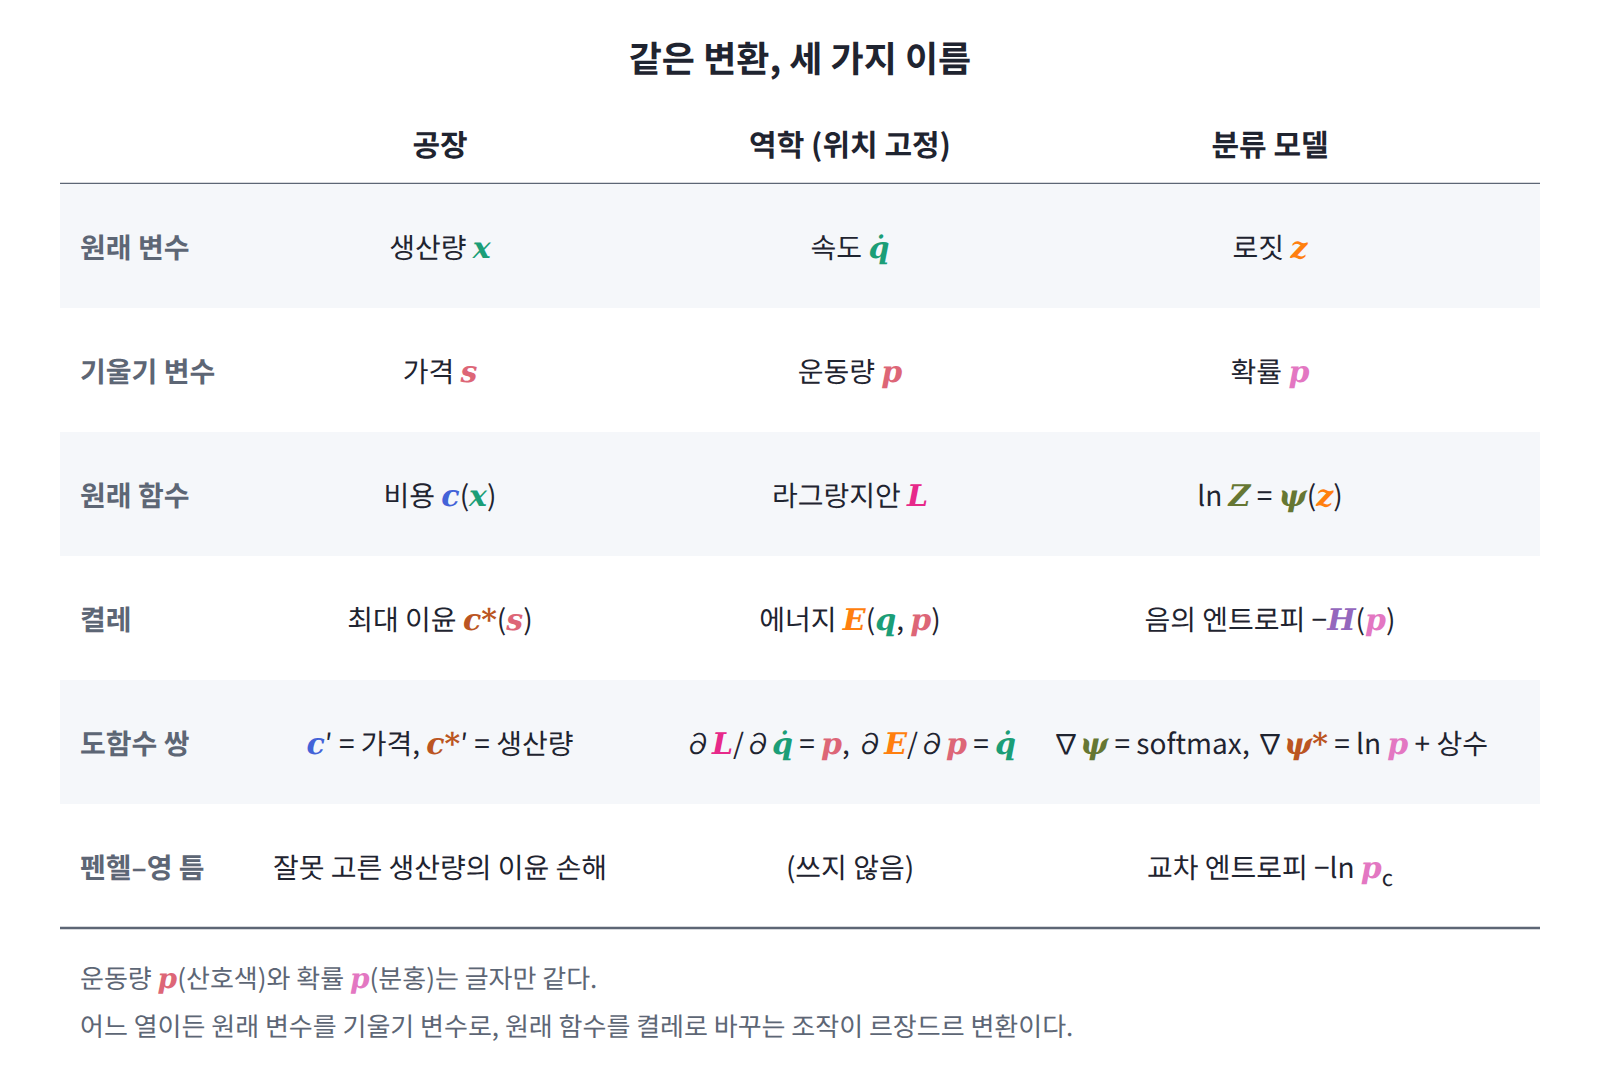
위젯 3에서 분포 자리에 정답 라벨을 넣으면, ln Z와의 차이로 나오는 값이 바로 그 라벨의 펜헬–영 틈이다. 아래 문제 9를 풀어 본 뒤 「문제 9 불러오기」로 확인해 보자.
ML에서: 펜헬–영 손실
Blondel, Martins, Niculae(2020)의 「Learning with Fenchel–Young Losses」는 이 관점을 거꾸로 써서, 음의 엔트로피 자리에 다른 볼록 함수를 넣으면 softmax 대신 새 출력층과 그에 맞는 손실이 한꺼번에 나온다고 보였다. 대표적인 것이 sparsemax(작은 확률을 정확히 0으로 잘라 내는 출력층)이다. softmax는 어떤 로짓에도 0보다 큰 확률을 주지만, sparsemax는 점수가 낮은 클래스를 아예 후보에서 뺀다.
문제 8. 역전파의 「p − y」는 어디서 왔나
두 클래스 분류기가 로짓 z = (2, 0)을 내놓았고 정답은 둘째 클래스, 곧 y = (0, 1)이다. 교차 엔트로피 손실 ψ(z) − Σ yᵢzᵢ를 로짓 z₁, z₂로 미분한 값을 구하고, 왜 그 꼴이 되는지 설명하라.
그건 외우고 있어요. 과제에서 매번 썼거든요. softmax 출력에서 정답 원-핫을 빼면 돼요. p = (0.8808, 0.1192)니까 (0.8808, −0.8808).
값은 맞아요. 그런데 왜 빼는 꼴인지는 설명할 수 있나요? 손실의 두 항을 따로 미분해 봐요. ψ(z)를 z₁로 미분하면요?
ψ = ln(e^z₁ + e^z₂)니까 e^z₁/(e^z₁ + e^z₂), 곧 p₁이에요. 로그 분배함수의 기울기가 softmax라는 게 여기서 쓰이네요.
Σ yᵢzᵢ는요?

z에 대해 일차식이니까 기울기는 그냥 y예요. 아, 그러니까 p − y는 「ψ의 기울기 빼기 직선의 기울기」였네요. 외운 공식이 아니라 두 기울기의 차이였어요.
그럼 기울기가 0이 되는 로짓을 찾으면 학습이 끝나겠네요. 순서만 뒤집은 (0, 2)면 되지 않을까요?
(0, 2)면 p = (0.1192, 0.8808)이라 기울기가 (0.1192, −0.1192)야. 작아지긴 했는데 0은 아니야.
아, 0이 되려면 p = y여야 하는데, y가 원-핫이면 softmax는 정확히 (0, 1)을 낼 수가 없어요. 로짓을 끝없이 벌려야만 다가가네요.
맞아요. 원-핫 정답과 맞는 짝이 되는 로짓은 유한한 곳에 없어요. 그래서 원-핫 정답으로 오래 학습하면 로짓의 차이가 계속 벌어져요.
과제를 돌려받으면 빨간 줄만큼만 고치는 거랑 같네요. 모델이 낸 확률과 정답의 차이가 곧 빨간 줄이고요.
문제 9. 정답이 섞인 라벨의 손실
두 클래스 분류기가 로짓 z = (2, 0)을 내놓았다. (가) 정답이 첫째 클래스인 원-핫 라벨 y = (1, 0)일 때와 둘째 클래스인 y = (0, 1)일 때 펜헬–영 틈 ψ(z) + ψ*(y) − Σ yᵢzᵢ를 구하라. (나) 라벨 스무딩으로 y = (0.9, 0.1)을 쓸 때 틈과 교차 엔트로피 −Σ yᵢ ln pᵢ를 각각 구하라. 둘은 왜 다른가?
붕어빵 문제랑 같은 틀이네요. 로짓이 전날 준비한 양이고, 라벨이 당일 정해진 가격이에요. ln Z = 2.1269니까 y = (1, 0)이면 2.1269 + 0 − 2 = 0.1269, y = (0, 1)이면 2.1269 − 0 = 2.1269. 둘 다 −ln p_c와 같아요.
(나)도 교차 엔트로피 식에 넣으면 되죠. 0.9 × 0.1269 + 0.1 × 2.1269 = 0.3269. 원-핫일 때 둘이 같았으니까 틈도 0.3269겠죠.
원-핫일 때 ψ*(y)는 얼마였죠? 이번에는요?
원-핫은 엔트로피가 0이라 ψ*(y) = 0이었어요. (0.9, 0.1)이면 0.9 ln 0.9 + 0.1 ln 0.1 = −0.3251이에요. 그럼 틈은 2.1269 − 0.3251 − 1.8 = 0.0018이고, 교차 엔트로피와는 0.3251만큼 달라요.
0.3251이 y의 엔트로피네요. 교차 엔트로피 = 틈 + H(y)이고, 틈은 KL(y ‖ softmax)예요.

그래서 라벨 스무딩을 쓰면 교차 엔트로피는 아무리 학습해도 0.3251 아래로 내려가지 않아요. 로짓 차이가 ln 9 = 2.197이 되어 softmax가 (0.9, 0.1)을 맞히는 순간 틈은 0이지만, 손실은 그 높이에서 멈춰 보여요.
스무딩을 켜고 학습했을 때 loss가 0.3 근처에서 안 내려가서 학습이 멈춘 줄 알았는데, 그게 바닥이었네요.