가장 큰 항: 큰 계의 ln Z는 승자 하나가 거의 정한다
에너지 값마다 점수 ln g − βE를 매기면, 점수가 가장 큰 에너지 값이 가장 자주 관찰되는 승자였다. 그런데 분배함수 Z는 승자 하나가 아니라 에너지 값마다의 비중 g·e^(−βE)를 모두 더한 것이다. 승자 하나는 그 합에서 얼마나 큰 몫을 차지할까? 들뜬 상태의 볼츠만 인자가 1/2인 온도(βε = ln 2)의 2준위 입자로, 모든 항을 더한 ln Z와 가장 큰 항 하나의 점수를 나란히 놓고 입자 수를 늘려 보자.
| N | ln Z | 승자 n | 최대 점수 | 차이 | 최대 점수 / ln Z |
|---|---|---|---|---|---|
| 3 | 1.216 | 1 | 0.405 | 0.811 | 0.333 |
| 30 | 12.164 | 10 | 10.287 | 1.877 | 0.846 |
| 300 | 121.640 | 100 | 118.620 | 3.020 | 0.975 |
| 3000 | 1216.395 | 1000 | 1212.225 | 4.170 | 0.997 |
입자가 세 개일 때는 가장 큰 항이 ln Z의 3분의 1밖에 설명하지 못하지만, 입자가 3,000개이면 99.7%를 설명한다. 차이도 조금씩 자라기는 하지만, ln Z가 입자 수에 비례해 10배씩 커지는 동안 차이는 1.1 남짓씩만 늘어난다. Z는 N + 1개의 항을 모두 더한 것인데, 입자가 많아지면 왜 그 로그가 가장 큰 항 하나로 거의 정해질까?
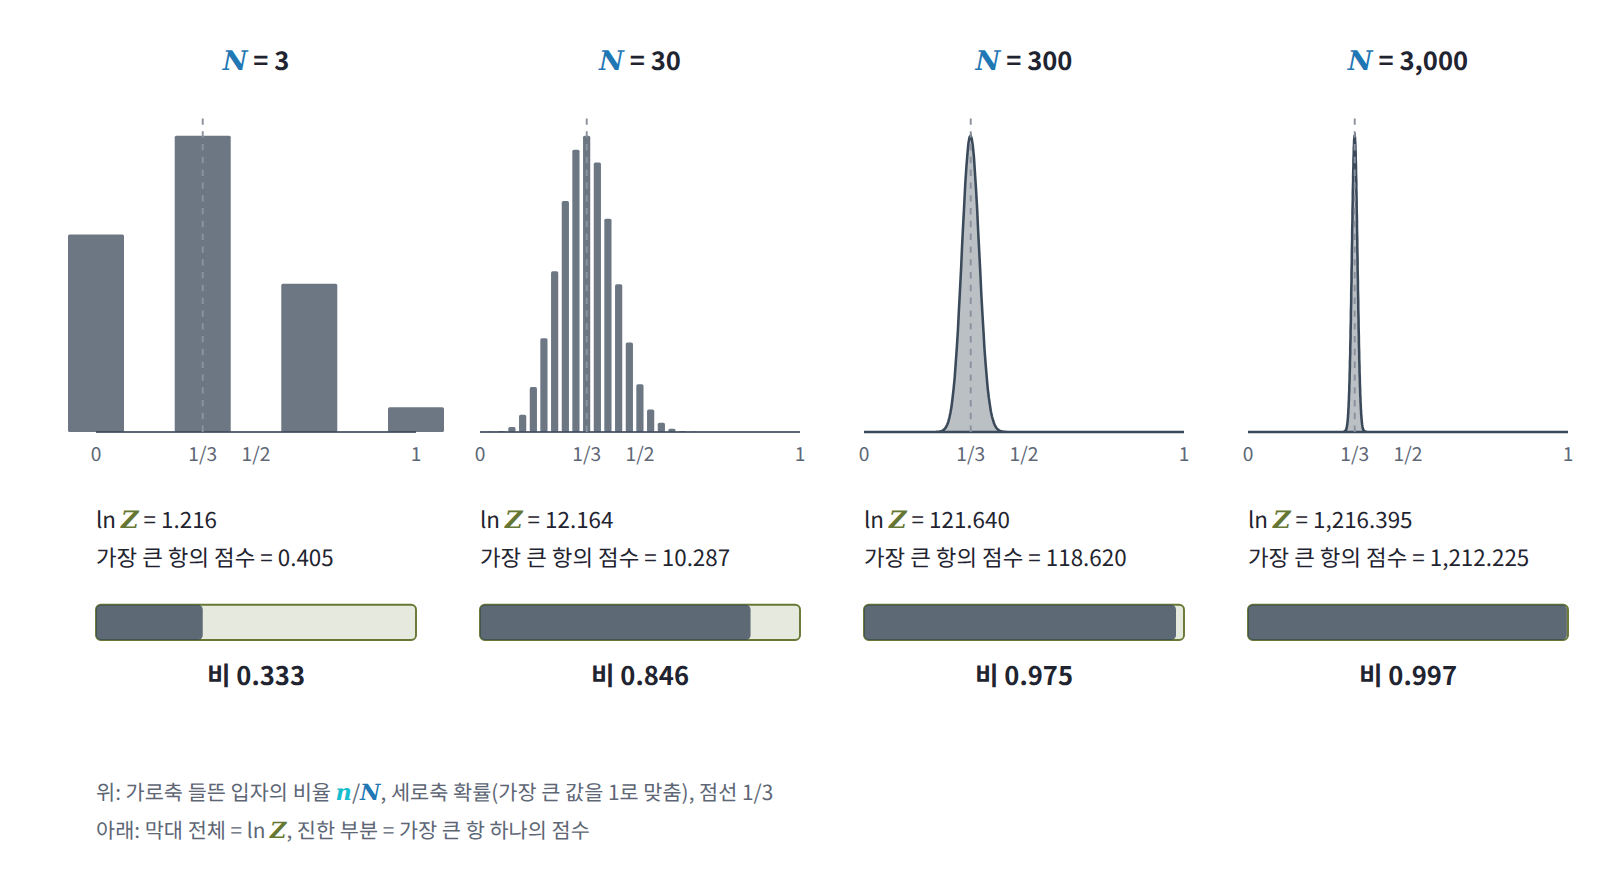
합의 로그와 가장 큰 항
분배함수를 에너지 값별로 묶어 쓰면 Z = Σ_E g(E)e^(−βE)이고, 각 항을 지수 하나로 모으면 Z = Σ_E e^(ln g(E) − βE)가 된다. 괄호 안이 바로 앞에서 매긴 점수다. 그러니 ln Z는 점수들의 logsumexp이고, ML을 해 본 독자라면 logsumexp가 max를 부드럽게 만든 함수라는 것을 알고 있을 것이다. 이 사실을 부등식으로 적어 두자. 더하는 항은 모두 양수이므로 합은 가장 큰 항보다 크고, 항이 M개이면 합은 가장 큰 항의 M배를 넘지 못한다.
2준위 입자 N개에서는 에너지 값이 N + 1개뿐이므로, ln Z와 최대 점수의 차이는 ln(N + 1)을 넘지 못한다. 반면 점수 자체는 입자 수에 비례해 커진다. N = 3,000이면 차이의 상한은 ln 3001 = 8.0이고 실제 차이는 4.17인데, ln Z는 1,216이다. 입자 수가 아보가드로수쯤 되면 ln Z는 10²³의 크기이고 차이는 기껏해야 수십이므로, 둘을 구별할 방법이 없다. 실제 차이가 상한의 절반쯤인 것은 승자 근처의 항들이 승자와 거의 같은 크기로 함께 더해지기 때문인데, 그 차이가 정확히 무엇을 재는지는 아래 코드로 확인한다.
경우의 수의 로그에 볼츠만 상수를 곱한 것이 엔트로피 S(E) = k ln g(E)이므로 점수에 −kT를 곱하면 E − TS(E)가 된다. 그러니 이 결과를 물리의 말로 옮기면 다음과 같다. 큰 계에서 −kT ln Z는 겨루기의 승자가 거둔 E − TS와 거의 같다.
코드로 확인하기
위 표를 코드로 다시 만들어 보자. 2준위 입자 N개에서 에너지 값마다 점수 ln g − βE를 계산해 승자를 찾고, 정확한 ln Z = N ln 1.5와의 차이를 출력한다. 마지막 칸은 차이가 무엇을 재는지 짐작해 보려고 함께 찍은 값이다.
from math import lgamma, log, pi

beta_eps = log(2)                      # βε = ln 2, 들뜬 상태의 볼츠만 인자 e^(−βε) = 1/2

def score(N, n):                       # ln g(E) − βE, 들뜬 입자 n개인 에너지 값의 「점수」
    return lgamma(N + 1) - lgamma(n + 1) - lgamma(N - n + 1) - n * beta_eps

print(" N      ln Z    승자 n   최대 점수     차이   ½ln(2πN·p(1−p))")
for N in (3, 30, 300, 3000):
    lnZ = N * log(1 + 0.5)                                  # Z = (1 + e^(−βε))^N
    n_best = max(range(N + 1), key=lambda n: score(N, n))
    gap = lnZ - score(N, n_best)
    print(f"{N:5d} {lnZ:9.3f} {n_best:6d} {score(N, n_best):11.3f} {gap:8.3f} "
          f"{0.5 * log(2 * pi * N * (1/3) * (2/3)):9.3f}")
#  N      ln Z    승자 n   최대 점수     차이   ½ln(2πN·p(1−p))
#     3     1.216      1       0.405    0.811     0.716
#    30    12.164     10      10.287    1.877     1.867
#   300   121.640    100     118.620    3.020     3.019
#  3000  1216.395   1000    1212.225    4.170     4.170
「차이」 칸의 값은 입자가 10배 늘 때마다 약 1.15씩, 곧 ½ ln 10씩 늘어나고, 마지막 칸의 ½ ln(2πN·p(1 − p))와 N이 커질수록 소수 셋째 자리까지 맞는다. 여기서 p = 1/3은 입자 하나가 들떠 있을 확률이고, Np(1 − p)는 들뜬 입자 수의 분산이다. 그러니 ln Z와 가장 큰 항의 차이는 승자 근처에서 함께 더해지는 항들이 몇 개쯤인지, 곧 봉우리 폭의 로그를 잰 값이다. 폭은 √N으로만 자라므로 그 로그는 N에 비하면 무시할 만하다.
ML에서: logsumexp는 부드러운 max다
분류기의 로짓에 쓰는 logsumexp도 같은 부등식을 따른다. 로짓이 M개이면 logsumexp는 가장 큰 로짓보다 크고, 가장 큰 로짓에 ln M을 더한 값보다 작다. 라이브러리가 가장 큰 로짓 m을 먼저 빼고 m + ln Σᵢe^(zᵢ − m)으로 계산하는 것도 이 부등식의 모양 그대로다. 앞의 m이 가장 큰 항이고, 뒤의 로그는 0과 ln M 사이에서 나머지 항들이 보태는 몫이다.
문제 3. 확성기 하나와 관중 2만 명
소리의 크기를 재는 데시벨(dB)은 귀에 닿는 소리 에너지(단위 넓이에 1초 동안 닿는 양) I를 기준값 I₀와 견준 10 log₁₀(I/I₀)이고, 따로 나는 소리들이 겹치면 I가 더해진다. 야구장에서 응원단장의 확성기 하나가 관중석의 한 자리에 80 dB로 들리고, 관중 2만 명이 저마다 웅성거리는 소리는 그 자리에 한 사람당 40 dB로 들린다고 하자. (가) 모두 합치면 몇 dB인가? 확성기와 관중 가운데 어느 쪽이 더 크게 들리는가? (나) 관중이 몇 명일 때 두 쪽이 같아지는가? (다) 소리 2만 1개가 겹칠 때 전체 dB는 가장 큰 소리의 dB보다 얼마까지 커질 수 있는가?
80 dB와 40 dB면 40이나 차이 나요. dB는 10씩 오를 때마다 에너지가 10배니까 확성기 하나가 관중 한 명의 1만 배예요. 관중 소리는 무시하고 (가)는 거의 80 dB겠죠.
관중이 한 명이 아니죠. 에너지로 바꿔서 더해 볼까요?
확성기가 I₀의 10⁸배, 관중 한 명이 10⁴배니까 2만 명이면 2 × 10⁸배… 관중 쪽이 확성기의 두 배네요. 합이 3 × 10⁸배라 10 log₁₀(3 × 10⁸) = 84.8 dB예요. 한 명 한 명은 1만분의 1인데 머릿수로 이겼어요.
(나)는 관중 쪽이 10⁸배가 되면 되니까 1만 명이야. 관중 소리만 따로 재면 2만 명일 때 40 + 10 log₁₀ 20000 = 83.0 dB고.
(다)는 앞에서 본 부등식으로 풀 수 있어요. 무엇이 무엇에 해당하죠?
dB는 에너지 합의 로그에 10을 곱한 거니까 logsumexp랑 같은 꼴이에요. 합은 가장 큰 항의 20,001배를 넘지 못하니까 전체는 가장 큰 소리보다 10 log₁₀ 20001 = 43.0 dB까지만 커져요. 모두가 확성기처럼 80 dB로 소리칠 때 그 끝에 닿고요. 2준위 입자로 옮기면 확성기가 바닥 상태 하나고, 관중이 한 명씩은 작아도 수가 많은 들뜬 상태들이에요.
학과 행사비를 교수님 한 분이 10만 원 내고 학생 2백 명이 천 원씩 내면, 학생 쪽 합이 20만 원으로 더 큰 거랑 같네요.
문제 4. 어휘 5만 개의 logsumexp
토큰 50,000개의 어휘에서 다음 토큰의 로짓을 내는 언어모델이 있다. (가) 로짓이 모두 0이면 logsumexp는 얼마인가? (나) 한 토큰의 로짓만 10이고 나머지가 모두 0이면? (다) 그 한 토큰의 로짓이 12이면? 각 경우 가장 큰 로짓과의 차이가 무엇을 세는지 말하라.
(가)는 ln 50000 = 10.82요. 부등식의 위쪽 끝이에요. (나)는 e¹⁰ = 22,026이 e⁰ = 1보다 압도적으로 크니까 나머지는 무시하고 거의 10이겠죠.
하나하나는 2만분의 1이지만 49,999개나 있잖아. 49,999 × e⁻¹⁰ = 2.27이면 가장 큰 항 두 개어치가 넘어.

그럼 logsumexp = 10 + ln(1 + 2.27) = 11.18이에요. 무시할 수 있는 게 아니었네요. (다)는 49,999 × e⁻¹² = 0.31이라 12 + ln 1.31 = 12.27이고요.
가장 큰 로짓과의 차이 1.18, 0.27, 그리고 (가)의 10.82는 각각 무엇의 로그죠?
합을 가장 큰 항으로 나눈 값, 곧 가장 큰 항 몇 개어치가 모였는가의 로그예요. (가)는 모두 같으니까 5만 개어치, (나)는 3.27개어치, (다)는 1.31개어치고요. 가장 큰 토큰의 확률도 그 역수라서 (나)에서는 1/3.27 = 0.31, (다)에서는 0.76이에요.

입자 수를 늘렸을 때와 같은 이야기예요. 항 하나하나가 작아도 개수가 많으면 몫을 벌어 오고, 가장 큰 항이 합을 거의 정하는지는 둘의 겨루기로 정해져요.