샘플러의 온도: 스텝 크기와 노이즈의 비
이제 이 장 첫머리의 물음으로 돌아가자. 경사하강에 더하는 노이즈는 왜 스텝 크기 η가 아니라 √(2η)여야 했을까? 그리고 스텝 크기와 노이즈를 따로 조절하는 샘플러는 저마다 어떤 분포를 뽑고 있는 것일까?
스텝 크기 a와 노이즈 σ로 온도 읽기
SGLD처럼 ζ = 1, 스텝 크기 η, 노이즈 √(2η)로 두면 ζD = 1이라 샘플러는 e^(−U), 곧 U = −ln π로 정한 목표 분포 π를 뽑는다. 노이즈에 η를 곱하면 ζD = η/2라서 샘플러는 e^(−U/(η/2))를 뽑는데, U = θ²/2이면 이것은 분산이 η/2인 정규분포다. η = 0.01에서 0.005, 이 장 첫머리에서 체인 4000개로 잰 분산 0.0051이 바로 이 분산 η/2 = 0.005다. 더 일반적으로, 어떤 알고리즘이 한 스텝에 x ← x − a∇U + σz로 움직인다고 하자. 학습률 η 대신 a로 쓴 것은 SGLD에 한정하지 않고 아무 알고리즘의 스텝 크기를 가리키려는 것이고, σ는 노이즈의 표준편차다. 이 한 스텝을 랑주뱅 방정식의 한 스텝 x ← x − (Δt/ζ)∇U + √(2DΔt)z와 맞대면 Δt/ζ = a, 2DΔt = σ²이다. 둘째 식을 첫째 식으로 나누면 2ζD = σ²/a, 곧 ζD = σ²/(2a)이고, 끌려가는 흐름과 퍼지는 흐름이 상쇄되는 분포 e^(−U/(ζD))에서 온도 자리에 오는 것이 ζD였으므로 이 알고리즘은 온도 kT = σ²/(2a)의 볼츠만 분포를 향해 간다. 이 σ²/(2a)를 샘플러의 온도 (한 스텝에 x ← x − a∇U + σz로 움직이는 알고리즘이 향하는 볼츠만 분포의 온도)라 부르자. 스텝 크기와 노이즈의 크기를 따로 조절하는 샘플러는 모두 이 식으로 자기가 몇 도에서 샘플을 뽑는지 읽을 수 있다.

ML에서: SGLD의 「알맞은 양의 노이즈」
웰링과 테(2011)의 SGLD는 사후분포의 −ln을 위치에너지로 두고 미니배치로 그 그래디언트를 추정한다.
논문은 그래디언트 항에 ε/2를, 노이즈의 분산에 ε를 두었는데, 이것은 스텝 크기 η = ε/2에 노이즈 √(2η)를 붙인 것과 같아서 온도 kT = σ²/(2a) = 2η/(2η) = 1인 랑주뱅 방정식이다. 그런데 미니배치로 추정한 그래디언트에는 이미 오차가 섞여 있다. 그렇다면 노이즈를 따로 넣지 않은 SGD(stochastic gradient descent, 미니배치로 추정한 그래디언트를 따라가는 확률적 경사하강)도 몇 도에선가 샘플을 뽑는 샘플러라고 할 수 있을까? 이 물음은 아래 문제 13에서 따져 보자. 웰링과 테가 말한 「알맞은 양의 노이즈」는 스텝 크기 η에 대해 분산이 2η인 노이즈, 곧 샘플러의 온도 σ²/(2a)가 1이 되는 노이즈다.
ML에서: 에너지 기반 모델의 샘플러는 몇 도에서 뽑는가
에너지 기반 모델(energy-based model, EBM)을 학습하려면 모델 분포 e^(−E_θ(x))/Z에서 샘플을 뽑아 모델 분포에서 뽑은 샘플로 내는 평균(음의 단계, negative phase)을 추정해야 한다. 두와 모다치(2019)는 입력 x를 에너지의 내리막으로 옮기며 노이즈를 더하는 랑주뱅 방정식을 썼다.
논문의 식은 a = λ/2, σ² = λ로 온도 1에 맞춰져 있다. 그런데 CIFAR-10(가로세로 32픽셀 컬러 이미지 6만 장의 데이터 모음) 실험에서는 랑주뱅 60스텝을 가면서 그래디언트 스텝 크기를 10으로, 노이즈의 표준편차를 0.005로 두었다고 적었다. 이 샘플러가 실제로 몇 도의 분포를 향하는지는 아래 문제 13에서 직접 읽어 보자. 논문은 「EBM 학습은 MCMC 한 스텝(전이)의 크기에 가장 민감하다」고 적었다(MCMC는 Markov chain Monte Carlo의 머리글자로, 마르코프 체인을 돌려 샘플을 뽑는 방법을 통틀어 부르는 말이다).
문제 11. 어항 수온은 얼마나 흔들리나
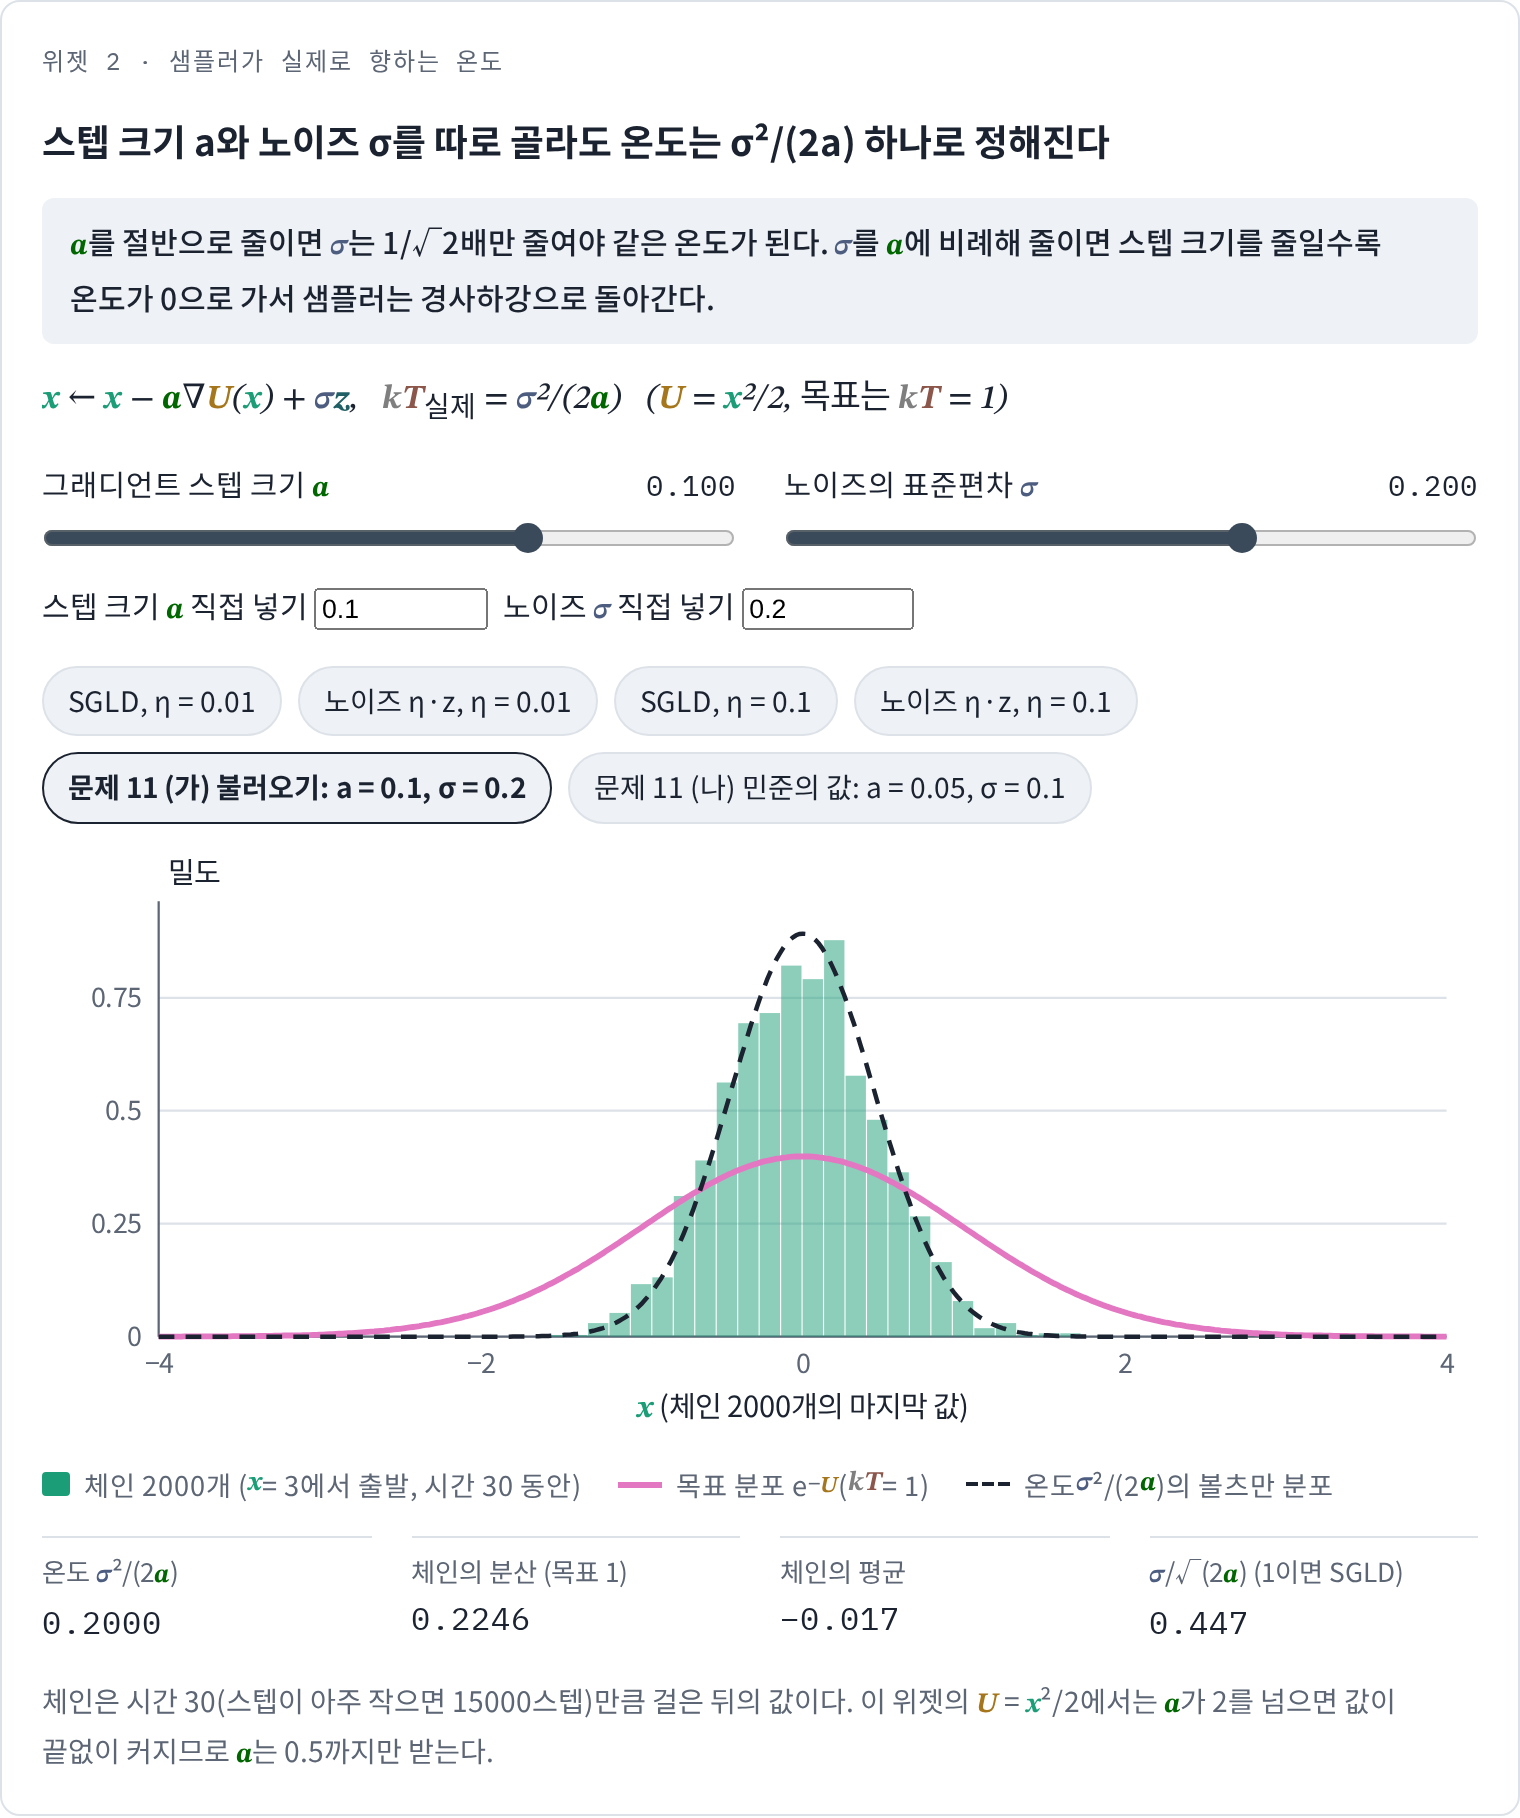
어항의 목표 수온은 25°C다. 히터는 1분마다 목표와의 차이의 10%를 되돌리고, 그 1분 동안 물의 순환과 창문 바람이 수온을 표준편차 0.2°C만큼 무작위로 흔든다. (가) 오래 두면 수온은 목표 둘레에서 표준편차 얼마로 흔들리는가? (나) 히터가 30초마다 5%씩 되돌리게 바꾸고 무작위로 흔드는 양도 30초 단위로 적는다. 30초 동안 흔드는 양의 표준편차는 얼마로 두어야 하는가? (목표와의 차이를 x로 보면 위젯 2의 샘플러 x ← x − a∇U + σz와 같은 꼴이다. 「문제 11 (가) 불러오기」 단추로, (나)는 「문제 11 (나) 민준의 값」 단추와 숫자 칸으로 직접 재어 비교해 보자.)
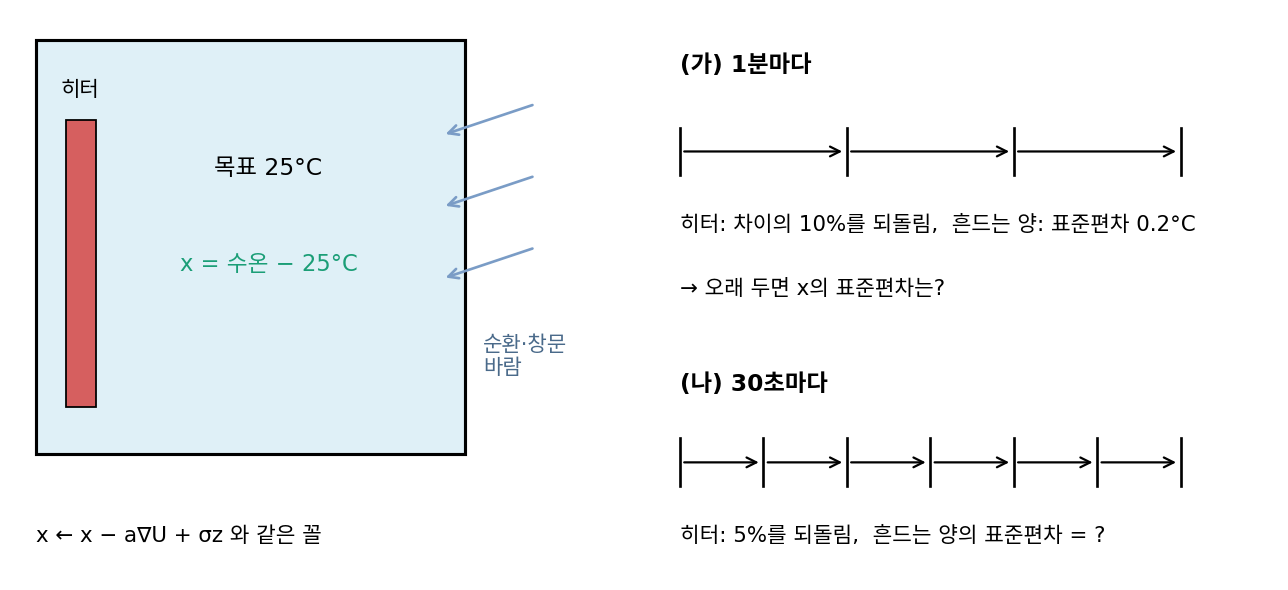

목표와의 차이가 e ← 0.9e + 0.2z로 바뀌니까, 오래 두어 분산 V가 멈추면 V = 0.81V + 0.04예요. V = 0.211, 표준편차 0.46°C고요.

(나)는 시간이 절반이니까 흔드는 표준편차도 절반인 0.1°C요. 돌려 보니 표준편차가 0.32°C, 15초로 쪼개 0.05°C를 넣으면 0.23°C예요. 식을 잘게 쓸수록 어항이 조용해지네요?

식을 어떻게 쪼개든 실제 어항은 그대로여야지. 30초짜리 무작위 변화 두 개가 1분짜리 무작위 변화 하나가 되는데, 서로 독립이면 더해지는 건 분산이야. 0.1²을 두 번 더하면 0.02인데 1분짜리 변화의 분산은 0.04잖아.

그래요. 30초짜리 무작위 변화는 분산이 절반, 표준편차는 0.2/√2 = 0.141°C예요. 그러면 30초 단위로 0.453°C, 15초 단위로 0.450°C로 거의 그대로죠. 히터가 되돌리는 비율은 시간에 비례하고, 무작위 변화의 표준편차는 시간의 제곱근에 비례해야 해요.

배달 알바를 두 번에 나눠 뛴다고 그날 수입의 들쭉날쭉이 반으로 줄지는 않는 거네요.

위젯 2에서 문제 11 (가) 설정을 불러와, 체인들이 퍼지는 폭이 셈한 값과 맞는지 확인해 보세요.
문제 12. 원하는 온도에 맞춘 노이즈
손실 U(θ) = θ²/2의 볼츠만 분포에서 샘플을 얻으려고 경사하강 θ ← θ − η∇U에 노이즈 σz를 더한다. (가) 온도 kT = 0.1인 분포, 곧 분산 0.1인 정규분포에서 뽑고 싶다. η = 0.01이면 σ는 얼마로 두어야 하는가? (나) 온도 1을 목표로 SGLD처럼 σ = √(2η)를 쓰면 η = 0.01에서는 분산이 1에 가깝지만 η = 0.1에서는 1.04 남짓으로 조금 크게 나온다. 왜 그런가? 스텝 크기를 줄이지 않고 이 편향을 없앨 수 있는가? ((가)에서 고른 노이즈는 위젯 2의 숫자 칸에 넣어 확인해 보자.)
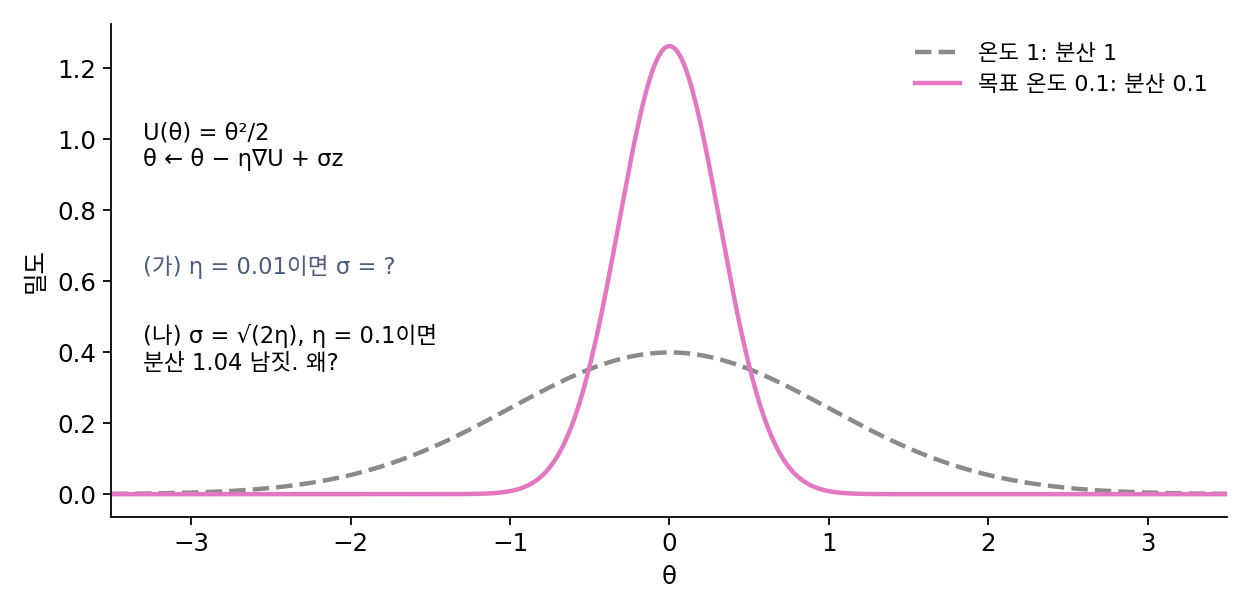

온도 1이면 노이즈가 √(2η) = 0.141이니까, 온도를 10분의 1로 하려면 0.1을 곱해서 0.0141이요. 돌렸더니… 분산이 0.0100이에요. 목표는 0.1인데요.
한 스텝이 x ← x − a∇U + σz면 온도가 σ²/(2a)잖아. 너는 0.0141²/(2 × 0.01) = 0.01, 온도를 100분의 1로 만든 거야. 온도는 σ가 아니라 σ²에 비례해.
어항에서 분산 대신 표준편차를 절반으로 줄였던 실수랑 같은 모양이네요. 온도를 10분의 1로 하려면 σ²을 10분의 1로, σ = √(2 × 0.01 × 0.1) = 0.0447이에요.
0.0447로 돌려 보세요.
0.100이요. 이제 맞네요. 그런데 (나)처럼 η = 0.1에서 √(2η)로 돌리면 1.04예요. 왜 조금 크게 나오죠?
정확히 풀어 볼게. 분산을 v로 두면 한 스텝 뒤의 분산 (1 − η)²v + 2η가 다시 v여야 하니까…
정리하면 v = 2η/(2η − η²) = 1/(1 − η/2)네. η = 0.1이면 1.053이야.
스텝 크기가 유한해서 생기는 편향이고, 스텝 크기를 줄이면 1로 가.
스텝 크기를 줄이지 않고 이 편향을 없애려면, 한 스텝을 제안으로 보고 메트로폴리스 수락 단계를 붙이면 돼요. 랑주뱅 한 스텝에 수락 단계를 붙인 이 방법을 MALA(Metropolis-adjusted Langevin algorithm)라고 불러요.

근데 왜 하필 제곱근이어야 하는지가 확률론 수업에서 본 거랑 똑같네요. 독립인 변수 n개를 더해서 √n으로 나누면 정규분포가 남고, n으로 나누면 큰 수의 법칙처럼 0으로 가잖아요. 노이즈에 η를 곱하는 건 n으로 나누는 경우예요.
문제 13. 이 샘플러는 몇 도에서 뽑나
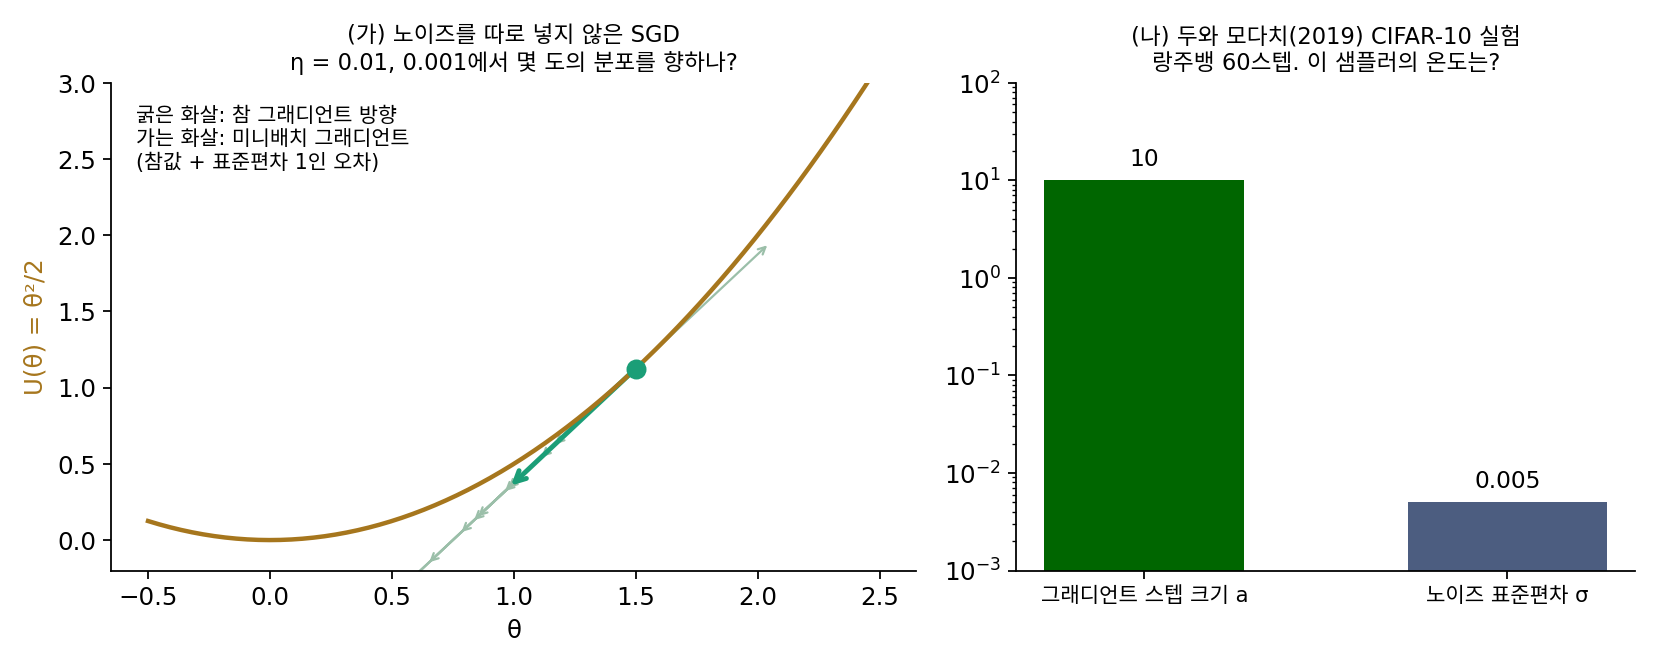
(가) 손실 U(θ) = θ²/2에서 노이즈를 따로 넣지 않은 SGD를 돌린다. 미니배치로 추정한 그래디언트는 참 그래디언트에 표준편차 1인 오차가 스텝마다 독립으로 섞인 것이다. 학습률 η = 0.01과 0.001에서 θ는 몇 도의 분포를 향하는가? (나) 두와 모다치(2019)는 CIFAR-10 실험에서 랑주뱅 한 스텝의 그래디언트 스텝 크기 a를 10, 노이즈의 표준편차 σ를 0.005로 두고 60스텝을 갔다. 이 샘플러의 온도는?
(가)는 SGD도 미니배치 노이즈가 원래 있으니까 샘플러인 셈이죠. 온도 1 근처 아닐까요?
그래디언트 오차에 η가 곱해지니까 한 스텝 노이즈는 σ = η × 1이야.
그걸 아까 그 온도 식에 넣으면?
σ²/(2a) = η²/(2η) = η/2이니까 0.005와 0.0005야. 학습률을 줄이면 식어.
헉, SGD는 처음부터 노이즈에 스텝 크기를 곱하고 있었던 거네요.
학습률이 크면 미니배치 노이즈도 무시할 수 없는 온도를 만들지만, 그 온도는 학습률, 미니배치 크기, 그래디언트의 분산에 따라 정해질 뿐 목표 온도 1에 맞춘 것이 아니에요. 그래서 SGLD는 노이즈를 따로 넣어요.
(나)로 가 볼까요? 논문의 식은 a = λ/2, σ² = λ로 온도 1에 맞춰져 있었어요.
0.005²/(2 × 10) = 1.25 × 10⁻⁶이요. 온도가 80만 분의 1이에요!
그 온도면 노이즈는 없는 거나 마찬가지고, 60스텝은 사실상 에너지의 내리막을 따라가는 경사하강이야. 모델 분포 e^(−E_θ)가 아니라 그보다 80만 배 낮은 온도의 분포를 향해 가는 거지.

그래요. 논문이 「EBM 학습은 MCMC 한 스텝의 크기에 가장 민감하다」고 적은 것도 그래서예요. 이렇게 학습된 E_θ를 온도 1의 볼츠만 분포 그대로 읽으려면 조심해야 해요.
보고서에는 「무작위로 골랐다」고 써 놓고 실제로는 늘 1등만 고른 셈이네요.