물리의 실험실에서 바꿀 수 있는 조건은 주로 온도지만, ML에서 바꾸는 것은 모델의 파라미터이고 파라미터의 개수도 하나가 아니다. 바꾸는 조건이 여러 개이면 요동-응답 관계는 어떤 모양이 될까?
로짓 두 개짜리 softmax
가장 작은 예부터 보자. 클래스가 둘인 softmax는 동전 하나와 같다. 로짓을 (z₀, 0)으로 두고 온도 1의 볼츠만 분포로 읽으면 ln Z = ln(1 + e^z₀)이다. ln Z를 z₀로 한 번 미분하면 e^z₀/(1 + e^z₀)이고, 이는 0번 클래스가 나올 확률 p₀다. 0번이 나오면 1, 아니면 0인 표시를 두면 그 평균이 p₀이니, 한 번 미분은 표시의 평균을 내준다. 한 번 더 미분하면 p₀(1 − p₀)인데, 이것은 앞면 확률이 p₀인 동전의 분산이다. z₀ = 1이면 p₀ = 0.731이고 ln Z의 2차 미분은 0.731 × 0.269 = 0.197이다. 역온도를 바꿀 때 ln Z의 2차 미분이 에너지의 분산이었듯, 로짓을 바꿀 때의 2차 미분은 그 로짓이 붙은 표시의 분산이다. 그렇다면 로짓 대신 아무 파라미터를 바꾸면 어떻게 될까?
로짓 두 개짜리 softmax(다른 로짓은 0)의 ln Z(위)와 그 2차 미분(아래). z₀ = 1에서 ln Z의 기울기는 0번 클래스의 확률 0.731이고, 2차 미분은 앞면 확률 0.731인 동전의 분산 0.197이다. 2차 미분은 두 클래스가 반반일 때(z₀ = 0) 가장 크고, 한쪽을 확신할수록 0으로 간다
ln Z를 파라미터로 두 번 미분하면
온도를 1로 두고 에너지 함수 E_θ(x)에 파라미터 θ = (θ₁, θ₂, …)가 들어 있는 볼츠만 분포 p_θ(x) = e^(−E_θ(x))/Z(θ)를 생각하자. ln Z를 θₐ로 한 번 미분하면 각 항에서 −∂E/∂θₐ가 내려오므로 ∂ln Z/∂θₐ = −⟨∂E/∂θₐ⟩이다. 에너지 기반 모델을 학습할 때 로그우도의 그래디언트에 나타나는 모델 쪽 평균이 바로 −⟨∂E/∂θₐ⟩다. ∂ln Z/∂θₐ를 θ_b로 한 번 더 미분하면, 역온도로 두 번 미분할 때와 같은 분수의 미분법으로 다음을 얻는다.
에너지가 파라미터의 일차식이라서 E_θ(x) = −Σₐθₐφₐ(x)처럼 파라미터가 어떤 특징 φₐ(x)의 계수로만 들어 있으면 마지막 항이 0이 되고, ln Z의 헤시안은 특징들의 공분산 행렬과 같아진다. softmax의 로짓이 바로 이런 파라미터다. 이때 한 번 미분한 결과가 ∂ln Z/∂θₐ = ⟨φₐ⟩이므로, 헤시안은 「θ_b를 조금 바꿨을 때 특징 φₐ의 평균이 움직이는 비율」이기도 하다. 요동-응답 관계를 여러 파라미터에 대해 한꺼번에 적은 행렬판이다. 공분산 행렬은 양의 준정부호(positive semidefinite: 어느 방향으로 재도 곡률이 음수가 아님)이므로 ln Z는 파라미터에 대해서도 볼록하고, 어떤 방향 c로 특징의 조합 Σₐcₐφₐ가 전혀 흔들리지 않으면 ln Z는 그 방향으로 곧은 선이 된다.
softmax로 확인하기
이번에는 바꾸는 변수를 온도에서 로짓으로 옮긴다. 로짓 z = (2, 1, 0)에서 logsumexp(온도 1의 ln Z)를 로짓으로 두 번 미분한 헤시안을 구하고, 모델이 이 확률로 라벨을 10만 번 뽑았을 때 원-핫 벡터의 표본 공분산과 비교한다. 크로스 엔트로피 손실의 헤시안이 정답 라벨에 따라 달라지는지도 확인한다.
ln Z의 헤시안과 모델이 뽑은 원-핫의 표본 공분산이 소수 셋째 자리로 반올림하면 같고, 크로스 엔트로피의 헤시안은 정답이 0이든 2든 똑같다. 고윳값 하나가 0이고 (1, 1, 1) 방향의 곡률이 컴퓨터의 반올림 오차 크기라는 것도 눈여겨보자. 이 두 사실이 무엇을 뜻하는지는 아래 ML 사례와 문제들에서 다룬다.
ML에서: 크로스 엔트로피의 곡률은 모델이 뽑은 라벨의 공분산이다
softmax 분류기를 온도 1의 볼츠만 분포로 읽으면 에너지는 Eᵢ = −zᵢ이고 ln Z = logsumexp(z)이다. 정답이 y일 때 크로스 엔트로피 손실은 −ln p_y = −z_y + ln Z인데, 앞의 −z_y는 로짓의 일차식이라 두 번 미분하면 사라진다. 그래서 손실의 헤시안은 ln Z의 헤시안뿐이고, 로짓이 에너지의 계수로 들어가는 경우이므로 그것은 모델이 뽑은 원-핫 벡터의 공분산이다.
py,piziZδij1[y′=i]softmax 확률 (정답 y의확률, i번째클래스의확률)로짓 (음의에너지)분배함수∑iezi (ln Z = logsumexp)i = j이면 1, 아니면 0모델이뽑은라벨 y’의원-핫벡터의 i번째성분
정답 y는 식의 어디에도 남지 않는다. 곡률은 데이터가 무엇이라고 말하는지와 상관없이, 모델이 지금 내놓은 확률로 라벨을 뽑는다면 원-핫 벡터가 얼마나 흔들릴지만으로 정해진다. 모델이 한 클래스를 확신해 p가 원-핫에 가까워지면 원-핫 벡터의 공분산이 사라지고 곡률도 0으로 간다. 학습이 진행되어 확신이 커질수록 손실 곡면이 평평해지는 것은 이 때문이다.
문제 6. 내일 날씨 예보의 세 표시
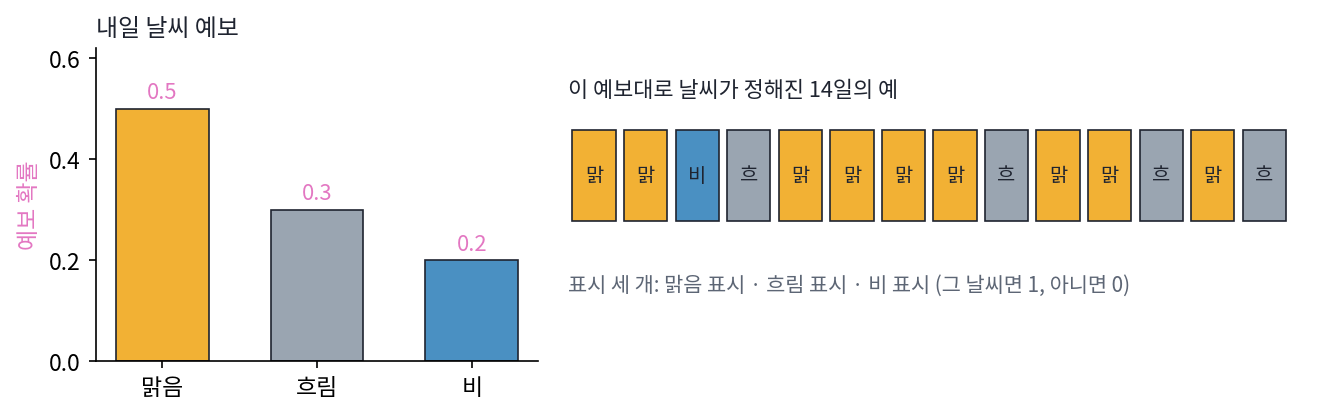
내일 날씨 예보가 맑음 0.5, 흐림 0.3, 비 0.2이고, 날씨가 이 확률대로 정해진다고 하자. 맑으면 1, 아니면 0인 「맑음 표시」처럼 날씨마다 표시를 하나씩 둔다. (가) 각 표시의 분산과 두 표시 사이의 공분산을 구하라. (나) 세 표시를 더한 값은 얼마나 흔들리는가?
문제 6의 예보(맑음 0.5, 흐림 0.3, 비 0.2)와, 이 예보대로 날씨를 뽑은 14일의 한 예. 표시는 날씨마다 하나씩 있다 (sources/ch10/problems_figs.py)
김민준
표시 하나는 앞면 확률이 p인 동전이랑 같으니까 분산이 p(1 − p)예요. 0.25, 0.21, 0.16이요. 맑음과 비는 서로 다른 날씨라 공분산은 0이고, 세 표시를 더한 값의 분산은 셋을 더한 0.62예요.
이서연
더한 값이 흔들린다고? 날씨는 셋 중 하나만 나오니까 세 표시를 더하면 늘 1이야. 더한 값은 흔들리지 않아야지.
선생님
맑음 표시가 1인 날 비 표시는 얼마죠? 공분산을 정의대로 계산해 봐요.
김민준
맑은 날엔 비 표시가 무조건 0이니까 둘을 곱한 값의 평균이 0이고, 공분산은 0 − 0.5 × 0.2 = −0.10이에요. 맑음–흐림은 −0.15, 흐림–비는 −0.06이고요.
선생님
그럼 세 표시를 더한 값의 분산을 다시 계산하면요?
김민준
합의 분산에는 공분산이 두 번씩 들어가니까 2 × (−0.31) = −0.62가 0.62를 정확히 지워서 0이 되네요.
이서연
대각에는 pᵢ(1 − pᵢ), 나머지 칸에는 −pᵢpⱼ니까 한꺼번에 적으면 diag(p) − ppᵀ구나. 세 성분을 모두 똑같이 1씩 움직이는 방향으로는 분산이 0인 행렬이고.
김민준
세 표시를 세 사람이 먹는 양으로 보면 피자 한 판을 셋이 나눠 먹는 거랑 같네요. 누가 한 조각 더 먹으면 누군가는 덜 먹으니까 먹는 양끼리는 늘 음의 상관이고, 셋이 먹은 양을 더하면 늘 한 판이에요.
문제 7. 파라미터가 제곱으로 들어가면
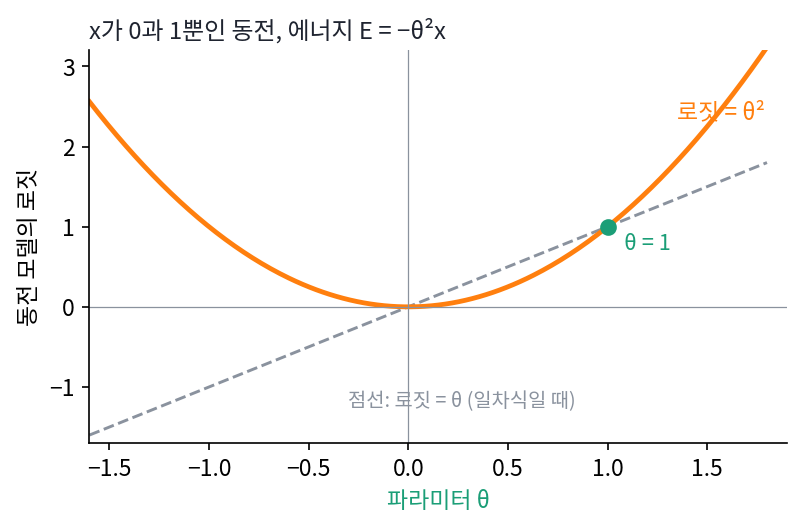
결과 x가 0과 1뿐인 동전 모델의 에너지를 E_θ(x) = −θ²x로 두자(로짓이 θ²인 모델이다). θ = 1에서 (가) ln Z(θ) = ln(1 + e^(θ²))를 θ로 두 번 미분한 값과 (나) ∂E/∂θ의 분산을 구해 비교하라. (가)와 (나)가 다르면 두 값의 차이는 어디서 오는가?
문제 7의 동전 모델에서 파라미터 θ에 따른 로짓 θ²(주황)과, 로짓이 θ 자체인 일차식 모델(점선). 두 모델은 θ = 1에서 만난다 (sources/ch10/problems_figs.py)
(가)를 직접 미분해 봤는데 안 맞아. ln(1 + e^(θ²))를 한 번 미분하면 2θp이고, 한 번 더 미분하면 2p + 2θ × 2θp(1 − p) = 1.462 + 0.786 = 2.248이야. 0.786보다 1.462만큼 커.
선생님
파라미터로 두 번 미분한 일반식에 항이 몇 개였죠?
김민준
두 개요. 공분산에서 ⟨∂²E/∂θ²⟩를 빼는 항이 있었어요.
선생님
이 모델에서는 그 항이 얼마죠?
김민준
∂²E/∂θ² = −2x니까 평균은 −2p = −1.462이고, 빼면 +1.462. 0.786 + 1.462 = 2.248로 (가)의 2차 미분과 맞네요. 에너지가 파라미터의 일차식이면 이 항이 0이라서 안 보였던 거예요.
이서연
합성함수를 두 번 미분할 때, 바깥 함수의 2차 미분에 안쪽 함수의 1차 미분의 제곱을 곱한 항 말고 바깥 함수의 1차 미분에 안쪽 함수의 2차 미분을 곱한 항이 하나 더 붙잖아요. 공분산이 앞의 항이고 1.462가 뒤의 항이에요. 안쪽이 일차식이면 뒤의 항이 사라지고요.
선생님
그래요. 신경망의 가중치는 로짓 안에 일차식으로 들어가지 않으니, 가중치로 잰 ln Z의 헤시안은 공분산 하나로 끝나지 않아요. 곡률을 공분산으로 읽고 싶으면 파라미터가 일차식으로 들어가는 자리, softmax라면 로짓에서 재야 해요.
문제 8. 정답이 사라진 헤시안
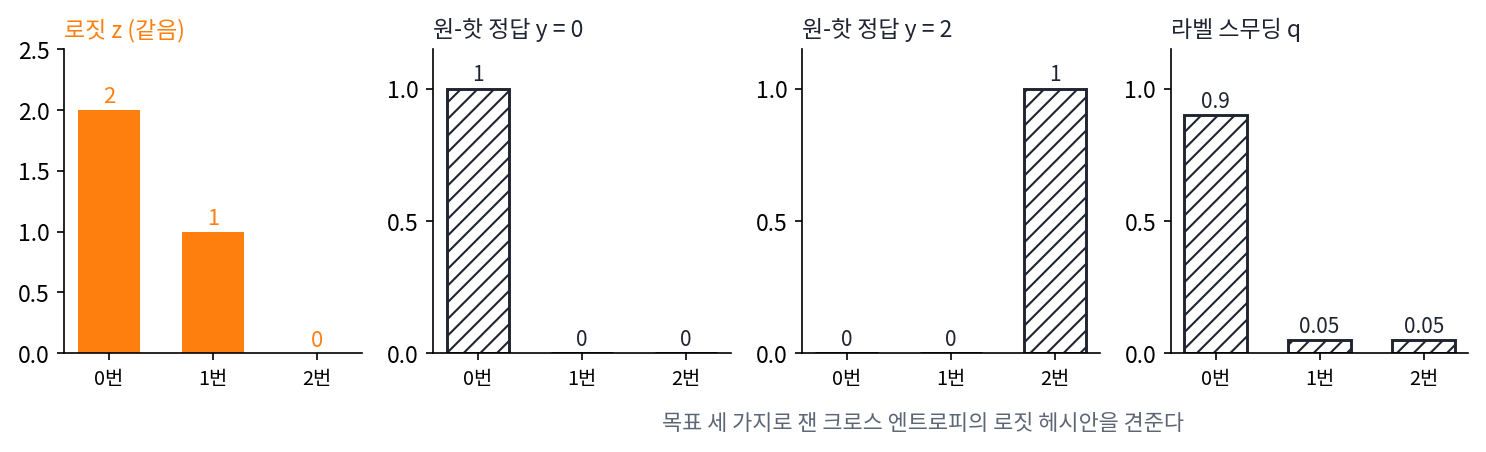
로짓 z = (2, 1, 0)인 softmax 분류기를 라벨 스무딩(label smoothing, 원-핫 정답 대신 정답에 0.9를 주고 남은 확률을 나머지에 나눠 준 목표로 학습하는 방법)으로 학습한다. (가) 정답이 0번일 때 목표 q = (0.9, 0.05, 0.05)로 잡은 크로스 엔트로피 −Σᵢqᵢ ln pᵢ를 로짓으로 두 번 미분한 헤시안은, 원-핫 정답 y = 0이나 y = 2일 때의 헤시안과 다른가? (나) 이 헤시안의 역행렬로 뉴턴 방법(그래디언트에 헤시안의 역행렬을 곱해 스텝을 정하는 최적화 방법)의 한 스텝을 계산할 수 있는가?
문제 8에서 견주는 세 목표: 원-핫 정답 y = 0, 원-핫 정답 y = 2, 라벨 스무딩 q = (0.9, 0.05, 0.05). 분류기의 로짓 (2, 1, 0)은 셋 다 같다 (sources/ch10/problems_figs.py)
김민준
원-핫 정답이면 −z_y가 일차식이라 사라진다는 건 봤는데, 라벨 스무딩은 정답이 셋에 섞여 있으니까 헤시안에 q가 남을 것 같아요. 계산해 볼게요. −Σᵢqᵢ ln pᵢ = −Σᵢqᵢzᵢ + (Σᵢqᵢ) ln Z… 앞의 항은 여전히 로짓의 일차식이고, Σᵢqᵢ = 1이라 뒤의 항은 그냥 ln Z네요. 이번에도 정답이 식에서 사라졌어요.
이서연
그럼 원-핫 정답 0이든 2든, 라벨 스무딩이든 헤시안은 셋 다 코드에서 본 그 행렬이야. 대각 성분이 (0.223, 0.185, 0.082)이고 원-핫의 공분산 diag(p) − ppᵀ랑 같았어.
김민준
날씨 표시 문제에서 본 행렬이네. 원-핫 벡터가 날씨 표시 세 개고, 모델이 내놓은 확률이 예보였던 거야.
이서연
그런데 q의 합이 1이라서 ln Z 앞의 계수가 1이 된 거잖아. 예제마다 비중을 달리 줘서 합이 1이 아니면?
김민준
정답 0번에 비중 1.5를 주고 돌려 보니 헤시안이 정확히 1.5배가 돼요. 대각이 (0.334, 0.277, 0.123)이요. 모양은 그대로고 크기만 비중만큼 커지네요.
선생님
손실의 값과 그래디언트는 목표에 따라 달라요. 그래디언트는 p − q라서 목표 쪽으로 당기는 방향이 다르죠. 곡률은 목표가 무엇인지가 아니라 목표에 준 비중의 합과 모델 자신의 확률로만 정해져요. 그럼 (나)의 뉴턴 방법은요?