합쳐 없앤 변수의 자유에너지: 숨은 변수가 남기는 상태의 수
학교 앞 분식집에 줄이 길면 우리는 그 집 대표 메뉴가 유난히 맛있으리라고 짐작한다. 그런데 손님이 가게를 고를 때는 대표 메뉴 하나가 아니라 그 가게에서 먹을 수 있는 메뉴 전부를 떠올린다. 분류기의 입력과 라벨, 잠재변수 모델의 관측값과 잠재변수도 이렇게 「가게와 메뉴」 같은 짝 (x, h)를 이룬다(VAE 논문들은 잠재변수를 z로 적지만, 이 책에서 z는 로짓이므로 잠재변수는 h로 쓴다. 글자만 바꾼 것이다). 관심 있는 것은 가게 x 쪽뿐일 때, 짝 (x, h)의 분포(결합 분포, joint)가 볼츠만 분포라면 메뉴 h를 모두 더해 없앤(주변화, marginalize) 가게의 분포는 어떤 모양이 되고, 그 에너지 자리에는 무엇이 남을까?
분식집 두 곳
숫자로 먼저 보자. 분식집 A와 B에 메뉴가 세 개씩 있고, 학생들의 만족도 점수가 A는 (3, 0, 0), B는 (3, 2, 2)다. 점심마다 학생들이 (가게, 메뉴) 한 쌍을 고르는데, 어떤 쌍을 고를 확률이 e^(만족도)에 비례한다고 하자. 만족도에 마이너스를 붙인 것을 에너지로 보면 온도 1의 볼츠만 분포다.
| 가게 | 메뉴 셋의 e^(만족도) | 합 | 가게 안에서 대표 메뉴를 시키는 비율 | 합 ÷ 대표 메뉴의 e^(만족도) |
|---|---|---|---|---|
| A | 20.09, 1, 1 | 22.09 | 0.909 | 1.10 |
| B | 20.09, 7.39, 7.39 | 34.86 | 0.576 | 1.74 |
가게 안에서 대표 메뉴를 시키는 손님의 비율은 A가 0.909로 훨씬 높다. 그러나 가게에 오는 손님 수는 그 가게 모든 메뉴의 e^(만족도)를 더한 값에 비례하므로, B에 오는 손님이 A보다 34.86 ÷ 22.09 = 1.58배 많다. 대표 메뉴의 점수는 두 가게가 3으로 같으니 차이는 나머지 메뉴가 보태는 e^(만족도)에서 난다. 합을 대표 메뉴 하나의 e³ = 20.09로 나누면 A는 대표 메뉴 1.10개어치, B는 1.74개어치를 가진 것과 같다. 이 장에서는 합을 가장 큰 항으로 나눈 이 비율을 「가장 좋은 상태 몇 개어치」라고 부른다.
가게의 손님 수를 에너지처럼 적으면 A는 −ln 22.09 = −3.09, B는 −ln 34.86 = −3.55다. 가장 낮은 메뉴의 에너지는 두 가게 모두 −3인데, 거기서 ln(몇 개어치)만큼(A는 ln 1.10 = 0.10, B는 ln 1.74 = 0.55) 더 내려간다. 메뉴를 합쳐 없앤 가게의 에너지 자리에는 가장 좋은 메뉴의 에너지 −3이 아니라 메뉴 전체의 −ln(합)(A는 −3.09, B는 −3.55)이 선다.
한 변수를 합쳐 없애면
일반적으로 계산해도 x의 분포는 볼츠만 분포의 모양을 한다. 다만 그 에너지 자리에는 x를 고정하고 h만의 분배함수를 계산해 얻은 자유에너지가 들어선다. 분식집에서 가게마다 구한 −ln(합)이 바로 그 자유에너지다.
h를 합쳐 없애면 h의 에너지만 남는 것이 아니라 h가 가질 수 있는 상태의 수도 함께 남는다. 그래서 F(x)는 가장 낮은 에너지 min_h E(x, h)보다 항상 낮고, 두 값의 차이는 kT × ln(가장 낮은 상태 몇 개어치)다. 여기서 「몇 개어치」는 합 Σ_h e^(−βE(x, h))를 그 가운데 가장 큰 항으로 나눈 값으로, 분식집 B의 1.74처럼 가장 낮은 에너지 상태와 같은 무게의 상태가 몇 개 있는 셈인지를 센다. 같은 모양이 물리와 ML의 여러 곳에 나온다.
| 합쳐 없앤 변수 | 남은 변수 | 남은 변수의 에너지 구실을 하는 F |
|---|---|---|
| HMC(위치에 가짜 운동량을 붙여 굴리며 샘플을 뽑는 방법)의 운동량 | 위치 q | F(q) = U(q) − kT ln Z_p. 운동량 쪽 분배함수 Z_p가 위치와 상관없는 상수라 위치의 분포는 e^(−βU)를 그대로 따른다 |
| 분류기의 라벨 y (에너지 E(x, y) = −z_y(x)) | 입력 x | F(x) = −logsumexp_y z_y(x) |
| 잠재변수 모델의 잠재변수 h (온도 1, 에너지 E(x, h) = −ln p(x, h)) | 관측값 x | F(x) = −ln p(x): 데이터의 음의 로그우도 |
어느 줄이든 숨은 변수의 자유에너지가 보이는 변수의 에너지가 되는데, 둘째 줄은 바로 아래 ML 소절에서, 셋째 줄은 다음 절의 ELBO에서 다시 만난다.
ML에서: 분류기가 버리던 logsumexp는 입력의 자유에너지다
방금 본 대로 분류기에서 라벨을 합쳐 없앤 입력의 자유에너지는 F(x) = −logsumexp_y z_y(x)이고 입력의 분포는 e^(−F(x))에 비례한다. Grathwohl 외(2020)의 JEM(joint energy-based model, 분류기 하나를 입력의 에너지 기반 모델로도 함께 학습한 방법)이 입력의 에너지로 쓴 −logsumexp가 바로 이 자유에너지다. Liu 외(2020)는 같은 양 −T·ln Σ_y e^(z_y(x)/T)를 「헬름홀츠 자유에너지」라 부르고, 학습 분포에서 벗어난 입력을 가려내는 점수로 썼다. 이 논문의 핵심 관찰은 「log max_y p(y|x) = E(x; f) + f_max(x)」라는 한 줄의 등식인데, 논문의 E(x; f)는 이 책의 F(x)이고 f_max는 가장 큰 로짓이다. 이 책의 말로 옮기면 Liu 외의 등식은 「softmax 신뢰도의 로그와 입력의 자유에너지는 가장 큰 로짓 하나만큼 떨어진 두 양이다」라는 뜻이다. 같은 입력을 두고 두 양이 어떻게 움직이는지는 문제 14에서 숫자로 확인한다.
제한된 볼츠만 머신(RBM)의 학습 코드에 흔히 있는 free_energy 함수도 같은 계산이다. 보이는 유닛 v가 정해지면 숨은 유닛들은 서로 독립인 2준위계라서 분배함수가 곱으로 쪼개지고, 합쳐 없앤 결과는 −Σᵢaᵢvᵢ − Σⱼln(1 + e^(bⱼ + Σᵢvᵢwᵢⱼ))라는, 합이나 적분 없이 바로 계산되는 식(닫힌 꼴)이 된다. 여기서 aᵢ와 bⱼ는 보이는 유닛 i와 숨은 유닛 j의 편향, wᵢⱼ는 둘을 잇는 결합 계수이고, 숨은 유닛 j 하나를 합쳐 없앨 때마다 그 유닛의 0과 1 두 상태에서 ln(1 + e^(…)) 한 항(softplus라 부르는 함수)이 나온다.
문제 13. 대표 메뉴가 더 맛있는 집과 메뉴가 고른 집
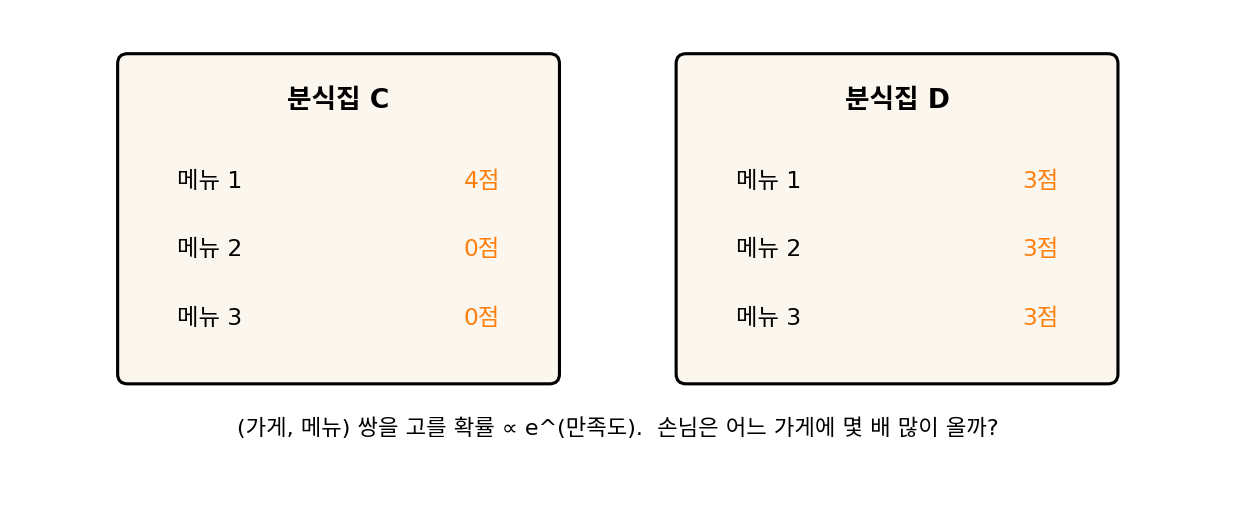
분식집 C는 메뉴 세 개의 만족도 점수가 (4, 0, 0)이고, 분식집 D는 세 메뉴가 모두 3점이다. 학생들이 (가게, 메뉴) 한 쌍을 고를 확률은 본문의 분식집처럼 e^(만족도)에 비례한다. (가) 각 가게에서 점수가 가장 높은 메뉴를 시키는 손님의 비율을 구하고, (나) 두 가게에 오는 손님 수의 비를 구하라. (다) D의 세 메뉴 점수를 모두 s로 똑같이 바꿀 때, s가 얼마보다 커야 D가 C보다 붐비는가?

(가)는 C가 e⁴/(e⁴ + 2) = 0.965, D는 세 메뉴가 똑같으니까 1/3이에요. (나)는 메뉴를 다 더해서 비교해야 하는 건 알아요. 그래도 C의 대표 메뉴는 4점이고 D는 제일 좋은 게 3점이잖아요. e⁴는 e³의 2.7배니까 C가 2.7배쯤 붐비겠죠.

가장 큰 항끼리만 견줬네요. D의 합은 가장 큰 항 몇 개어치죠?

세 메뉴가 같으니까 딱 3개어치요. D는 3 × 20.09 = 60.26, C는 54.60 + 1 + 1 = 56.60이에요. 2.7배는커녕 D가 1.065배 더 붐비네요.
(다)는 C의 합 56.60을 D의 3e^s와 같게 놓으면 되겠네. s = ln(56.60/3) = 2.94.
4점보다 1점 넘게 낮은데도 손님 수가 같아져?
메뉴가 셋이면 ln(합)이 ln 3 = 1.10만큼 커지니까, 대표 메뉴가 4점보다 1.10 남짓 낮아도 두 가게의 손님 수가 같아지는 거야. C의 나머지 두 메뉴가 조금 보태서 4 − 1.10 = 2.90이 아니라 2.94고.

점수가 1 높은 메뉴 하나와 점수가 같은 메뉴 셋의 겨루기예요. 에너지가 낮은 상태 하나와 경우의 수가 많은 상태들이 겨루는 것과 같은 꼴이죠.
동아리도 유명한 회장 한 명이 있는 곳보다 고루 괜찮은 선배가 셋 있는 곳에 신입생이 더 몰릴 수 있는 거네요.
문제 14. 확신이 높은 입력이 더 흔한 입력인가
세 클래스 분류기가 입력 x_a에 로짓 (2, 1, 0)을, 입력 x_b에 로짓 (2, −3, −3)을 내놓았고, 에너지를 E(x, y) = −z_y(x), 온도를 1로 둔다. (가) 각 입력의 softmax 최대 확률을 구하라. (나) 라벨을 합쳐 없앤 자유에너지 F(x)와 p(x_a)/p(x_b)를 구하라. (다) x_a의 로짓 전체에 상수 c를 더하면 (가)와 (나)의 답은 어떻게 되는가?
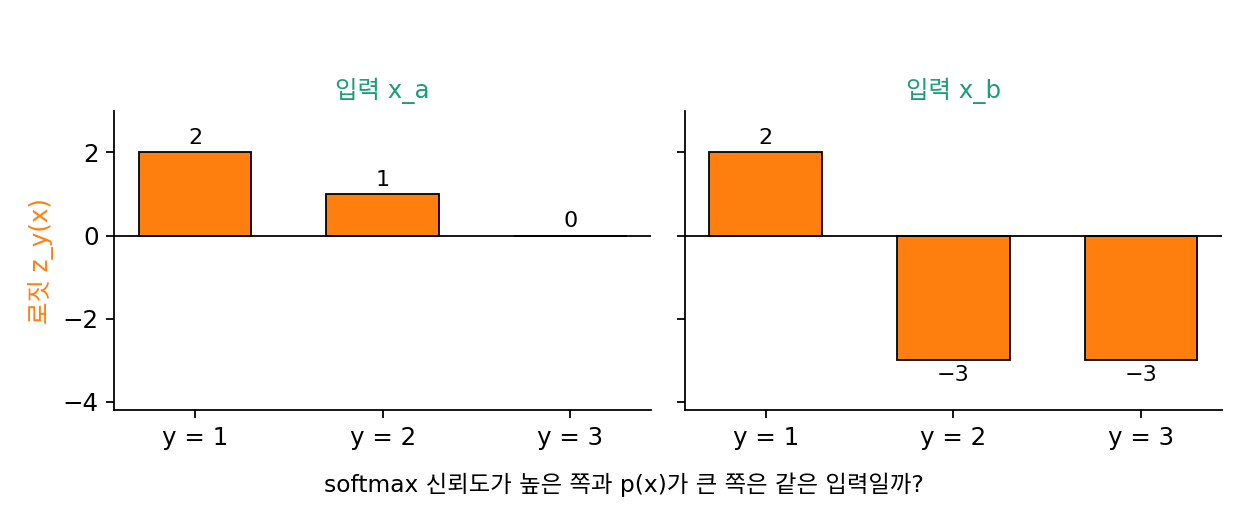
(가)는 x_a가 0.665, x_b가 0.987이에요. 두 입력 모두 가장 큰 로짓이 2라서 에너지는 −2로 같고, x_b 쪽이 훨씬 확신하니까 학습 데이터에 흔한 전형적인 입력이겠죠. p(x_b)가 더 클 거예요.
두 입력에서 가장 좋은 라벨의 에너지는 같다고 했죠. 그럼 p(x)를 정하는 F(x)는 무엇으로 갈리나요?
아, 분식집이랑 같아요. 입력이 가게고 라벨이 메뉴예요. 그럼 라벨을 합쳐 없앨 때 가장 낮은 에너지만 남는 게 아니겠네요.

그럼 두 입력의 F를 직접 계산해 볼까요?

F(x_a) = −ln(e² + e + 1) = −2.408이고 F(x_b) = −ln(e² + 2e⁻³) = −2.013이에요.

x_a 쪽이 더 낮으니까 p(x_a)/p(x_b) = e^(2.408 − 2.013) = 1.48이에요.
헉, 거꾸로네요. 확신이 낮은 x_a가 1.5배 더 흔한 입력이라고요?

두 입력 모두 가장 좋은 라벨의 에너지는 −2로 같아요. 차이는 나머지 라벨들에서 나요. x_a는 다른 라벨들의 에너지도 꽤 낮아서 합이 가장 좋은 라벨 1 + e⁻¹ + e⁻² = 1.503개어치이고, x_b는 1 + 2e⁻⁵ = 1.013개어치예요. F(x) = (가장 낮은 에너지) − ln(몇 개어치)라서 상태가 많은 쪽의 자유에너지가 낮아요.
그런데 softmax 최대 확률도 가장 좋은 라벨의 e^(로짓)을 합으로 나눈 거니까 1 ÷ (몇 개어치)이고, 그 로그는 −ln(몇 개어치)잖아요.
그럼 몇 개어치가 많아지면 두 점수는 각각 어떻게 움직이죠?
신뢰도는 떨어지고, 자유에너지도 떨어져서 입력은 더 흔해져요. 같은 양이 두 점수를 반대 방향으로 움직이는 거네요.
(다)는 쉬워요. 로짓에 상수를 더해도 softmax는 그대로니까 신뢰도는 안 바뀌고, 에너지 기준점을 옮긴 거니까 F도… 아니다, F는 −logsumexp라서 c만큼 그대로 내려가요. 그럼 p(x_a)는 e^c배가 되고요.

이상한데. 에너지에 상수를 더해도 확률은 안 바뀐다며. 기준점은 마음대로 옮길 수 있다고 했잖아.
모든 상태에 같은 상수를 더할 때만 그래요. 여기서 상태는 (x, y) 쌍 전체예요. x_a의 로짓에만 c를 더하면 x_a에 딸린 상태들의 에너지만 내려가고 다른 입력은 그대로니까, 공통 기준점을 옮긴 게 아니라 x_a의 에너지를 바꾼 거예요. softmax는 입력 하나 안에서만 정규화하니까 이 변화를 보지 못하는 거고요.
그럼 분류 손실만으로 학습하면 입력마다 로짓의 기준점이 제멋대로 떠 있어도 손실은 똑같겠네요. 그 F(x)를 믿어도 돼요?
좋은 의심이에요. 그래서 JEM은 분류 손실에 입력의 로그우도 항을 함께 넣어 학습했어요. 분류만 학습한 모델의 자유에너지를 점수로 쓴 Liu 외(2020)도 softmax 신뢰도보다는 학습 분포 밖의 입력을 잘 가려냈다고 보고했지만요.