테일러 전개: 0·1·2차 근사의 사다리
이 장의 물음
파이토치로 학습 코드를 짜면 한 스텝은 늘 같은 세 줄이다. loss = criterion(model(x), y)로 지금 파라미터에서 손실 값을 하나 재고, loss.backward()로 그래디언트를 채우고, optimizer.step()으로 파라미터를 옮긴다. 옵티마이저가 손에 쥔 것은 지금 서 있는 한 점에서 잰 숫자들뿐이다. 손실이 0.69이고, 어느 쪽으로 가면 얼마나 빨리 줄어드는지. 조금 떨어진 곳의 손실은 직접 재 보기 전에는 모르는데도, 옵티마이저는 스텝마다 어디로, 얼마나 갈지를 정해야 한다. 한 점에서 잰 숫자만으로 떨어진 곳을 내다보는 일이 어떻게 가능할까?
옵티마이저마다 재는 것도 다르다. 손실 값만 재는 방법이 있고, 그래디언트까지 쓰는 방법이 있고, 손실이 얼마나 휘었는지까지 쓰는 방법이 있다. 더 많이 재면 더 멀리 내다볼 것 같은데, 큰 신경망은 왜 거의 모두 그래디언트까지만 쓸까? 그리고 그래디언트로 내다본 예측은 얼마나 먼 곳까지 믿어도 될까? 학습률을 너무 키우면 학습이 무너지는 일도 예측을 믿을 수 있는 거리와 이어져 있을 것 같다.
이 장은 다음 물음에 차례로 답한다.
- 한 점에서 잰 값과 그래디언트로 조금 떨어진 곳의 손실을 얼마나 맞힐 수 있을까? 틀리는 양은 거리에 따라 어떻게 늘어날까?
- 손실의 바닥(손실이 가장 작은 곳)에서는 그래디언트가 0이다. 그 바닥이 어디 있는지 내다보려면 무엇을 더 재야 할까?
- 미분을 더 많이 하면 얼마든지 먼 곳까지 맞힐 수 있을까?
- 예측을 믿어도 되는 거리는 미리 계산할 수 있을까? 학습률은 그 거리와 어떻게 이어질까?
- 옵티마이저들은 한 점에서 무엇을 재고, 그것을 재는 데 얼마를 치를까?
1차 근사: 그래디언트로 한 스텝 앞을 내다보기
지금 자리의 손실 값 하나만 안다면, 조금 떨어진 곳의 손실은 어떻게 짐작할까? 가장 정직한 대답은 지금 값을 그대로 다음 자리의 예측으로 쓰는 「모르지만 아마 비슷하겠지」다. 이 예측은 어느 방향으로 가도 같은 값을 말하므로, 어디로 가야 손실이 줄어드는지 알려 주지 않는다. 그래디언트(손실이 가장 빨리 커지는 방향과, 그 방향으로 움직일 때 손실이 커지는 비율을 함께 담은 벡터)까지 알면, 오른쪽으로 0.1 가면 손실이 대략 얼마 늘거나 줄지를 말할 수 있다. 그 「대략」은 얼마나 맞고, 멀리 갈수록 얼마나 빨리 틀려 갈까?
역사: 로그표의 칸 사이를 직선으로 메우다
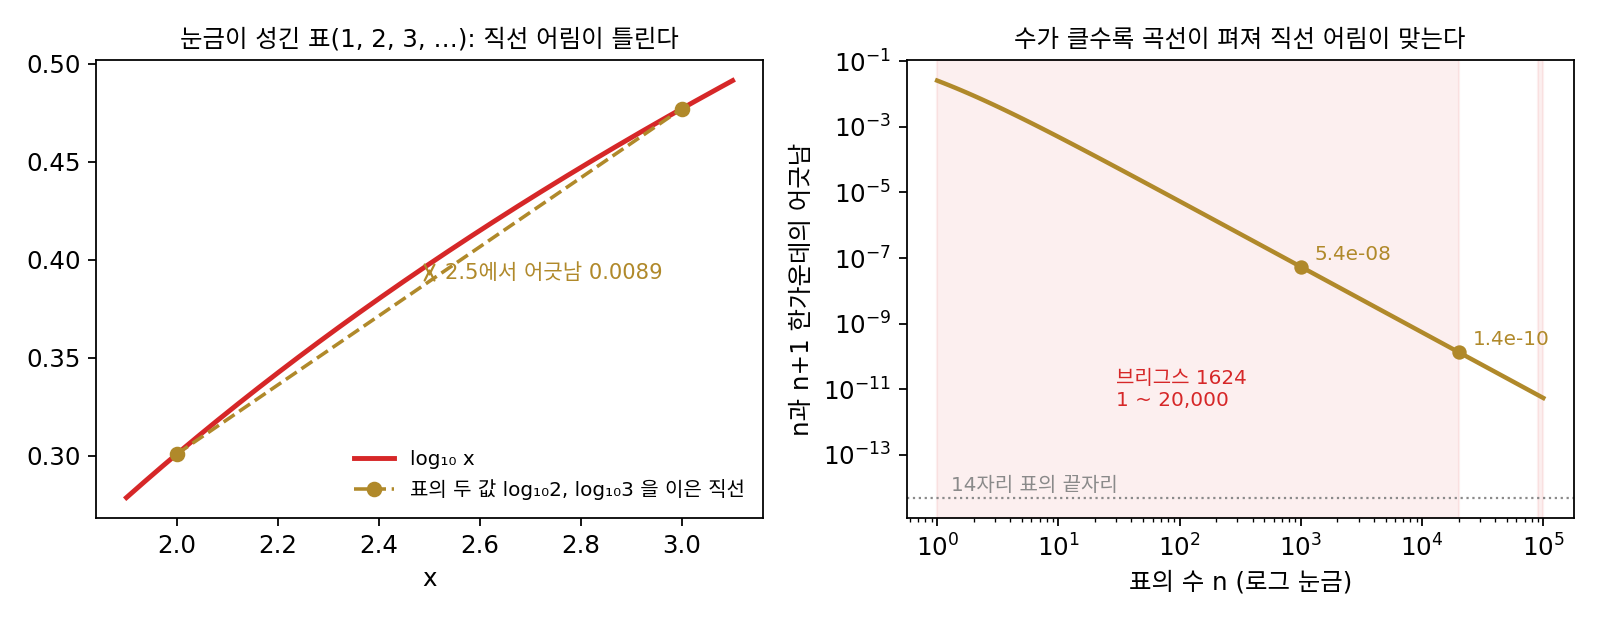
계산기가 없던 시절, 곱셈을 덧셈으로 바꿔 주는 로그는 천문학자와 항해사의 도구였고, 사람들은 계산한 로그 값을 표로 묶어 썼다. 영국의 수학자 헨리 브리그스(Henry Briggs)가 1624년에 펴낸 『로그 산술(Arithmetica Logarithmica)』은 1부터 20,000까지, 그리고 90,000부터 100,000까지의 정수에 대해 상용로그를 소수 열네 자리까지 실었다. 가운데 비어 있던 20,000부터 90,000까지는 네덜란드의 아드리안 블락(Adriaan Vlacq)이 1628년 판에 채웠다. 표에는 정수만 실리므로, 칸 사이에 있는 수의 로그가 필요하면 이웃한 두 칸의 값을 직선으로 이어 어림한다. 칸 사이의 짧은 곡선을 직선으로 보는 것이다.
이 직선 어림은 얼마나 틀릴까? 정수 n과 n + 1의 한가운데에서 직선이 곡선과 어긋나는 양을 계산하면, n이 1,000일 때 5.4 × 10⁻⁸이고 20,000일 때 1.4 × 10⁻¹⁰이다. 수가 20배 커지자 어긋남이 약 400배(20²배) 준 것은, 로그 곡선이 수가 클수록 펴져서 같은 한 칸 안에서도 직선과 덜 벌어지기 때문이다. 직선 어림의 어긋남은 곡선이 얼마나 휘었는지와 칸이 얼마나 넓은지 두 가지로 정해진다. 이 절은 이 관찰을 식으로 옮긴다.
계산기 없이 ln 1.1 어림하기
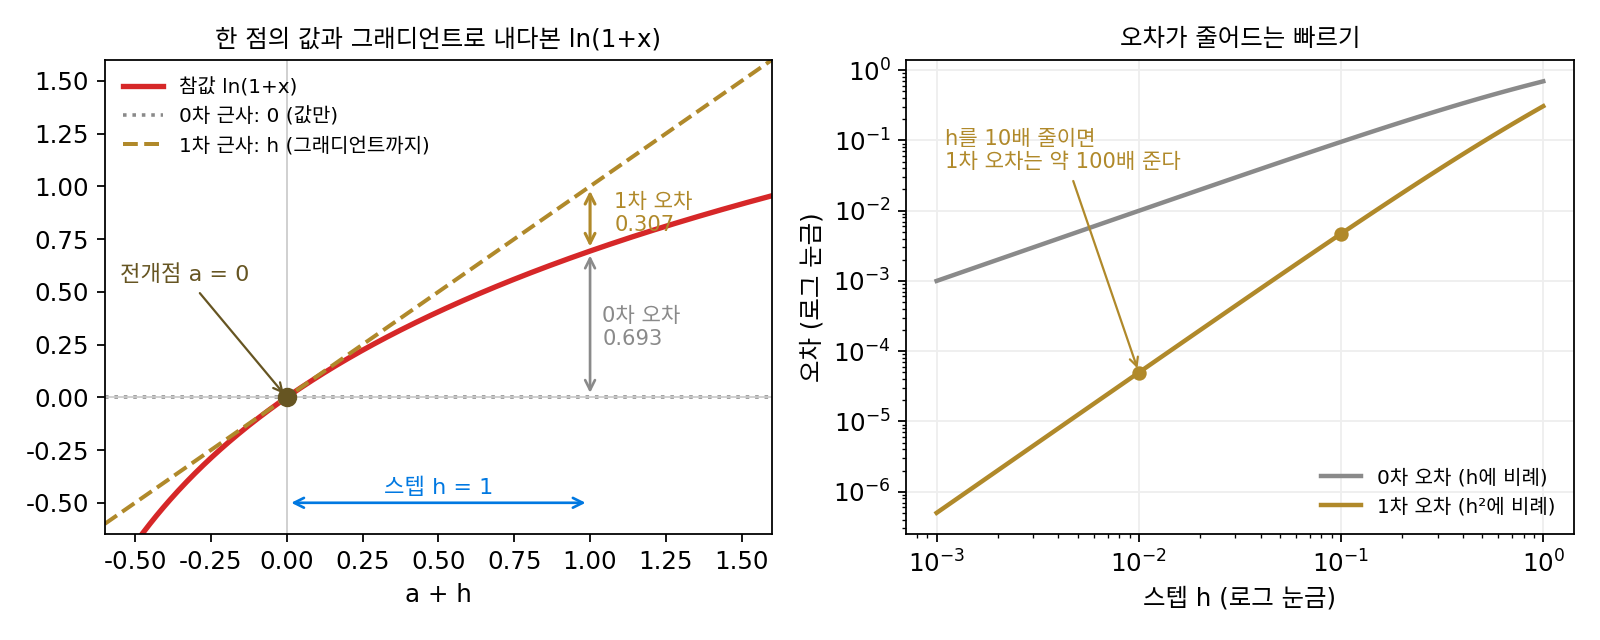
로그표 대신 손실 함수에서 직선 어림을 해 보자. 예제로는 ln(1 + x)를 고르는데, 분류 신경망의 손실인 크로스 엔트로피가 −ln p 꼴의 로그라서 ML 손실이 휘어 있는 모양의 대표이고, x = 0에서 값과 그래디언트를 암산으로 구할 수 있고, 계산기로 참값을 바로 확인할 수 있기 때문이다. 근사의 기준으로 삼는 점을 전개점이라 부르고 a로 적자. 전개점 a = 0에서 값은 f(0) = ln 1 = 0이고, 그래디언트는 f′(x) = 1/(1 + x)에서 f′(0) = 1이다.
값만 쓰는 예측은 f(h) ≈ 0이다. 그래디언트까지 쓰면 「1만큼 가면 1만큼 오른다」는 직선으로 f(h) ≈ 0 + 1 × h = h를 얻는다. 그러면 ln 1.1 ≈ 0.1인데, 계산기로는 0.095310이니 0.004690만큼 크게 어림했다. 스텝 h를 바꿔 가며 두 예측의 오차를 재면 다음과 같다.
| 스텝 h | 참값 ln(1 + h) | 값만 쓴 예측 0의 오차 | 그래디언트까지 쓴 예측 h의 오차 |
|---|---|---|---|
| 0.01 | 0.009950 | 0.009950 | 0.000050 |
| 0.1 | 0.095310 | 0.095310 | 0.004690 |
| 0.5 | 0.405465 | 0.405465 | 0.094535 |
| 1 | 0.693147 | 0.693147 | 0.306853 |
스텝을 0.1에서 0.01로 10배 줄이면, 값만 쓴 예측의 오차는 9.58배 줄고 그래디언트까지 쓴 예측의 오차는 94.42배 준다. 그래디언트까지 쓴 예측의 오차는 거의 h²/2다(h = 0.1이면 0.005, 실제 0.004690). 스텝을 반으로 줄이면 오차는 4분의 1로 준다. 오차가 늘 같은 방향(예측이 참값보다 큼)인 것도 눈여겨보자. ln(1 + x)는 위로 볼록하게 휘어서, 전개점에서 그은 직선보다 늘 아래에 있다.
지금 자리의 값과 그래디언트만으로 떨어진 곳의 손실을 직선으로 예측하는 것을 1차 근사 (접선으로 내다보기 / first-order approximation)라 한다. 스텝 h의 1제곱까지 쓰기 때문에 붙은 이름이고, 같은 뜻으로 값만 쓰는 예측은 0차 근사라 부른다.
파라미터가 여럿이면 파라미터 벡터 θ(세타)를 옮기는 스텝도 벡터 Δθ(델타 세타)가 되고, 그래디언트 ∇𝓛(∇는 나블라라고 읽는다)와 스텝의 내적, 곧 파라미터마다 (그 방향의 그래디언트 성분) × (그 방향으로 옮긴 양)을 모두 더한 것이 1차 근사의 변화량이다.
ML에서: 경사하강은 1차 근사를 믿고 걷는다
그래디언트 반대쪽으로 그래디언트에 학습률 η(에타)를 곱한 만큼 옮기는 경사하강의 한 스텝 Δθ = −η∇𝓛를 1차 근사에 넣으면, 손실이 ∇𝓛·(η∇𝓛) = η|∇𝓛|²만큼 준다고 예측된다. 같은 스텝 길이라면 이 예측 감소가 가장 큰 방향이 그래디언트 반대쪽이므로, 경사하강을 「가장 가파른 내리막」이라 부르는 것은 1차 근사 안에서 하는 말이다.
입력이 둘이고 샘플이 200개인 로지스틱 회귀(분류 손실을 쓰는 가장 작은 선형 모델. 데이터는 씨앗을 고정해 만들었다)에서 파라미터 0을 출발점으로 이 예측을 실제와 맞대 보자. 출발점의 손실은 0.6931이고 |∇𝓛|² = 0.1075다. 학습률 0.1이면 1차 근사가 예측한 감소는 0.01075, 실제 감소는 0.01062로 98.8%가 맞는다. 학습률 1이면 예측 0.1075에 실제 0.0950으로 88.4%만 맞으니, 스텝이 열 배 길어지자 예측이 실제에서 눈에 띄게 벗어나기 시작했다. 어디까지가 믿을 만한 스텝인지는 1차 근사가 버린 항의 크기를 따져야 답할 수 있고, 그 계산은 나머지항이라는 개념으로 한다.
문제 1. 출발하는 자동차의 위치 어림
정지해 있던 자동차가 매초 속도가 2 m/s씩 붙으며 출발했다. 출발 뒤 t초에 자동차는 출발점에서 t² m 떨어져 있으므로, 5초 뒤에는 25 m 지점을 속도 10 m/s로 지나고 있다. (가) 지금 속도 그대로 간다고 보고 1초 뒤, 2초 뒤의 위치를 어림하라. 실제 위치와는 몇 m 다른가? (나) 10초 뒤의 어림은 몇 m 틀리는가? (다) 어림하는 시간을 10배 늘리면 틀리는 양은 몇 배가 되는가?

1초 뒤는 25 + 10 = 35 m인데 실제는 6² = 36 m라서 1 m 틀려요. 그러면 10초 뒤는 10배니까 10 m쯤 틀리겠네요.

10초 뒤도 직접 계산해 볼까요?

어림은 25 + 100 = 125 m, 실제는 15² = 225 m요. 100 m나 틀려요! 2초 뒤는 45 m와 49 m로 4 m, 5초 뒤는 75 m와 100 m로 25 m고요. 1, 4, 25, 100이에요.

틀린 양이 시간의 제곱이네. (5 + h)²을 풀면 25 + 10h + h²이잖아. 25 + 10h가 지금 속도로 간다는 어림이고, 남는 게 h²이야.

그 h²은 어디서 왔을까요? 지금 속도 10 m/s를 쓴 어림이 놓친 것이 무엇인지 보세요.
속도가 매초 2씩 붙는다는 거요. 가속도를 놓쳤어요.
가속도 때문에 더 간 거리를 식으로 쓰면요?

½ × 2 × h² = h²이요. 아까 풀어 쓴 식에서 남은 그 h²이네요.
그럼 (다)는 10배가 아니라 100배네.
응. 지금 속도만 쓰는 어림은 1차 근사이고, 그 오차는 시간의 제곱으로 커지는 거야.

지난주 하루에 과제 다섯 쪽 썼으니 마감까지 열흘이면 쉰 쪽이라고 계산했다가 크게 틀린 적이 있어요. 날마다 쓰는 속도가 조금씩 늘었으니, 지금 빠르기로 열흘 뒤를 내다본 게 틀린 거네요.
문제 2. 1차 근사가 0이라고 말하는 스텝
함수 f(x, y) = x²y의 점 (1, 2)에서 그래디언트는 (2xy, x²) = (4, 1)이다. (가) 스텝 (0.1, −0.1)에 대해 1차 근사가 예측하는 변화와 실제 변화를 구하라. (나) 스텝 (0.1, −0.4)는 1차 근사로 얼마나 변한다고 예측되는가? 실제 변화는? (다) (나)의 스텝을 (0.01, −0.04)로 10배 줄이면 실제 변화는 몇 배 줄어드는가?
(가)는 4 × 0.1 + 1 × (−0.1) = 0.3이고, 실제로는 1.1² × 1.9 − 2 = 0.299야. 거의 맞아.
(나)는 4 × 0.1 + 1 × (−0.4) = 0이니까 변하지 않아요. 그래디언트와 수직인 스텝이에요.
실제 값도 계산해 볼까요?

1.1² × 1.6 = 1.936이라서 0.064만큼 줄었어요. 0이라더니 줄었네요. 반대 스텝 (−0.1, 0.4)로 가 봐도 0.9² × 2.4 = 1.944라서 0.056만큼 줄어요. 양쪽 다 줄어요.

1차 근사라면 반대로 가면 부호가 바뀌어야 하잖아. 양쪽 다 준다는 건 1차가 아닌 무언가가 남았다는 뜻이야. (다)를 해 보면 스텝을 10배 줄였을 때 변화가 −0.064에서 −0.000604로 106배 줄어. 거의 100배니까 스텝의 제곱에 비례하는 양이네.

그래요. 그래디언트와 수직인 방향에서는 1차 항이 0이라, 그다음 항이 변화를 정해요. 그 항은 무엇이 정할까요?

스텝의 제곱에 비례하니까 함수가 그 방향으로 얼마나 휘었는지가 정하겠죠. 1차 근사가 0이라고 말해도 실제로 아무 일이 없다는 뜻은 아니네요. 해석학에서 극값의 후보는 미분이 0인 곳에서 찾지만, 극대인지 극소인지는 거기서 끝나지 않던 것과 같아요.

등고선을 따라 걸으면 높이가 안 변한다고 배웠는데, 곧은 직선으로 걸으면 휜 등고선에서 벗어나니까 결국 높이가 변하는 거군요.
문제 3. float32 로 계산한 ln(1 + 0.000001)
이진 분류 손실을 계산하다 보면 아주 작은 x에서 ln(1 + x)를 구할 일이 생긴다. 신경망은 보통 float32(32비트 실수)로 계산하고, float32에서 1 바로 다음 수는 1과 1.19 × 10⁻⁷만큼 떨어져 있다. (가) x = 10⁻⁶일 때 float32로 1 + x를 먼저 만들고 로그를 취하면 얼마가 나오는가? 참값 9.999995 × 10⁻⁷과 견줘라. (나) 1차 근사 ln(1 + x) ≈ x로는? (다) x = 10⁻⁸이면 두 방법은 각각 무엇을 내는가?
컴퓨터가 로그를 틀릴 리 없죠. torch.log(1 + x)로 하면 돼요. 돌려 보니… 9.536739 × 10⁻⁷이요? 참값보다 4.6%나 작아요.
로그를 취하기 전에, float32로 만든 1 + 10⁻⁶은 정확히 1.000001일까요?
아, 1 근처에서는 수가 1.19 × 10⁻⁷ 간격으로만 있으니까 1.000001은 가장 가까운 칸으로 반올림돼요. 로그는 정확한데 넣은 수가 이미 틀렸어요. x = 10⁻⁸이면 1 + x가 그냥 1이 돼서 로그가 0이에요.
1차 근사 x는 10⁻⁶을 그대로 내니까 상대 오차가 x²/2를 x로 나눈 5 × 10⁻⁷밖에 안 돼. 10⁻⁸에서는 더 작고. 「정확한 식」보다 「근사」가 더 정확하네.
파이토치에는 torch.log1p라는 함수가 따로 있어요. 1 + x를 만들지 않고 ln(1 + x)를 계산하도록 만든 함수예요. 10⁻⁶에 넣으면 9.999995 × 10⁻⁷, 10⁻⁸에 넣으면 1.000000 × 10⁻⁸을 내요. 왜 이런 함수가 필요했을까요?
작은 x에서 ln(1 + x)는 x와 거의 같은데, 1 + x를 만드는 순간 x의 아랫자리가 반올림으로 사라지니까요. x가 그만큼 작을 때는 1차 근사가 가르쳐 주는 대로 x를 직접 다뤄야 정보가 남아요.
이진 크로스 엔트로피를 직접 짜지 말고 라이브러리의 BCEWithLogitsLoss를 쓰라는 말이 그래서였구나. 보고서 표에서 0.4%를 소수 첫째 자리로 반올림해 0%라고 적었다가 조교님께 지적받은 적이 있는데, 1 + x를 만들면서 x의 아랫자리가 사라지는 것도 그렇게 반올림에 묻히는 거네요.