왜 늦게 배우나: 신경 탄젠트 커널의 고윳값이 높은 주파수에서 작다
경사하강이 어떤 순서로 오차를 줄이는지는 이미 답이 있었다. 손실이 2차식이면 헤시안(2차 편미분을 모은 행렬)의 고유 방향마다 오차가 따로 줄고, 고윳값 λ가 큰 방향은 스텝마다 1 − ηλ 배씩 빨리, 고윳값이 작은 방향은 느리게 채워진다. 가는 물결이 늦게 맞는 것도 이 이야기로 설명할 수 있을까? 그러려면 신경망의 학습을 「어떤 행렬의 고유 방향마다 따로 줄어드는 일」로 적어야 하고, 그 고유 방향이 물결처럼 생겼어야 한다.
역사: 커널 하나로 학습을 적다
2018년 스위스 로잔 연방공대의 자코(Arthur Jacot)와 동료들은 폭이 아주 넓은 망의 학습이 커널 하나로 적힌다는 것을 보였다. 점 x′ 하나에서 오차를 줄이려고 한 스텝 가면 다른 점 x의 출력도 함께 움직이는데, 그 정도가 두 점에서 잰 그래디언트(망의 출력을 파라미터로 미분한 벡터)의 내적 K(x, x′) 이고, 이것을 신경 탄젠트 커널이라 부른다. 폭이 넓으면 학습 내내 이 커널이 거의 바뀌지 않는다.
그런데 라하만 외의 실험에서 높은 주파수의 진폭을 크게 주어도 순서가 바뀌지 않았던 것처럼, 순서를 정하는 것은 과녁이 아니라 망 쪽에 있었다. 스펙트럼 편향의 실험이 나오자, 이 커널을 주파수로 나눠 보면 되겠다는 생각이 곧 이어졌다. 바스리(Ronen Basri), 제이컵스(David Jacobs)와 동료들은 2019년 신경정보처리학회(NeurIPS)에 낸 「주파수가 다른 함수를 배울 때 신경망의 수렴 속도」에서 이 생각을 계산으로 밀고 나갔다. 입력을 구 위에 고르게 놓으면 넓은 망의 학습을 적는 선형 계의 고유 함수가 구 위의 물결(구면 조화)이 된다는 결과를 써서, 주파수마다의 고윳값을 구하고 주파수별로 배우는 데 걸리는 시간을 예측해 얕은 망과 깊은 망의 실험에 맞대었다. 같은 계산에서 뜻밖의 것도 나왔다. 은닉 뉴런마다 입력에 더하는 상수 항(bias)을 뺀 얕은 망은 3, 5 처럼 낮은 홀수 주파수(1 보다 큰 홀수)의 물결조차 나타내지도 배우지도 못했다. 그 주파수들에서는 커널의 고윳값이 0 이었던 것이다.
넓은 망의 커널을 고유 방향으로 나누기
1차 근사가 잘 맞도록 넓은 망을 쓰자. 은닉층 하나에 폭 1024 인 ReLU 망이고, 과녁과 학습 점은 앞의 장난감과 같다. 이번에는 Adam 대신 손실 (1/2N) Σ r² 의 경사하강(학습률 η = 0.008)으로 학습한다. 학습 전에 학습 점 128개 사이의 커널을 모두 재어 128 × 128 행렬 K를 만들면, 1차 근사에서 학습 점의 남은 오차는 다음처럼 바뀐다.
남은 오차를 고유벡터 vᵢ들로 다시 적으면, 축마다 스텝당 (1 − ηλᵢ) 배씩 따로 준다. 이차 함수 손실에서 경사하강이 헤시안의 고유 방향마다 따로 줄던 것과 같은 꼴이다. 그러면 고유벡터는 어떻게 생겼는지, 실제로 구해 큰 것부터 차례로 늘어놓으면 다음과 같다.
| 순위 | 1 | 2 | 3 | 4 | 5 | 7 | 9 | 11 | 13 | 15 |
|---|---|---|---|---|---|---|---|---|---|---|
| 고윳값 λ | 181.8 | 45.6 | 1.93 | 0.256 | 0.0710 | 0.0121 | 0.00358 | 0.00158 | 0.00078 | 0.00043 |
| 가장 센 주파수 | 0 | 1 | 1 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
고유벡터는 순위가 내려갈수록 부호가 바뀌는 횟수가 0, 1, 2, 3, … 으로 하나씩 늘어나는 물결 꼴이다(구간의 두 끝이 이어지지 않아 깔끔한 사인은 아니고, 표의 「가장 센 주파수」는 이산 푸리에 변환으로 읽은 값이다). 고윳값은 출렁임이 늘수록 빠르게 작아진다. 주파수 1 이 가장 센 첫 고유벡터의 고윳값은 45.6, 주파수 2 는 0.0710, 4 는 0.00358, 8 은 0.000272, 10 은 0.000132 다. 주파수 2 에서 4 로 두 배가 되면 고윳값은 20분의 1 로, 4 에서 8 로는 13분의 1 로, 8 에서 16(0.0000315)으로는 9분의 1 로 준다. 가는 물결 쪽 축은 스텝마다 거의 줄지 않는 것이다. 스텝당 배율 1 − ηλ로 오차가 10% 로 주는 스텝 수 ln 10/(ηλ) 를 계산하면, 주파수 1 의 축은 6 스텝, 주파수 2 의 축은 4053 스텝이다. 주파수 10 의 축은 얼마나 걸릴지 문제 5 에서 따진다.
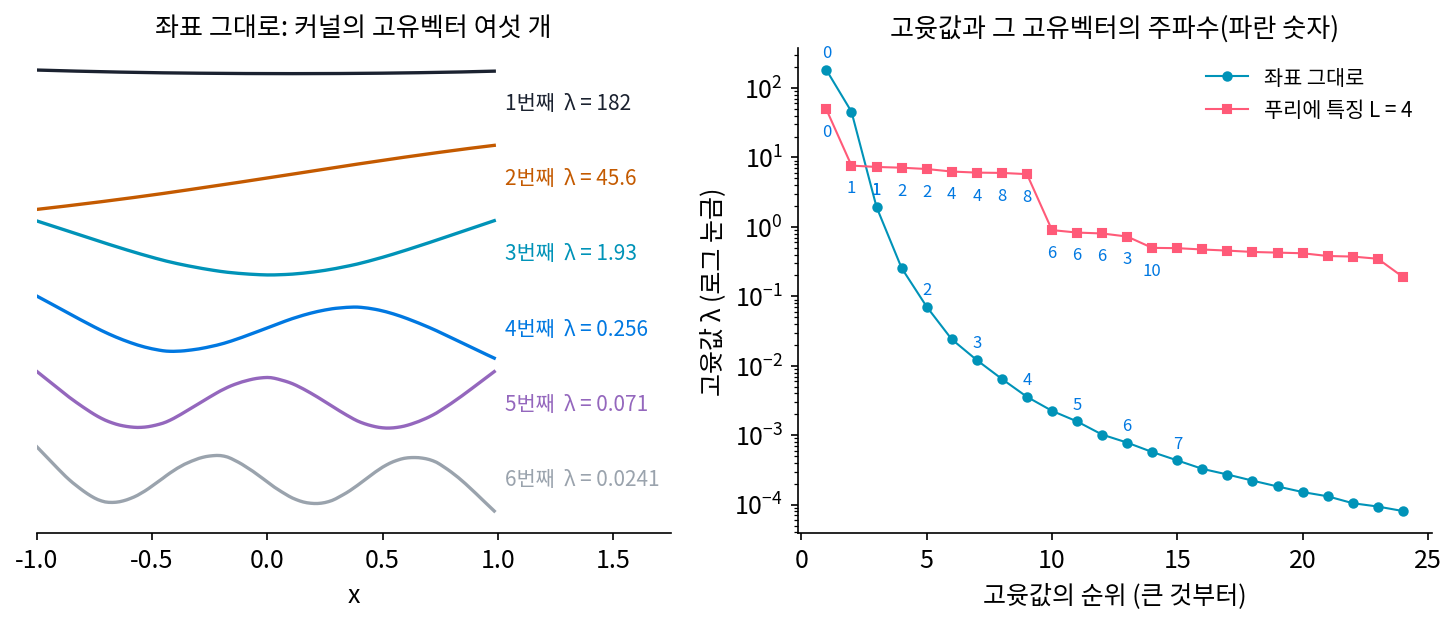
실제 경사하강과 견주어 보자. 위 식으로 학습 전의 커널만 써서 예측한 남은 진폭과 실제로 학습한 망의 남은 진폭은 거의 같다. 굵은 물결은 3000 스텝 뒤 실제 0.004, 예측 0.005 로 거의 다 맞았고, 가는 물결은 실제 0.491, 예측 0.494 로 0.514 에서 거의 줄지 않았다. 이렇게 신경 탄젠트 커널의 고윳값을 고유벡터의 주파수에 따라 늘어놓은 것을 신경 탄젠트 커널의 스펙트럼 (주파수마다 오차가 스텝당 줄어드는 비율을 정하는 고윳값 / NTK spectrum)이라 한다. 스펙트럼 편향은 이 스펙트럼이 높은 주파수 쪽으로 가파르게 내려가기 때문에 생긴다. 망이 가는 물결을 그릴 수 없는 것이 아니라, 가는 물결 쪽 축의 고윳값이 작아서 경사하강이 그 축을 아주 천천히 채운다.
ML에서: 일찍 멈추면 가는 무늬가 덜 들어온다
높은 주파수를 늦게 배운다는 것은 쓸모도 있다. 학습 데이터의 노이즈는 대개 모든 주파수에 고르게 흩어져 있고, 쓸 만한 신호는 낮은 주파수에 몰려 있는 경우가 많다. 그러면 망은 신호를 먼저 배우고 노이즈 가운데 높은 주파수 쪽은 한참 뒤에야 외운다. 검증 손실이 가장 낮을 때 학습을 멈추는 일찍 멈추기가, 주파수의 말로는 높은 주파수 축을 덜 채운 채로 멈추는 일이 된다. 쉬즈친과 동료들도 첫 글에서 주파수 원리로 일찍 멈추기가 왜 통하는지를 설명했는데, 노이즈가 얼마나 잘 걸러지는지는 아래 문제 6 에서 잰다.
문제 4. 두 가지 빚 갚기
민준이 빚 두 가지를 갚는다. 학자금은 100만 원인데 다달이 남은 액수의 20% 를 갚고, 친구에게 빌린 돈은 50만 원인데 다달이 남은 액수의 1% 만 갚는다. (가) 몇 달 뒤에 각 빚이 처음의 10% 아래로 내려가는가? (나) 두 빚을 합친 남은 돈이 처음 150만 원의 10% 아래로 내려가는 것은 언제인가? (다) 6개월 뒤 남은 합계만 보고 「빚이 3분의 1로 줄었으니 1년이면 거의 끝난다」고 하면 맞는가?
(가)는 학자금이 0.8ⁿ < 0.1 이니까 n > ln 10/(−ln 0.8) = 10.3, 11 개월이요. 친구 돈은 0.99ⁿ < 0.1 이라 229.1, 230 개월이에요. 거의 20년이네요.
(나)는 100 × 0.8ⁿ + 50 × 0.99ⁿ < 15 를 풀어야 해. 학자금은 금방 없어지니까 결국 50 × 0.99ⁿ < 15 근처, 120 개월쯤 될 거야.
계산해 보면 몇 개월째죠?
120 개월에 100 × 0.8¹²⁰ + 50 × 0.99¹²⁰ = 14.97 만 원(학자금은 거의 0), 119 개월에 15.12 만 원이라 120 개월이에요.
그럼 (다)는요? 6개월 뒤 합계부터 구해 봐요.
100 × 0.262 + 50 × 0.941 = 26.2 + 47.1 = 73.3 만 원이에요. 3분의 1 은커녕 절반이네요. 1년 뒤에는 6.9 + 44.3 = 51.2 만 원이고요.
처음 몇 달은 합계가 빠르게 줄어요. 그 몇 달 동안 줄어든 돈은 거의 다 학자금이에요.
처음 6개월에 줄어든 76.7 만 원 가운데 73.8 만 원이 학자금이에요. 합계가 빨리 줄던 것을 보고 앞으로도 그렇게 줄 거라고 보면 안 되네요. 빚마다 줄어드는 비율이 따로 있으니까, 느린 쪽이 남으면 합계도 느려져요.
아까 학습 손실이 처음에 확 줄다가 0.12 근처에서 안 줄던 거랑 같은 모양이에요. 학자금이 굵은 물결이고 친구 돈이 가는 물결이네요.
문제 5. 학습률을 키우면 되지 않을까
넓은 망의 커널에서 가장 큰 고윳값은 181.8, 주파수 10 이 가장 센 첫 고유벡터의 고윳값은 0.000132 다. (가) 학습률 η = 0.008 에서 그 축의 오차가 10% 로 주는 스텝 수는? (나) 가는 물결을 빨리 배우려고 학습률을 100배(0.8)로 키우면 어떻게 되는가? (다) 학습률을 키울 수 있는 끝까지 키우면 주파수 10 의 축은 몇 스텝이 드는가? 학습률로 두 고윳값의 차이를 메울 수 있는가?
(가)는 ln 10/(0.008 × 0.000132) = 218만 스텝이요. (나)는 100배면 2만 2천 스텝이니까, 학습률을 키우면 되겠네요.
학습률 0.8 에서 가장 큰 고윳값의 축은 스텝마다 몇 배가 되죠?
1 − 0.8 × 181.8 = −144.4 배요. 스텝마다 부호가 바뀌면서 144배씩 커져요. 그 축이 터지네요.
1 − ηλ 의 크기가 1 보다 작아야 하니까 η < 2/181.8 = 0.0110 이 끝이야. (다)는 그 끝 0.0110 을 써도 ln 10/(0.0110 × 0.000132) = 159만 스텝.
학습률은 가장 큰 고윳값이 정하고, 걸리는 스텝 수는 가장 작은 고윳값이 정해요. 둘의 비가 181.8/0.000132, 약 138만 배니까 학습률을 아무리 골라도 가는 물결은 굵은 물결보다 백만 배쯤 오래 걸려요. 그런데 이 계산은 하나를 가정했어요. 무엇이었죠?
커널이 학습 내내 그대로라는 1차 근사요. 그런데 잠깐, 앞의 폭 128 짜리 세 층 망은 Adam 으로 3000 스텝 만에 가는 물결을 맞췄잖아요.
159만 스텝이라더니 3000 스텝? 계산이 틀린 거야?
폭 1024 망에서는 예측이 실제와 맞았어. 커널이 학습 중에 바뀌거나, Adam 이 축마다 스텝 크기를 따로 맞춰 주면 159만 스텝이라는 계산이 달라지는 걸 거야.
그럼 두 경우에 같았던 건 뭐였죠?
「굵은 물결이 먼저」라는 순서요. 그건 두 경우 모두 같았어요.
가장 느린 팀원에게 맞춰 마감을 늦추든지, 가장 급한 팀원 때문에 속도를 못 내든지, 둘 중 하나밖에 못 하는 거네요. 조별 과제가 늘 그래요.
문제 6. 노이즈 섞인 정답에서 언제 멈출까
장난감 과녁(sin πx + 0.5 sin 10πx)의 학습 점 128개에 표준편차 0.3 의 노이즈를 더해 정답으로 쓰고, 처음의 작은 망(폭 128 세 층, Adam)을 3000 스텝 학습한다. 시험 손실은 학습 점 사이 한가운데 128 점에서 노이즈 없는 과녁과 견줘 잰다. (가) 노이즈 자체의 제곱 평균은 0.0749 다. 학습 손실이 끝까지 0 으로 내려가는 것이 좋은 일인가? (나) 시험 손실이 가장 낮은 스텝과 그때의 시험 손실·학습 손실은? (다) 시험 손실이 가장 낮은 스텝에서 멈추면 무엇이 걸러지고 무엇이 남는가?
(가)는 학습 손실이 0 이면 다 맞춘 거니까 좋은 거죠. 돌려 보면 3000 스텝에 학습 손실 0.0476 이고 계속 줄어요.
학습 손실이 0.0749 보다 작다는 건 무슨 뜻이에요?
과녁을 완벽하게 맞혀도 학습 손실은 노이즈의 제곱 평균 0.0749 가 남아야 하는데 그보다 작으니까, 노이즈까지 따라가기 시작했다는 거네요. 0 까지 가면 노이즈를 다 외운 거고요.
(나)는 시험 손실이 1800 스텝째 0.0192 로 가장 낮아. 그때 학습 손실은 0.0545 로, 노이즈 제곱 평균보다 조금 작은 정도야. 3000 스텝에는 시험 손실이 0.0246 으로 다시 올라.
(다)는요? 남은 오차를 주파수로 나눈 값을 보세요.
1800 스텝 근처를 보면… 가는 물결(주파수 10)까지 거의 맞췄어요. 주파수 20…64 에 남은 진폭은 평균 0.04 대고요.
노이즈는 처음에 그 주파수들에 얼마나 있었죠?
0.047 이요. 조금만 줄었네요. 높은 주파수의 노이즈는 아직 거의 안 외운 거예요.
과녁은 낮은 주파수에 있고 노이즈는 모든 주파수에 퍼져 있으니까, 일찍 멈추면 노이즈만 덜 배우는 거구나.
응, 스펙트럼 편향 덕에 멈추는 스텝 수가 필터 노릇을 해.
과녁의 가는 물결이 주파수 30 이었으면 노이즈랑 같이 늦게 배워져서 이렇게 깔끔하게 안 갈렸겠네요. 교수님이 실험 데이터에 맞춘 곡선이 너무 꼬불꼬불하면 측정 노이즈까지 따라간 거라고 하신 게 이거였어요.