잔차: 맞힌 만큼 새로 적을 것이 준다
지금까지는 점들이 몇 방향으로 분포해 있는지를 측정했지만, 이 책의 물음은 「얼마나 짧게 적을 수 있나」였다. 판 위의 점은 2차원이라 해도, 실제로는 두께만큼 떠 있어서 셋째 좌표 x₃을 x₁, x₂에서 오차 없이 계산할 수는 없다. 그렇다면 x₃은 결국 따로 적어야 하고, 판 위에 있다는 사실은 아무것도 아껴 주지 못하는 걸까? 친구가 말을 반쯤 하면 나머지를 추측할 수 있듯, 다 맞히지는 못해도 거의 맞힐 수 있다면 그만큼은 덜 적어도 될 것 같다.
역사: 거꾸로 맞혀도 거의 똑같았다
1951년 섀넌(Claude Shannon)은 논문 「인쇄된 영어의 예측과 엔트로피(Prediction and Entropy of Printed English)」(『Bell System Technical Journal』 30권, 50~64쪽)에서 사람의 머리를 다음 글자 예측기로 썼다. 상대가 처음 보는 글 한 대목을 선택해 첫 글자부터 맞히게 하고, 맞히면 다음 글자로 넘어가고 틀리면 틀렸다고만 말해 다시 맞히게 하면서, 글자마다 몇 번째 추측에서 맞혔는지를 적었다. 이 놀이의 상대는 벨 연구소에서 수치 계산을 하던 아내 베티 섀넌이었고, 섀넌이 서가에서 레이먼드 챈들러의 탐정 소설을 꺼내 아무 대목이나 짚었다고 전해진다. 논문의 한 예에서는 기호 102개 가운데 79개를 첫 추측에 맞혔고, 다섯 번 넘게 걸린 것은 여덟 개뿐이었다. 틀리는 곳은 주로 새 단어의 첫 한두 글자였고, 단어가 시작되고 나면 나머지 글자는 거의 한 번에 맞혔다. 첫 추측에 맞힌 글자는 받는 쪽도 이미 추측하니 새로 알려 주는 것이 거의 없고, 앞을 충분히 아는 사람에게 영어 글자 하나는 평균 1비트 안팎만 새로 알려 준다는 것이 이 실험의 결론이었다. 같은 논문에는 두 가지 대목이 더 있다.
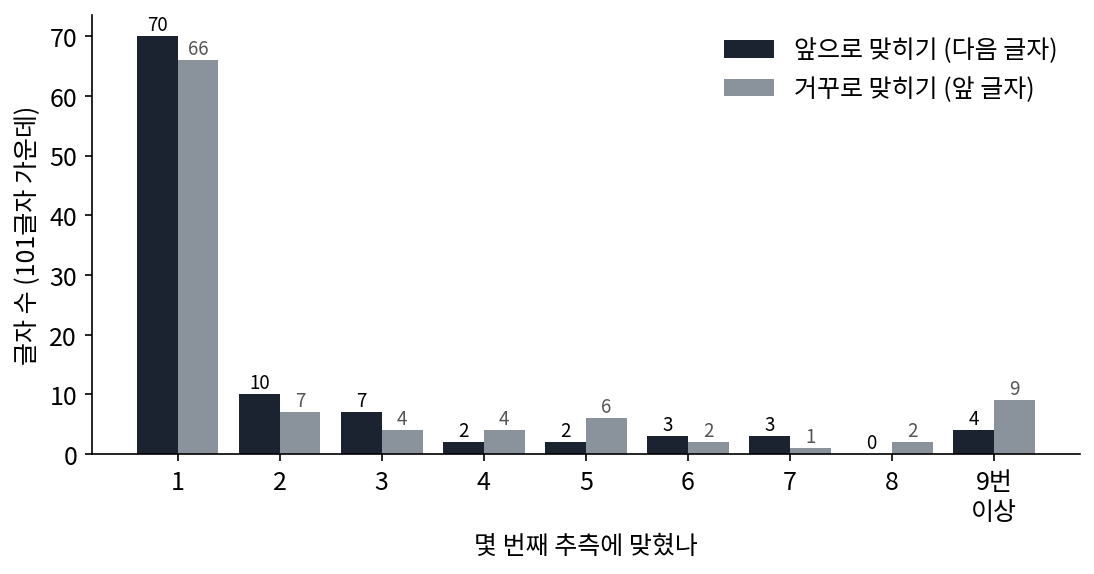
하나는 거꾸로 맞히기다. 섀넌은 같은 글에서 뽑은 101글자짜리 두 대목으로, 한 번은 앞 글자들을 보고 다음 글자를, 한 번은 뒤 글자들을 보고 바로 앞 글자를 맞히게 했다. 거꾸로 맞히기는 하는 사람에게 훨씬 어렵게 느껴졌지만, 첫 추측에 맞힌 글자는 앞으로 맞히기 70자, 거꾸로 맞히기 66자로 성적이 조금만 나빴다. 섀넌은 글자 n개 묶음의 통계로 정한 엔트로피가 글을 뒤집어도 같다는 것을 식으로 보였다. 이 책 식으로 읽으면, 글이 맞혀지는 것은 읽는 방향 때문이라기보다 글자들이 서로를 묶는 규칙이 있기 때문이다.
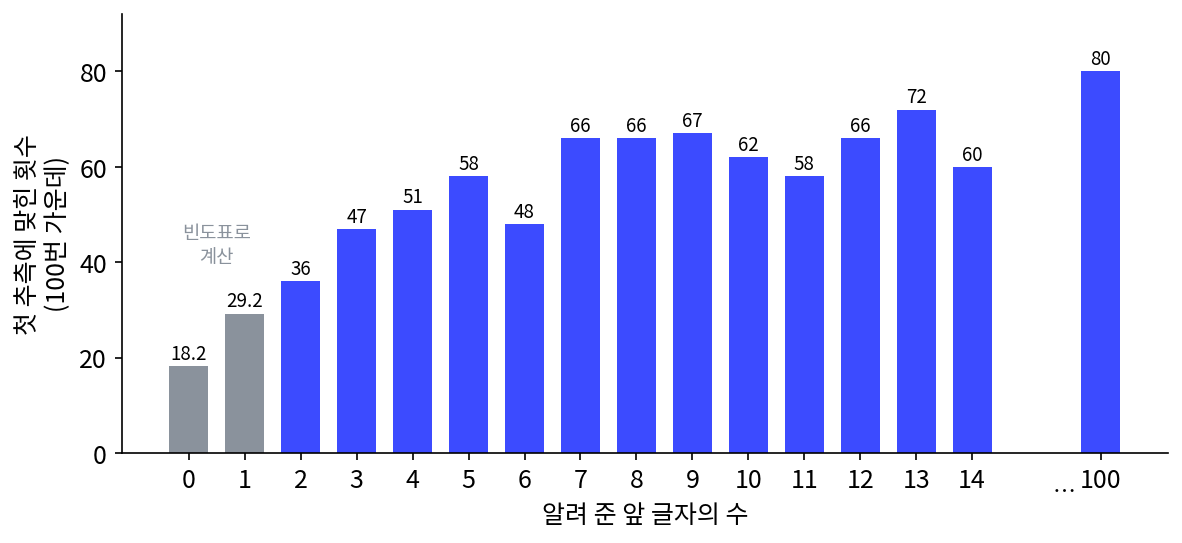
다른 하나는 맞힌 순번만 보고 엔트로피의 범위를 정한 방법이다. 섀넌은 책 한 권에서 15글자짜리 대목 100개를 뽑아, 앞 글자를 0개부터 14개까지 알려 준 상태에서 다음 글자를 맞히게 하고, 몇 번째 추측에 맞혔는지의 분포를 집계했다. 앞 글자를 100개 알려 주는 시험도 따로 했다. 그리고 그 분포만으로 글자 하나의 엔트로피를 위아래로 가두는 두 식을 냈다(아래 경계는 가장 잘 맞히는 이상적인 예측기에 대해 증명한 것을 사람의 자료에 쓴 것이다). 앞 글자를 하나도 모를 때(이 경우의 순번 분포는 사람 대신 글자 빈도표로 계산했다) 그 범위는 3.19~4.03비트였고, 앞 글자를 100개 알 때는 0.6~1.3비트였다. 맞히는 사람의 머릿속 규칙을 꺼내 보지 않고도, 맞힌 순번만 받아 적으면 「새로 알려 주는 양」의 범위가 나온다. 범위를 내는 두 식은 아래 문제 11에서 직접 써 본다.
다음 글자 맞히기면 지금은 언어 모델한테 시키면 되잖아요. 사람을 앉혀 놓고 한 글자씩 묻는 건 손이 너무 많이 가요.
1951년에 섀넌이 엔트로피를 계산할 때 쓴 것은 남이 세어 둔 글자 하나, 두 글자, 세 글자의 빈도표였어요. 그러면 앞의 열 글자를 보고 다음 글자를 맞히는 표는 어떨까요?
음, 글자가 27가지니까 열 글자 묶음은 27¹⁰가지… 206조 가지예요. 그 칸마다 빈도를 손으로 세는 건 안 되겠네요.
그래서 섀넌은 빈도표 대신 영어를 오래 읽어 온 사람의 머리를 예측기로 썼어요. 머릿속 규칙은 꺼내 볼 수 없으니, 몇 번째 추측에 맞혔는지만 받아 적은 거죠.
그런데 아래 경계는 가장 잘 맞히는 예측기에 대해 증명했다면서요. 사람이 그런 예측기인지는 모르잖아요.
맞아요. 아래 경계의 증명을 사람의 자료에 그대로 쓴 데에는 빈틈이 있어요. 그때 섀넌이 가진 예측기는 사람뿐이었으니까요. 오늘 우리는 예측기를 직접 만들어서 맞힌 결과를 얼마든지 셀 수 있고요.
그럼 점 구름에서도 사람 대신 가까운 이웃 몇 개로 x₃을 맞혀 보면, 맞힌 만큼 덜 적을 수 있을까요?
이웃으로 x₃ 맞히기
섀넌의 사람 대신, 점 구름에서 가장 단순한 예측기를 써 보자. 점마다 (x₁, x₂)가 가장 가까운 다른 점 5개를 찾아 그 x₃의 평균을 그 점의 x₃으로 맞힌다. 규칙을 모르고 이웃만 보는 방법이라, 판이든 공이든 똑같이 쓸 수 있다.
두께 0.02인 판에서 x₃의 표준편차는 0.280인데, 이웃으로 맞히고 남은 오차의 제곱평균제곱근(오차를 제곱해 평균 낸 뒤 제곱근을 씌운 값, 분포 폭을 표준편차와 같은 단위로 측정한다)은 0.019였다. 공에서는 x₃의 표준편차가 0.443이고 남은 오차는 0.485로, 이웃으로 맞힌 값이 그냥 평균 0을 대는 것보다도 나빴다(sources/low-dimension/s4_predict.py). 공에서는 (x₁, x₂)를 알아도 x₃이 위아래 어디에나 있을 수 있어서, 이웃의 x₃은 아무것도 알려 주지 않는다. 이웃 다섯의 x₃ 평균은 오히려 제 나름의 오차를 더했다.
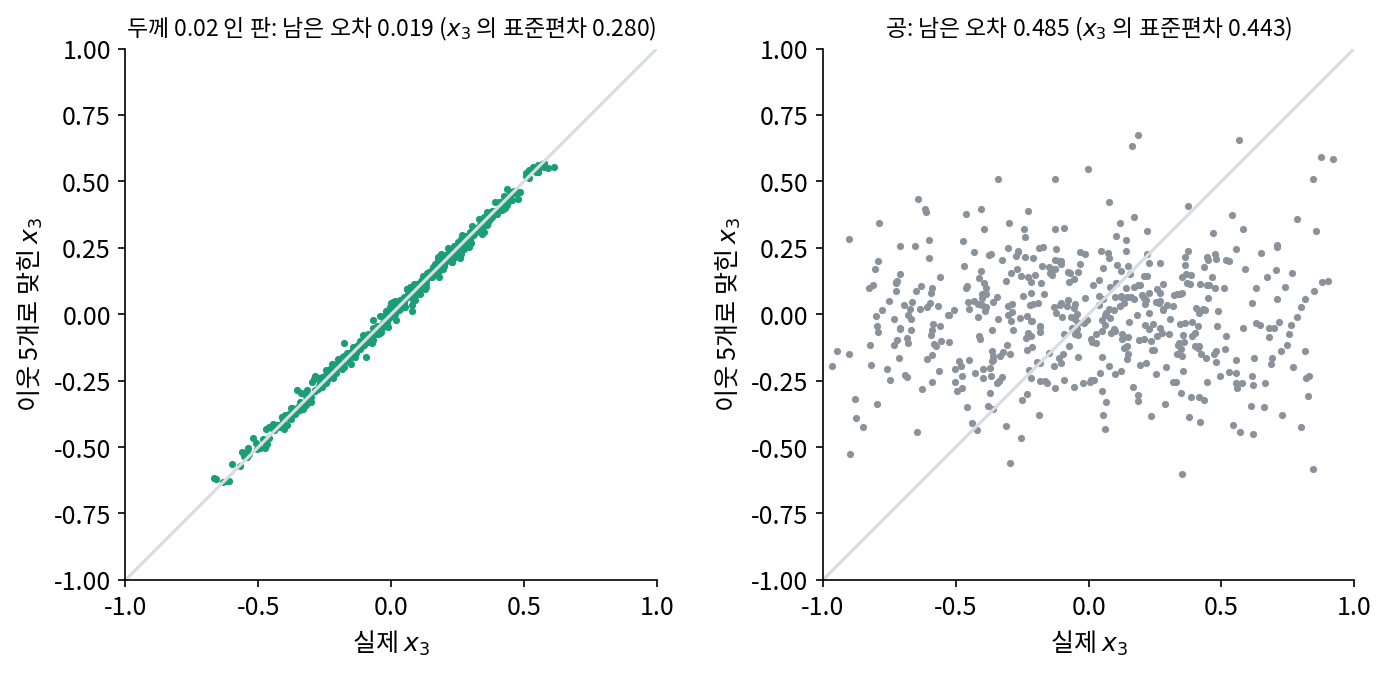
맞힌 값을 받는 쪽도 똑같이 계산할 수 있다면, x₃ 대신 「실제 값 − 맞힌 값」만 보내면 된다. 이렇게 예측하고 남은 오차를 잔차 (예측이 못다 맞힌 나머지, residual)라 한다. 판에서 잔차는 x₃ 자체보다 훨씬 좁게 분포해 있다. x₃을 0.01 간격으로 적는다고 하자. 분포 폭이 넓을수록 값의 가짓수가 많아지고, 폭이 절반이 될 때마다 가짓수가 절반이 되어 1비트가 덜 든다. 그래서 잔차를 적으면 아끼는 비트 Δℓ(Δ는 델타라고 읽고, 「차이」를 뜻한다)는 분포 폭의 비의 log₂다.
판에서는 log₂(0.280 ÷ 0.019) = 3.89비트를 점마다 아낀다. 공에서는 log₂(0.443 ÷ 0.485) = −0.13비트로, 이웃 예측을 쓰면 오히려 손해다. 판 위에 있다는 사실은 x₃을 「적지 않아도 되는 칸」으로 만들어 주지는 못하지만, 「거의 적지 않아도 되는 칸」으로 만들어 준다. 그리고 그 「거의」를 비트로 측정할 수 있다. 적어도 이 판에서는, 내재 차원이 낮다는 것과 다음 좌표를 잘 맞힐 수 있다는 것이 함께 간다.
아래 위젯에서 판 두께를 키워 보자. 두께가 커질수록 잔차가 넓어지고, 아끼는 비트는 줄어든다. 위젯 1에서 두께를 키우면 측정한 차원이 2에서 3으로 오르던 것을, 이번에는 아낀 비트로 보는 것이다.
게임 서버의 델타 스냅숏: 받는 쪽이 가진 지난 상태로 맞히기
1999년에 나온 온라인 슈팅 게임 퀘이크 III 아레나(Quake III Arena)의 네트워크 설정 메뉴에는 「Data Rate」라는 칸이 있고, 첫 줄 「<= 28.8K」는 전화선 모뎀을 뜻한다. 이 줄을 선택하면 서버는 그 플레이어에게 초당 2,500바이트까지만 보낸다. 서버는 기본으로 1초에 20번, 그 순간 게임 속 세상의 상태를 담은 스냅숏을 보내므로 스냅숏 하나에 쓸 수 있는 한도는 125바이트, 1,000비트다. 그 안에 화면 속 캐릭터 여럿의 위치와 동작을 어떻게 담았을까?
캐릭터 하나의 상태는 위치, 속도, 바라보는 방향, 애니메이션 번호 같은 칸 51개로 되어 있다. 칸마다 4바이트로 그냥 적으면 1,632비트라 캐릭터 하나도 들어가지 않는다. 그래서 퀘이크 III 서버는 이 상태를, 클라이언트(플레이어의 컴퓨터)가 받았다고 알려 온 지난 스냅숏과 비교해 바뀐 칸만 보낸다. 이렇게 지난 상태와의 차이만 보내는 방식을 델타 압축이라 부른다. 칸마다 「바뀌었나」 표시 1비트를 붙이고 바뀐 칸에만 새 값을 적으며, 바뀐 칸이 하나도 없는 캐릭터는 한 비트도 보내지 않는다. 클라이언트는 지난 스냅숏을 들고 있으니, 「지난번 그대로」를 맞힌 값으로 삼고 틀린 칸만 받는다. 맞힌 값을 받는 쪽도 똑같이 알고 있을 때 잔차만 보내던 것과 같은 구조다.
이 게임 소스 코드(2005년 GPL로 공개)의 규칙을 그대로 옮긴 스크립트로 장난감 캐릭터 하나의 비트를 계산해 보았다. 캐릭터는 0.5초 서 있다가, 초속 320유닛(이 게임의 기본 달리기 속력)으로 1초 동안 곧게 달리고, 다시 0.5초 선다(sources/low-dimension/s5_delta_snapshot.py). 모든 칸이 0인 기준 상태와 비교해 보내면 스냅숏마다 178~193비트가 든다. 지난 스냅숏과 비교해 보내면 서 있는 동안에는 0비트이고, 달리는 동안에는 x 좌표 한 칸만 바뀌어 37비트다. 2초 동안 보낸 스냅숏 40개의 합은 그냥 적으면 65,280비트, 기준 상태와 비교하면 7,420비트, 지난 스냅숏과 비교하면 1,000비트다. 모뎀 한도 1,000비트에 달리는 캐릭터를 담으면, 기준 상태와 비교할 때는 다섯, 지난 스냅숏과 비교할 때는 스물일곱이 들어간다.
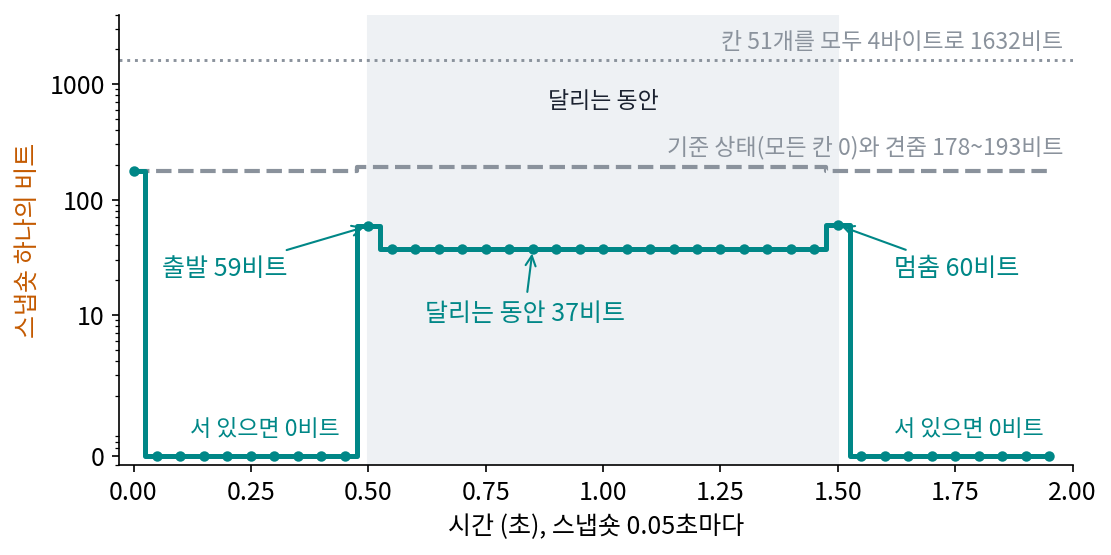
예측이 틀리는 순간도 그림에 보인다. 출발하는 스냅숏에서는 속도와 다리 애니메이션이 함께 바뀌어 59비트, 멈추는 스냅숏에서는 위치·속도·애니메이션이 바뀌어 60비트로 뛴다. 「지난번 그대로」라는 예측은 같은 동작을 이어 가는 동안에만 잘 맞고, 동작이 바뀌는 곳마다 잔차가 커진다. 더 크게 깨지는 곳은 패킷이 계속 사라질 때다. 클라이언트가 받았다고 알려 온 스냅숏이 보낸 메시지 수로 29개(초당 20번이면 1.45초) 넘게 뒤처지면, 서버는 비교할 스냅숏이 없다고 보고 기준 상태와 비교해 보낸다. 맞힌 값을 받는 쪽도 가지고 있어야 잔차만 보낼 수 있다는 조건이, 여기서는 「받았다고 알려 온 스냅숏」이라는 형태로 드러난다.
ML에서: 다음 칸을 맞히는 그림 모델
그림 생성 모델 가운데에는 칸을 한 줄로 늘어놓고, 앞의 칸들을 보고 다음 칸의 밝기를 맞히는 모델이 있다. 판덴오르트(Aäron van den Oord)·칼크브레너(Nal Kalchbrenner)·카부크추오글루(Koray Kavukcuoglu)의 「픽셀 순환 신경망(Pixel Recurrent Neural Networks)」(ICML 2016)이 그런 모델을 다루었다. 이런 모델의 성적은 칸 하나(색 하나)를 적는 데 드는 평균 비트로 측정한다. 칸마다 밝기가 256가지이므로, 아무것도 모르고 균등하게 믿으면 칸 하나에 8비트가 든다. 신경망이 8비트를 얼마나 낮추었는지는 아래 문제 12에서 본다. 다음 칸을 잘 맞히는 만큼 잔차가 좁아지고, 칸 하나를 적는 비트가 줄어든다는 이 절의 이야기가 그대로 모델의 성적표가 된다.
문제 10. 기온 기록을 차이로 적기
어느 도시의 2주 동안 낮 기온(°C)이 11, 13, 14, 14, 12, 10, 11, 13, 15, 16, 15, 13, 12, 12였다(이 책에서 지어낸 계산 모델). 기온은 −10~40°C 사이 1°C 간격으로 적는다고 하자. (가) 날마다 기온을 그대로 적으면 하루에 몇 비트가 드는가? (나) 첫날만 그대로 적고, 그다음부터는 「어제와의 차이」를 적으면 어떤가? 차이는 −3~+3 사이라고 미리 정해 둔다.
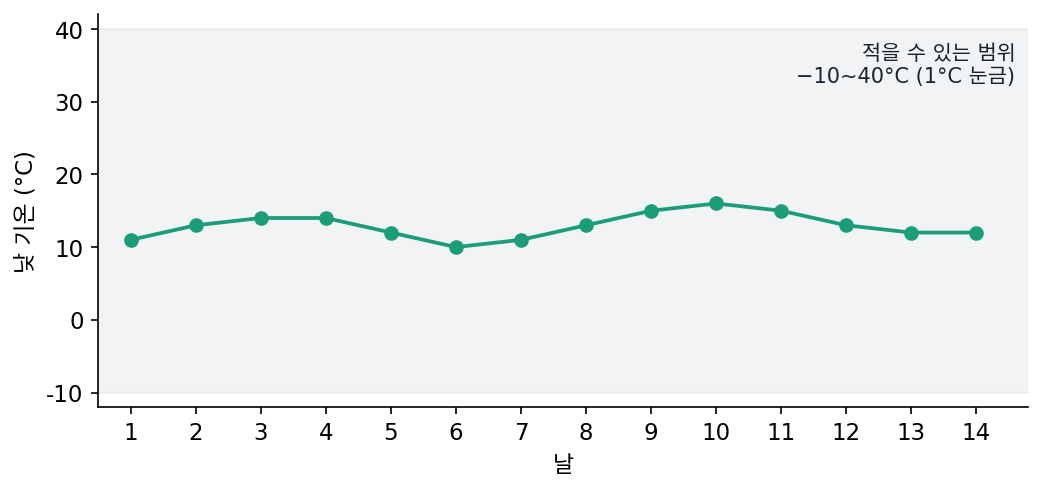
−10~40이면 51가지라서 log₂ 51 = 5.67비트요. 14일이면 79.4비트예요.
(나)에서 차이를 적는다는 건, 무엇을 예측값으로 쓴다는 걸까요?
어제 기온이요. 「오늘도 어제랑 같겠지」 하고 맞힌 다음, 틀린 만큼만 적는 거네요. 잔차를 적는 거예요.
차이를 계산하면 2, 1, 0, −2, −2, 1, 2, 2, 1, −1, −2, −1, 0이야. 전부 −3~+3 안에 들어. 7가지니까 log₂ 7 = 2.81비트고, 첫날 5.67비트에 13일 × 2.81비트를 더하면 42.2비트야. 79.4비트의 절반 정도네.
게임 서버의 델타 스냅숏은 칸마다 「바뀌었나」 1비트를 붙이고, 바뀐 칸에만 새 값을 적었어요. 기온에도 그렇게 하면 더 줄지 않을까요?
해 보자. 날마다 「어제와 같음」 1비트를 붙이고, 다른 날만 0을 뺀 여섯 가지 차이를 log₂ 6 = 2.585비트로 더 적는 거야. 그런데 13일 가운데 어제와 같은 날은 이틀뿐이라, 표시 13비트에 바뀐 11일 × 2.585비트를 더하고 첫날 5.67비트까지 넣으면 47.1비트야. 차이만 적은 42.2비트보다 길어.
게임에서는 왜 그 표시가 이득이었을까요?
칸 51개 가운데 거의 다가 스냅숏마다 그대로였으니까요. 달리는 동안에도 바뀐 건 x 좌표 하나였어요. 기온은 거의 날마다 바뀌니까 「그대로」라는 예측이 잘 안 맞고요.
표시를 붙인 쪽은 하루에 1 + (그대로가 아닌 날의 비율) × 2.585비트니까, 2.81비트보다 짧아지려면 어제와 같은 날이 열흘에 세 번은 넘어야 해. 이 2주는 13일 가운데 이틀이라 모자랐던 거고.
문제 11. 맞힌 순번으로 엔트로피의 범위 내기
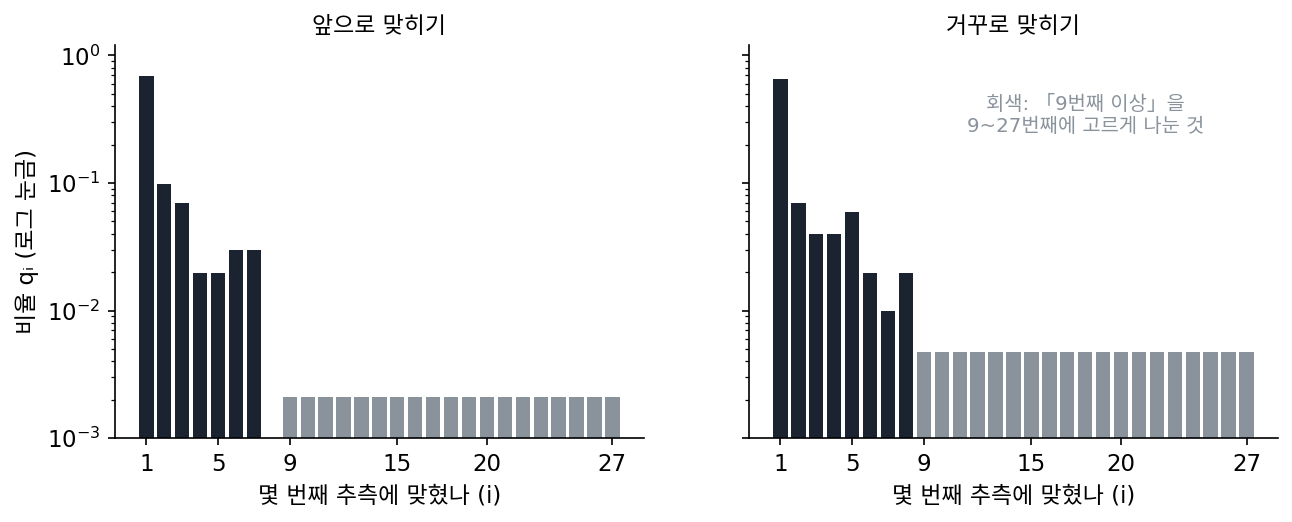
섀넌(1951)은 몇 번째 추측에 맞혔는지의 비율 q₁, q₂, …, q₂₇(글자는 26자와 띄어쓰기로 27가지)로 글자 하나의 엔트로피 H의 범위를 다음처럼 정했다. 위 경계는 −Σ(대문자 시그마, 모두 더한다는 뜻) qᵢ log₂ qᵢ, 아래 경계는 Σ i (qᵢ − qᵢ₊₁) log₂ i (q₂₈ = 0). 그의 101글자 두 대목에서 몇 번째 추측에 맞혔는지 센 글자 수는 다음과 같다. 앞으로 맞히기: 1번째 70, 2번째 10, 3번째 7, 4번째 2, 5번째 2, 6번째 3, 7번째 3, 8번째 0, 9번째 이상 4. 거꾸로 맞히기: 66, 7, 4, 4, 6, 2, 1, 2, 9. 「9번째 이상」은 9~27번째에 균등하게 나눈다고 하자(섀넌도 드문 칸을 이렇게 다듬었다). 두 대목의 위·아래 경계를 구하고, 글자 27가지를 균등하게 믿을 때와 비교하라.
계산하기 전에, 위 경계 −Σ qᵢ log₂ qᵢ가 왜 글자의 엔트로피보다 작을 수 없는지부터 생각해 볼까요?
음… 받는 쪽에도 똑같이 맞히는 사람이 있으면, 글자 대신 순번만 보내도 되지 않아요?
순번만 보낸다면 몇 비트가 들까요?
순번에 그 비율대로 코드를 주면 −Σ qᵢ log₂ qᵢ비트요. 그만큼으로 글자를 보낼 수 있으니까, 글자의 엔트로피는 그보다 클 수 없네요.
그럼 값을 내 볼게요. 앞으로 맞히기는 위 경계 1.84비트, 아래 경계 0.98비트. 거꾸로는 위 2.26비트, 아래 1.28비트예요. 27가지를 균등하게 믿으면 log₂ 27 = 4.75비트고요.
그런데 아래 경계 식은 이상하게 생겼어요. i랑 log₂ i가 왜 나와요?
작은 경우부터 넣어 봐요. 1번째와 2번째 추측에 반씩 맞혔다면 q₁ = q₂ = 0.5예요. 아래 경계는 얼마가 나오나요?
i = 1은 log₂ 1 = 0이라 빠지고, i = 2는 2 × (0.5 − 0) × log₂ 2 = 1이요. 1비트네요.
두 글자 가운데 하나를 반반으로 헷갈리는 경우랑 같은 값이네요.
그게 아래 경계의 뜻이에요. 순번 분포를 「1번째부터 i번째까지 i가지가 똑같이 그럴듯한」 경우들을 섞은 것으로 보면, 그 경우에 돌아가는 확률이 i(qᵢ − qᵢ₊₁)이고 그 경우의 엔트로피가 log₂ i예요. 섀넌은 가장 잘 맞히는 예측기라면 글자가 적어도 이만큼은 헷갈렸어야 한다는 것을 증명했어요.
그러면 앞으로 맞히기에서 글자 하나는 0.98~1.84비트예요. 균등하게 믿을 때 4.75비트였으니까, 앞을 아는 것만으로 새로 적을 것이 5분의 1~5분의 2쯤으로 준 거네요.
거꾸로도 1.28~2.26비트라 크게 다르지 않아. 대목이 101글자뿐이라 숫자는 많이 흔들리겠지만.
이웃으로 x₃을 맞힐 때와 비교하면, 맞힌 순번은 무엇에 해당할까요?
잔차요. 순번이 1번째에 몰릴수록 잔차가 좁게 몰린 거고, 적을 비트가 줄어요.
문제 12. 왼쪽 칸으로 다음 칸 맞히기
32 × 32 인물 그림 70장과 무작위 칸 그림 70장에서, 칸마다 바로 왼쪽 칸의 밝기를 예측값으로 쓴다. (가) 두 모음에서 잔차(실제 − 예측)의 크기는 평균 얼마쯤인가? 잔차가 0.05 안에 드는 칸은 몇 %인가? (나) 「픽셀 순환 신경망」(ICML 2016)의 표 5에 따르면 CIFAR-10 시험 그림에서 칸(색) 하나를 적는 데 균등하게 믿으면 8.00비트, 앞 칸들을 작은 창(합성곱)으로 관찰하는 PixelCNN은 3.14비트가 들었다. 앞 칸들을 차례로 읽으며 기억을 이어 가는 신경망(LSTM)을 대각선 두 방향으로 돌린 대각 양방향 LSTM은 3.00비트였다. 이 숫자와 (가)는 어떻게 이어지는가?
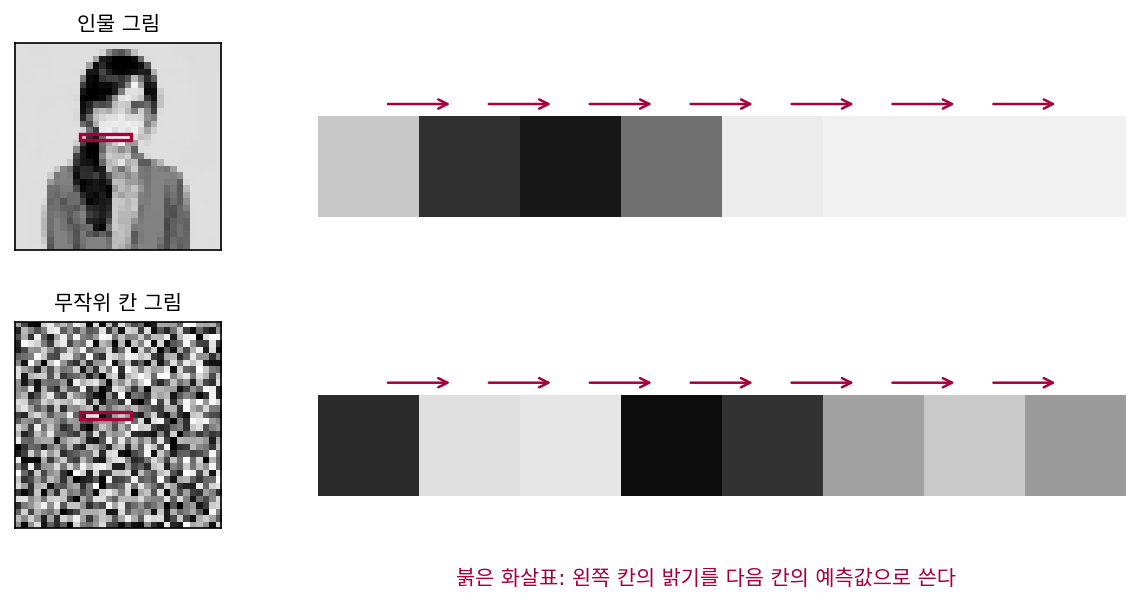
돌려 봤어요. 인물 그림은 잔차 크기 평균이 0.089, 무작위 칸 그림은 0.333이에요. 0.05 안에 드는 칸은 인물 그림 59.7%, 무작위 9.7%고요.
무작위 칸 그림의 0.333은 어디서 나온 숫자일까요?
음… 무작위 칸 그림은 칸끼리 상관이 없으니까 왼쪽 칸이 아무것도 안 알려 줘요. 0~1에서 아무 두 수를 뽑았을 때 차이의 평균이 1/3이라, 1/3이 그대로 나온 거예요. 공에서 이웃으로 x₃을 맞혔을 때처럼요.
그런데 (나)는 비트고 (가)는 밝기 차이잖아요. 둘을 어떻게 이어요?
판에서 이웃으로 x₃을 맞혔을 때, 남은 오차와 아낀 비트는 어떤 식으로 이어졌죠?
log₂(s ÷ e)였어요. 잔차의 산포가 절반이 될 때마다 1비트씩 덜 들었죠. 밝기로 측정한 잔차가 좁아지는 만큼 비트가 주니까 단위가 달라도 이어지네요.
그럼 (나)의 신경망들은 왼쪽 칸 하나보다 무엇을 더 보나요?
앞의 칸 전부요. 위 칸, 왼쪽 위 칸까지 보면 잔차가 더 좁아지겠네요. 8비트가 3.14비트, 3.00비트로 준 게 그 결과고요.
칸 하나에 새로 적을 것이 원래의 8분의 3쯤이라는 뜻이네.
이 장을 시작할 때의 물음으로 돌아가 볼까요? 그림 한 장의 숫자 가운데 정말로 따로 정해야 하는 것이 몇 개냐는 물음이었어요. 따로 정할 숫자의 개수와 방금 8비트가 3비트로 준 것은 어떻게 이어질까요?
음… CIFAR-10은 칸이 3,072개인데 내재 차원은 13~26으로 나왔어요. 따로 정할 숫자가 그만큼뿐이면, 나머지 칸은 그 몇 개에 따라 정해지는 거니까… 옆 칸들로 거의 맞힐 수 있겠네요.
거의 맞히면 맞히고 남은 잔차만 적으면 되고. 그 잔차가 좁으니까 8비트가 3비트로 준 거네.
아, 그럼 내재 차원이 낮은 것, 다음 칸을 잘 맞히는 것, 짧게 적을 수 있는 것이 다 같은 얘기네요.
그래요. 다만 같은 쪽을 가리키는 세 숫자라고 해 두죠. 서로 어떤 식으로 바뀌는지는 아직 말하지 않았어요.