VAE: 구름을 사전분포 안으로 모으기
앞 절의 구름을 인코더에 그대로 맡기면 어떻게 될까? 같은 몸통에 인코더가 μ와 σ를 내놓게 하고, 구름에서 뽑은 잠재 변수로 원래 그림을 되살리는 것만 손실로 삼아 학습해 보았다. 50번 돈 뒤 인코더가 내놓은 σ는 평균 0.0001, 중앙값은 0.0000이다. 구름이 다시 점으로 오그라들었다. 재구성만 보면 구름이 좁을수록 엉뚱한 자리를 덜 뽑으니 당연한 결과다. 지도는 반대로 퍼져 칸마다 표준편차가 10.0, 8.6이고 멀리는 60까지 나갔다. 이 모델에 N(0, I)에서 뽑은 잠재 변수 1만 개를 넣으면 71.6%가 숫자 2다. 원점 둘레가 통째로 2의 무리이기 때문이다.
구름이 제 일을 하려면 두 가지를 붙잡아 두어야 한다. 구름이 점으로 줄어들지 않게, 그리고 구름들이 한곳에 모여 있게. 둘 다 「잠재 변수가 놓이기로 정해 둔 분포」 하나와 견주면 한꺼번에 잴 수 있다.
사전분포와 사후분포: 보기 전과 본 뒤
그 「정해 둔 분포」에는 이름이 있다. 이름을 붙이기 전에 일상의 예부터 보자. 어떤 병에 걸린 사람이 100명에 1명꼴이라고 하자. 검사는 병이 있는 사람의 90%에게 양성을, 병이 없는 사람의 5%에게도 양성을 낸다. 한 사람이 양성을 받았다면 실제로 병이 있을 확률은 얼마일까? 1만 명으로 세면 환자 100명 가운데 90명, 환자가 아닌 9,900명 가운데 495명이 양성이다. 양성 585명 가운데 환자는 90명이니 15.4%다. 검사를 보기 전에는 1%였던 것이, 검사 결과를 본 뒤 15.4%로 바뀌었다.
보기 전의 1%를 사전확률, 본 뒤의 15.4%를 사후확률이라 한다. 확률이 값 하나가 아니라 여러 값에 걸친 분포이면 사전분포, 사후분포라 한다. 「사전」과 「사후」는 시간의 앞뒤가 아니라 관측(여기서는 검사 결과)을 보기 전과 본 뒤를 뜻한다.
이 장의 VAE 에서는 이렇게 대응한다. 사전분포 p(z) = N(0, I)는 그림을 하나도 보기 전에 잠재 변수가 놓이기로 정해 둔 분포다. 여기서 잠재 변수를 뽑아 디코더에 넣으면 어떤 숫자가 나올지 모른다. 아래 그림 왼쪽에서 사전분포에서 뽑은 16개를 되살리면 2, 7, 9, 0, 1, 5, 8, 6이 섞여 나온다. 사후분포 pθ(z ∣ x)는 그림 x 하나를 본 뒤, 모델이 그 그림을 그렸다면 잠재 변수가 어디였을지의 분포다. 잠재 변수가 2칸이라 격자 위에서 p(z)pθ(x ∣ z)를 칸마다 계산해 합이 1이 되게 나누면 이 분포를 직접 그릴 수 있다. 시험 그림 「3」 한 장의 사후분포는 사전분포 폭의 20분의 1쯤 되는 좁은 곳(표준편차 0.036, 0.066)에 몰려 있다. 그림을 보기 전에는 지도 어디든 될 수 있었던 잠재 변수가, 그림을 본 뒤에는 이 좁은 곳으로 좁혀진 것이다.
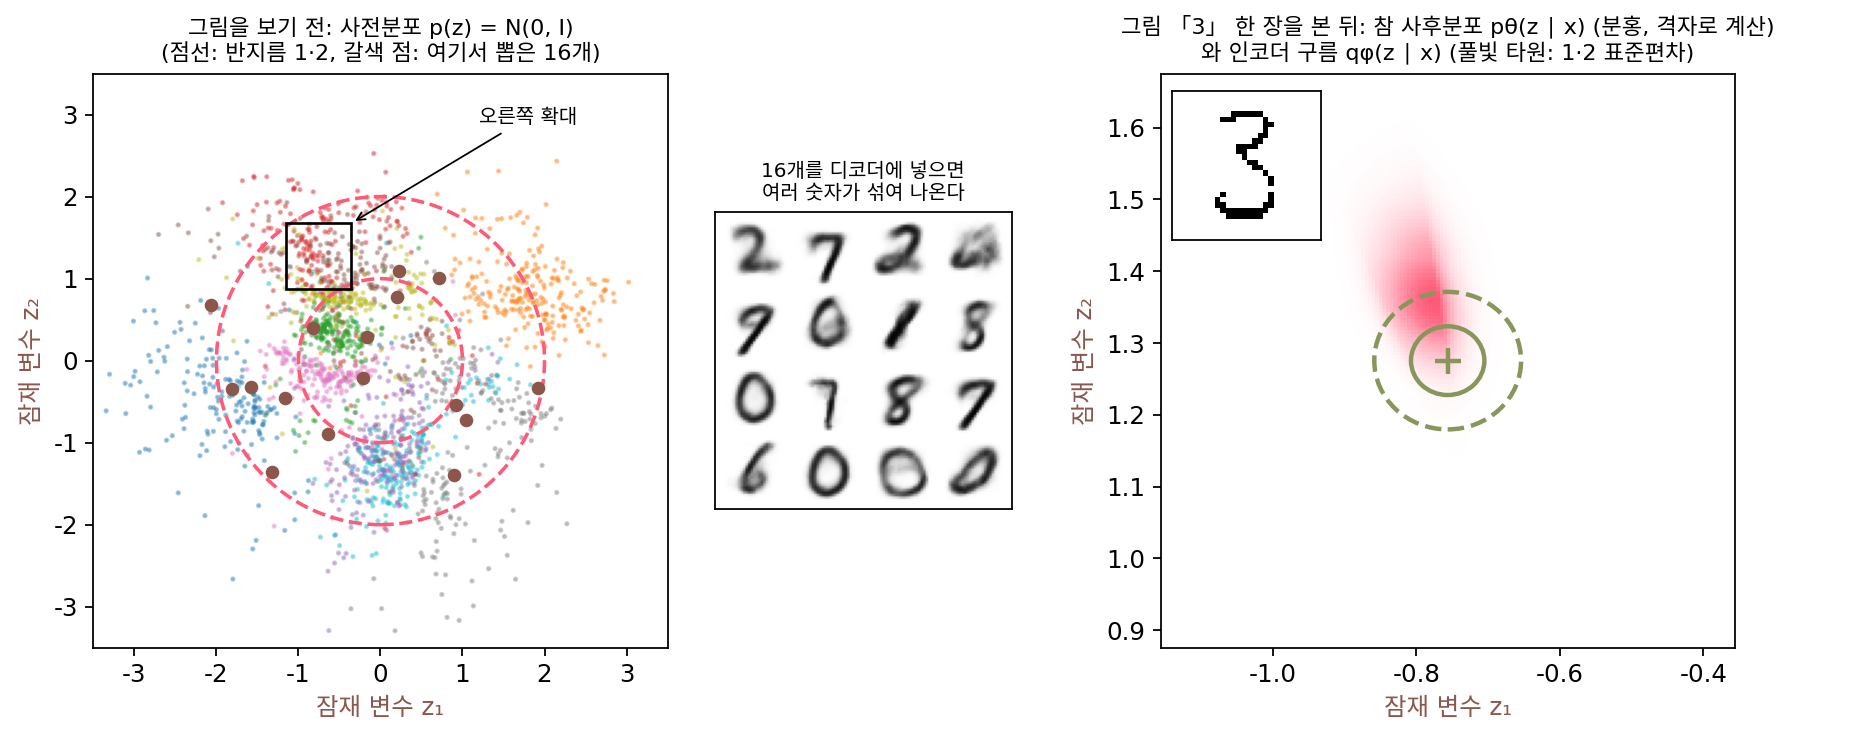
같은 그림에 앞 절의 인코더 구름 qφ(z ∣ x)도 겹쳐 그렸다. 구름은 칸마다 따로 퍼진 둥근 타원이라, 비스듬히 누운 사후분포를 꼭 맞추지는 못한다. 인코더 구름은 사후분포 그 자체가 아니라, 계산할 수 있는 모양으로 사후분포를 흉내 낸 근사다. 둘이 얼마나 어긋나는지는 뒤의 ELBO 절에서 숫자로 잰다.
역사: 두 팀이 같은 해에 같은 답에 닿았다
이 방법은 두 팀이 따로 내놓았다. 킹마(Diederik Kingma)와 웰링(Max Welling)은 2013년 12월 논문 「오토인코딩 변분 베이즈」에서 이렇게 물었다. 연속인 잠재 변수가 있고, 그 사후분포(그림을 본 뒤 잠재 변수의 분포)를 계산할 수 없고, 데이터셋이 클 때 어떻게 효율적으로 추론하고 학습할 것인가. 답은 두 가지였다. 하한(뒤의 ELBO 절)을 다시 써서 보통의 확률적 경사 하강으로 바로 올릴 수 있게 하는 것, 그리고 계산할 수 없는 사후분포를 흉내 내는 「인식 모델」을 그림마다 따로 풀지 않고 신경망 하나로 함께 학습하는 것. 한 달 뒤인 2014년 1월 레젠데(Danilo Jimenez Rezende), 모하메드(Shakir Mohamed), 비어스트라(Daan Wierstra)도 근사 사후분포를 나타내는 인식 모델을 「확률적인 인코더」로 두는 같은 구조를 내놓았다. 앞의 인식 모델이 곧 인코더다.
조각으로 덮고, 한데 모으기
디코더 쪽에서 보면 지금까지의 시도는 지도를 무엇으로 채우느냐의 차이다. 오토인코더는 학습 그림마다 점 하나씩으로 지도를 채웠다. 점은 넓이가 없으니 점과 점 사이는 디코더가 한 번도 배운 적 없는 자리로 남는다. 구름을 주면 그림마다 작은 조각면 하나씩으로 채운다. 디코더는 조각면 어디를 받아도 그 그림을 그리도록 배우니, 조각면들이 겹쳐 지도를 덮는다. 그런데 조각면을 학습에 그냥 맡기면, 위에서 본 것처럼 조각면이 점으로 오그라들고 서로 멀리 흩어진다. 그래서 VAE 는 조각면마다 사전분포에서 얼마나 벗어났는지에 벌점을 매겨 조각면들을 N(0, I) 안으로 끌어 모은다. 아래 그림은 세 모델의 지도와, 같은 N(0, I) 좌표 여덟 개를 세 디코더에 넣은 그림이다.
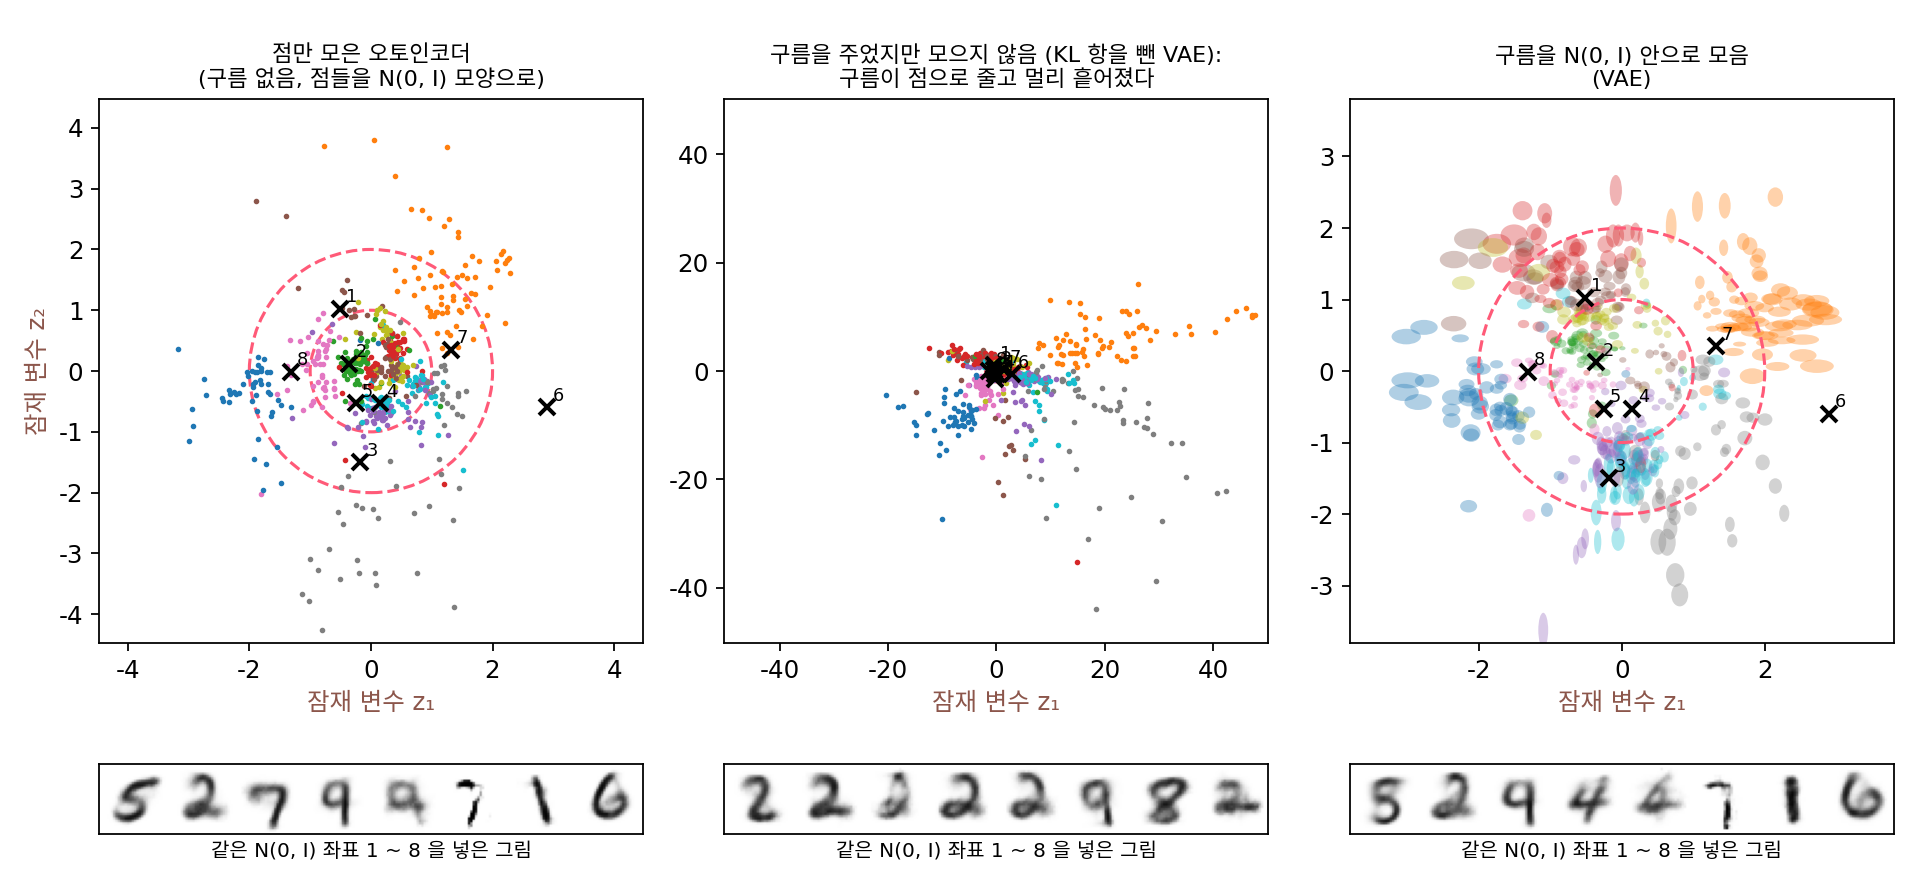
학습은 두 가지를 함께 원한다. 첫째, 구름에서 뽑은 잠재 변수로 원래 그림이 잘 되살아나야 한다. 이것을 「되살린 분포가 원래 그림에 주는 로그 확률」 log pθ(x ∣ z)로 잰다(재구성 항). 둘째, 구름이 사전분포 N(0, I)에서 너무 멀어지면 안 된다. 두 분포가 얼마나 다른지 재는 잣대가 필요하다.
두 분포의 거리: KL 발산
두 분포 q와 p가 얼마나 다른지를 이렇게 잰다. q에서 뽑은 값마다 log q − log p를 계산해 평균 낸다. 두 분포가 같으면 0이고, 다를수록 커지며, 음수가 되지 않는다. 이 양을 쿨백(Solomon Kullback)과 라이블러(Richard Leibler)의 이름을 따서 KL 발산이라 부르고 DKL로 쓴다. KL은 두 사람 이름의 머리글자이지 K와 L의 곱이 아니며, 「케이엘」이라고 읽는다. 「발산」은 벡터장의 발산(∇·)과 이름만 같다.
둘째 식은 정규분포끼리의 KL을 계산해 둔 것이다(잠재 변수가 여러 칸이면 칸마다 더한다). 예를 들어 구름이 μ = 1.5, σ = 0.2이면 ½(2.25 + 0.04 − 1 − log 0.04) = 2.25다. 중심이 원점에서 멀수록, 구름이 1보다 넓거나 좁을수록 커진다. 평균에 달린 항 ½μ²은 두 분포의 평균 차이의 제곱을 뒤쪽 분포 분산(여기서는 1)의 두 배로 나눈 것이다. 두 정규분포의 분산이 미리 정해져 있으면, 뒤쪽 분산이 1이 아니어도 KL에서 평균에 달린 부분은 이 꼴, 곧 (평균 차이)²을 뒤쪽 분산의 두 배로 나눈 항 하나뿐이다.
이제 손실은 재구성 항에서 KL을 뺀 값에 마이너스를 붙인 것이다. 재구성 항의 평균은 잠재 변수를 구름에서 하나 뽑아 어림한다.
이렇게 인코더가 잠재 변수의 분포를 내놓고, 그 분포를 사전분포 쪽으로 당기면서 디코더와 함께 학습하는 오토인코더를 VAE (잠재 변수를 분포로 다루는 오토인코더 / variational autoencoder)라 한다. 「변분」이라는 말이 어디서 왔는지, 이 손실이 실제로 무엇을 올리는지는 뒤의 ELBO 절에서 밝힌다.
지도가 원 안으로 들어온다
오토인코더와 같은 몸통(784-128-64, 잠재 변수 2칸)으로 VAE를 학습했다. 시험 그림 만 장에서 재구성 항은 평균 −130.75, KL은 6.81이다(단위 nat. 자연로그로 잰 정보의 양). 인코더 구름의 중심은 원점에서 평균 1.34만큼 떨어져 있고, 구름의 표준편차는 평균 0.039다. 오토인코더의 잠재 변수가 원점에서 평균 5.1만큼, 멀리는 25까지 흩어졌던 것과 견주면 잠재 변수 전체가 반지름 2 남짓한 원 안으로 들어왔다.
이제 새 그림을 뽑을 곳이 정해졌다. N(0, I)에서 잠재 변수를 1만 개 뽑아 디코더에 넣으면, 분류기가 90% 넘게 확신하는 그림이 74.9%이고 분류된 숫자는 0부터 9까지 6.5% ~ 11.9%로 고르게 나온다. 데이터를 보지 않고 새 손글씨 숫자를 만들어 낸다. 뽑기 성적만 보면 점을 모은 오토인코더(78.9%)와 비슷하고, 둘의 차이는 앞에서 본 대로 학습한 자리의 이웃에 있다.
ML에서: 생성 모델의 세 부품
VAE에서 그림을 뽑는 길은 둘이다. 하나는 p(z)에서 잠재 변수를 뽑고, 디코더 pθ(x ∣ z)로 그림을 얻는 길이다. 이것이 생성이다. 다른 하나는 실제 그림을 인코더 qφ(z ∣ x)로 줄였다가 디코더로 되살리는 길이고, 학습은 이 길로 한다. 앞으로 이 책의 생성 모델은 모두 이 세 부품, 곧 뽑기 쉬운 출발 분포, 그림 쪽으로 가는 길, 그 길을 배우게 해 주는 거꾸로 가는 길의 변주로 읽을 수 있다.
문제 10. 점심 메뉴 짐작
우리 과 학생들이 학생식당에서 고르는 메뉴는 실제로 짜장 50%, 짬뽕 25%, 볶음밥 25%다. 식당 아주머니는 셋이 똑같이 1/3씩이라고 짐작하고 재료를 준비한다. (가) 실제 분포 P에서 뽑아 잰 KL(P ‖ 짐작)을 nat 단위로 구하라. (나) KL(짐작 ‖ P)는 얼마인가? 둘이 같은가?

식에 넣으면 돼요. 0.5 log(0.5 ÷ 1/3) + 0.25 log(0.25 ÷ 1/3) × 2 = 0.5 × 0.405 + 0.5 × (−0.288) = 0.0589예요.

0.0589가 무슨 뜻일까요?

학생 한 명이 메뉴를 고를 때마다, 실제 확률로 봤을 때의 놀라움과 아주머니 짐작으로 봤을 때의 놀라움의 차이를 평균 낸 거예요. 아주머니는 짜장을 실제보다 덜 기대하니까 짜장이 나올 때마다 조금 더 놀라고, 짬뽕이나 볶음밥이 나올 때는 덜 놀라요. 평균하면 0.0589만큼 더 놀라요.

(나)는 자리만 바꾸면 되니까 똑같이 0.0589겠죠… 아니네요. 1/3 log(1/3 ÷ 0.5) + 2/3 log(1/3 ÷ 0.25) = 0.0566이에요. 다르네요.

왜 다를까요? 평균을 누구의 분포로 내는지 보세요.
(가)는 실제 손님이 오는 비율로 평균 내고, (나)는 아주머니가 상상한 손님 비율로 평균 내요. 어느 쪽 세상에서 놀라움을 세느냐가 다르니까 값도 달라요. 그래서 「거리」가 아니라 「발산」이라고 하는구나.
조별 과제에서 내가 느끼는 「쟤가 덜 했다」와 쟤가 느끼는 「내가 덜 했다」가 다른 거랑 같네요.
문제 11. 검사를 두 번 받으면
어떤 병의 유병률이 2%이고, 검사는 환자의 95%에게, 환자가 아닌 사람의 10%에게 양성을 낸다. (가) 한 번 양성이 나온 사람이 환자일 확률은? (나) 같은 검사를 다시 받아 또 양성이 나왔다(두 검사의 결과는 병이 있고 없음이 정해지면 서로 상관없다고 하자). 이제 환자일 확률은? (다) 이 장의 VAE 에서 사전분포를 N(0, I)로 정해 두었다. 학습이 끝난 뒤 시험 그림 1만 장마다 인코더 구름에서 잠재 변수를 하나씩 뽑아 보니, 원점에서 1 안쪽이 39.4%, 2 안쪽이 81.4%였다(N(0, I)라면 39.3%, 86.5%). 잠재 변수는 사전분포를 따르는가? (라) 위 그림 오른쪽에서 인코더 구름은 사후분포와 같은가?
(가)는 본문처럼 세면 돼요. 1만 명 가운데 환자 200명 중 190명, 아닌 9,800명 중 980명이 양성이니 190 ÷ 1,170 = 16.2%예요.
(나)는 처음부터 다시 세야 하나? 두 번 다 양성인 사람은 환자 중 0.95², 아닌 사람 중 0.1²이니까… 0.02 × 0.9025 ÷ (0.02 × 0.9025 + 0.98 × 0.01) = 64.8%야.

첫 검사 뒤의 16.2%를 출발점으로 두고 한 번만 더 세어 봐요.

0.1624 × 0.95 ÷ (0.1624 × 0.95 + 0.8376 × 0.1) = 64.8%. 똑같네요! 첫 검사의 사후확률이 둘째 검사의 사전확률이 됐어요.
그러니까 「사후」는 시간상 나중이라는 뜻이 아니구나. 어떤 관측을 기준으로 그걸 보기 전이냐 본 뒤냐야. 같은 16.2%가 첫 검사에는 사후, 둘째 검사에는 사전이고.
(다)는 쉬워요. 사전분포가 N(0, I)니까 잠재 변수는 N(0, I)죠. 39.4%면 거의 똑같고요.
2 안쪽도 봐요. 그리고 그 사전분포는 어디서 왔어요?
81.4% 대 86.5%… 5%쯤 모자라요. 바깥으로 삐져나간 그림이 그만큼 있는 거네요. 사전분포는… 데이터에서 구한 게 아니라 우리가 N(0, I)로 정해 둔 거예요. 병원의 2%는 실제로 세어 본 숫자였는데.

VAE 의 사전분포는 「여기에 모여라」라는 약속이고, KL 벌점이 구름들을 그쪽으로 당길 뿐이야. 당긴다고 꼭 그 모양이 되는 건 아니지. 재구성과 줄다리기한 결과가 39.4%와 81.4%인 거고.
(라)는요?

인코더 구름은 축에 나란한 둥근 타원인데 사후분포는 비스듬히 누워 있고 가운데도 위로 비켜 있어요. 그림을 보고 구한 「참」 사후분포를 인코더가 계산할 수 있는 모양으로 흉내 낸 거지, 같은 게 아니에요.

그래요. 사전분포는 우리가 정한 약속, 사후분포는 모델이 정해지면 따라 정해지는 참값, 인코더 구름은 그 참값의 근사예요. 셋을 섞어 부르면 뒤에서 ELBO 의 틈을 읽을 때 길을 잃어요.
일기예보 「내일 비 올 확률 30%」가 아침 하늘을 보고 70%로 바뀌는 거네요. 아침에 본 하늘이 관측이고요.
문제 12. 구름을 점으로 줄이면
잠재 변수 한 칸에서 인코더 구름 N(μ, σ²)와 사전분포 N(0, 1)의 KL을 다음 경우에 구하라: (μ, σ) = (0, 1), (2, 1), (0, 0.1), (0, 0.01), (0, 3). (가) 인코더가 구름을 점처럼 좁히려 하면 KL은 어떻게 되는가? (나) 이 절 첫머리의 KL 없는 모델은 구름이 σ 평균 0.0001로 줄고 지도가 표준편차 10 남짓으로 퍼졌으며, N(0, I) 좌표의 71.6%를 숫자 2로 그렸다. KL의 두 부분, ½μ²와 ½(σ² − 1 − log σ²)는 각각 이 가운데 무엇을 막는가? (다) 그 결과 VAE 의 디코더에 N(0, I)에서 아무 점이나 넣어도 숫자가 나오는 까닭을 말하라.
½(μ² + σ² − 1 − log σ²)에 넣으면 (0, 1)은 0, (2, 1)은 2, (0, 0.1)은 1.81, (0, 0.01)은 4.11, (0, 3)은 2.90이에요.
σ가 0.1에서 0.01로 줄 때 무엇이 KL을 키웠어요?
−log σ² 항이요. σ가 열 배 줄 때마다 log 100 ÷ 2 = 2.30씩 늘어요. σ가 0이면 끝없이 커지고요. 인코더가 구름을 점으로 만들면 벌점이 무한대예요.
그런데 사실 점이 제일 좋은 거 아니에요? 재구성만 보면 점이 가장 정확하잖아요. KL 벌점만 아니면 점으로 줄이는 게 맞는 것 같은데요.
KL 없는 모델이 실제로 그렇게 했죠. 그 모델에 N(0, I) 좌표를 넣으면요?

71.6%가 2예요. 점으로 줄었으니 다시 오토인코더처럼 점 사이를 아무도 안 배웠고, 지도까지 표준편차 10으로 퍼져서 N(0, I)의 좁은 원 안은 2의 무리 하나가 차지해요. 점이 재구성엔 좋아도 뽑기엔 쓸모가 없네요.
그럼 (나)는 이렇게 나뉘어. ½σ² − ½log σ² − ½ 부분은 σ = 1에서 가장 작고 σ가 0으로 가면 끝없이 커지니까 구름이 점으로 줄어드는 걸 막아. ½μ² 부분은 구름 가운데를 원점 쪽으로 당기니까 지도가 멀리 퍼지는 걸 막고.
그런데 ½μ²만 있으면 원점으로 당기기만 한 오토인코더처럼 지도를 통째로 오그라뜨려서 벌점을 피할 수 있었잖아. 이번엔 구름의 σ가 함께 있으니까 지도를 오그라뜨리면 구름끼리 겹쳐 재구성이 나빠지고, 구름까지 같이 줄이면 −log σ²가 커져. 두 부분이 같이 있어서 지도의 눈금이 정해지는구나.
그러면 (다)는요?
구름이 넓이를 지니니까 조각면들이 겹쳐서 빈 곳을 메우고, KL이 그 조각면들을 N(0, I) 안으로 한데 모아. N(0, I)에서 아무 점을 뽑아도 어느 그림의 조각면 위에 떨어지고, 디코더는 거기서 그 그림을 그리도록 배웠어. 그래서 디코더만 떼어 내 아무 점이나 넣어도 숫자가 나오는 거야. 학습된 VAE 의 구름 표준편차가 평균 0.039라 조각 하나는 작지만, 학습 그림이 6만 장이라 겹겹이 덮어.
동아리 방 청소 구역을 「각자 자기 책상 한 점」으로 정하면 바닥은 아무도 안 닦는데, 「책상 둘레 한 뼘씩」으로 정하고 방 안에서만 고르라고 하면 바닥 전체가 닦이는 거랑 같네요.
문제 13. KL 벌점을 0으로 만든 인코더
VAE의 인코더가 모든 그림에 똑같이 μ = 0, σ = 1을 내놓아 KL 항을 0으로 만들었다고 하자. (가) 잠재 변수 z는 그림에 대해 무엇을 알려 주는가? (나) 그때 재구성 항을 가장 크게 하는 디코더는 무엇을 내놓는가? (다) 칸마다 학습 그림의 잉크 비율을 내놓는 디코더로 시험 그림을 재면 재구성 항은 평균 −205.86 nat이다. 학습된 VAE(재구성 −130.75, KL 6.81)와 견주면 VAE는 KL에 얼마를 치르고 재구성에서 얼마를 얻었는가?
KL이 0이면 손실이 줄어드니까 좋은 거 아니에요?
인코더가 모든 그림에 같은 구름을 내놓으면, 디코더는 잠재 변수를 받고 무엇을 알 수 있어요?
아무것도요. 어떤 그림에서 왔든 같은 N(0, 1)에서 뽑은 잠재 변수니까요. 차라리 무시하는 게 나아요.
그러면 디코더는 모든 그림에 같은 분포를 내놓아야 하고, 칸마다 로그 확률을 가장 크게 하는 건 그 칸이 잉크인 비율이야. 칸마다 학습 그림들의 잉크 비율을 내놓는 거지. 곧 평균 그림.
라벨 넣은 MLP의 평균 그림이 또 나왔네요. 이번에는 라벨도 없이 전체 평균이요.
(다)를 계산해 봐요.
VAE는 KL로 6.81을 치르고 재구성에서 −205.86에서 −130.75로 75.11을 얻었어요. 합치면 68.30 이득이에요.
KL은 잠재 변수가 그림에 대해 실어 나르는 정보에 매긴 값이구나. 6.81 nat만큼 그림 이야기를 잠재 변수에 실었더니 되살리기가 75 nat 좋아진 거네. KL을 0으로 만들면 아무것도 안 실은 거고.
그래서 KL 항을 무조건 줄이는 게 목표가 아니에요. 실어 나른 정보만큼의 값어치가 있는지를 재구성 항과 맞바꾸는 거예요.
정보 이론 수업에서 통신로에 비트를 더 실으려면 그만큼 대가를 치러야 했던 거랑 같네요.