13장 — 가이던스: 조건 쪽으로 더 세게
이 장의 물음
그림 생성 도구 ComfyUI에서 그림을 만드는 마디(KSampler)를 열면, 걸음 수와 샘플러 말고도 cfg라는 칸이 있다. 기본값은 8.0이고, 마우스를 올리면 「이 값은 창의성과 프롬프트를 따르는 정도 사이의 균형을 잡는다. 값이 크면 프롬프트에 더 가까운 그림이 나오지만, 너무 크면 그림의 질이 나빠진다」는 설명이 뜬다. 같은 마디에는 프롬프트를 받는 입력(positive) 옆에 입력이 하나 더 있다. 이름은 negative다.
조건을 받는 신경망은 이미 지었다. 글 토큰 줄을 크로스 어텐션이나 합동 어텐션으로 읽으며, 글이 붙은 그림들로 배운다. 그렇게 배운 신경망은 조건이 붙은 그림들의 분포를 배웠을 텐데, 왜 그 위에 8배를 곱하는 손잡이가 또 필요할까? 코드(comfy/samplers.py)를 열어 보면 cfg가 1이 아닐 때 ComfyUI는 걸음마다 신경망을 두 번 부른다. 무엇을 두 번 읽는 것일까? 이 장은 다음 물음에 차례로 답한다.
- 조건을 넣고 배운 신경망으로 걸으면 조건에 꼭 맞는 그림만 나올까?
- 조건 쪽으로 더 세게 끌고 싶다면 바늘에 무엇을 더해야 할까?
- 그 「무엇」을 따로 배우지 않고 같은 신경망에서 얻을 수는 없을까?
- negative 칸에 글을 넣으면 그 글은 계산의 어디에 들어갈까?
- 배율을 올리면 무엇을 얻고 무엇을 잃을까?
조건부 스코어: 조건을 넣고 배운 바늘
글처럼 복잡한 조건을 따지기 전에, 조건을 가장 단순한 꼴로 줄여 보자. 조건 없이 잡음 섞인 그림과 잡음 수준만 받은 신경망은 데이터 전체의 분포에서 아무 그림이나 뽑는다. 낮 사진만 원한다면, 학습 데이터에 「낮」「밤」 같은 라벨을 붙여 두고 신경망에 라벨도 함께 넣어 배우면 된다. 그러면 신경망이 배우는 바늘은 낮 그림들만 모은 분포의 바늘이 된다. 이 바늘을 따라 걸으면 낮 그림만 나올까?
역사: 라벨 표 한 장을 시간 벡터에 더하기
라벨을 신경망에 넣는 길은 잡음 수준을 넣는 길과 같다. 다리왈(Prafulla Dhariwal)과 니콜(Alex Nichol)은 2021년 논문에서 ImageNet(1,000가지 범주로 나눈 사진 데이터셋)의 범주마다 벡터를 하나씩 두는 표를 만들고, 그림의 범주에 해당하는 벡터를 시간 벡터와 함께 잔차 블록마다 넣었다(정규화한 특징에 곱하고 더할 수를 이 벡터들이 정한다). ComfyUI의 U-Net 코드(comfy/ldm/modules/diffusionmodules/openaimodel.py)에도 같은 자리가 남아 있다. 범주 수만큼 줄이 있는 표(label_emb)를 두고, 시간 벡터에 그 줄을 더한다(emb = emb + self.label_emb(y)). 그 뒤로는 시간 벡터가 블록마다 들어가는 길을 그대로 탄다.
효과는 컸다. 같은 구조를 가로세로 256픽셀 ImageNet에서 같은 횟수만큼 배웠을 때, 라벨 없이 배운 모델의 FID(만든 그림 묶음과 실제 사진 묶음의 특징 분포가 얼마나 다른지 재는 값, 낮을수록 좋다)는 26.21, 라벨을 넣어 배운 모델은 10.94였다. 그런데 이 논문의 가장 좋은 숫자는 라벨을 넣어 배운 모델에서 나오지 않았다. 그들은 라벨을 넣어 배운 모델에 무언가를 하나 더 덧대어 FID를 4.59까지 낮췄다. 조건을 넣고 배운 것만으로는 모자랐다는 뜻이다. 무엇이 모자랐을까?
낮 그림과 밤 그림
답을 숫자로 보려면, 조건을 정확히 따르는 바늘을 식으로 아는 장난감이 필요하다. 그림을 밝기 숫자 하나 x로 줄이자. 밤 그림은 밝기 −0.5 둘레에, 낮 그림은 +0.5 둘레에 표준편차 0.3으로 흩어져 있고, 둘이 반반이다. 두 조건이 겹치는 가장 작은 장난감이다. 해 질 녘처럼 밝기가 0 근처인 그림은 낮이라 해도, 밤이라 해도 이상하지 않다.
조건이 붙은 분포와 조건 없는 분포는 베이즈 정리로 이어진다. 잡음 섞인 그림에서도 그렇다. pt(xt ∣ y) = pt(y ∣ xt) pt(xt) / p(y)에 로그를 씌우고 자리 xt로 미분하면, xt와 상관없는 p(y)는 사라진다.
조건이 붙은 바늘은 모든 그림의 바늘에 「이 그림이 조건 쪽일 확률이 커지는 방향」을 더한 것이다. 장난감에서는 세 바늘을 모두 식으로 안다.
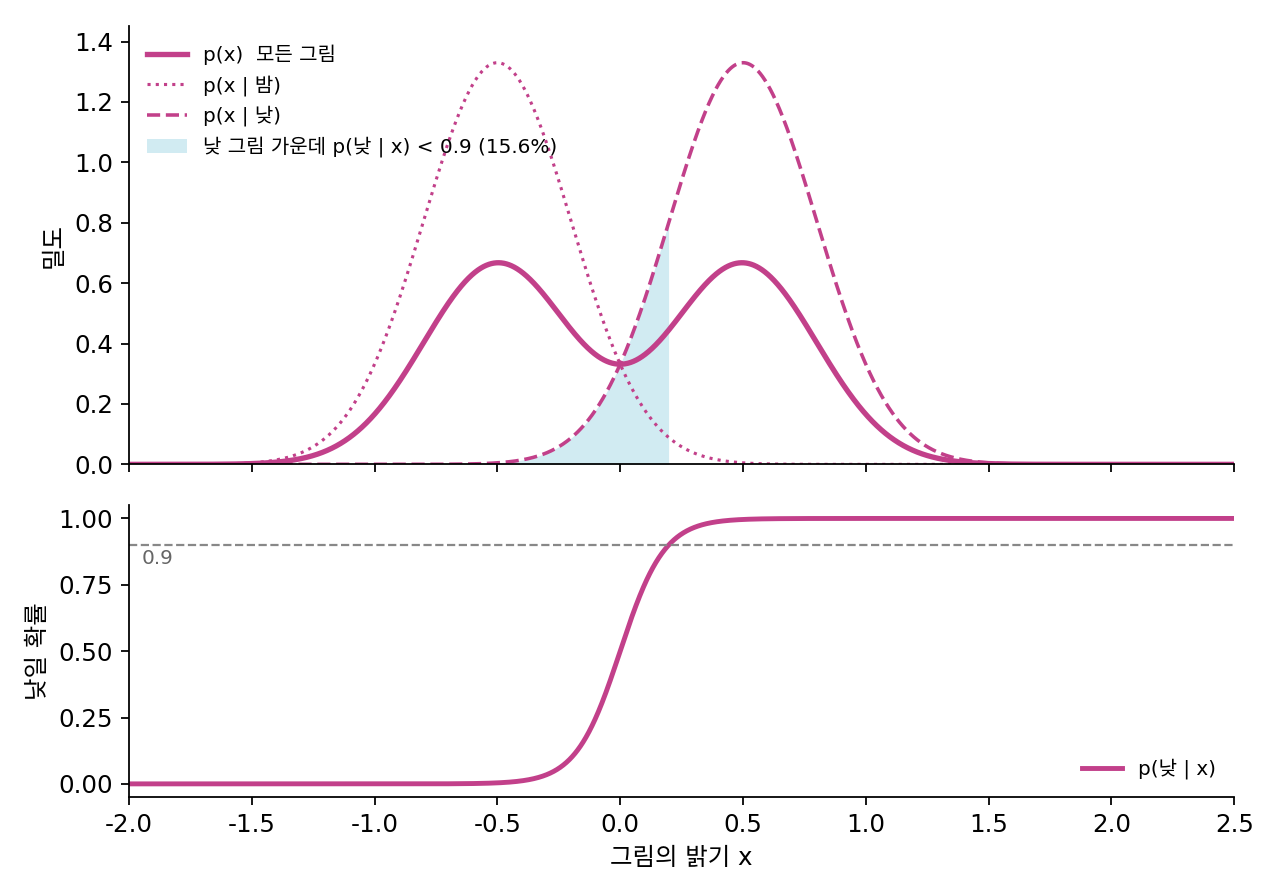
조건이 붙은 바늘을 따라 샘플러를 다룰 때 본 오일러 걸음으로 30걸음 걸어 낮 그림 2만 장을 뽑으면, 밝기의 평균이 0.492, 표준편차가 0.280으로 낮 그림의 분포(0.5, 0.3)를 잘 따른다. 그런데 뽑힌 그림 가운데 14.5%는 그림만 보고 낮일 확률을 매기면 0.9가 안 된다. 낮 그림 데이터 자체에서 그 몫이 15.6%이니, 바늘은 조건을 정확히 따랐다. 조건을 정확히 따른다는 것은 조건이 붙은 그림들의 분포를 그대로 재현한다는 뜻이고, 그 분포에는 해 질 녘처럼 애매한 그림이 원래 들어 있다. 이렇게 조건이 붙은 그림들의 분포의 로그 밀도 기울기 s(xt ∣ y) = ∇ log pt(xt ∣ y)를 조건부 스코어 (조건이 붙은 그림들만 모은 분포의 바늘 / conditional score)라 한다. 신경망으로는 잡음 예측 εθ(xt, t, y)처럼 조건을 하나 더 받는 꼴로 배운다.
ML에서: 조건이 들어가는 자리
라벨처럼 가짓수가 정해진 조건은 위의 표 한 장으로 넣는다. Stable Diffusion XL은 같은 자리(label_emb)에 글 인코더가 문장 하나를 줄인 벡터와 그림 크기 정보를 펴서 넣는다(ComfyUI 설정 adm_in_channels 2816). 글은 가짓수가 정해져 있지 않으므로, 문장을 토큰마다의 벡터 줄로 바꿔 크로스 어텐션이나 합동 어텐션으로 그림의 칸들이 골라 읽게 하는 길이 하나 더 있다. 문장을 어떤 벡터로 바꾸는지는 이 장이 다루지 않는다. 이 장은 조건이 무엇이든, 조건을 받은 신경망의 예측을 어떻게 쓰느냐만 본다.
문제 1. 아주 밝은 사진 한 장
사진 앨범에 낮 사진 600장, 밤 사진 400장이 있다. 낮 사진의 30%, 밤 사진의 5%가 「아주 밝은」 사진이다. (가) 아주 밝은 사진 한 장을 골랐을 때 그 사진이 낮 사진일 확률은? (나) 앨범이 낮 사진 100장, 밤 사진 900장이라면? (다) 두 앨범에서 「낮 사진 가운데 아주 밝은 사진의 비율」은 같은데 (가)와 (나)의 답이 다른 까닭은?

낮 사진의 30%가 아주 밝다고 했으니까 30%요.

그 30%는 어느 사진들 가운데의 비율이죠? 지금 손에 든 건 어느 사진들 가운데 하나고요?

아, 30%는 낮 사진 가운데 밝은 사진이고, 저는 밝은 사진 가운데 하나를 들고 있어요. 방향이 반대예요. 세어 보면 밝은 낮 사진이 180장, 밝은 밤 사진이 20장이니까 180/200 = 0.9예요.

(나)는 밝은 낮 사진이 30장, 밝은 밤 사진이 45장이라 30/75 = 0.4야. 같은 「30%와 5%」인데 밤 사진이 많으면 밝은 사진도 밤에서 많이 나오니까.

(다)를 식으로 말해 볼까요?

p(낮 ∣ 밝음) = p(밝음 ∣ 낮) p(낮) / p(밝음)이에요. 앞의 p(밝음 ∣ 낮)은 두 앨범이 같고, 다른 건 p(낮)과 p(밝음)이에요. 로그를 씌우면 셋이 더하기 빼기로 갈라지네요.

조교님이 「이 반 보고서는 대부분 A였다」고 한 거랑 「A 보고서는 대부분 이 반 거였다」는 다른 말이었구나. 반 인원이 다르면 완전히 다르겠어요.
문제 2. 바늘 셋을 더하기
낮·밤 장난감(밤 −0.5, 낮 +0.5, 표준편차 0.3, 반반)에 잡음 σ = 0.5를 섞었다. 잡음 섞인 낮 그림의 분포는 N(0.5, 0.3² + 0.5²), 밤 그림은 N(−0.5, 0.3² + 0.5²)이다. 자리 xt = 0.2에서 (가) 낮 그림들의 바늘 s(xt ∣ 낮) (나) 모든 그림의 바늘 s(xt) (다) ∇ log pt(낮 ∣ xt)를 구하고, (가) = (나) + (다)인지 확인하라. (라) pt(낮 ∣ xt)는 xt의 어떤 함수인가?
분산이 0.09 + 0.25 = 0.34예요. (가)는 가우시안 하나의 바늘이라 −(0.2 − 0.5)/0.34 = 0.882예요. (나)는 두 가우시안을 반반 섞은 거니까 바늘도 반반 섞으면… (0.882 + (−(0.2 + 0.5)/0.34))/2 = (0.882 − 2.059)/2 = −0.588이요.

바늘을 반반 섞어도 돼? 반반인 건 처음 비중이지, 0.2에 선 사람이 낮에서 왔을 확률은 반반이 아닐 텐데.
0.2에 선 사람이 낮에서 왔을 확률부터 구해 볼까요?

두 밀도의 비로 구하면… 0.643이에요. 낮에서 왔을 가능성이 더 커요. 그 비중으로 섞으면 0.643 × 0.882 + 0.357 × (−2.059) = −0.168이에요.
(다)는 그 0.643이 곧 pt(낮 ∣ xt)야. 두 밀도의 비를 정리하면 지수에 xt의 일차식만 남아서, 1/(1 + e^(−2.941 xt))이 돼. 2.941은 2 × 0.5 / 0.34고.
(라)는 시그모이드네요. 시그모이드의 로그를 미분하면 2.941 × (1 − 0.643) = 1.050이에요. (나) + (다) = −0.168 + 1.050 = 0.882. (가)와 같아요.
모든 그림의 바늘은 이 자리에서 음수였어요. 낮 바늘은 양수고요. 무엇이 방향을 뒤집었죠?
분류기 쪽 바늘이요. 모든 그림의 바늘은 이 자리에서 두 봉우리 사이 골짜기 쪽, 밤 봉우리 쪽으로 기울어 있는데, 분류기가 「낮일 확률이 커지는 쪽」으로 1.05만큼 당겨서 낮 봉우리 쪽으로 돌려놓아요. 그리고 2.941은 잡음 분산 0.34로 나눈 값이니까, 잡음이 짙을수록 분류기의 기울기는 완만해지겠네요.

전체 학생 평균은 C인데 우리 조 평균이 B면, 우리 조 점수 = 전체 경향 + 「우리 조라서 더해지는 몫」인 거랑 같네요.
문제 3. 뽑고 나서 버리기
낮 그림만 쓰는 데이터셋을 만들려고, 조건부 스코어로 낮 그림을 뽑은 뒤 분류기 p(낮 ∣ x)가 0.99 이상인 그림만 남기기로 했다(장난감의 정확한 분류기를 쓴다). (가) 뽑은 그림의 몇 %를 버리게 되는가? (나) 1,000장을 남기려면 평균 몇 장을 뽑아야 하고, 한 장에 30걸음이면 신경망을 몇 번 부르는가? (다) 버리지 않고 처음부터 덜 애매한 그림을 뽑는 길은 없을까?
본문에서 0.9보다 낮은 게 15.6%였으니까 15.6%쯤 버리겠네요.
문턱이 0.9에서 0.99로 바뀌었어요. 문턱을 높이면 버리는 몫은 어느 쪽으로 움직일까요?
늘어나죠. 돌려 보니 38.6%예요. 두 배가 넘어요. 그럼 1,000장을 남기려면 1,000/(1 − 0.386) = 1,627장을 뽑아야 하고, 신경망은 1,627 × 30 = 48,818번 불러요.
남긴 그림은 다 밝기가 큰 쪽이겠네. 그러면 낮 그림의 분포에서 왼쪽 꼬리를 잘라 낸 분포가 되는 거지?
그래요. 그럼 (다)예요. 잘라 내는 대신, 처음부터 그 꼬리 쪽으로 덜 가게 걸을 수는 없을까요? 바늘을 두 부분으로 나눴던 식을 떠올려 봐요.
조건부 바늘은 모든 그림의 바늘에 분류기의 바늘을 더한 거였어요. 애매한 그림을 덜 뽑고 싶으면, 분류기의 바늘을 한 배가 아니라 더 세게 더하면 되지 않을까요?
과제를 다 받아 놓고 기준 미달을 반려하는 대신, 처음부터 채점 기준을 더 세게 알려 주는 거네요. 조교님 품이 훨씬 덜 들겠어요.