분류기 가이던스: 분류기의 바늘을 w배로 더한다
조건부 바늘을 따라 걸으면 조건이 붙은 그림들의 분포가 그대로 나오고, 그 분포에는 애매한 그림이 섞여 있다. 뽑은 뒤 버리면 신경망 호출을 그만큼 버린다. 바늘이 「모든 그림의 바늘 + 분류기의 바늘」로 갈라진다면, 뒤쪽을 한 배보다 세게 더해 처음부터 조건 쪽으로 더 기울어 걸을 수 있지 않을까?
역사: 배율 1로는 모자랐다
다리왈과 니콜은 라벨 없이 배운 디퓨전 모델에 범주를 맞히는 분류기를 덧대는 길부터 시험했다. 디퓨전 모델은 걸음마다 잡음 섞인 그림을 보므로, 분류기도 같은 잡음을 섞은 그림으로 따로 학습했다(U-Net의 내려가는 절반에 어텐션 풀링을 붙인 구조). 걸음마다 분류기의 로그 확률을 그림으로 미분해 바늘에 더했다. 베이즈 정리대로라면 한 배만 더하면 조건부 바늘이 된다.
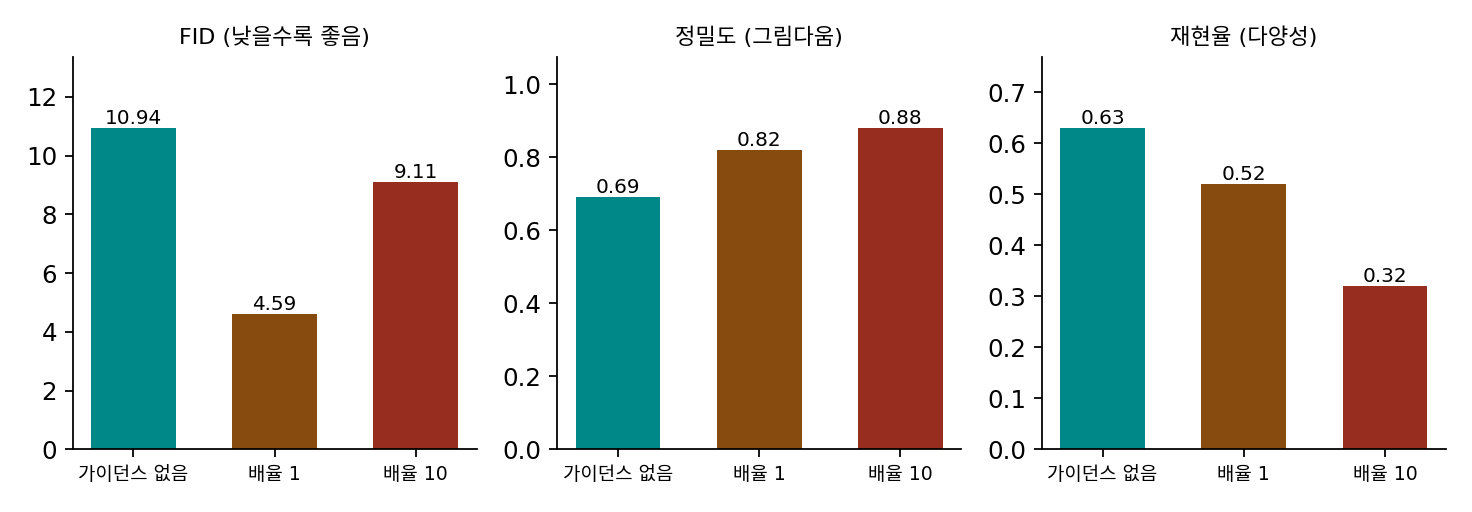
그런데 한 배로는 그림이 범주를 따르지 않았다. 논문은 이렇게 적었다. 배율 1에서는 분류기가 마지막 그림에 원하는 범주의 확률을 50% 안팎으로 매겼지만, 눈으로 보면 그 범주의 그림이 아니었다. 분류기의 바늘을 1보다 큰 상수로 키우자 그 확률이 100% 가까이 올라갔다. 「펨브로크 웰시 코기」 범주로 이끈 그림은 배율 1에서 FID 33.0, 배율 10에서 12.0이었다. 라벨을 넣어 배운 모델에도 분류기를 덧대자 FID가 10.94에서 4.59로 내려갔다. 배율을 10으로 더 키우자 범주다움을 재는 정밀도는 0.88로 오르고, 다양성을 재는 재현율은 0.63에서 0.32로 떨어졌다. 논문은 배율을 키우는 것이 「다양성을 내주고 충실도를 얻는」 거래라고 불렀다.
증거를 w번 세기
분류기의 바늘에 배율 w를 곱해 더한 바늘로 걷는다.
로그 확률에 w를 곱하는 것은 확률을 w제곱하는 것이다. 「낮일 확률이 0.6」이라는 증거를 w번 들은 셈이라, w가 1보다 크면 분류기가 확신하는 쪽으로 분포가 몰린다. 조건부 바늘로 고쳐 쓰면 s(xt ∣ y) + (w − 1)∇ log pφ(y ∣ xt)이므로, 라벨을 넣어 배운 모델에 분류기를 덧대는 것도 같은 식의 다른 꼴이다. 다리왈과 니콜이 적은 배율은 분류기의 바늘에 곱한 수라서, 라벨 없이 배운 모델에서는 이 책의 w와 같고, 라벨을 넣어 배운 모델에서는 w − 1에 해당한다.
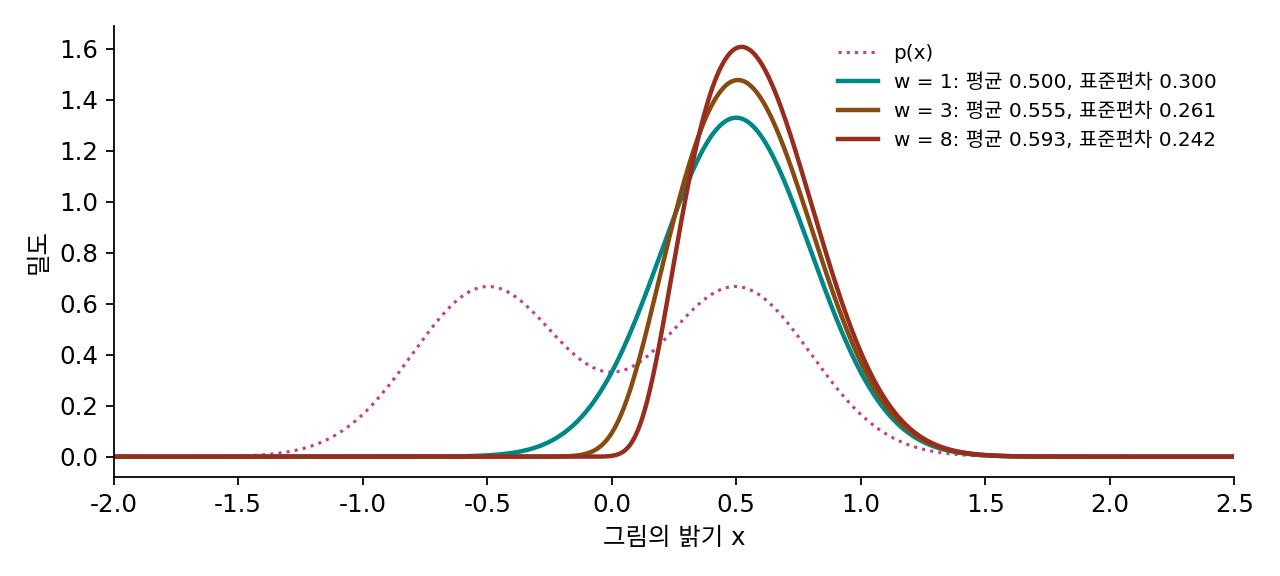
장난감에서 잡음 0의 목표 분포 p(x) p(낮 ∣ x)w를 수치로 적분해 보자. w = 1이면 낮 그림의 분포 그대로(평균 0.500, 표준편차 0.300)이고 애매한 그림이 15.7%다. w = 3이면 평균 0.555, 표준편차 0.261, 애매한 그림 7.7%, w = 8이면 평균 0.593, 표준편차 0.242, 애매한 그림 2.8%다. 낮 봉우리의 왼쪽 꼬리가 눌리면서 분포가 오른쪽으로 조금 옮겨 가고 좁아진다. 이렇게 잡음 섞인 그림으로 배운 분류기의 로그 확률 기울기를 배율만큼 바늘에 더해 조건 쪽으로 기울여 걷는 방법을 분류기 가이던스 (분류기의 바늘을 배율만큼 더하기 / classifier guidance)라 하고, w를 가이던스 배율이라 부른다.
ML에서: 분류기가 짐이 된다
분류기 가이던스는 디퓨전 모델을 다시 배우지 않고도 조건을 바꿀 수 있다는 장점이 있지만, 짐이 둘이다. 첫째, 분류기를 잡음 섞인 그림으로 따로 배워야 하므로 이미 잘 배운 보통의 분류기를 가져다 쓸 수 없다. 둘째, 걸음마다 분류기를 거꾸로 미분해야 한다. 조건이 범주 1,000개가 아니라 아무 문장이나 되면, 「잡음 섞인 그림이 이 문장에 맞을 확률」을 내는 분류기를 따로 만드는 일부터 막막하다.
문제 4. 같은 추천서를 세 번 읽으면
회사는 지원자가 성실할 확률을 처음에 반반으로 본다. 「성실하다」고 쓴 추천서는 성실한 지원자에게서 나올 확률이 그렇지 않은 지원자에게서 나올 확률의 2배다. (가) 그런 추천서 한 통을 받은 뒤 성실할 확률은? (나) 서로 다른 세 사람이 따로 쓴 그런 추천서 세 통이면? (다) 한 통을 세 번 읽고 세 통으로 셌다면 무엇이 잘못되었나? (라) 추천서를 반만 믿기로 하고 2배라는 비를 0.5제곱만 반영하면?

한 통에 성실 쪽으로 2배니까, 0.5에서 두 배 해서… 1이요? 그럼 세 통이면 넘쳐 버리네요.

확률이 아니라 「성실하다 : 아니다」의 비로 적어 볼까요? 처음에는 1 : 1이었죠.

아, 비가 2 : 1이 되니까 확률은 2/3 = 0.667이에요. 세 통이면 비가 2 × 2 × 2 = 8 : 1이라 8/9 = 0.889고요.

(다)는 계산은 (나)와 똑같이 0.889가 나오는데, 실제로 받은 증거는 한 통뿐이야. 같은 증거를 세 번 센 거지.

그럼 (라)는 어떻게 될까요?

비가 2의 0.5제곱, √2 : 1이라 √2/(1 + √2) = 0.586이에요. 제곱하는 수가 1보다 크면 증거를 실제보다 세게, 작으면 약하게 믿는 거네요. 가이던스 배율이 바로 그 지수고요.

팀플 발표에서 조교님 한마디를 세 번 되새기면 그 한마디대로만 발표 자료를 고치게 되는 거랑 같네요.
문제 5. 가이던스 배율을 올리면
그림을 숫자 하나 x로 줄인 장난감에서 그림의 분포가 p(x) = N(0, 1)이고, 분류기가 「웃는 얼굴」이라는 조건 y에 매기는 확률이 pφ(y ∣ x) ∝ exp(−(x − 2)²/2) 꼴이라 하자. (가) w = 1과 w = 3에서 조건을 건 분포 p(x) pφ(y ∣ x)w의 평균과 분산을 구하라. (나) 조건을 건 분포의 로그 밀도의 기울기를 p(x)의 것과 pφ(y ∣ x)의 것으로 나눠 적어라. (다) 배율을 올리면 뽑히는 그림은 어떻게 달라지는가?
(가)는 지수끼리 더하면 돼요. −x²/2 − w(x − 2)²/2를 정리하면 평균이 2w/(1 + w)라서, w = 1이면 1, w = 3이면 1.5요. 배율을 올리면 그림이 더 웃는 쪽으로 옮겨 가요.
옮겨 가기만 해요? 분산은요?
x²의 계수가 (1 + w)/2라서 분산이 1/(1 + w)예요. w = 1이면 0.5, w = 3이면 0.25. 평균만 움직이는 게 아니라 분포가 좁아져요.
아까 추천서 문제랑 같아. 확률을 세제곱한 건 같은 증거를 세 번 본 거니까, 그만큼 한쪽으로 몰리고 퍼짐이 줄어. 배율 3은 「웃는 얼굴」이라는 증거를 세 번 들은 셈이야.
(나)는요?
로그를 씌우면 곱이 합이 되니까 ∇ₓ log(p(x) pφ(y ∣ x)w) = ∇ₓ log p(x) + w ∇ₓ log pφ(y ∣ x)예요. 정규화 상수는 x와 상관없어서 기울기에서 빠지고요. 여기서는 −x + w(2 − x)예요.
디퓨전 모델은 원래 ∇ₓ log p(x)를 배워 두었으니까, 분류기의 기울기에 w를 곱해서 더하기만 하면 되는 거네요. 분포에서는 곱셈을, 기울기에서는 덧셈을 하는 거고요.
그래요. (다)는 다리왈과 니콜도 같은 말을 해요. 배율을 키우면 조건에 더 잘 맞는 그림이 나오지만, 그림들이 서로 덜 다양해진다고요. 오늘 계산에서 분산이 1/(1 + w)로 줄어든 것이 바로 그 다양성이에요.
과제 피드백을 세 배로 세게 반영하면 다들 조교님 취향 답안으로 비슷해지는 거랑 같네요.
문제 6. 깨끗한 사진으로만 배운 분류기
낮·밤 장난감에서 조건 없는 바늘에 분류기의 바늘을 w = 3배로 더해 30걸음 걷는다. 분류기로 (ㄱ) 잡음 섞인 그림으로 배운 것(잡음 크기 σ마다 정확한 p(낮 ∣ x) = 1/(1 + e^(−2 · 0.5 · x/(0.3² + σ²)))) 과 (ㄴ) 깨끗한 그림으로만 배운 것(어느 걸음에서나 1/(1 + e^(−2 · 0.5 · x/0.3²)))을 견준다. (가) 첫 걸음 σ = 14.61에서 x = 3과 x = −3일 때 두 분류기의 바늘 ∇ log p(낮 ∣ x)는? (나) 도착한 그림의 밝기의 평균과 표준편차는? (다) 잘 배운 분류기를 그대로 가져다 쓸 수 없는 까닭은?
깨끗한 그림으로 배운 분류기가 더 정확하잖아요. (ㄴ)이 더 좋을 것 같아요.
첫 걸음의 숫자부터 봐요.
(ㄱ)은 x = 3에서 0.0023, −3에서 0.0024예요. (ㄴ)은 3에서 3.7 × 10⁻¹⁴, −3에서 11.1이요. 한쪽은 0이고 한쪽은 엄청 커요.

잡음이 14.61이면 그림이 ±15쯤에 흩어져 있을 텐데, 깨끗한 분류기는 밝기 3이면 「확실히 낮」, −3이면 「확실히 밤」이라고 해 버리겠네. 깨끗한 그림에서는 −3 같은 밝기가 나온 적이 없는데.
돌려 보니 (ㄱ)은 평균 0.803, 표준편차 0.167인데 (ㄴ)은 평균 11.0, 표준편차 10.4예요. 그림이 데이터 밖으로 날아갔어요.
−3에서 바늘 11.1은 원래 그림의 짐작으로 바꾸면 얼마나 옮기는 걸까요? 바늘에 잡음 분산을 곱하면 원래 그림 쪽으로 가는 거리였죠.
트위디 공식대로면 σ² × 바늘이니까 3 × 11.1 × 14.61²… 7,000이 넘어요. 깨끗한 분류기는 잡음 섞인 그림을 본 적이 없으니, 거기서 내놓는 기울기는 근거 없는 숫자예요. 잡음 수준마다 그 수준의 그림으로 배운 분류기가 필요한 거네요.
깨끗한 답안만 채점해 본 조교님한테 커피 쏟은 답안을 주면 엉뚱한 데 점수를 주는 거랑 같네요. 잡음 섞인 그림용 분류기를 따로 배워야 하니 짐이 하나 더 느는 거고요.