분류기 없는 가이던스: 조건 있는 예측과 없는 예측의 차이를 키운다
분류기 가이던스는 효과가 있었지만, 잡음 섞인 그림으로 따로 배운 분류기와 걸음마다의 거꾸로 미분이 짐이었다. 조건이 문장이면 그런 분류기를 만들기부터 어렵다. 그런데 베이즈 정리로 갈랐던 식을 거꾸로 읽으면, 분류기의 바늘은 ∇ log pt(y ∣ xt) = s(xt ∣ y) − s(xt)다. 조건부 바늘과 조건 없는 바늘이 있으면 분류기 없이도 분류기의 바늘을 얻는다. 조건부 바늘은 이미 라벨을 넣어 배운 신경망이 준다. 조건 없는 바늘은 어디서 얻을까?
역사: 조건을 일부러 지우며 배우기
호(Jonathan Ho)와 샐리먼스(Tim Salimans)는 2021년 12월 학회 워크숍에 짧은 판을 내고, 2022년 7월에 긴 판을 공개했다. 그들은 조건부 모델과 조건 없는 모델을 따로 배우지 않았다. 신경망은 하나로 두고, 학습 때 일정한 확률로 조건을 「빈 조건」 ∅(조건이 없다는 뜻으로 따로 둔 표시)로 바꿔 넣었다. 같은 신경망이 조건을 받으면 조건부 바늘을, ∅를 받으면 조건 없는 바늘을 내놓게 된다. 논문은 이것을 「학습 때 조건을 무작위로 지우는 것과, 생성 때 두 바늘을 섞는 것, 코드 한 줄씩의 변화」라고 소개했다.
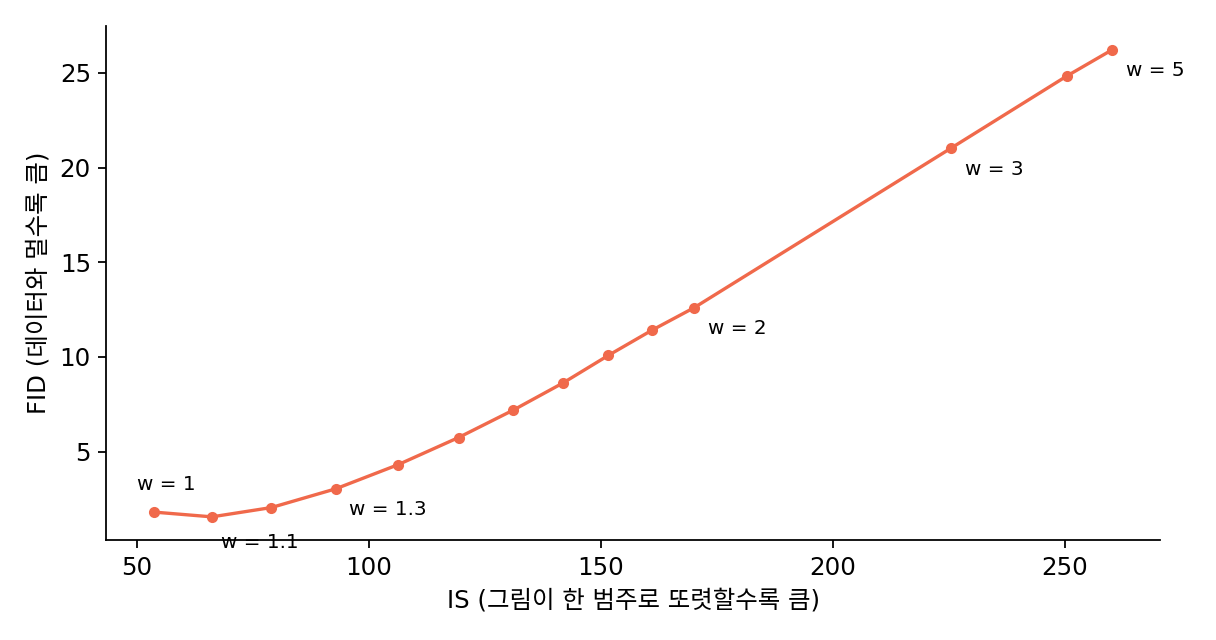
조건을 지우는 확률을 0.1, 0.2, 0.5로 바꿔 가로세로 64픽셀 ImageNet에서 시험했더니, 0.1과 0.2는 거의 같았고 0.5는 모든 배율에서 나빴다. 조건 없는 그림을 만드는 데는 신경망의 작은 몫만 내주면 된다는 뜻이다. 배율을 0부터 올리면, 그림 묶음이 실제 사진과 얼마나 가까운지를 재는 FID는 처음에 조금 좋아졌다가 나빠지고, 그림 한 장 한 장이 한 범주로 얼마나 또렷한지를 재는 IS(Inception Score)는 계속 올랐다. 분류기 가이던스와 같은 거래다. 가로세로 128픽셀에서 세게 이끈 그림을 보이며 논문은 「흥미롭게도 이렇게 세게 이끈 그림은 색이 포화되어 있다」고 덧붙였다.
두 번 읽고 차이를 키우기
걸음마다 신경망을 두 번 부른다. 한 번은 조건 c를 넣어 원래 그림 x̂₀(c)를 읽고, 한 번은 빈 조건 ∅를 넣어 x̂₀(∅)를 읽는다. 둘의 차이를 w배 해서 빈 조건 쪽 예측에 더한다.
두 예측에 붙은 무게 (1 − w)와 w를 더하면 1이므로, 원래 그림으로 적든 잡음 ε̂으로 적든 바늘로 적든 같은 식이다. 바늘 꼴을 분류기 가이던스와 견주면 차이 s(xt ∣ c) − s(xt ∣ ∅)가 분류기의 바늘 자리에 들어갔다. 이렇게 학습 때 조건을 일정한 확률로 지워 한 신경망이 조건부 예측과 조건 없는 예측을 함께 배우게 하고, 생성 때 두 예측의 차이를 배율만큼 키워 조건 쪽으로 기울이는 방법을 분류기 없는 가이던스 (조건 있는 예측과 없는 예측의 차이를 키우기 / classifier-free guidance, CFG)라 한다.
배율을 적는 법은 문헌마다 다르다. 호와 샐리먼스는 (1 + w)ε(c) − wε(∅)로 적어 w = 0이 조건부다. ComfyUI의 cfg, Imagen 논문, 이 책은 위 식처럼 적어 w = 1이 조건부다. 논문의 w에 1을 더하면 이 책의 w다.
코드: 낮 그림을 배율마다 뽑기
낮·밤 장난감에서 정확한 x̂₀를 식으로 계산해, 배율마다 낮 그림 2만 장을 오일러 30걸음으로 뽑는다.
import numpy as np

M, S0 = 0.5, 0.3                                   # 밤 그림 밝기 −0.5, 낮 +0.5, 그림마다 흔들림 0.3

def x0hat(x, s, cond):                             # 정확한 E[x₀ | x]. cond = '낮' 이면 낮 그림만, None 이면 빈 조건(모든 그림)
    mus = np.array([M]) if cond == '낮' else np.array([-M, M])
    v = S0**2 + s**2
    lw = -(x[:, None] - mus)**2 / (2 * v)
    g = np.exp(lw - lw.max(1, keepdims=True)); g /= g.sum(1, keepdims=True)
    return (g * (mus + S0**2 / v * (x[:, None] - mus))).sum(1)

def karras(n, smin=0.0292, smax=14.6146, rho=7):  # SD 1.x 의 σ 범위에 카라스 걸음 일정
    r = np.linspace(0, 1, n)
    return np.append((smax**(1/rho) + r * (smin**(1/rho) - smax**(1/rho)))**rho, 0)

def generate(w, n=20000, steps=30, seed=0):
    rng = np.random.default_rng(seed); sg = karras(steps); x = sg[0] * rng.standard_normal(n)
    for s, s2 in zip(sg[:-1], sg[1:]):
        xu = x0hat(x, s, None)
        xg = xu + w * (x0hat(x, s, '낮') - xu)      # 분류기 없는 가이던스
        x = xg + s2 * (x - xg) / s                  # 오일러 걸음: 읽은 x̂₀ 와 잡음을 다음 σ 로 다시 섞기
    return x

p_day = lambda x: 1 / (1 + np.exp(-2 * M * x / S0**2))   # 깨끗한 그림의 p(낮 | x)
for w in (0, 1, 2, 3, 8):
    x = generate(w)
    print(f"w = {w}: 평균 {x.mean():.3f}, 표준편차 {x.std():.3f}, 애매한 그림 {np.mean(p_day(x) < 0.9):.1%}, 밝기 1 넘음 {np.mean(x > 1):.1%}")
# w = 0: 평균 0.002, 표준편차 0.556, 애매한 그림 57.9%, 밝기 1 넘음 1.7%
# w = 1: 평균 0.492, 표준편차 0.280, 애매한 그림 14.5%, 밝기 1 넘음 3.4%
# w = 2: 평균 0.685, 표준편차 0.195, 애매한 그림 0.0%, 밝기 1 넘음 6.6%
# w = 3: 평균 0.803, 표준편차 0.167, 애매한 그림 0.0%, 밝기 1 넘음 12.5%
# w = 8: 평균 1.150, 표준편차 0.125, 애매한 그림 0.0%, 밝기 1 넘음 91.0%
w = 0은 밤과 낮을 가리지 않는 그림, w = 1은 조건부 그림이다. w = 2에서 이미 애매한 그림이 사라지고, 표준편차는 0.280에서 0.195로 준다. 배율 3의 숫자(평균 0.803, 표준편차 0.167)는 잡음 섞인 그림으로 배운 정확한 분류기로 분류기 가이던스를 걸었을 때와 똑같다. 장난감의 두 바늘이 정확하면 둘의 차이는 정확한 분류기의 바늘이기 때문이다. 그런데 배율이 커질수록 평균이 낮 그림의 중심 0.5를 지나 계속 오른쪽으로 간다. w = 8에서는 평균이 1.150이고 그림의 91.0%가 밝기 1을 넘는다. 낮 그림 데이터에서 밝기 1을 넘는 몫은 4.8%뿐이다.

ML에서: 10%의 빈 조건과 두 번의 호출
Stable Diffusion v1-4 의 모델 설명서는 v1-3과 v1-4를 학습할 때 「분류기 없는 가이던스 생성을 좋게 하려고 글 조건을 10% 지웠다」고 적는다. 생성 때 negative 칸을 빈 글로 두면, 빈 문자열을 글 인코더에 넣어 얻은 벡터가 빈 조건 자리에 들어간다. ComfyUI의 comfy/samplers.py 에서 가이던스는 두 예측을 원래 그림 꼴로 받아 uncond_pred + (cond_pred - uncond_pred) * cond_scale 한 줄로 섞고(cfg_function), cfg가 1이면 조건 없는 예측을 아예 계산하지 않는다(sampling_function 의 math.isclose(cond_scale, 1.0)). 가이던스를 쓰면 생성 시간이 두 배가 되는 것이다. 이 시간을 줄이려고 멍(Chenlin Meng)과 동료들(2022)은 가이던스를 건 예측을 학생 신경망이 한 번에 내도록 증류하고, 배율 자체를 학생의 입력으로 넣었다. FLUX.1 [dev]의 모델 설명서도 「가이던스 증류로 학습했다」고 적는다. ComfyUI의 FLUX 구현은 배율 값을 시간 값처럼 벡터로 펴서 시간 벡터에 더하고(comfy/ldm/flux/model.py 의 guidance_in), 그 배율을 정하는 마디(FluxGuidance)의 기본값은 3.5다.
문제 7. 필터 세기 슬라이더
사진 앱의 「선명하게」 필터는 원본 밝기 120인 칸을 150으로 바꾼다. 필터 세기 슬라이더는 「원본 + 세기 × (필터 결과 − 원본)」으로 계산한다. (가) 세기 1.5와 2.5에서 이 칸의 밝기는? (나) 세기 0과 1에서는? (다) 밝기는 0~255로 저장된다. 세기 5에서는 어떻게 되는가?

세기 1.5면 150 × 1.5 = 225예요.

그 계산이면 세기 1에서는 얼마죠? 필터를 그대로 건 것과 같아야 할 텐데요.

150이요… 맞긴 하네요. 그런데 세기 0이면 0이 돼요. 필터를 안 걸었는데 검은 칸이 될 리가 없죠. 원본에서 차이만 늘려야 해요. 120 + 1.5 × 30 = 165, 2.5면 195예요.

(나)는 세기 0이면 원본 120, 1이면 필터 결과 150. 세기가 1을 넘으면 필터가 바꾼 방향으로 필터보다 더 가는 거네. 사이를 잇는 게 아니라 바깥으로 늘이는 거야.

(다)는요?
120 + 5 × 30 = 270인데 255까지만 저장되니까 255로 잘려요. 필터가 바꾼 방향이 맞아도, 너무 늘이면 저장할 수 있는 범위를 넘어 버려요.

가이던스 식이랑 꼴이 똑같네요. 빈 조건이 원본, 조건이 필터 결과, 배율이 세기예요. 보고서를 첨삭 받은 방향으로 더 고친다고 첨삭 범위를 넘어서까지 고치면 엉뚱해지는 거랑 같고요.
문제 8. 겨냥하는 분포의 평균은 조건의 평균을 넘는다
조건 없는 분포가 N(0, 1), 조건부 분포가 N(1, 0.5²)인 장난감이다. 분류기 없는 가이던스의 바늘은 잡음 0에서 p(x ∣ ∅)1 − w p(x ∣ c)w에 비례하는 분포를 겨냥한다. (가) w = 2와 w = 8에서 이 분포의 평균과 분산은? (나) w가 아주 크면 평균은 어디로 가는가? 조건부 분포의 평균 1과 견주어라. (다) 조건부 분포가 조건 없는 분포보다 넓은 N(1, 2²)이라면?
조건부 분포 쪽으로 무게를 더 주는 거니까 평균은 1로 다가가고, 분산은 0.25로 다가가겠죠.
지수를 직접 정리해 볼까요? 정밀도(분산의 역수)로 적으면 편해요.

−(1 − w)x²/2 − w · 4(x − 1)²/2니까, x²의 계수에서 정밀도가 (1 − w) + 4w = 1 + 3w, 평균이 4w/(1 + 3w)예요. w = 2면 평균 8/7 = 1.143, 분산 1/7 = 0.143이고, w = 8이면 평균 32/25 = 1.28, 분산 0.04예요. 평균이 1을 넘었어요.

(나)는 4w/(1 + 3w)에서 w → ∞이면 4/3이야. 조건부 분포의 평균 1을 지나 1.333까지 가. 조건 없는 쪽에서 조건 쪽으로 가는 방향을 따라 조건 너머로 밀려나는 거지.
(다)는 「조건부 분포가 더 좁다」는 단서를 뺀 경우예요. 어떻게 될까요?

정밀도가 (1 − w) + w/4 = 1 − 3w/4라서, w = 4/3을 넘으면 음수가 돼요. x²의 계수가 양수면 밀도가 양쪽 끝에서 무한히 커지니까… 분포가 아니에요. 정규화할 수가 없어요.

그래요. 조건을 붙였는데 오히려 넓어지는 방향이 있으면, 그 방향으로는 가이던스가 「조건 없는 쪽에서 멀어지라」고 끝없이 밀어요. 실제 모델에서는 차원마다 이런 일이 섞여 있어요.

「작년보다 나아진 점을 더 키워라」고 했는데 작년보다 오히려 산만해진 부분까지 키우면 끝도 없이 산만해지는 거네요.
문제 9. 신경망을 몇 번 부르나
ComfyUI에서 오일러 20걸음으로 그림 한 장을 만든다. (가) cfg 8이면 신경망을 몇 번 부르는가? (나) cfg 1이면? (다) FLUX.1 [dev]처럼 배율을 입력으로 받는 모델에 FluxGuidance 3.5를 주고 cfg 1로 걸으면? (라) 글 조건을 10% 지우는 Stable Diffusion v1-4 를 학습 묶음 256장으로 배울 때, 한 묶음에서 빈 조건으로 배우는 그림은 평균 몇 장인가?
(가)는 걸음마다 조건 하나, 빈 조건 하나라 40번이요. (나)도 40번이요. 식이 같으니까요.
cfg 1이면 식이 x̂₀(∅) + 1 × (x̂₀(c) − x̂₀(∅))잖아. x̂₀(∅)가 지워지는데 그걸 왜 계산해?
코드를 보니 cond_scale이 1이면 uncond를 None으로 두고 안 불러요. 20번이에요.
그럼 (다)의 모델은 빈 조건을 한 번도 안 읽는데, 어떻게 3.5배 가이던스를 걸까요?
학습 때 이미 가이던스를 건 예측을 흉내 내도록 배웠으니까요. 배율 3.5를 시간처럼 입력으로 받아서, 두 번 읽고 섞은 결과를 한 번에 내요. 그래서 20번이에요. (라)는 10%니까 25.6장이고요.
과제 두 번 채점해서 평균 내던 걸, 그 결과를 외운 조교님이 한 번에 채점하는 거네요.