12장 — 디퓨전 트랜스포머: U-Net 자리에 트랜스포머를
합동 어텐션: 글 토큰과 그림 토큰을 한 줄로
DiT 의 조건은 시간과 분류 라벨 1,000개 가운데 하나였다. 라벨은 벡터 하나라 시간과 더해 adaLN 에 넣으면 됐다. 글은 다르다. 글 인코더는 토큰마다 벡터를 넘기고, 「파란 공 위의 빨간 정육면체」의 「빨간」은 정육면체가 그려질 칸이, 「파란」은 공이 그려질 칸이 읽어야 한다. 토큰 줄을 벡터 하나로 줄여 adaLN 에 넣으면 이 짝이 뭉개진다. U-Net 은 크로스 어텐션으로 그림 칸이 글 토큰을 읽게 했다. 트랜스포머는 이미 토큰 줄을 다루는데, 글 토큰 줄을 따로 읽는 층을 둘 필요가 있을까? 두 줄을 이어 한 줄로 만들면 안 될까?
역사: 두 벌의 가중치, 한 번의 어텐션
2024년 Stability AI 의 에서(Patrick Esser)와 동료들은 Stable Diffusion 3 을 만들며 이 물음을 실험으로 따졌다. 같은 자료(CC12M)에서 네 구조를 학습했다. DiT 에 글 토큰을 그대로 이어 붙여 같은 가중치로 처리하는 것, 크로스 어텐션으로 글을 읽는 DiT(CrossDiT), U-Net 과 트랜스포머를 섞은 UViT, 그리고 그들이 새로 낸 MM-DiT 다. MM-DiT 는 글 토큰과 그림 토큰을 어텐션에서만 한 줄로 잇고, 정규화·변조·QKV 투영·MLP 는 글 줄과 그림 줄이 저마다 다른 가중치를 쓴다. 논문은 「글과 그림의 임베딩은 개념적으로 꽤 다르기 때문에 두 양식에 서로 다른 가중치 두 벌을 쓴다」고 적었다. 결과는 MM-DiT 가 검증 손실, CLIP 점수, FID 모두에서 가장 좋았고, 같은 가중치 한 벌로 이은 DiT 가 가장 나빴다. 글 인코더 둘(CLIP 과 T5)에 가중치를 따로 주는 세 벌짜리는 두 벌보다 조금 나을 뿐이라 두 벌을 택했다.
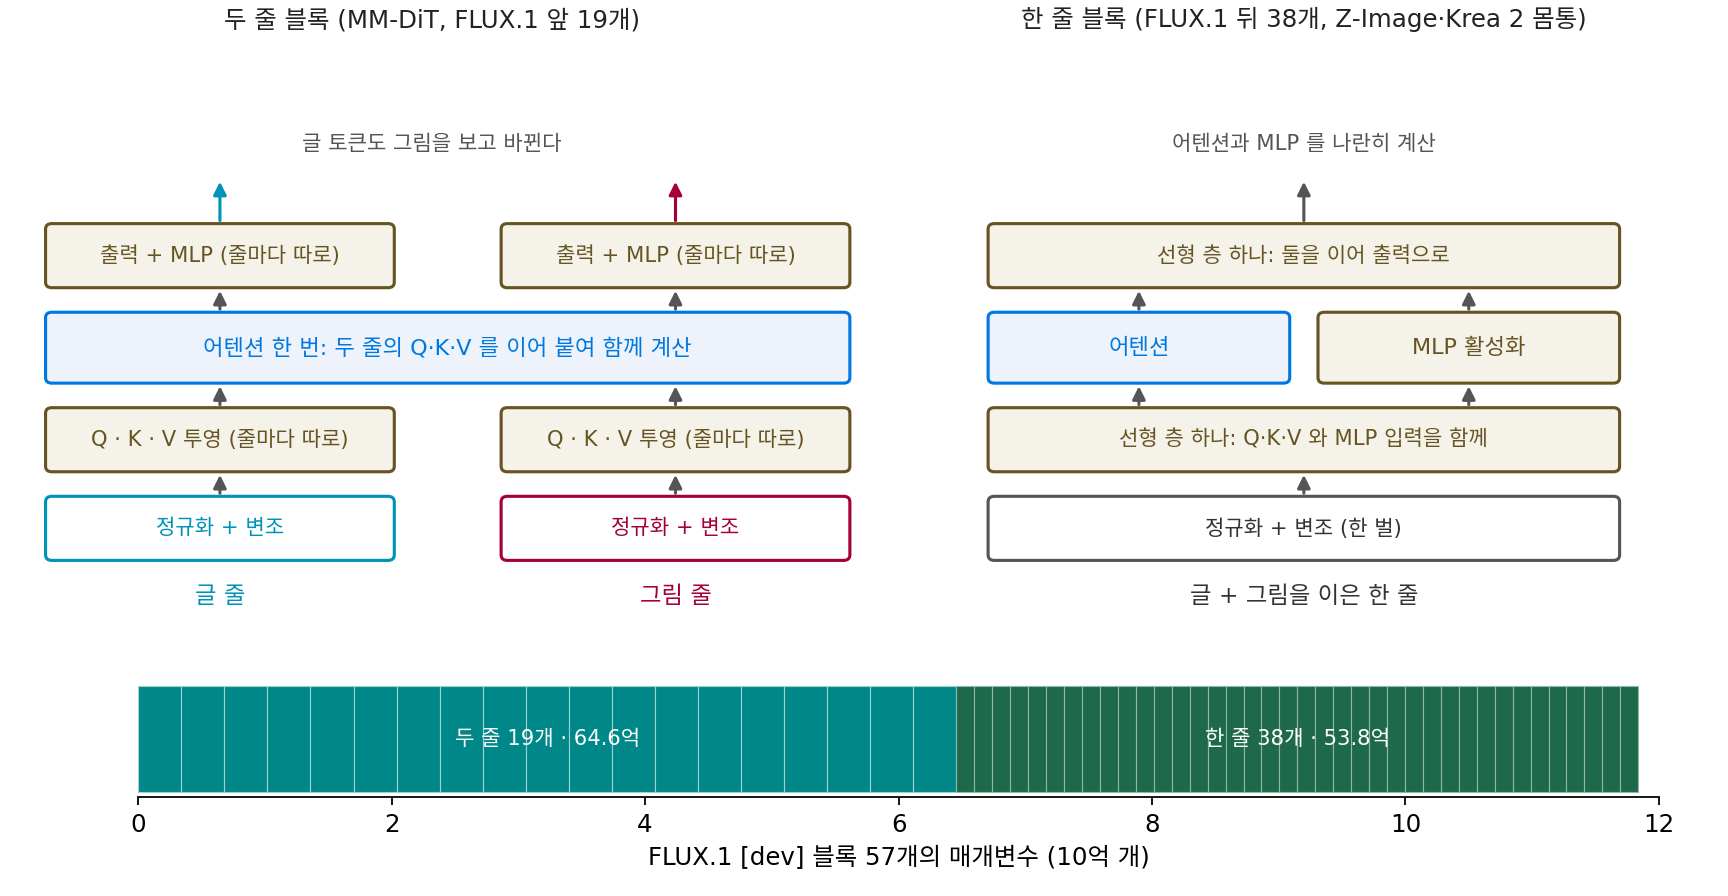
같은 해 Black Forest Labs 의 FLUX.1 은 이 두 줄 블록을 19개 쌓은 뒤, 글 토큰과 그림 토큰을 한 줄로 합쳐 가중치 한 벌만 쓰는 한 줄 블록을 38개 더 쌓았다. 한 줄 블록은 어텐션과 MLP 를 차례로 지나지 않고 한 번의 선형 층에서 둘의 입력을 함께 뽑아 나란히 계산한다. ComfyUI 코드는 이 블록에 구글의 220억 매개변수 ViT 논문(2023)을 출처로 달아 두었다.
두 줄 블록과 한 줄 블록
글 토큰 줄 c(토큰 N글개)와 그림 토큰 줄 h(토큰 N그림개)가 블록에 들어온다. 두 줄 블록은 줄마다 다른 가중치로 질의·열쇠·값을 만든 뒤, 셋을 줄 방향으로 이어 셀프 어텐션을 한 번 계산한다.
어텐션 뒤에는 결과를 다시 두 줄로 갈라 줄마다 제 MLP 를 지난다. 한 줄 블록은 처음부터 [c; h]를 한 줄로 보고 가중치 한 벌로 같은 일을 한다. 어느 쪽이든 그림 토큰은 글 토큰을, 글 토큰은 그림 토큰을 읽고, 글 토큰도 층마다 바뀐다. 이렇게 글 토큰 줄과 그림 토큰 줄을 이어 셀프 어텐션 하나로 함께 처리하는 것을 합동 어텐션 (두 줄을 이어 함께 보는 어텐션 / joint attention)이라 한다.
두 블록은 매개변수가 크게 다르다. ComfyUI 의 FLUX.1 블록을 만들어 세면 두 줄 블록 하나가 3억 3,983만 1,296개, 한 줄 블록 하나가 1억 4,159만 1,808개다(sources/ch12/model_facts.py). 계산은 어떨까? 그것은 아래 문제에서 따져 보자.
ML에서: 앞에서 따로, 뒤에서 함께
이 장에서 견줄 모델들은 글과 그림을 만나게 하는 자리를 저마다 다르게 정했다. Qwen-Image 는 두 줄 블록만 60개다. FLUX.1 은 두 줄 19개 뒤에 한 줄 38개, FLUX.2 [dev] 은 두 줄 8개 뒤에 한 줄 48개로 한 줄 쪽이 더 늘었다. Z-Image 와 Krea 2 는 몸통이 모두 한 줄 블록이다. 대신 몸통에 들어가기 전에 글 토큰만 따로 다듬는 단계를 둔다. Z-Image 는 글 토큰만 지나는 블록 2개와 그림 토큰만 지나는 블록 2개를 먼저 둔 뒤 둘을 이어 30개의 한 줄 블록에 넣고(comfy/ldm/lumina/model.py 의 context_refiner, noise_refiner), Krea 2 는 글 융합 단계를 지난 글 토큰 줄을 그림 줄 앞에 이어 28개의 한 줄 블록에 넣는다(comfy/ldm/krea2/model.py). Z-Image 를 만든 Tongyi-MAI 팀은 이 구조를 「단일 줄 DiT(S3-DiT)」라 부르며 두 줄 구조보다 매개변수를 알뜰하게 쓴다고 소개한다. Anima 만 다른 길이다. 몸통의 블록 28개가 모두 「셀프 어텐션 → 글을 읽는 크로스 어텐션 → MLP」이고, 글 토큰은 몸통을 지나는 동안 바뀌지 않는다.
문제 10. 두 줄 블록과 한 줄 블록의 셈
FLUX.1 [dev] 의 두 줄 블록 하나는 339,831,296개, 한 줄 블록 하나는 141,591,808개의 매개변수를 가진다. (가) 블록 57개(두 줄 19 + 한 줄 38)의 매개변수는? (나) 57개가 모두 두 줄이었다면, 모두 한 줄이었다면? (다) 1536 × 1024 그림(그림 토큰 6,144개)에 글 256토큰일 때 두 줄 블록과 한 줄 블록의 어텐션 쌍은 각각 몇 개인가? (라) 한 줄 블록의 매개변수가 두 줄 블록의 절반보다도 적은 까닭은?

(가)는 19 × 339,831,296 = 6,456,794,624에 38 × 141,591,808 = 5,380,488,704를 더해 11,837,283,328개. 전체 119억에서 남는 6,400만 개쯤은 패치·시간·글을 옮기는 층하고 마지막 층이겠다.

(나)는 모두 두 줄이면 193억 7,038만 3,872개, 모두 한 줄이면 80억 7,073만 3,056개요. (다)는 두 줄이 가중치가 두 벌이니까 쌍도 두 배 아니에요?

두 줄 블록에서 어텐션은 몇 번 계산하죠?

질의·열쇠·값을 이어 붙여서 한 번이요. 그럼 둘 다 6,400² = 40,960,000쌍이네요. 가중치가 두 벌이어도 토큰 하나는 자기 줄의 가중치 한 벌만 지나니까, 토큰마다의 계산도 같고요.

(라)는 두 줄 블록이 그림 줄과 글 줄에 가중치를 한 벌씩, 곧 두 벌 갖는 데다, 줄마다 변조 층이 6 × 3072 묶음이라 무거워. 한 줄 블록은 한 벌에 변조 묶음도 셋뿐이라 절반보다 가벼운 거야. 변조 층을 빼고 보면 두 줄이 226,548,224개, 한 줄이 113,271,040개로 거의 정확히 두 배야(차이 6,144개는 정규화의 수).

그래요. 두 줄 블록은 계산은 그대로 두고 「글을 다루는 가중치」를 따로 사는 데 매개변수를 써요. 그 값이 그만한지는 모델마다 판단이 갈렸어요.

통역사를 언어마다 따로 두든 한 명이 다 하든 회의 시간은 같은데, 인건비만 다른 거네요.
문제 11. 글 토큰은 언제 바뀌나
Anima 의 몸통 블록 28개는 「셀프 어텐션 → 크로스 어텐션 → MLP」이고, Krea 2 의 몸통 블록 28개는 글과 그림을 이은 한 줄 블록이다. (가) 그림을 만드는 동안 Anima 의 몸통에서 글 토큰 줄은 몇 번 바뀌는가? Krea 2 에서는? (나) Anima 는 글 인코더(Qwen3-0.6B)의 마지막 층과 몸통 사이에 블록 6개짜리 어댑터를, Z-Image 는 글 토큰만 지나는 블록 2개를 둔다. 왜 이런 단계가 필요할까? (다) 「글 토큰이 그림을 보고 바뀐다」는 것이 그림 생성에 무슨 쓸모가 있을까?
(가) Anima 는 크로스 어텐션이라 글은 읽히기만 하니까 0번, Krea 2 는 블록마다 바뀌니까 28번이요.
그럼 Anima 에서 글 쪽의 일은 누가 하죠?
아, 몸통에 들어가기 전에 다 끝내야 하네요. 그게 (나)의 어댑터 6개고요. Qwen3-0.6B 의 은닉 상태를 그대로 쓰지 않고, 그림 몸통이 읽기 좋은 꼴로 한 번 더 바꾸는 거예요.

그런데 Z-Image 는 몸통에서 글 토큰도 바뀌는 한 줄 블록인데 왜 글만 지나는 블록 2개를 또 둬?
한 줄 블록은 글 토큰과 그림 토큰에 같은 가중치를 써요. 처음 들어올 때 두 줄의 수는 비슷한 모양일까요?
아니겠네요. 글 쪽은 언어모델의 은닉 상태를 옮긴 것이고 그림 쪽은 잡음 섞인 잠재 그림을 옮긴 거라, 크기도 퍼진 모양도 달라요. 같은 가중치에 넣기 전에 줄마다 따로 다듬어 비슷한 말투로 맞추는 거예요. 두 줄 블록이 가중치 두 벌로 하던 일을 앞의 몇 블록으로 몰아서 한 거고요.
그래요. (다)는 문제를 하나 남겨 둘게요. 같은 「빨간」이라도 그림에서 정육면체가 왼쪽에 자리 잡았느냐 오른쪽이냐에 따라, 그 토큰이 그림 칸들에게 내줄 내용이 달라져야 할 때가 있어요. 글이 그림을 볼 수 있으면 그런 조정을 층마다 할 수 있죠.

디자이너가 시안을 고치는 동안 고객사도 시안을 보면서 요청을 고쳐 말하는 회의랑, 고객 요청서를 처음에 한 번 받고 끝까지 그것만 보는 작업의 차이네요.