디노이징 오토인코더: 일부러 망가뜨린 그림을 되살리기
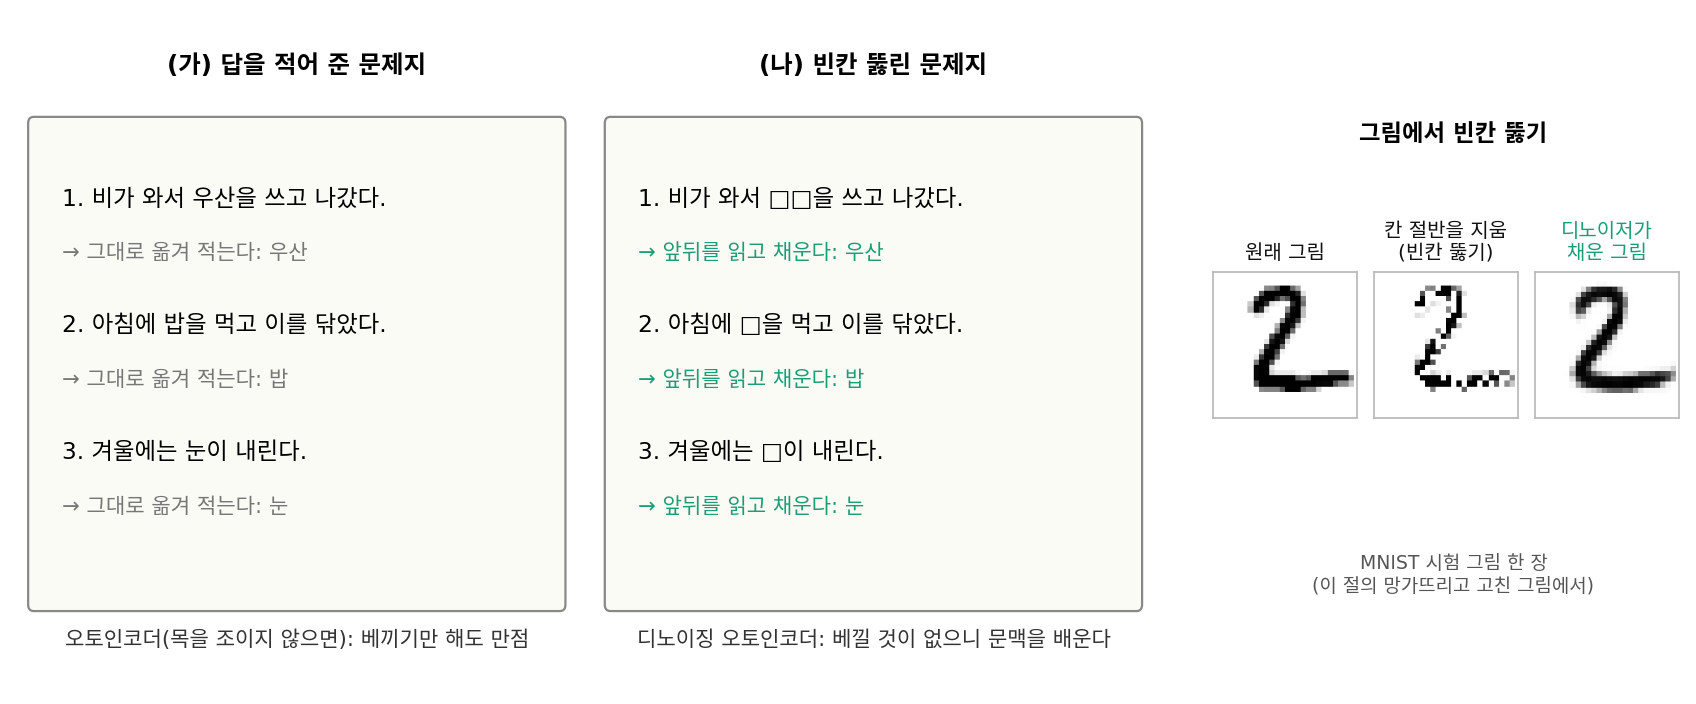
오토인코더는 받은 그림을 그대로 되살리도록 배운다. 가운데를 좁은 목으로 조이지 않으면 받은 것을 그대로 내보내는 지루한 함수가 되고, 아무것도 배우지 않는다. 시험에 비유하면 문제지에 답을 적어 주고 그 답을 그대로 옮겨 쓰라는 것과 같다. 같은 문제지라도 빈칸을 뚫어 놓으면 베껴 쓸 수 없고, 앞뒤 문맥을 알아야 빈칸을 채울 수 있다. 목을 조이는 대신 입력을 일부러 망가뜨려 베끼지 못하게 하면, 신경망은 무엇을 배우게 될까?
역사: 가려도 알아보는 특징
2008년 몬트리올 대학교의 뱅상(Pascal Vincent), 라로셸(Hugo Larochelle), 벤지오(Yoshua Bengio), 만자골(Pierre-Antoine Manzagol)은 「입력을 망가뜨려 베끼지 못하게 하면 무엇을 배울까」라는 물음에서 출발했다. 그해 네 사람이 국제 머신러닝 학회(ICML)에 낸 논문의 제목은 「노이즈를 걷어 내는 오토인코더로 튼튼한 특징을 뽑고 쌓기(Extracting and Composing Robust Features with Denoising Autoencoders)」이다. 그때는 층이 깊은 신경망을 처음부터 학습하기가 어려워서, 층마다 먼저 라벨 없이 쓸 만한 중간 표현을 배워 두고 그 위에서 학습을 시작하는 방법이 쓰였다. 그런데 무엇이 「쓸 만한 표현」인지는 거의 알려지지 않았다. 네 사람은 입력이 일부 부서져도 거의 같은 표현이 나와야 한다는 기준을 내세웠고, 사람이 가려지거나 망가진 그림도 알아본다는 것을 그 근거로 들었다. 방법은 단순했다. 입력 칸 가운데 정해진 비율을 무작위로 골라 0으로 지우고, 지우기 전의 입력을 되살리게 했다.
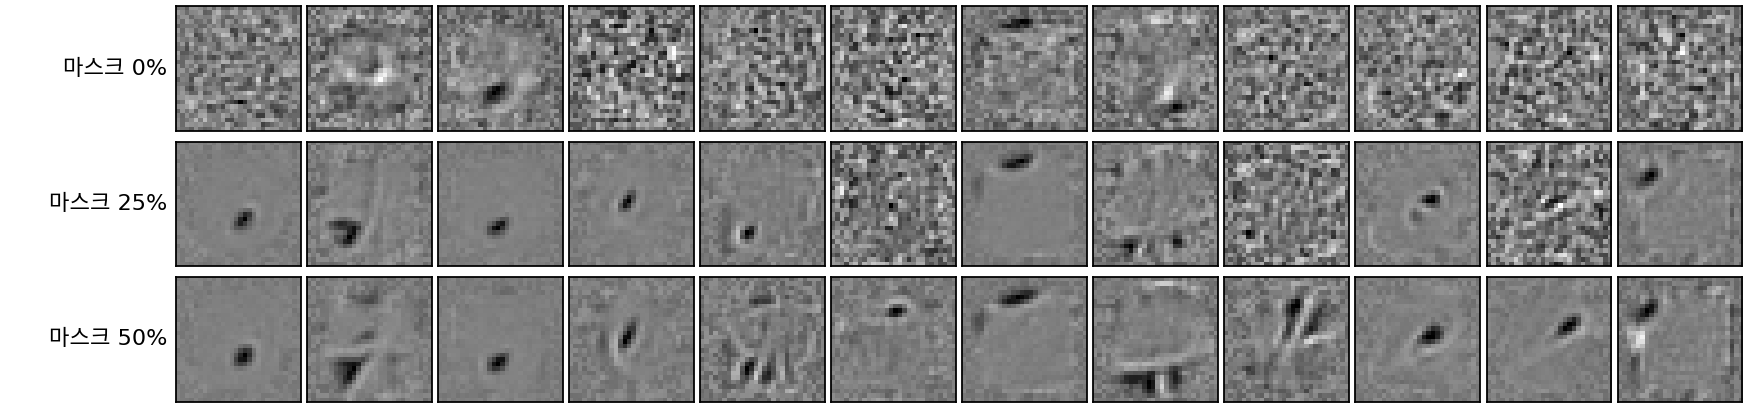
결과는 필터에서 드러났다. 지우지 않고 배운 오토인코더의 필터는 상당수가 뜻 없는 얼룩이었는데, 지우는 비율을 올리자 점과 획을 찾는 필터가 늘었다. 숨은 층을 입력(784칸)보다 넓은 2,000칸으로 잡아도 베끼기로 빠지지 않았다. 논문은 오토인코더로 노이즈를 걷는 일 자체는 1987년 르쿤(Yann LeCun)과 갈리나리(Patrick Gallinari) 등이 먼저 했다고 밝히고, 자기들의 목표는 좋은 디노이저가 아니라 좋은 표현이라고 적었다.
칸을 지우고 원래 그림을 맞히게 하는 거면 지금은 파이토치로 몇 줄이잖아요. 784칸짜리 MLP 하나를 처음부터 끝까지 한 번에 학습하면 되고요.
지금은 그렇죠. 그런데 2008년의 네 사람은 왜 층마다 따로 미리 배워 두는 번거로운 방법을 썼을까요?
음, 오토인코더의 역사에서 본 그 문제 아니에요? 시그모이드의 미분이 0.25 이하라서, 층을 거슬러 올라갈수록 그래디언트가 줄어든다는 거요.
맞아요. 2008년에도 그 벽은 그대로였어요. 처음 가중치 규칙, ReLU, Adam 은 아직 나오기 전이었고, 층마다 출력의 크기를 맞춰 주는 배치 정규화는 2015년에야 나왔어요. 그러니 층을 쌓을수록 아래층까지 학습 신호가 잘 닿지 않아서, 한 층씩 배워 쌓았어요.
그런데 층마다 미리 배울 때는 라벨이 없잖아요. 그 층이 잘 배웠는지는 무엇으로 판단했어요?
그게 막힌 곳이에요. 「쓸 만한 표현」을 바로 재는 잣대가 없었어요. 필터를 그림으로 그려 눈으로 보거나, 층을 다 쌓은 뒤 분류 문제에서 얼마나 맞히는지로 거꾸로 따질 수밖에 없었죠.
잠깐, 숨은 층이 2,000칸이면 784칸을 그대로 옮겨 적을 자리가 넉넉하잖아요. 칸을 지우기만 했는데 베끼기로 빠지지 않았다는 게 이상해요.
지운 칸에는 베낄 값이 없으니까요. 그럼 디노이저는 지운 칸에 무엇을 적어 넣을까요? 지운 칸이 원래 0이었는지 1이었는지 모르는데요.
가리고, 흔들고, 되살리기
손글씨 숫자(MNIST, 칸마다 밝기 0은 바탕, 1은 잉크)로 해 보자. 먼저 시험 그림마다 칸의 절반을 무작위로 0으로 지우고, 784 → 1024 → 1024 → 1024 → 784 MLP 가 지우기 전의 그림을 맞히도록 제곱 오차로 학습했다. 지운 칸을 0으로 둔 채 재면 지운 칸의 제곱 오차 합이 그림 한 장에 40.63인데, 고친 그림에서는 3.98이다.
다음은 지우는 대신, 칸마다 표준정규 노이즈 ε(엡실론)에 노이즈 크기 σ(시그마)를 곱해 더해서 흔든다. σ = 0.5 이면 칸마다 밝기가 ±0.5쯤 흔들린다. σ 마다 따로 학습한 디노이저(망가진 그림을 받아 원래 그림을 내놓는 신경망)의 결과가 아래 그림이다.
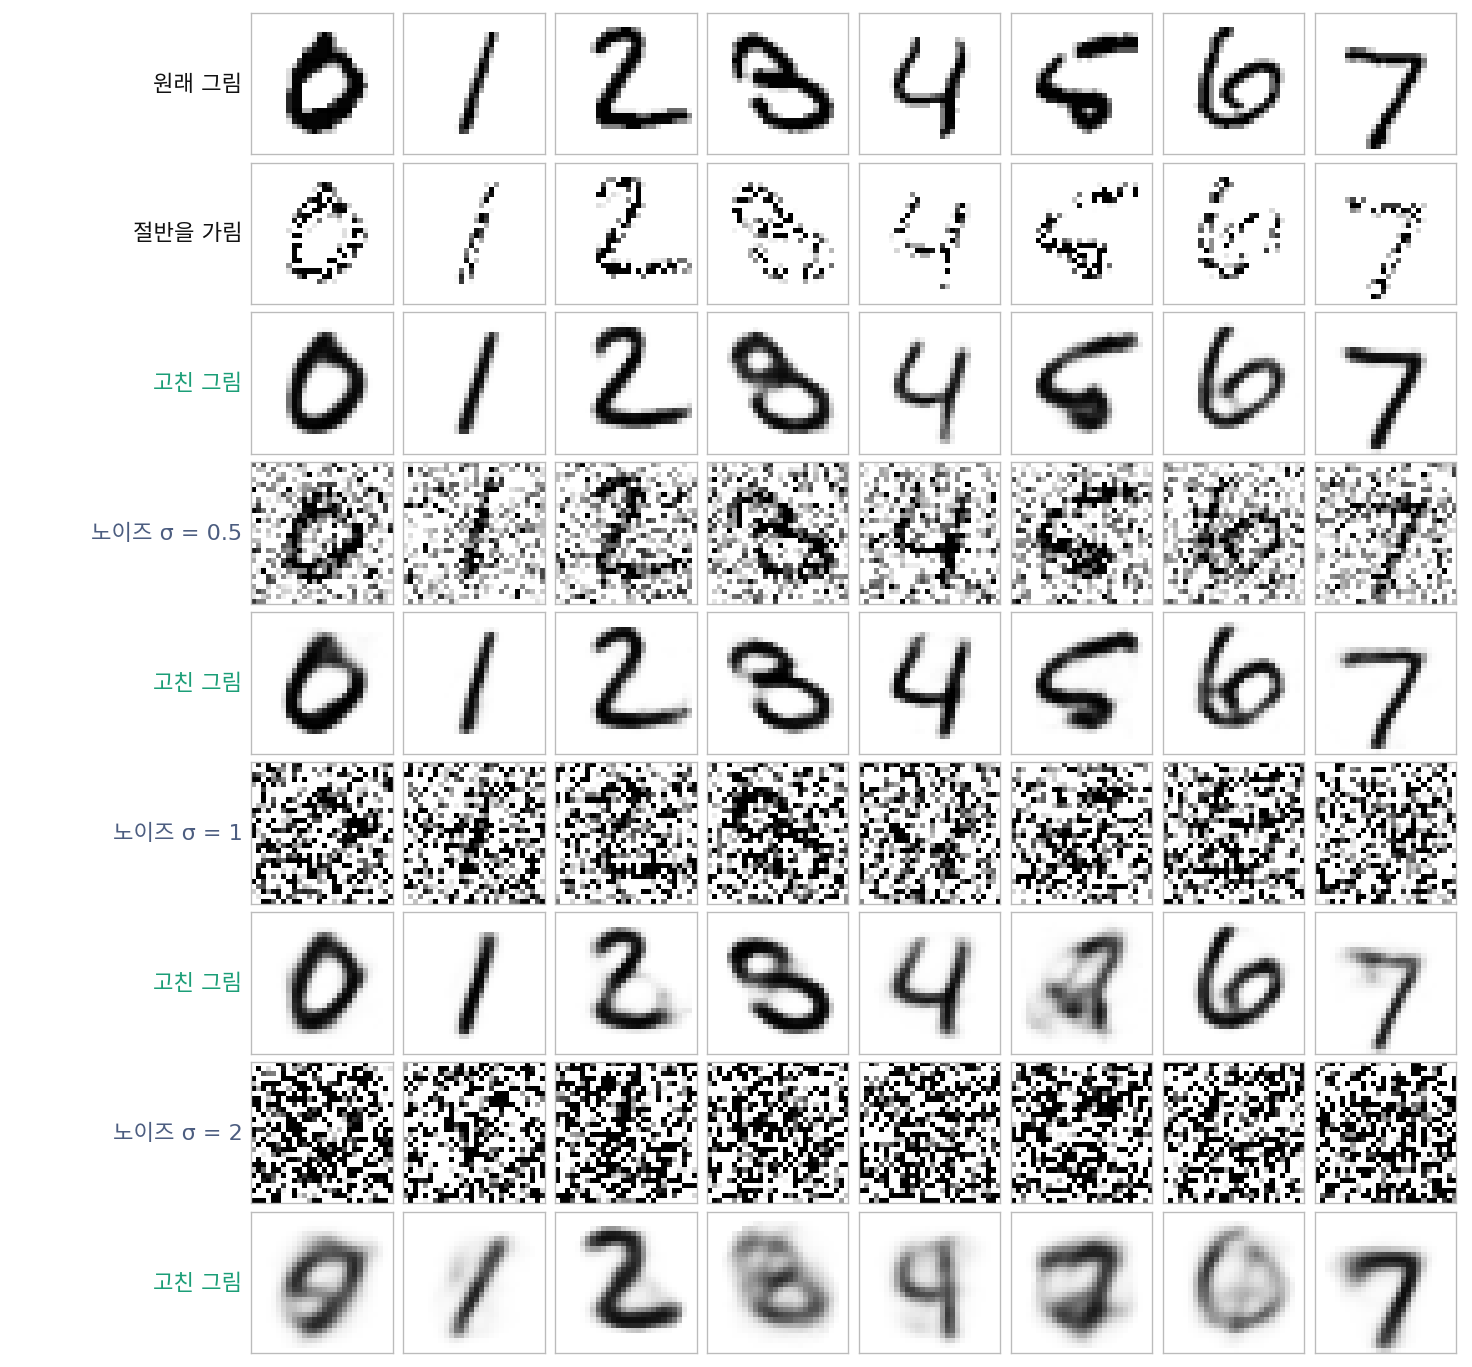
σ 가 커질수록 고친 그림이 흐려진다. 밝기 0.2 ~ 0.8 인 회색 칸이 시험 그림에는 6.1%인데, 고친 그림에서는 σ = 0.5 에서 7.7%, 1 에서 11.6%, 2 에서 20.0%다. 고친 그림과 학습 그림 전체의 평균 그림 사이의 제곱 거리도 42.88, 33.97, 17.05로 줄어든다(시험 그림 자체는 평균 그림과 50.51 떨어져 있다).
고친 그림이 흐려지는 것은 학습 목표 때문이다.
라벨을 넣고 그림을 받는 MLP가 그 라벨의 그림들을 평균 낸 것과 같은 원리다. 입력 하나에 정답이 여럿 붙어 있으면, 제곱 오차로 배운 신경망은 정답들의 평균(조건부 평균)을 내놓는다. 여기서는 입력이 망가진 그림이다. 조금 망가진 그림은 원래 그림을 거의 하나로 가리키지만, 많이 망가진 그림은 수많은 원래 그림과 어울리고, 그 평균은 흐리다. 이렇게 일부러 망가뜨린 입력을 받아 원래 입력을 되살리도록 배우는 오토인코더를 디노이징 오토인코더 (denoising autoencoder)라 한다. 디노이징(denoising)은 노이즈(noise)을 걷어 낸다는 말이고, 이 장은 칸을 지우는 것처럼 다른 방식으로 망가뜨린 것을 되살리는 일까지 이 말로 부른다.
ML에서: 가린 낱말 맞히기
2018년 구글의 데블린(Jacob Devlin)과 동료들이 내놓은 언어 모델 BERT 는 문장의 토큰(낱말 조각) 가운데 15%를 무작위로 골라 가리고, 가린 낱말을 맞히도록 프리트레인한다. 논문은 「디노이징 오토인코더(빈센트와 동료들, 2008)와 달리 입력 전체를 되살리지 않고 가린 낱말만 맞힌다」고 적어, 같은 생각에서 갈라져 나왔음을 밝혔다.
문제 6. 번진 키 기록
어느 반 학생 20명의 키(cm)는 158, 161, 163, 165, 166, 168, 169, 171, 172, 172, 174, 175, 176, 177, 178, 180, 181, 183, 185, 188 이다. 한 학생의 기록 카드에 물이 번져 키가 「17□」로만 보인다. (가) 이 학생의 키를 숫자 하나로 짐작해 제곱 오차의 평균을 가장 작게 하려면 얼마라고 해야 하는가? (나) 더 번져서 「1□□」만 보이면? (다) 두 짐작은 이 반에 실제로 있는 키인가?
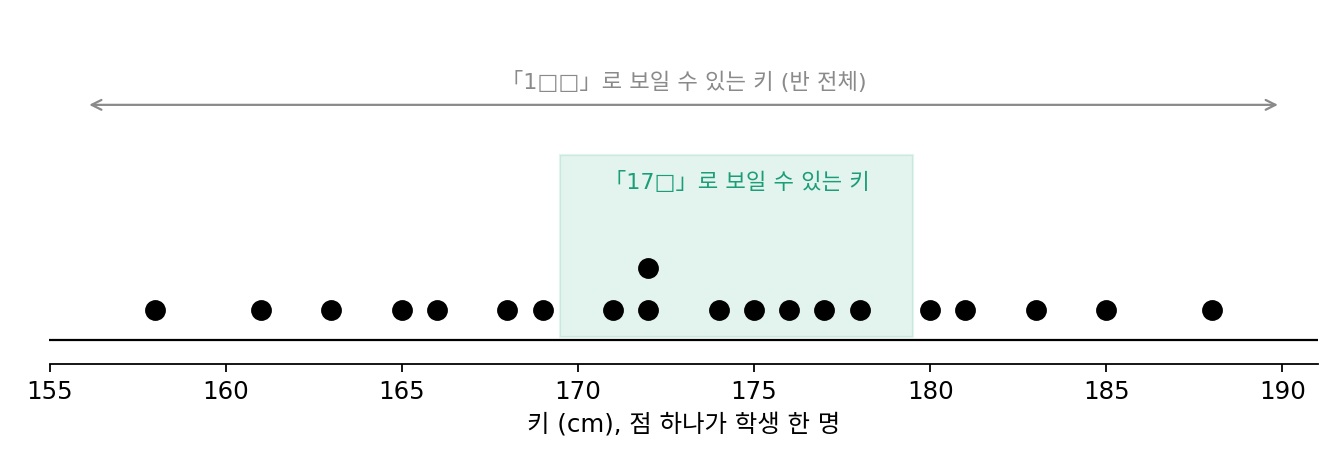
170대 학생은 171, 172, 172, 174, 175, 176, 177, 178, 여덟 명이에요. 제곱 오차의 평균을 가장 작게 하는 건 평균이니까 174.375예요.
가운데쯤인 174로 짐작하면 얼마나 손해예요?
계산해 보니 174면 제곱 오차 평균이 5.875, 174.375면 5.734예요. 조금이지만 평균이 이기네요.
(나)는요?
반 전체가 다 「1□□」에 맞으니까 20명 평균, 173.1이요.
(다)는요?
키 174.375인 학생도 173.1인 학생도 반에 없어요. 짐작이 제곱 오차로는 가장 좋은데, 실제 학생 누구의 키도 아니네요.
번진 게 적을 때는 여덟 명의 평균, 많이 번지면 반 전체의 평균이네. 많이 망가질수록 더 많은 학생을 섞어서 반 평균 쪽으로 끌려가.
위의 숫자 그림에서 σ 가 커질수록 고친 그림이 평균 그림 쪽으로 다가간 거랑 똑같아. 망가진 정도가 「몇 명이 후보로 남았나」를 정하는 거야.
문제 7. 네 칸짜리 그림
가로세로 2칸짜리 흑백 그림 세상에 그림이 네 가지뿐이고, 모두 같은 비율로 나온다: 왼쪽 세로 획, 오른쪽 세로 획, 위 가로 획, 아래 가로 획(획이 지나는 칸은 1, 나머지는 0). 칸 일부를 가리고, 제곱 오차를 가장 작게 하는 디노이저로 가린 그림을 되살린다. (가) 왼쪽 위 칸만 보이고 그 값이 1이면 디노이저는 무엇을 내놓는가? (나) 그 그림은 네 가지 그림 가운데 하나인가? (다) 두 칸만 보여 준다면, 어느 두 칸을 보여 줘야 언제나 그림 하나로 정해지는가?
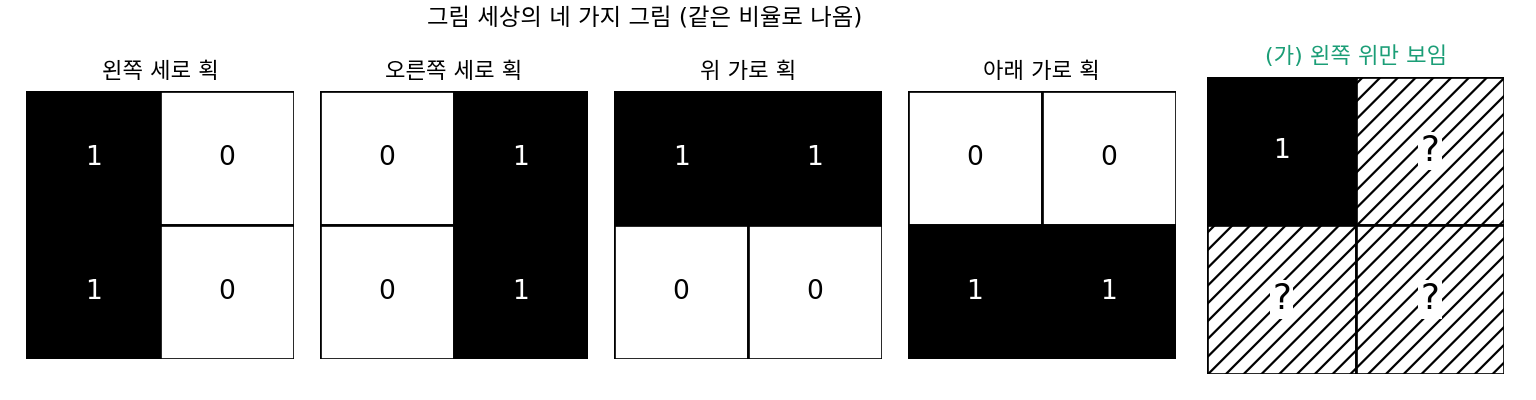
왼쪽 위가 1인 그림은 왼쪽 세로 획과 위 가로 획 둘이에요. 둘의 평균이니까 왼쪽 위 1, 오른쪽 위 0.5, 왼쪽 아래 0.5, 오른쪽 아래 0이에요.
그럼 (나)는 아니네요. 0.5인 칸이 둘이나 있는 그림은 세상에 없어요. 그래도 디노이저가 틀린 건 아니죠? 시킨 대로 평균을 낸 거니까.
맞아요. (다)는 어때요? 보여 줄 두 칸을 아무렇게나 골라도 될까요?
왼쪽 위랑 오른쪽 아래를 보여 주면… 왼쪽 세로 획도 위 가로 획도 (1, 0)이 나와요. 이 쌍은 안 되네요.
같은 줄이나 같은 칸에 있는 두 칸이면 네 그림이 모두 다르게 보여. 대각선으로 마주 본 두 칸만 안 돼. 가린 칸 수만이 아니라 어디를 가렸는지가 남는 후보 수를 정하는구나.
문제 8. 망가진 정도를 잘못 알고 고치면
위의 MNIST 실험에서 σ = 0.25 로만 학습한 디노이저와 σ = 1 로만 학습한 디노이저를 서로 바꿔 써 본다. 시험 그림 한 장의 제곱 오차 합 평균은 아래와 같다(고치지 않으면 784σ², 곧 σ = 0.25 에서 49, σ = 1 에서 784).
σ = 0.25 그림을 고침 σ = 1 그림을 고침 σ = 0.25 로 배운 디노이저 3.61 34.73 σ = 1 로 배운 디노이저 9.52 16.86 (가) 어느 쪽으로 잘못 쓰든 오차가 두 배 넘게 커진다. 그래도 고치지 않는 것보다는 나은가? (나) 두 실수는 고친 그림에서 각각 어떻게 다르게 보일까? (다) 사진 앱이라면 이 문제를 어떻게 풀겠는가?
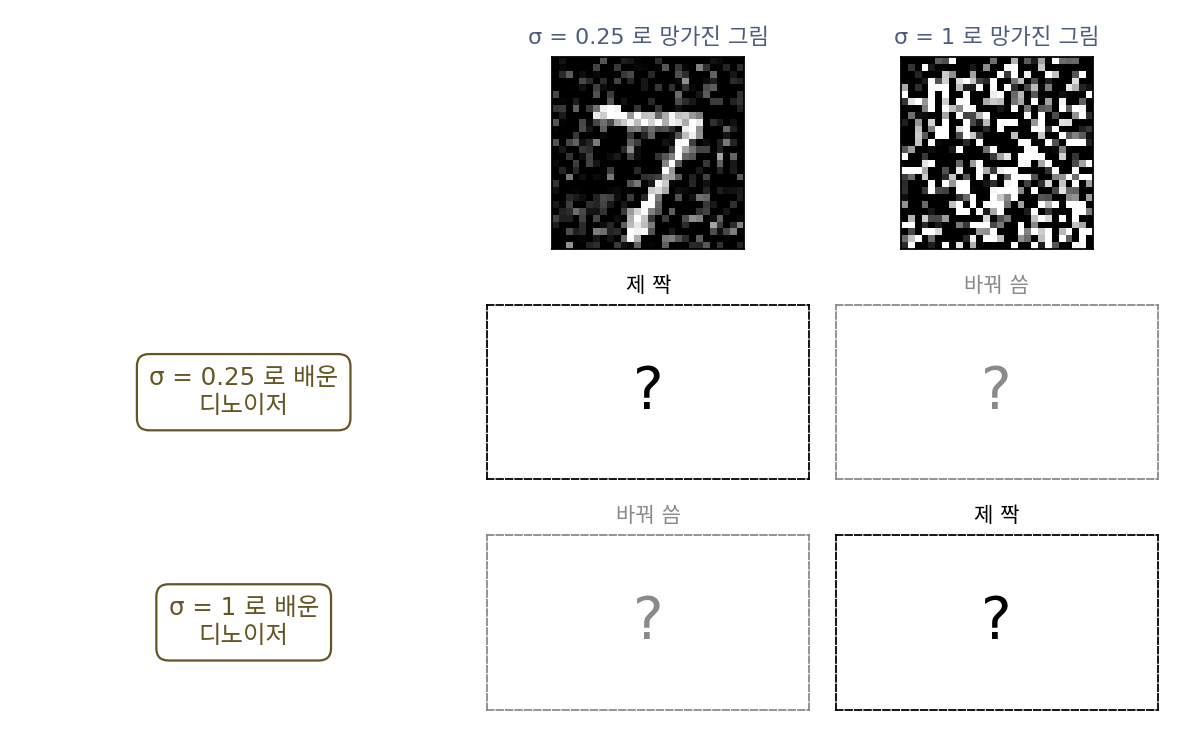
(가)는 쉬워요. 9.52는 49보다, 34.73은 784보다 훨씬 작으니까 잘못 써도 고치긴 하네요.
(나)를 보려면 고친 그림을 재 봐야 해요. 회색 칸 비율은 σ = 0.25 그림을 제 디노이저로 고치면 6.3%, σ = 1 디노이저로 고치면 10.0%예요. 거꾸로 σ = 1 그림을 σ = 0.25 디노이저로 고치면, 원래 바탕이던 칸의 밝기가 평균 0.050으로 제 디노이저(0.023)의 두 배가 넘어요.
σ = 1 디노이저는 「많이 망가졌을 것」이라고 믿으니까 조금 흔들린 그림도 후보를 넓게 잡아 평균을 내. 그래서 멀쩡한 획까지 흐려. 반대로 σ = 0.25 디노이저는 「조금만 흔들렸을 것」이라고 믿으니까 큰 노이즈를 획으로 착각하고 남겨 둬. 바탕에 얼룩이 남는 거고.
그럼 σ 마다 디노이저를 하나씩 만들어야 해요? σ 가 0.01부터 4까지면 몇 개를 만들어야 하죠?
(다)를 다시 봐요. 사진 앱은 디노이저를 수백 개 들고 다닐까요?
사진 앱에는 「노이즈 제거 강도」 슬라이더가 있어요! 디노이저 하나에 강도를 숫자로 알려 주는 거네요. 우리도 σ 를 입력으로 같이 넣으면 되겠다.