오토인코더: 줄였다 되살리며 배우는 신경망
이 장의 물음
라벨 「3」은 그림의 분산 가운데 21%만 정했다. 획이 어디를 지나는지, 얼마나 기울었는지, 얼마나 굵은지 같은 나머지 79%의 분산은 라벨 곁에 다른 값이 함께 들어가야 고를 수 있다. 그런데 획의 생김새를 적은 값을 학습 그림마다 붙여 준 사람은 없다. 라벨은 사람이 하나하나 붙였지만, 6만 장의 획 생김새를 숫자로 적어 줄 사람은 없다. 사람이 적어 주지 못한다면, 생김새를 적은 값은 그림 자신에게서 얻을 수밖에 없다.
휴대폰 사진 앱에는 사진 속 지나가는 사람을 손가락으로 문지르면 지우고, 그 자리를 뒤의 배경으로 채워 주는 기능이 있다. 오래된 가족사진의 긁힌 자국을 메워 주는 서비스도 있는데, 이런 「고치기」를 가르치는 일은 의외로 쉽다. 멀쩡한 사진에 일부러 흠집을 내면, 흠집 난 사진과 고쳐야 할 정답(원래 사진)이 한꺼번에 생긴다. 그림을 숫자 몇 개로 줄이는 솜씨와 망가진 그림을 고치는 솜씨는 어떻게 배우고, 배운 뒤에는 어디에 쓸 수 있을까? 이 장은 다음 물음을 차례로 따라간다.
- 획의 생김새를 적은 값을, 사람 손을 빌리지 않고 그림 자신에게서 얻을 수 있을까?
- 사진을 알아보는 분류기는 합성곱 층과 최대 풀링 층으로 그림을 줄인다. 가장 큰 값 하나를 고르는 층도 미분할 수 있을까? 분류기를 뒤집어 디코더를 만들면, 버려진 칸에는 무엇을 채우고 학습 신호는 어디로 흘러야 할까?
- 일부러 망가뜨린 그림을 되살리도록 배운 신경망은 무엇을 배울까? 많이 망가뜨릴수록 되살린 그림은 어떻게 될까? 얼마나 망가졌는지를 함께 알려 주면 고치는 솜씨가 달라질까?
- 그림을 줄이고 고칠 줄 아는 신경망은 새 그림을 만들지 않고도 어디에 쓸 수 있을까?
오토인코더: 그림 자신을 정답으로 삼기
라벨을 넣은 MLP가 평균을 그린 것은, 같은 라벨 아래 6,131가지 3이 있을 만큼 라벨 「3」이 그림을 정하기에 너무 적은 정보라서였다. 그렇다면 입력에 정보를 더 주면 어떨까? 획의 기울기, 굵기, 고리의 크기까지 알려 주면 정답은 점점 하나로 좁아지고, 끝까지 가면 입력이 그림 자체가 된다. 그림을 넣고 같은 그림을 맞히라면 정답은 정확히 하나다. 그대로 두면 받은 것을 그대로 내보내는 지루한 함수가 되지만, 가운데를 좁은 목으로 조이면 이야기가 달라진다. 그림이 좁은 목을 지나려면 숫자 몇 개로 줄어야 한다. 좁은 목을 지나는 숫자 몇 개가, 아무도 붙여 주지 않은 생김새의 값 노릇을 할 수 있을까?
역사: 주성분 분석의 손을 떠나
그림처럼 칸이 많은 데이터를 몇 개의 숫자로 줄이는 일은 오래전부터 주성분 분석(PCA)이 맡았다. 데이터가 가장 크게 퍼진 방향 몇 개를 찾아, 그 방향의 좌표만 남기는 방법이다. 줄이는 법이 직선(선형)이라 계산은 깔끔하지만, 손글씨처럼 굽은 모양의 차이는 잘 담지 못한다.
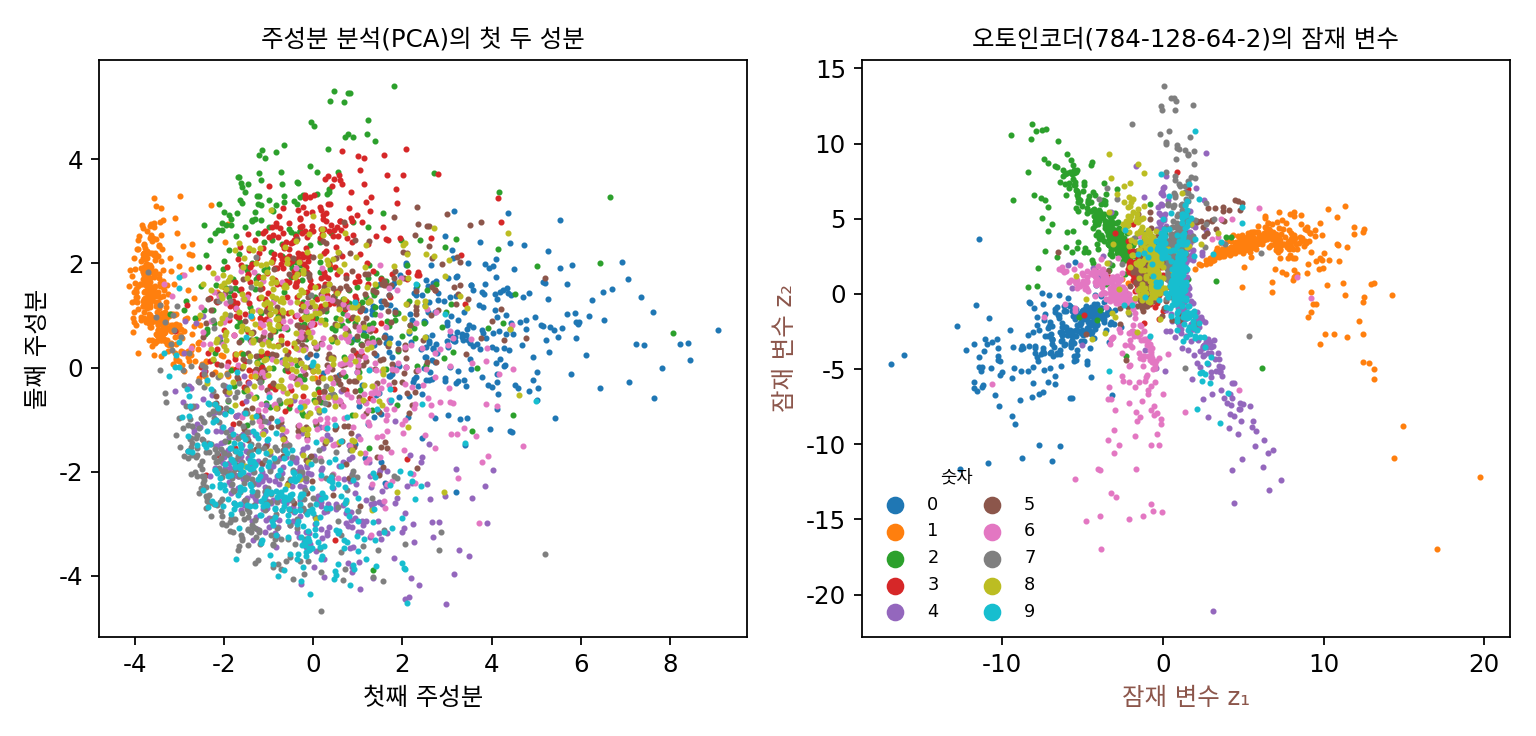
신경망으로 줄였다 되살리는 생각은 그 전에도 있었지만, 층이 많은 신경망은 잘 학습되지 않았다. 힌턴(Geoffrey Hinton)과 살라후트디노프(Ruslan Salakhutdinov)는 2006년 《사이언스》 논문에서 그 어려움을 이렇게 적었다. 처음 가중치가 크면 손실이 나쁜 극소점에 빠지고, 작으면 앞쪽 층의 그래디언트가 너무 작아 학습이 되지 않는다. 무작위로 그린 곡선 그림을 784-400-200-100-50-25-6 신경망으로 줄였다 되살리게 했더니, 미리 학습 없이 바로 학습시킨 신경망은 오래 다듬어도 「언제나 학습 데이터의 평균을 되살렸다」고 한다. 두 사람은 층을 하나씩 미리 학습시켜 좋은 출발점을 만든 뒤 전체를 역전파로 다듬었고, 784-1000-500-250-30 신경망이 MNIST 그림을 30개의 숫자로 줄였다가 PCA보다 훨씬 잘 되살렸다. 가운데를 2칸으로 줄인 신경망의 숫자 두 개를 평면에 찍자 같은 숫자의 점들이 각각 무리를 지어 갈라져, PCA의 첫 두 성분보다 뚜렷한 지도가 나왔다.
이 장의 신경망은 층이 몇 개 안 되고 ReLU 와 Adam 옵티마이저를 써서, 미리 학습 없이 처음부터 바로 학습했다.
층 몇 개 쌓고 역전파를 돌리면 되는 거잖아요. 이 장의 모델도 그렇게 바로 학습했고요. 2006년에는 그게 왜 《사이언스》에 실릴 일이었어요?
그때 신경망의 뉴런은 대개 시그모이드였어요. 시그모이드의 미분은 가장 커도 0.25예요. 역전파로 층을 하나 거슬러 올라갈 때마다 그래디언트에 0.25 이하의 수가 곱해지면 어떻게 될까요?
음, 0.25를 거듭 곱하면… 층이 여섯이면 0.25⁶이라 4,000분의 1도 안 남아요. 가중치까지 작으면 더 줄고요. 앞쪽 층이 거의 못 배웠겠네요.
그럼 처음 가중치를 크게 잡으면 되잖아. 아, 본문에 크면 나쁜 극소점에 빠진다고 했지. 크게 잡아도 작게 잡아도 막혀 있었네.
그 사이를 고를 처방이 그때는 없었어요. 층의 크기에 맞춰 처음 가중치의 크기를 정하는 규칙은 2010년, 깊은 신경망에 ReLU 를 쓰자는 논문은 2011년, Adam 옵티마이저는 2014년에 나왔어요. 이 장의 모델이 쓴 ReLU 와 Adam 은 둘 다 힌턴과 살라후트디노프의 논문보다 늦게 나왔어요.
그래서 한 층씩 미리 학습시키는 방법으로 돌아간 거군요. 출발점을 잡아 줄 도구가 없으니 출발점을 직접 만들어 준 거네요.
미리 학습 없이 바로 학습시킨 신경망은 언제나 학습 데이터의 평균을 되살렸다고 했잖아요. 평균 그림 하나 대신 그림마다 다른 그림을 되살리려면, 가운데 좁은 칸을 지나는 숫자 몇 개에 무엇이 담겨야 해요?
줄였다 되살리기
784칸 그림을 받아 784 → 128 → 64 → 2로 줄이는 MLP와, 2칸을 받아 2 → 64 → 128 → 784로 키우는 MLP를 이어 붙인다. 앞쪽을 인코더 (그림을 짧은 숫자로 바꾸는 신경망 / encoder), 뒤쪽을 디코더 (숫자를 그림으로 되돌리는 신경망 / decoder)라 부른다. 둘을 하나로 묶어 입력 그림과 출력 그림의 제곱 오차를 줄이도록 함께 학습한다. 가운데 2칸은 잠재 변수 (그림을 정하는 숨은 값 / latent variable)라 한다. 그림에 직접 보이지는 않지만 그림을 정하는 값이라는 뜻이다. 논문에서는 코드(code)라고도 부르는데, 프로그램 코드와 섞이므로 이 책은 잠재 변수라고 쓴다.
이렇게 그림을 숫자 몇 개로 줄였다가 자기 자신으로 되살리도록 배우는 신경망을 오토인코더 (줄였다 되살리는 신경망 / autoencoder)라 한다. 앞머리 auto- 는 「자동」보다 「자기 자신」이라는 뜻이다. 따로 붙인 정답 없이 입력 그림 자기 자신을 정답으로 삼아, 입력을 자기 자신으로 되살리도록 배운다는 이름이다.
시험 그림에서 제곱 오차(784칸 합)를 재면, 학습 그림의 평균 그림 하나로 모든 그림을 대신했을 때 52.90, 잠재 변수가 2칸인 오토인코더는 30.09, 16칸이면 8.87이다. 숫자 두 개만으로도 평균 그림보다 43% 적게 틀린다. 위 그림의 오른쪽에 있는 2칸짜리 잠재 변수의 지도를 보면 같은 숫자의 잠재 변수는 한 무리로 모였고, 숫자별 무리들은 원점에서 사방으로 뻗었다. 가로는 −19.0 ~ 24.4, 세로는 −25.5 ~ 16.5까지 퍼져 있다.
ML에서: 줄인 칸에서 일하기
오토인코더의 잠재 변수는 그림보다 훨씬 짧은데도 그림을 되살릴 만큼의 정보를 담는다. 그래서 큰 그림을 다루는 모델들은 계산을 그림 대신 이런 줄인 칸에서 하고, 마지막에만 디코더로 그림을 되살리곤 한다. 오늘의 그림 생성 모델도 이 방식을 쓰는데, 그때 쓰는 압축기도 오토인코더의 후손이다.
문제 1. 단체 티셔츠 주문
동아리 단체 티셔츠를 맞춘다. 가게는 사이즈 번호 하나(1 = S, 2 = M, 3 = L, 4 = XL)만 받고, 번호마다 가슴둘레와 총장(cm)이 표로 정해져 있다: S (96, 68), M (100, 70), L (104, 72), XL (108, 74). 부원의 몸에 맞는 치수가 (101, 73)이다. (가) 이 부원의 치수를 번호 하나로 줄여 전하고 가게가 표대로 되살리면, 번호마다 두 치수의 제곱 오차 합은 얼마인가? 어느 번호를 골라야 하는가? (나) 가게에 「2.5번」이라고 전하면 무엇을 받는가?
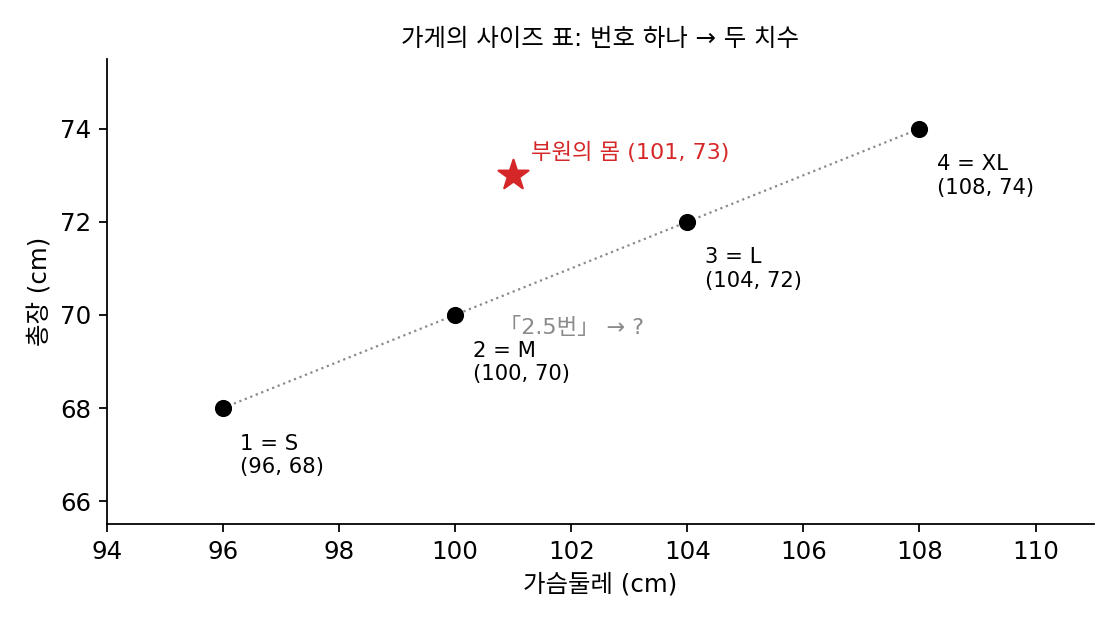
번호마다 제곱 오차 합을 계산해 봤어요. S는 5² + 5² = 50, M은 1² + 3² = 10, L은 3² + 1² = 10, XL은 7² + 1² = 50이에요. M과 L이 똑같이 10이네요. 가슴은 M이 맞고 총장은 L이 맞아서요.
어느 번호를 골라도 10은 남네요. 왜 0이 될 수 없을까요?
숫자 두 개를 하나로 줄였으니 어딘가는 잃어요. 표는 가슴과 총장이 같이 커지는 사람에 맞춰져 있어서, 가슴은 작은데 키가 큰 사람은 어느 번호로도 정확히 못 돌아와요.
(나)는요?
2.5는 2와 3의 한가운데니까, M (100, 70)과 L (104, 72)의 한가운데 (102, 71)이 오겠죠. 그러면 오차가 1² + 2² = 5라서 M이나 L보다도 좋아요.
가게가 그렇게 해 준다면 그렇지. 그런데 코드로 치면 이 표는 번호를 열쇠로 치수를 꺼내는 사전이잖아. 사전에 2.5를 넣으면 한가운데 값이 아니라 「그런 열쇠 없음」 오류가 나.
가게가 표에 없는 번호를 받으면 무엇을 줄지, 표 어디에 적혀 있어요?
어디에도 없네요. 저는 번호 사이를 직선으로 이어 채운다고 저 혼자 정해 버렸어요. 사이즈는 한 줄로 커지니 그럴듯해 보였을 뿐이고, 표에 없는 번호에 무엇을 줄지는 가게 마음이에요.
오토인코더의 잠재 변수와 디코더가 꼭 이 번호와 표예요. 학습한 그림들의 잠재 변수에서는 잘 되살리지만, 아무도 쓴 적 없는 잠재 변수를 넣으면 무엇이 나올지는 학습이 정해 주지 않았어요.
문제 2. 잠재 변수를 열 배로 늘려도
잠재 변수가 2칸인 오토인코더에서, 인코더의 마지막 층 출력에 10을 곱하고 디코더의 첫 층 가중치를 10으로 나눈다(바이어스는 그대로). (가) 되살린 그림은 바뀌는가? (나) 잠재 변수 지도는 어떻게 바뀌는가? (다) 「잠재 변수 (1, 1)을 넣으면 무엇이 나오나」라는 물음에는 학습 전에 답이 정해져 있었는가?
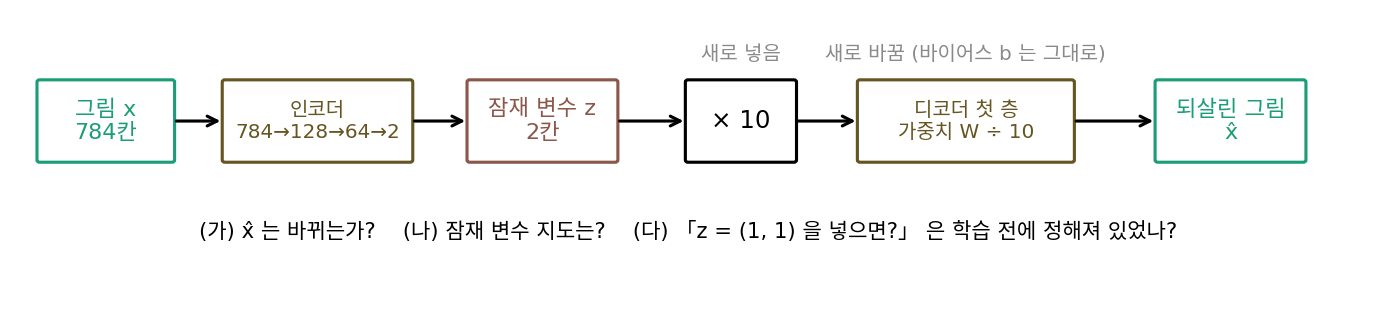
디코더 첫 층은 Wz + b니까 (W/10)(10z) + b = Wz + b예요. 첫 층의 출력이 같고 뒤는 그대로니까 되살린 그림도 똑같아요.
코드로 해 봤어요. 시험 그림 만 장을 되살린 밝기가 원래와 가장 크게 달라도 1.8 × 10⁻⁶이에요. 컴퓨터 반올림만큼이요. 손실도 똑같고요.
그럼 지도는요?
열 배로 커져요. 가로가 −190부터 244까지요. 그런데 손실이 똑같으니까 학습은 둘 중 어느 쪽이 더 좋다고 할 수 없겠네요.
늘리기뿐 아니라 돌리거나 굽혀도 마찬가지야. 인코더 끝에 거꾸로 되돌릴 수 있는 변환을 아무거나 넣고 디코더 앞에 그 반대를 넣으면 손실이 그대로니까. 손실은 「잠재 변수에서 그림으로 돌아올 수 있는가」만 보지, 「잠재 변수가 어디에 놓이는가」는 전혀 보지 않아.
그래서 (다)의 답은 「아니요」예요. 잠재 변수 (1, 1)은 어떤 모델에서는 한 숫자의 무리 한가운데고, 어떤 모델에서는 학습 그림이 하나도 없는 들판이에요.