조건의 방향: p(a∣b) 와 p(b∣a) 는 다른 분포다
사진첩에서 「고양이 사진의 80%가 실내」였다. 이 말을 친구에게 「실내 사진이면 80%는 고양이래」라고 옮기면 틀린다. 실제로는 62%였다. 조건을 뒤집은 두 값이 이 정도 차이면 큰일이 아니다. 그런데 한쪽 무리가 아주 작으면 두 값은 몇 배씩 벌어진다. 병원 검사가 그런 경우다.
역사: 「7,300만 분의 1」
1999년 영국에서 샐리 클라크(Sally Clark)가 두 아들을 살해한 혐의로 유죄 판결을 받았다. 두 아이는 영아 돌연사로 숨졌다고 주장되었다. 소아과 의사 로이 메도(Roy Meadow)는 법정에서 담배를 피우지 않는 넉넉한 가정에서 영아 돌연사가 두 번 일어날 확률이 7,300만 분의 1이라고 증언했다. 이 숫자는 「죄가 없다면 이런 일이 일어날 확률」이다. 그런데 배심원이 알고 싶었던 것은 「이런 일이 일어났을 때 죄가 없을 확률」이고, 두 값은 조건의 방향이 반대다. 영국 왕립통계학회는 2001년 공개 성명으로 이 숫자의 계산과 쓰임을 비판했다. 두 사건이 서로 상관없다고 보고 확률을 곱한 것도 문제였고, 조건을 뒤집어 읽게 만든 것도 문제였다. 클라크의 판결은 2003년 항소심에서 뒤집혔다. 이렇게 조건을 뒤집어 읽는 실수는 「검사의 오류(prosecutor’s fallacy)」라는 이름까지 얻었다.
조건을 바르게 뒤집는 계산은 훨씬 오래되었다. 영국 목사 토머스 베이즈(Thomas Bayes)가 남긴 글을 리처드 프라이스(Richard Price)가 다듬어 1763년 왕립학회에 보냈고, 프랑스의 라플라스(Pierre-Simon Laplace)는 1774년에 따로 같은 생각에 닿아 「결과로부터 원인의 확률」을 구하는 문제로 넓혔다.
1만 명으로 세어 보기
어떤 병에 걸린 사람이 100명에 1명꼴이라고 하자. 검사는 병이 있는 사람의 90%에게 양성을, 병이 없는 사람의 5%에게도 양성을 낸다. 한 사람이 양성을 받았다면 실제로 병이 있을 확률은 얼마일까? 1만 명으로 세면 환자 100명 가운데 90명, 환자가 아닌 9,900명 가운데 495명이 양성이다. 양성 585명 가운데 환자는 90명이니 15.4%다.
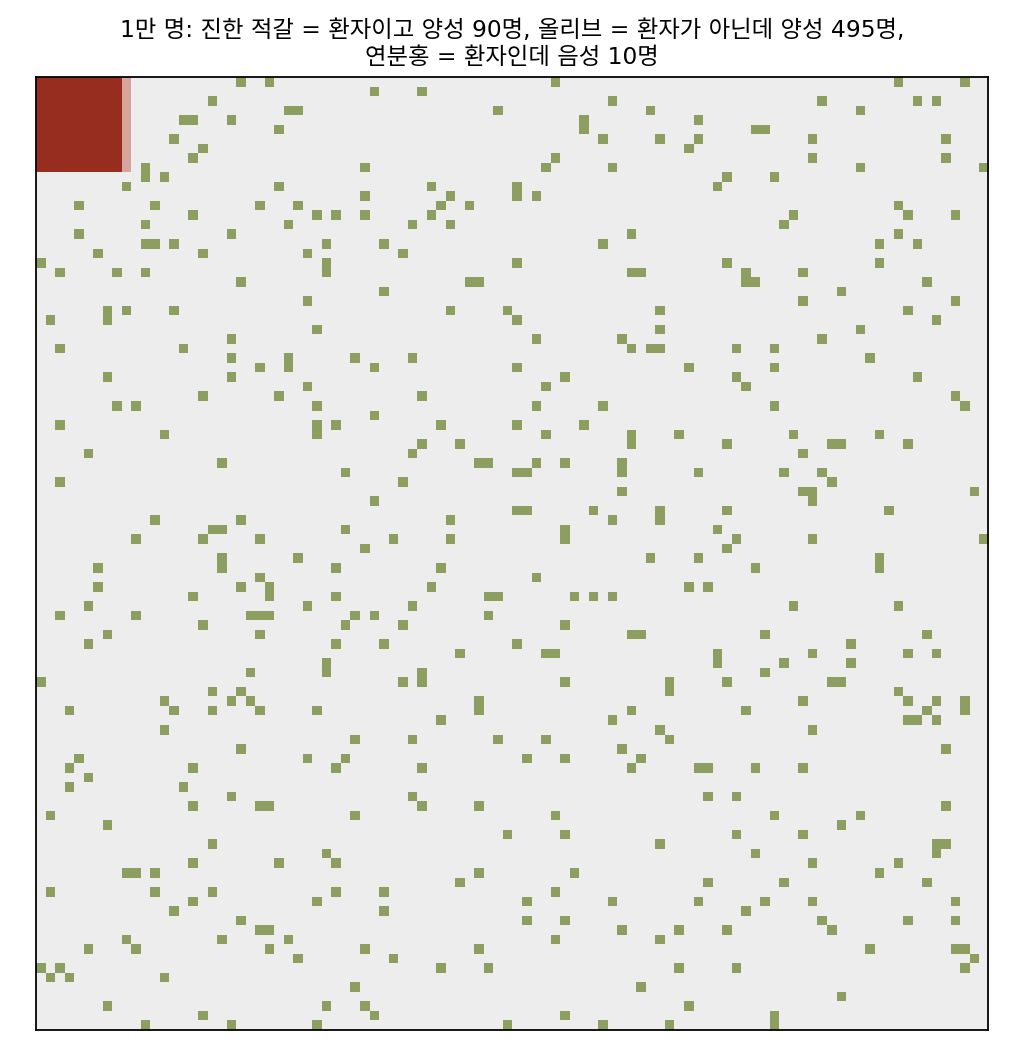
검사 회사가 내세우는 90%는 p(양성 ∣ 병)이다. 양성을 받은 사람이 궁금한 것은 p(병 ∣ 양성)이고, 그 값은 15.4%다. 두 값이 여섯 배 가까이 벌어진 까닭은 그림에서 보인다. 환자 무리는 작고 환자가 아닌 무리는 크다. 큰 무리의 5%(495명)가 작은 무리의 90%(90명)보다 많다.
베이즈 정리: 무리의 크기를 곱해 뒤집기
1만 명으로 센 계산을 식으로 적으면 이렇다. 결합 확률을 두 방향으로 쪼갤 수 있다는 것, p(a, b) = p(a ∣ b) p(b) = p(b ∣ a) p(a) 에서 나온다.
이 식을 베이즈 정리 (조건의 방향을 뒤집는 식 / Bayes’ theorem)라 한다. 뒤집으려면 p(b ∣ a)만으로는 모자라고 무리의 크기 p(a)를 곱해야 한다. 「7,300만 분의 1」에는 이 곱셈이 빠져 있었다.
보기 전의 1%를 사전확률, 본 뒤의 15.4%를 사후확률이라 한다. 확률이 값 하나가 아니라 여러 값에 걸친 분포이면 사전분포, 사후분포라 한다. 「사전」과 「사후」는 시간의 앞뒤가 아니라 관측(여기서는 검사 결과)을 보기 전과 본 뒤를 뜻한다.
ML에서: 학습 때와 쓸 때 라벨 비율이 다르면
분류기의 출력 p(y ∣ x)에도 학습 데이터의 라벨 비율 p(y)가 곱해져 들어 있다. 베이즈 정리의 분자에 p(a)가 있었던 것과 같다. 그래서 고양이와 강아지를 반반 섞어 학습한 분류기를 고양이가 드문 곳에 그대로 쓰면, 고양이 쪽 확률을 실제보다 높게 말한다. 의료 영상처럼 학습 데이터의 비율과 실제 환자 비율이 크게 다른 분야에서 출력 확률을 그대로 믿지 않고 비율을 다시 맞추는 까닭이다.
문제 4. 우산을 든 사람
어느 도시는 비 오는 날이 20%다. 비 오는 날에는 사람들의 90%가 우산을 들고, 맑은 날에도 10%는 양산 삼아 우산을 든다. (가) 길에서 우산 든 사람을 봤다. 오늘 비가 올 확률은? (나) 장마철이라 비 오는 날이 50%라면?
비 오는 날 90%가 우산을 드니까, 우산을 봤으면 90% 아니에요?
그 90%는 무엇을 안다고 보고 잰 값이에요?
비가 온다는 걸 알 때요. p(우산 ∣ 비)네요. 묻는 건 p(비 ∣ 우산)인데.
100일로 세면 비 오는 20일 동안 우산 비율 90%, 맑은 80일 동안 10%야. 우산을 든 날의 비중은 18 + 8 = 26이고 그 가운데 비 오는 날이 18이니 0.692.
(나)는요?
50일, 50일이면 45 대 5니까 0.9야. 비 오는 날이 흔해지니까 이번엔 우연히 90%와 같아졌네.
사전확률이 바뀌면 같은 우산을 봐도 결론이 달라지는 거군요. 우산 비율 90%는 그대로인데.
조교님이 「밤새운 사람은 다 눈이 빨개」라고 했다고, 눈 빨간 사람을 다 밤새운 사람으로 보면 안 되는 거랑 같아요. 알레르기인 사람이 훨씬 많을 수도 있고요.
문제 5. 검사를 두 번 받으면
어떤 병의 유병률이 2%이고, 검사는 환자의 95%에게, 환자가 아닌 사람의 10%에게 양성을 낸다. (가) 한 번 양성이 나온 사람이 환자일 확률은? (나) 같은 검사를 다시 받아 또 양성이 나왔다(두 검사의 결과는 병이 있고 없음이 정해지면 서로 상관없다고 하자). 이제 환자일 확률은?
(가)는 본문처럼 세면 돼요. 1만 명 가운데 환자 200명 중 190명, 아닌 9,800명 중 980명이 양성이니 190 ÷ 1,170 = 16.2%예요.
(나)는 처음부터 다시 세야 하나? 두 번 다 양성인 사람은 환자 중 0.95², 아닌 사람 중 0.1²이니까… 0.02 × 0.9025 ÷ (0.02 × 0.9025 + 0.98 × 0.01) = 64.8%야.
첫 검사 뒤의 16.2%를 출발점으로 두고 한 번만 더 세어 봐요.
0.1624 × 0.95 ÷ (0.1624 × 0.95 + 0.8376 × 0.1) = 64.8%. 똑같네요! 첫 검사의 사후확률이 둘째 검사의 사전확률이 됐어요.
그러니까 「사후」는 시간상 나중이라는 뜻이 아니구나. 어떤 관측을 기준으로 그걸 보기 전이냐 본 뒤냐야. 같은 16.2%가 첫 검사에는 사후, 둘째 검사에는 사전이고.
일기예보 「내일 비 올 확률 30%」가 아침 하늘을 보고 70%로 바뀌는 거네요. 아침에 본 하늘이 관측이고요.
문제 6. 반반으로 배운 분류기
고양이·강아지 사진을 반반 섞어 학습한 분류기가 있다. 이 분류기를 고양이 사진이 10%뿐인 사진첩에 쓴다. 사진 한 장에 분류기가 p(고양이 ∣ 사진) = 0.8 을 냈다. (가) 이 사진첩에서 이 사진이 고양이일 확률은 얼마로 고쳐야 하는가? 분류기가 사진을 보는 눈, 곧 p(x ∣ y)는 두 사진첩에서 같다고 하자. (나) 분류기가 0.5를 낸 사진은?
분류기는 사진을 보고 낸 값이니까 사진첩이 바뀌어도 0.8 그대로 아니에요?
분류기가 학습한 데이터에서 고양이 비율은 얼마였어요?
50%요. 아, 출력 안에 그 50%가 사전확률로 들어가 있는 거네요.
베이즈 정리로 보면 출력은 p(x ∣ 고양이) × 0.5 대 p(x ∣ 강아지) × 0.5 의 비율이야. 사진을 보는 눈이 같다면 두 밀도의 비는 0.8 : 0.2 = 4 : 1 로 그대로고, 앞의 무게만 0.1 대 0.9로 바꾸면 돼. 4 × 0.1 대 1 × 0.9, 곧 0.4 대 0.9 니까 0.4 ÷ 1.3 = 0.308.
(나)도 같은 방법으로 해 봐요.
두 밀도의 비가 1 : 1 이니까 0.1 대 0.9, 곧 0.1이요. 분류기가 반반이라고 한 사진은 이 사진첩에서는 고양이일 확률이 사진첩의 고양이 비율 그대로네요. 사진이 아무것도 말해 주지 않은 셈이고요.
밀도의 비는 사진이 알려 준 것, 앞의 무게는 사진을 보기 전에 알던 것. 분류기 출력은 둘을 곱해 놓은 거라서, 앞의 무게가 바뀌면 다시 곱해야 하는구나.
선형대수에서 기저를 바꾸면 성분이 바뀌어도 벡터는 그대로인 것처럼, 사진이 주는 정보는 그대로이고 그걸 읽는 출발점만 바뀐 거야.