조건의 방향: p(a∣b) 와 p(b∣a) 는 다른 분포다
사진첩에서 「고양이 사진의 80%가 실내」였는데, 이 말을 친구에게 「실내 사진이면 80%는 고양이래」라고 옮기면 틀린다. 실제로는 62%였지만, 조건을 뒤집은 두 값이 이 정도 차이면 큰일이 아니다. 그런데 조건으로 세운 한쪽 집단(예: 환자)이 아주 작으면 두 값은 몇 배씩 벌어진다. 병원 검사가 그런 경우다.
역사: 「7,300만 분의 1」
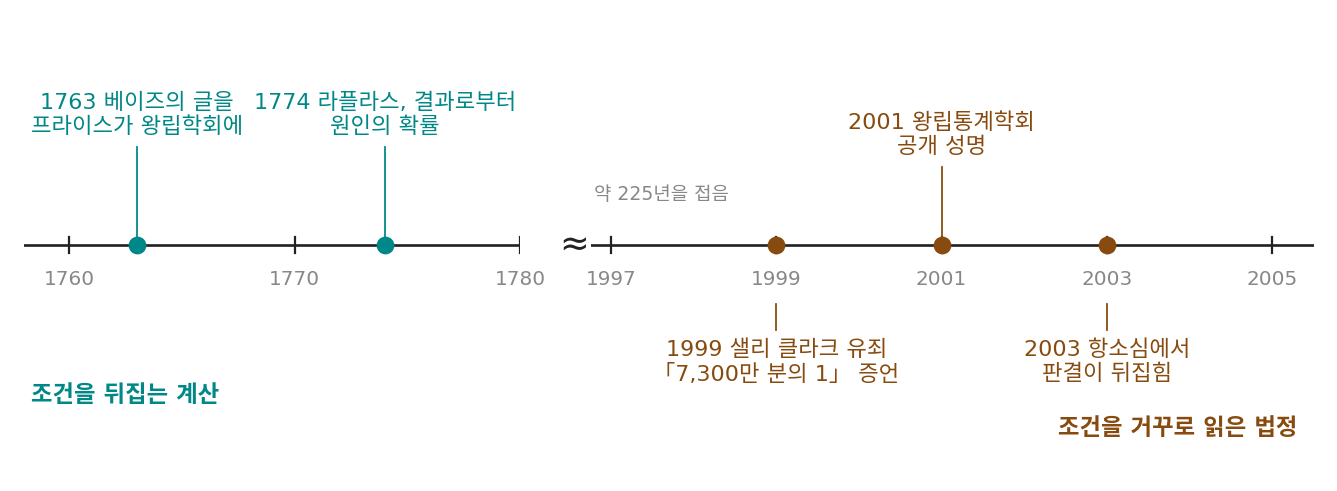
1999년 영국에서 샐리 클라크(Sally Clark)가 두 아들을 살해한 혐의로 유죄 판결을 받았다. 두 아이는 영아 돌연사로 숨졌다고 주장되었다. 소아과 의사 로이 메도(Roy Meadow)는 법정에서 담배를 피우지 않는 넉넉한 가정에서 영아 돌연사가 두 번 일어날 확률이 7,300만 분의 1이라고 증언했다. 이 숫자는 「죄가 없다면 이런 일이 일어날 확률」이다. 그런데 배심원이 알고 싶었던 것은 「이런 일이 일어났을 때 죄가 없을 확률」이고, 두 값은 조건의 방향이 반대다. 영국 왕립통계학회는 2001년 공개 성명으로 「7,300만 분의 1」의 계산과 쓰임을 비판했다. 두 사건이 서로 상관없다고 보고 확률을 곱한 것도 문제였고, 조건을 뒤집어 읽게 만든 것도 문제였다. 클라크의 판결은 2003년 항소심에서 뒤집혔다. 이렇게 조건을 뒤집어 읽는 실수는 「검사의 오류(prosecutor’s fallacy)」라는 이름까지 얻었다.
조건을 바르게 뒤집는 계산은 훨씬 오래되었다. 영국 목사 토머스 베이즈(Thomas Bayes)가 남긴 글을 리처드 프라이스(Richard Price)가 다듬어 1763년 왕립학회에 보냈고, 프랑스의 라플라스(Pierre-Simon Laplace)는 1774년에 따로 같은 생각에 닿아 「결과로부터 원인의 확률」을 구하는 문제로 넓혔다.
조건을 뒤집는 계산이 1763년에 벌써 있었는데 1999년 법정에서 거꾸로 읽었다고요? 이백 년이 넘었는데요.
계산법은 있었어요. 그럼 민준 학생이 그 법정에서 「7,300만 분의 1」을 뒤집어 보려 한다면, 7,300만 분의 1 말고 무엇이 더 있어야 할까요?
7,300만 분의 1은 죄가 없다고 보고 잰 거니까… 반대 방향을 구하려면 다른 쪽 숫자가 하나 더 필요하겠네요.
음, 두 아이가 숨지는 다른 길도 같이 봐야 할 것 같아요. 엄마가 아이 둘을 해치는 일도 아주 드물 테니까, 드문 것끼리 비교해야 하는 거 아니에요?
그래요. 그런데 한 집에서 영아 돌연사가 두 번 일어나는 일도, 아이 둘이 살해되는 일도 아주 드물어서, 믿을 만한 비율을 얻으려면 아주 많은 가정을 오래 지켜본 기록이 있어야 해요. 증언대에 선 사람이 법정에서 바로 셀 수 있는 숫자가 아니죠.
잠깐, 7,300만 분의 1도 두 번이 서로 상관없다고 보고 곱한 거라고 했죠. 같은 집 아이들은 사는 환경을 나누니까, 7,300만 분의 1부터 너무 작게 나왔을 수도 있겠네요.
뒤집는 식이 있어도 거기 넣을 숫자가 없거나 틀리면 쓸 수가 없었던 거예요. 그럼 숫자가 다 주어진 쉬운 경우라면, 조건을 뒤집은 두 값은 얼마나 벌어질까요?
1만 명으로 세어 보기
어떤 병에 걸린 사람이 100명에 1명꼴이라고 하자. 검사는 병이 있는 사람의 90%에게 양성을, 병이 없는 사람의 5%에게도 양성을 낸다. 한 사람이 양성을 받았다면 실제로 병이 있을 확률은 얼마일까? 1만 명으로 세면 환자 100명 가운데 90명, 환자가 아닌 9,900명 가운데 495명이 양성이다. 양성 585명 가운데 환자는 90명이니 15.4%다.
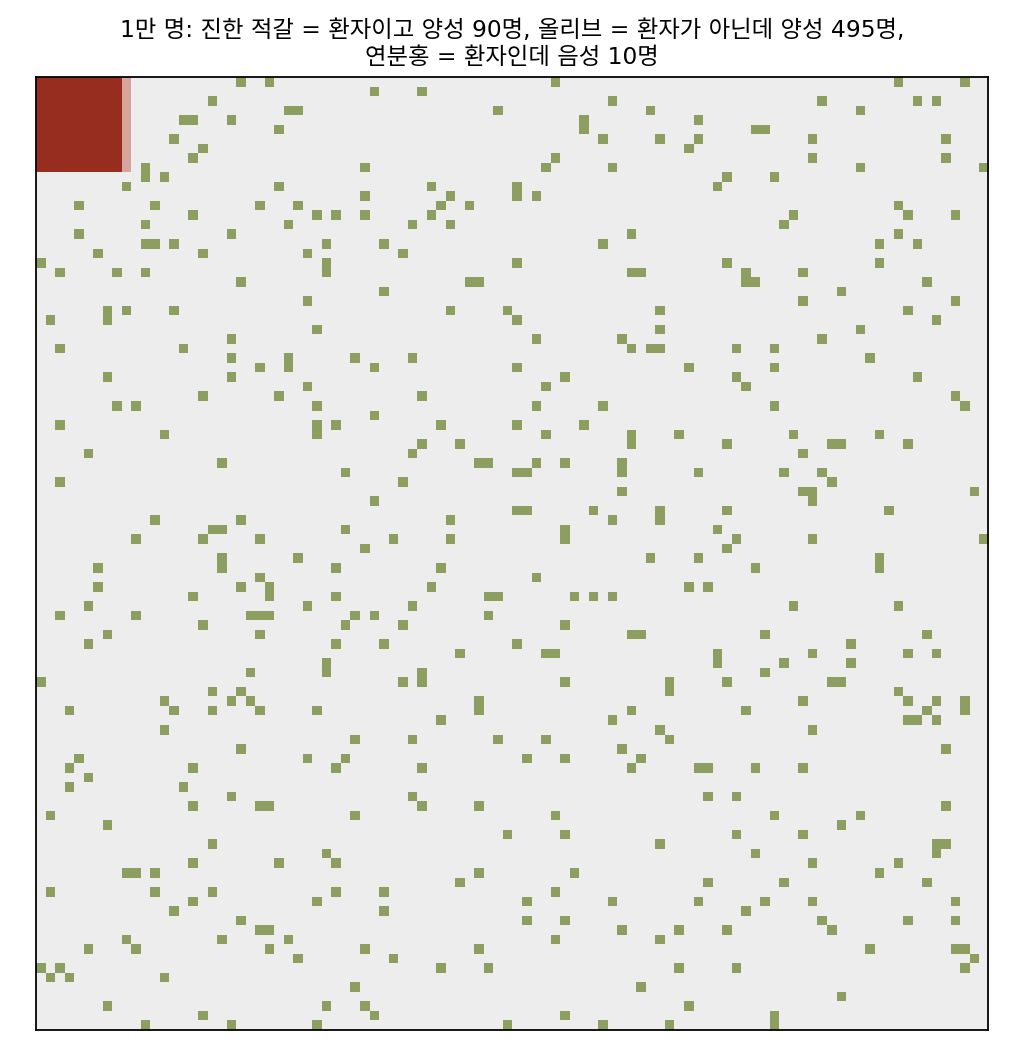
검사 회사가 내세우는 90%는 p(양성 ∣ 병)이지만, 양성을 받은 사람이 궁금한 것은 p(병 ∣ 양성)이고 그 값은 15.4%다. 두 값은 왜 여섯 배 가까이 벌어졌을까? 그림을 보면 환자는 100명으로 적고 환자가 아닌 사람은 9,900명으로 많아서, 환자가 아닌 9,900명의 5%(495명)가 환자 100명의 90%(90명)보다 많다.
베이즈 정리: 원인의 비율을 곱해 조건 뒤집기
1만 명으로 센 계산을 식으로 적으면 이렇다. 결합 확률을 두 방향으로 쪼갤 수 있다는 것, p(a, b) = p(a ∣ b) p(b) = p(b ∣ a) p(a) 에서 나온다.
식 p(a ∣ b) = p(b ∣ a) p(a) ÷ p(b)를 베이즈 정리 (조건의 방향을 뒤집는 식 / Bayes’ theorem)라 한다. 뒤집으려면 p(b ∣ a)만으로는 모자라고 원인의 비율(검사에서는 유병률 0.01) p(a)를 곱해야 한다. 「7,300만 분의 1」에는 이 곱셈이 빠져 있었다. 분모 p(b) = 0.01 × 0.90 + 0.99 × 0.05 = 0.0585는 병이 있는 경우와 없는 경우를 모두 더해 원인을 지운 양성의 주변확률이다.
보기 전의 1%를 사전확률, 본 뒤의 15.4%를 사후확률이라 하고, 확률을 여러 값에 걸친 분포로 적으면 사전분포, 사후분포라 한다. 「사전」과 「사후」는 시간의 앞뒤가 아니라 관측(여기서는 검사 결과)을 보기 전과 본 뒤를 뜻한다.
ML에서: 학습 때와 쓸 때 라벨 비율이 다르면
분류기의 출력 p(y ∣ x)에도 학습 데이터의 라벨 비율 p(y)가 곱해져 들어 있다. 베이즈 정리의 분자에 p(a)가 있었던 것과 같다. 그래서 고양이와 강아지를 반반 섞어 학습한 분류기를 고양이가 드문 곳에 그대로 쓰면, 고양이 쪽 확률을 실제보다 높게 말한다. 의료 영상처럼 학습 데이터의 비율과 실제 환자 비율이 크게 다른 분야에서 출력 확률을 그대로 믿지 않고 비율을 다시 맞추는 것도 이 때문이다.
문제 7. 우산을 든 사람
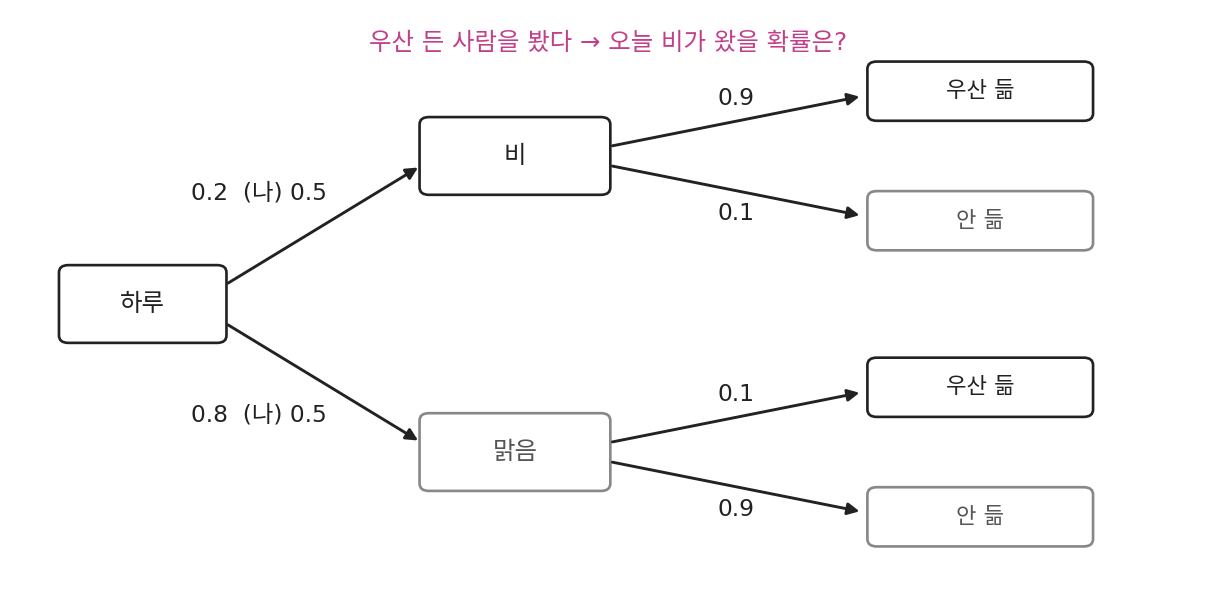
어느 도시는 비 오는 날이 20%다. 비 오는 날에는 사람들의 90%가 우산을 들고, 맑은 날에도 10%는 양산 삼아 우산을 든다. (가) 길에서 우산 든 사람을 봤다. 오늘 비가 올 확률은? (나) 장마철이라 비 오는 날이 50%라면?
비 오는 날 90%가 우산을 드니까, 우산을 봤으면 90% 아니에요?
그 90%는 무엇을 안다고 보고 잰 값이에요?
비가 온다는 걸 알 때요. 그러면 p(우산 ∣ 비)네요. 묻는 건 p(비 ∣ 우산)인데, 둘을 어떻게 잇지.
본문처럼 날수로 세어 보자. 100일이면 비 오는 날이 20일이야.
그 20일 가운데 90%인 18일은 우산을 들고, 맑은 80일 가운데 10%인 8일도 우산을 들어. 우산을 든 날이 26일이고 그중 비 오는 날이 18일이니 0.692.
(나)는요?
50일, 50일이면 45일 대 5일이니까 0.9야. 이번엔 90%와 똑같네.
그럼 민준 학생의 첫 답 90%는 (나)에서는 맞은 거예요?
값만 우연히 같아진 거예요. 비 오는 날과 맑은 날이 같은 무게라 사전확률이 약분되고, 마침 0.9와 0.1을 더하면 1이라서요. 비 오는 날이 20%로 줄면 같은 우산을 봐도 0.692로 내려가요. 우산을 드는 비율은 그대로인데 결론은 사전확률을 따라 움직이네요.
문제 8. 검사를 두 번 받으면
어떤 병의 유병률이 2%이고, 검사는 환자의 95%에게, 환자가 아닌 사람의 10%에게 양성을 낸다. (가) 한 번 양성이 나온 사람이 환자일 확률은? (나) 같은 검사를 다시 받아 또 양성이 나왔다(두 검사의 결과는 병이 있고 없음이 정해지면 서로 상관없다고 하자). 이제 환자일 확률은?
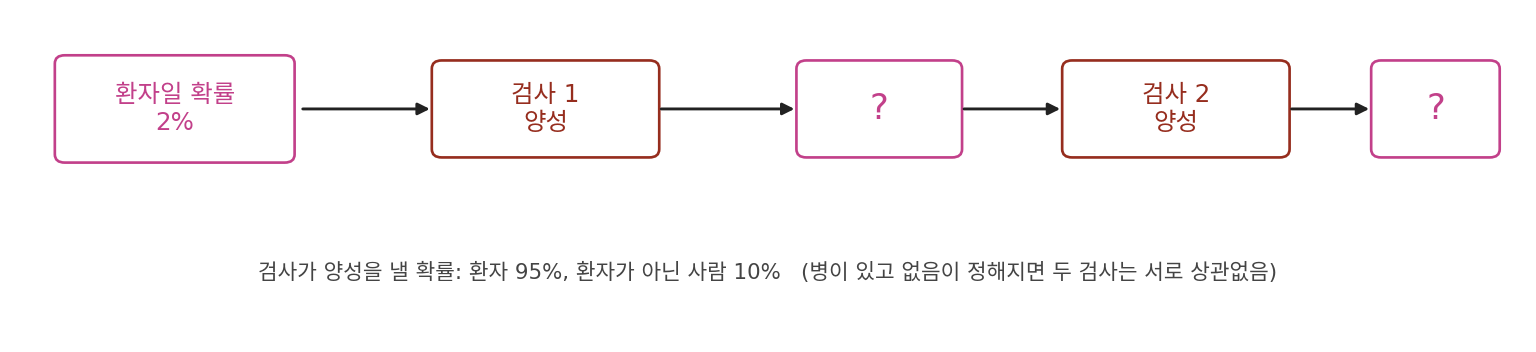
(가)는 본문처럼 1만 명으로 셀게. 환자 200명 가운데 190명, 환자가 아닌 9,800명 가운데 980명이 양성이니 190 ÷ 1,170 = 16.2%.
(나)는 처음부터 다시 세면 되겠다. 두 번 다 양성일 확률이 환자는 0.95², 아닌 사람은 0.1²이니까… 0.02 × 0.9025 ÷ (0.02 × 0.9025 + 0.98 × 0.01) = 64.8%.
다른 길도 있어요. 첫 검사 뒤의 16.2%를 출발점으로 두고 둘째 검사를 한 번만 더 세어 볼래요?
유병률 자리에 0.1624를 넣으라는 거죠? 0.1624 × 0.95 ÷ (0.1624 × 0.95 + 0.8376 × 0.1)… 0.1543 ÷ 0.2380 = 64.8%. 같네요.
왜 같을까요? 두 계산에서 곱한 숫자를 늘어놓아 봐요.
음, 제 계산은 0.02에 0.95를 두 번 곱했어요. 서연이는 0.95를 한 번 곱하고 전체로 나눠 16.2%로 정리해 둔 다음, 0.95를 한 번 더 곱했고요. 중간에 나눈 수는 마지막에 다시 나눌 때 약분되니까 결과가 같아요.
두 검사 결과가 서로 상관없다는 조건이 있어서 0.95² 처럼 곱으로 쪼갤 수 있었던 거야. 그 조건이 없으면 둘째 검사에 0.95를 그대로 곱할 수 없겠다.
그래요. 같은 사람이 같은 검사를 다시 받으면 실제로는 두 결과가 얽힐 때가 많아서, 병원에서는 방식이 다른 검사로 확인하는 일이 많아요.
문제 9. 반반으로 배운 분류기
고양이·강아지 사진을 반반 섞어 학습한 분류기를 고양이 사진이 10%뿐인 사진첩에 썼더니, 사진 한 장에 분류기가 p(고양이 ∣ 사진) = 0.8 을 냈다. (가) 이 사진첩에서 이 사진이 고양이일 확률은 얼마로 고쳐야 하는가? 라벨마다의 사진 분포 p(x ∣ y)(분류기가 사진을 보는 눈)는 두 사진첩에서 같다고 하자. (나) 분류기가 0.5를 낸 사진은?
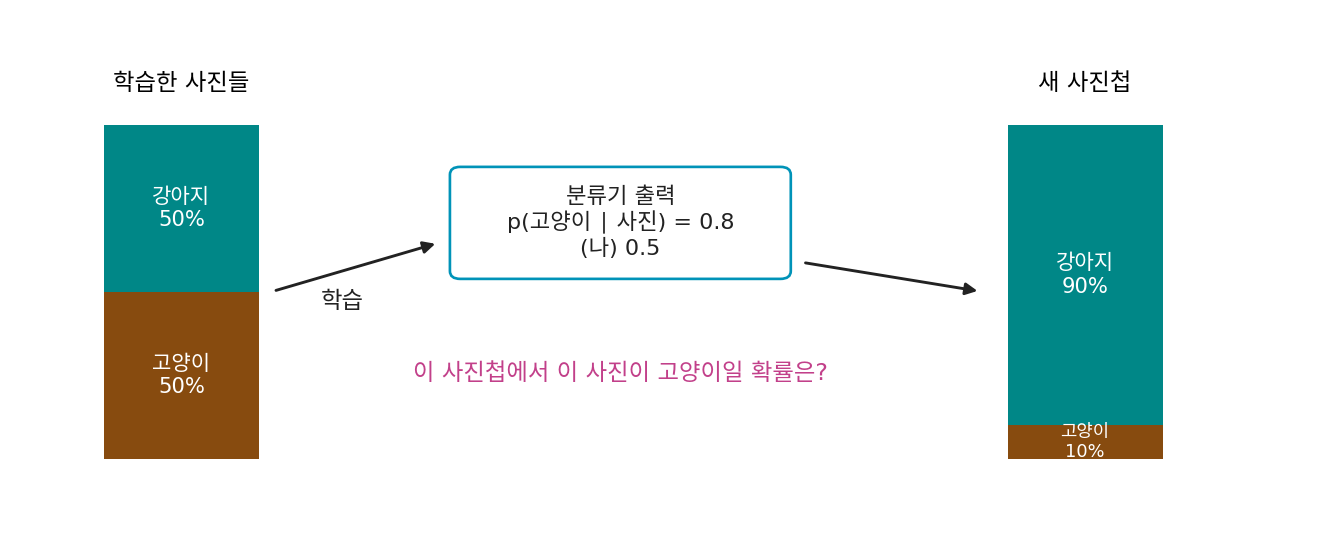
분류기는 사진을 보고 낸 값이니까 사진첩이 바뀌어도 0.8 그대로 아니에요?
분류기가 학습한 데이터에서 고양이 비율은 얼마였어요?
50%요. 아, 출력 안에 그 50%가 사전확률로 들어가 있는 거네요.
베이즈 정리로 풀어 볼게. 출력은 p(x ∣ 고양이) × 0.5 대 p(x ∣ 강아지) × 0.5 의 비율이야.
사진첩을 바꾸면 그 가운데 무엇이 바뀌어요?
사진을 보는 눈은 같다고 했으니 두 밀도의 비는 0.8 : 0.2 = 4 : 1 로 그대로예요. 앞의 무게만 0.1 대 0.9로 바꾸면 되네요.
그럼 4 × 0.1 대 1 × 0.9, 0.4 대 0.9 니까 0.4 ÷ 1.3 = 0.308. 0.8에서 확 줄었네.
(나)도 같은 방법으로 해 봐요.
두 밀도의 비가 1 : 1 이니까 0.1 대 0.9 이고, 고양이일 확률은 0.1 ÷ 1.0 = 0.1이요. 분류기가 반반이라고 한 사진은 이 사진첩에서 고양이일 확률이 사진첩의 고양이 비율 그대로네요. 사진이 아무것도 말해 주지 않은 셈이고요.
밀도의 비는 사진이 알려 준 것, 앞의 무게는 사진을 보기 전에 알던 것. 분류기 출력은 둘을 곱해 놓은 거라서, 앞의 무게가 바뀌면 다시 곱해야 하는구나.
방금 한 일은 고양이 사진에 0.1 ÷ 0.5 = 0.2, 강아지 사진에 0.9 ÷ 0.5 = 1.8을 곱한 거예요. 0.8 × 0.2 대 0.2 × 1.8 은 0.16 대 0.36 이니 다시 0.308이 나오죠. 한 분포에서 뽑은 샘플을 새 비율 ÷ 원래 비율만큼 무겁게 또는 가볍게 쳐서 다른 분포에서 뽑은 것처럼 쓰는 방법을 중요도 샘플링 (샘플마다 두 분포의 비를 무게로 다는 방법 / importance sampling)이라 해요. 여기서는 그 무게를 라벨에만 달았을 뿐 생각은 같아요.