노이즈를 맞히는 신경망: DDPM과 디노이징 스코어 매칭
디노이징 스코어 매칭: 노이즈를 섞어 본 기록으로 스코어를 배운다
단계마다 채우는 대역이 다르니 디노이저도 노이즈 레벨마다 다르고, 거꾸로 걸으려면 그 모든 노이즈 레벨에서 스코어 s(x, t) = ∇ₓ log pt(x)가 있어야 한다. 이 스코어를 신경망 sθ(x, t)에게 맡기고 싶은데, 신경망을 배우는 익숙한 방법은 정답과의 제곱 오차를 줄이는 것이다. 문제는 노이즈 섞인 그림들의 분포 pt를 모르니 그 로그의 그래디언트도 몰라서 정답이 없다는 데 있다. 스코어를 배우려면 스코어의 정답이 먼저 있어야 하는 형태다.
역사: 정규화 상수 없이 배우려던 시도
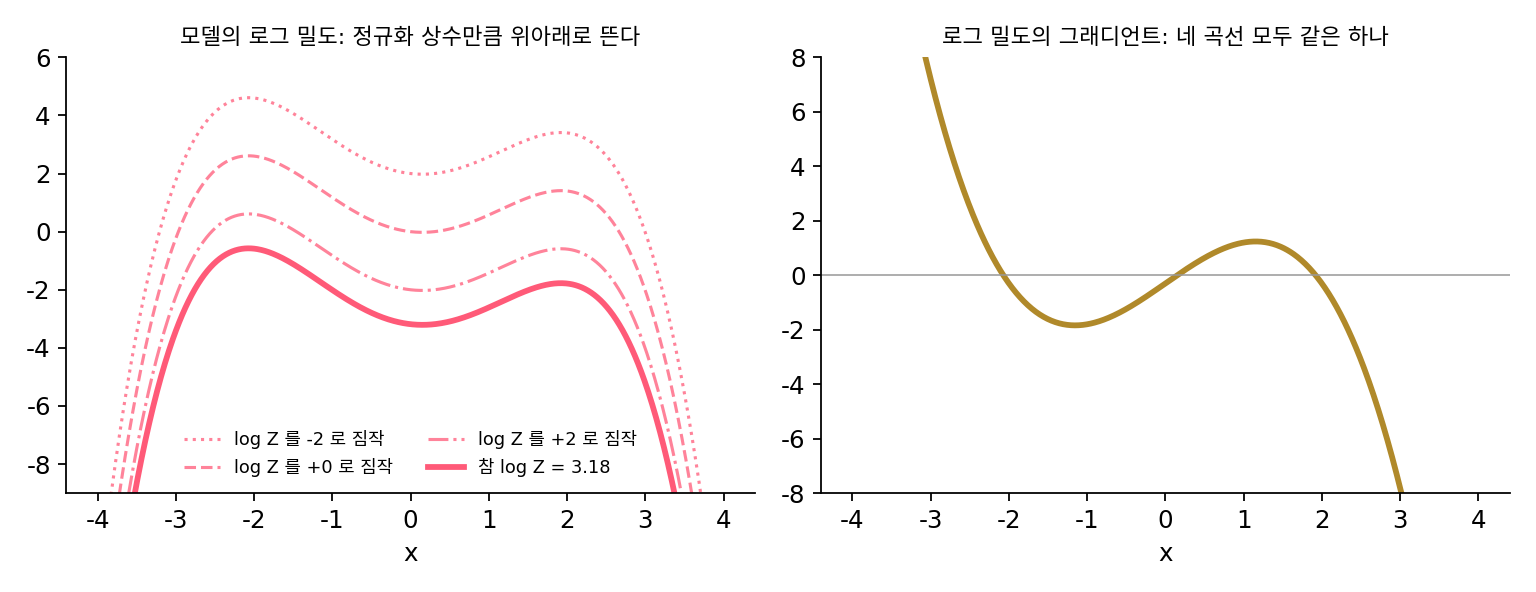
같은 막힘을 디퓨전 모델보다 먼저 겪은 사람들이 있다. 그림처럼 차원이 큰 데이터를 다루는 모델 가운데에는 밀도를 상수배까지만 적을 수 있는 것이 많다. 밀도의 합을 1로 맞추는 정규화 상수를 모르면, 모델이 데이터에 준 확률을 계산할 수 없어, 그 로그(로그우도)를 올리는 익숙한 학습이 막힌다. 아포 히바리넨(Aapo Hyvärinen)은 2005년 학술지 JMLR에 낸 「스코어 매칭으로 정규화하지 않은 통계 모델 추정하기(Estimation of Non-Normalized Statistical Models by Score Matching)」의 서론에서 그때의 처지를 이렇게 적었다. 이런 모델은 보통 마르코프 체인 몬테카를로(무작위 스텝으로 샘플을 뽑아 적분을 근사하는 방법)에 기대거나 정규화 상수를 근사해야 했다.
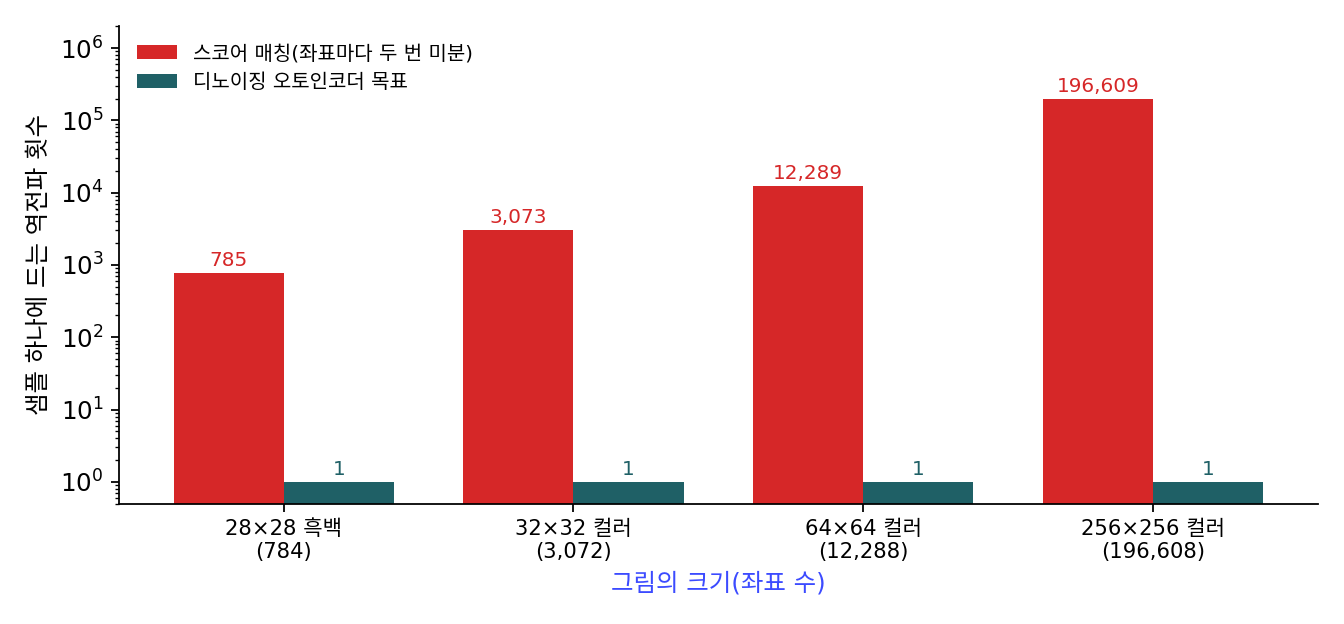
그의 제안은 모델의 로그 밀도 그래디언트와 데이터의 로그 밀도 그래디언트 사이의 제곱 거리를 줄이자는 것이었다. 그래디언트에는 정규화 상수가 들어 있지 않다. 남은 걸림돌은 데이터의 로그 밀도 그래디언트를 모른다는 것, 바로 앞에서 부딪힌 그 벽이었다. 히바리넨은 이 목표를 부분적분으로 바꿔 쓰면 데이터의 밀도가 식에서 사라지고, 모델의 로그 밀도를 미분한 값 몇 가지의 표본 평균만 남는다는 것을 증명했다. 대가가 있었다. 남은 식에는 로그 밀도를 좌표마다 두 번 미분한 값이 들어 있어서, 좌표가 수천 개인 신경망에서는 계산이 무거웠다.
몇 해 뒤 파스칼 뱅상(Pascal Vincent)은 전혀 다른 쪽에서 같은 자리에 닿았다. 그는 2008년에 동료들과 디노이징 오토인코더, 곧 입력을 일부러 망가뜨리고 원래 입력을 되살리도록 배우는 오토인코더를 내놓은 사람이다. 2011년 학술지 Neural Computation에 실린 짧은 논문 「스코어 매칭과 디노이징 오토인코더의 연결(A Connection Between Score Matching and Denoising Autoencoders)」에서 그는 이 훈련 목표가 노이즈로 번진 데이터 분포에 대한 스코어 매칭과 같다는 것을 보였다. 그는 이렇게 하면 두 번 미분이 필요 없다고 적었고, 정답 스코어를 모르는 문제를 「노이즈를 섞어 본 기록」으로 푸는 길이 이렇게 열렸다.
정규화 상수가 걸리면 그래디언트를 쓰면 되잖아요. 로그를 미분하면 상수가 떨어지는 건 미적분 첫 주에 배우는 건데요.
상수가 떨어지는 건 쉬운 부분이었어요. 그다음에 남은 벽은 뭐였죠?
데이터의 로그 밀도 그래디언트를 모르는 거요. 히바리넨은 그걸 부분적분으로 지웠는데… 대신 좌표마다 두 번 미분한 값이 들어왔고요.
그 두 번 미분을 32 × 32 컬러 그림, 숫자 3072개에서 한다고 해 봐요. 오늘의 자동 미분으로도 좌표 하나의 두 번 미분마다 역전파를 한 번씩 더 돌려야 해요.
그럼 미니배치 하나에 역전파를 3072번 더… 그건 지금 GPU로도 버거운데요.
그래서 막혔던 거예요. 수학은 2005년에 풀렸는데, 큰 그림에서는 돌릴 수 없는 계산이 남았어요. 뱅상의 연결은 그 두 번 미분을 「노이즈를 섞고 원래 것을 맞히기」로 바꿔 놓았고요.
노이즈를 섞어 본 기록만으로 된다는 건데… 그 기록 한 줄에서는 무엇을 정답으로 삼아요?
기록 한 줄의 정답
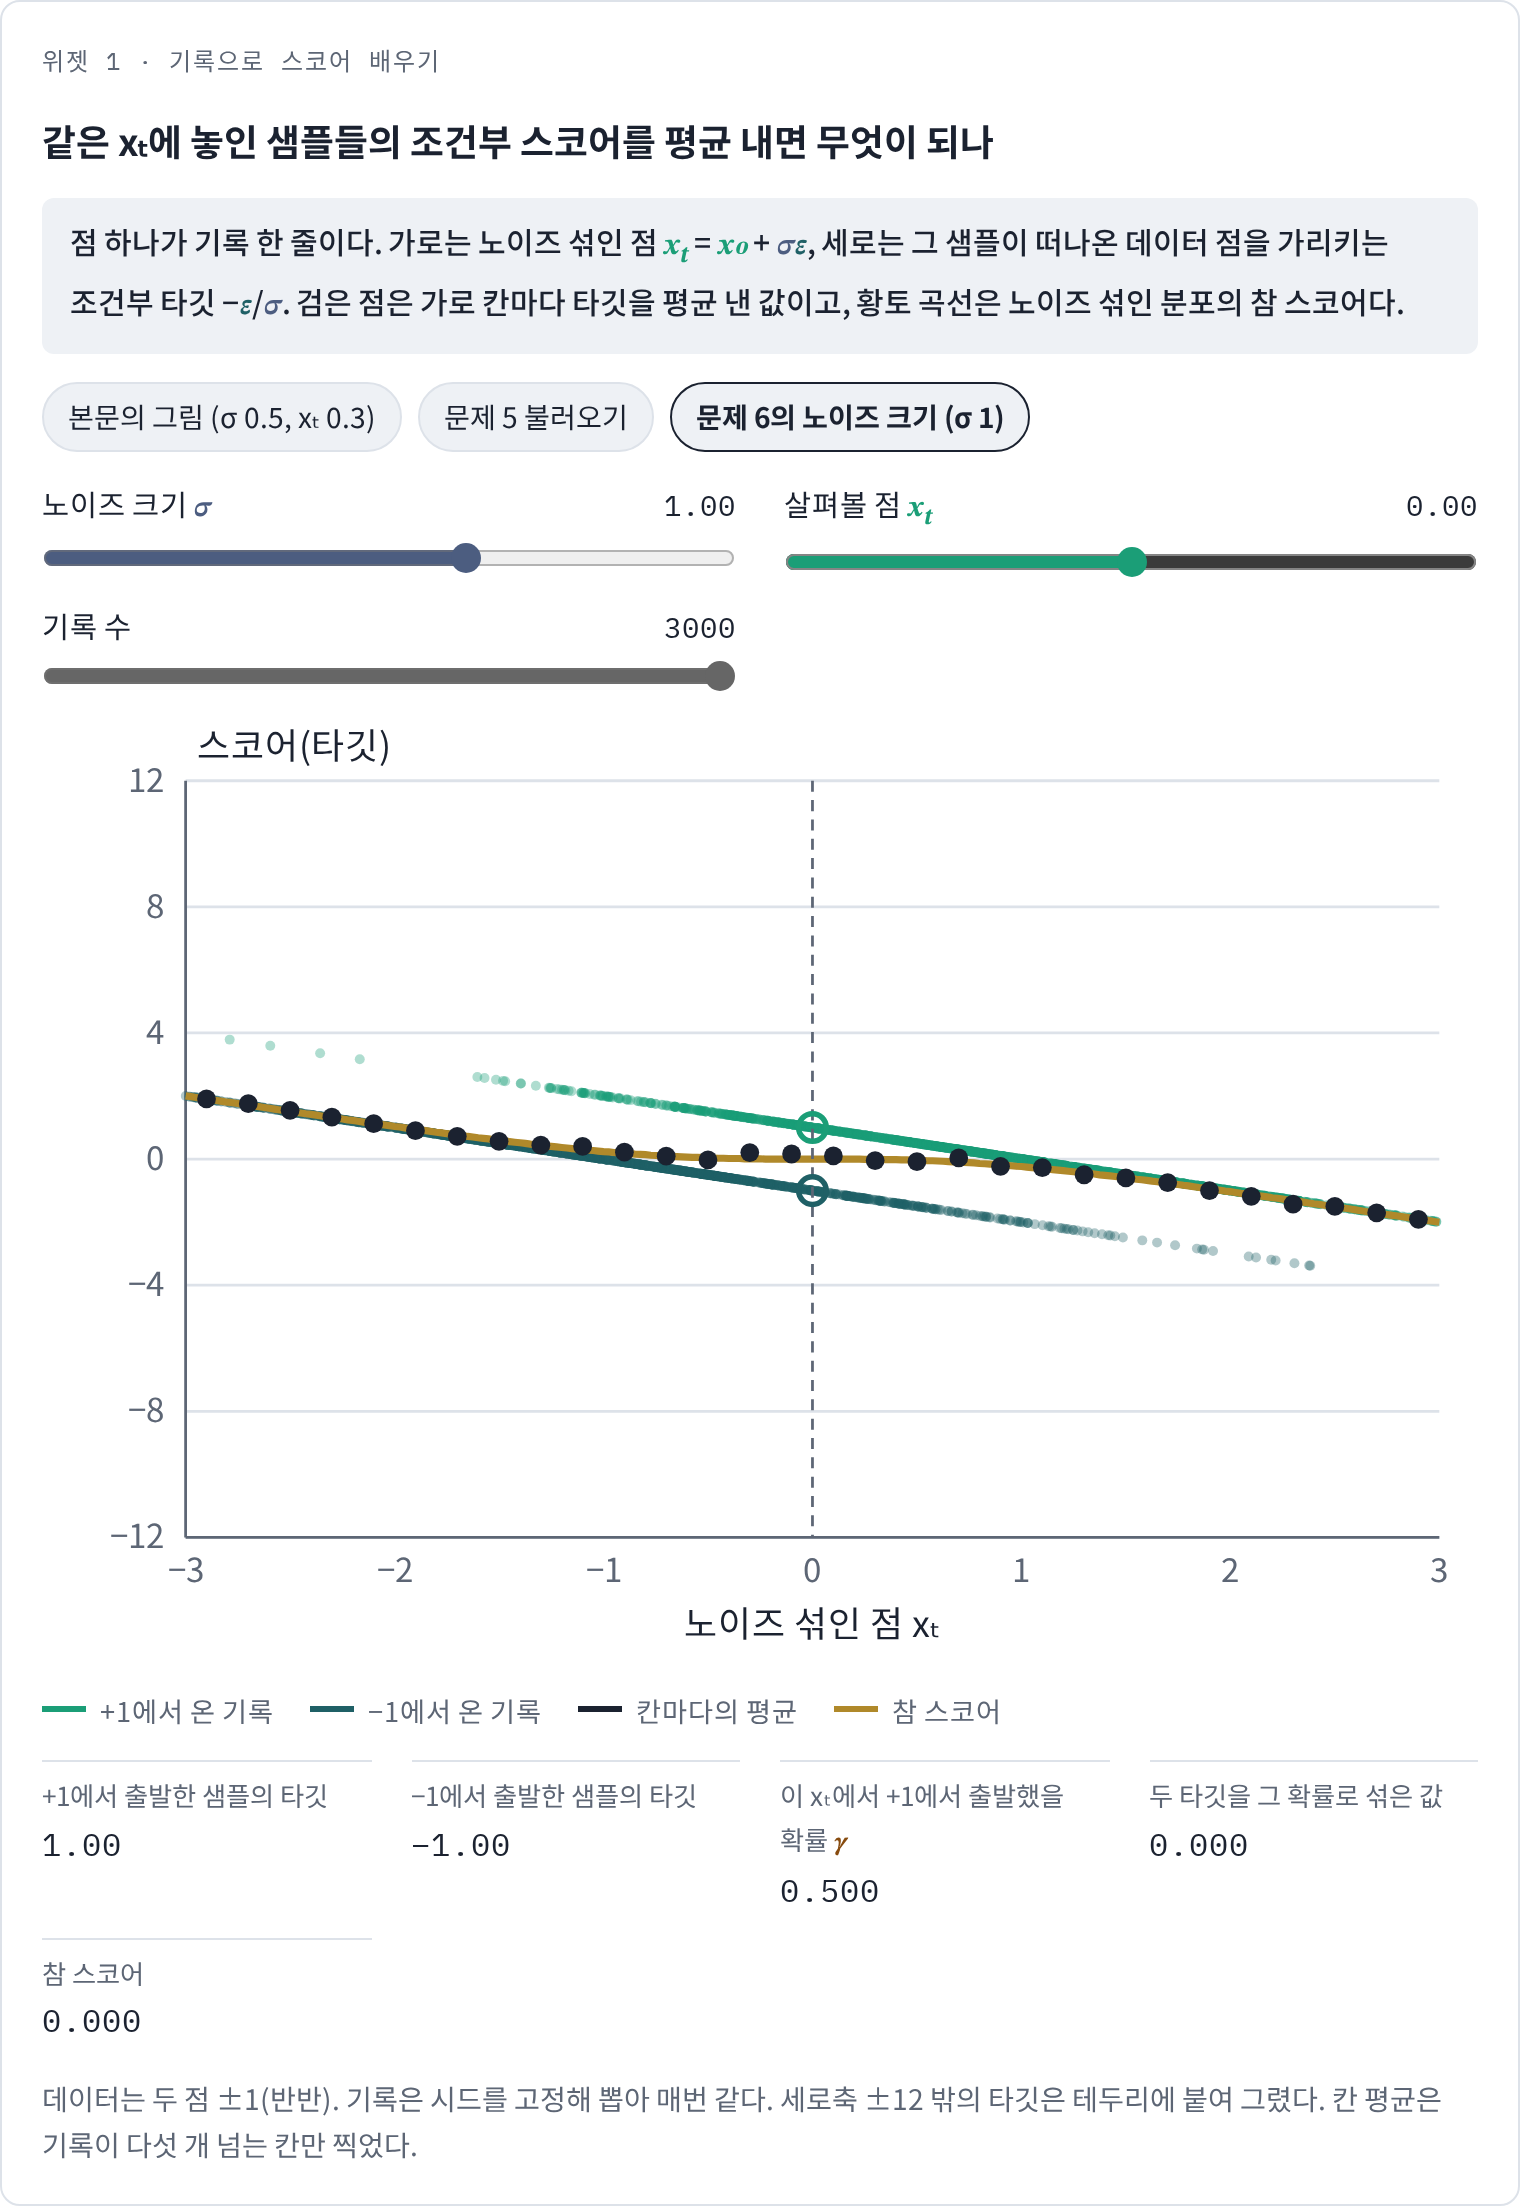
우리는 데이터 분포의 봉우리가 어디에 있는지, 그 분포의 스코어가 어떤지 모르고, 가진 것은 데이터 점들뿐이다. 그래도 노이즈를 섞어 본 기록은 얼마든지 만들 수 있다. 기록 한 줄은 「데이터 점 x₀에서 출발해 노이즈에 이만큼 밀려난 샘플이 xₜ에 있었다」는 내용이다. 그 샘플 하나만 보면 돌아가는 방향은 분명한데, 자기가 떠나온 데이터 점 x₀ 쪽이다. 그림 한 장을 고르고 노이즈를 뽑아 섞기만 하면 한 줄이 생긴다.
기록 한 줄은 데이터 점 x₀, 표준정규 노이즈 ε, 노이즈 크기 σt로 이루어지고, 그 샘플이 놓인 자리는 xt = x₀ + σtε다. 그 샘플 하나에 맞는 스코어는 x₀를 중심으로 한 정규분포 밀도의 로그 그래디언트, −(xt − x₀)/σt² = −ε/σt다. 이 조건부 스코어를 정답 삼아 신경망을 훈련한다.
여기서 조심할 것은, 타깃은 「이 샘플은 x₀에서 왔다」를 알 때의 스코어인데 신경망은 x₀를 보지 못하고 xt와 t만 본다는 점이다. 같은 xₜ에 서로 다른 데이터 점에서 출발한 샘플들이 겹쳐 있으면, 신경망은 그 샘플들의 서로 다른 조건부 스코어에 하나로 답할 수밖에 없다. 그 하나는 무엇이 될까?
두 점 데이터로 확인하기
가장 단순한 데이터, −1과 +1 두 점(반반)에 σ = 0.5인 노이즈를 섞는다. xₜ = 0.3에 놓인 샘플은 +1에서 출발했다면 조건부 스코어가 −(0.3 − 1)/0.25 = +2.8이고, −1에서 출발했다면 −(0.3 + 1)/0.25 = −5.2다. xₜ = 0.3을 본 뒤에 그 샘플이 +1에서 출발했을 확률은 0.917이다.
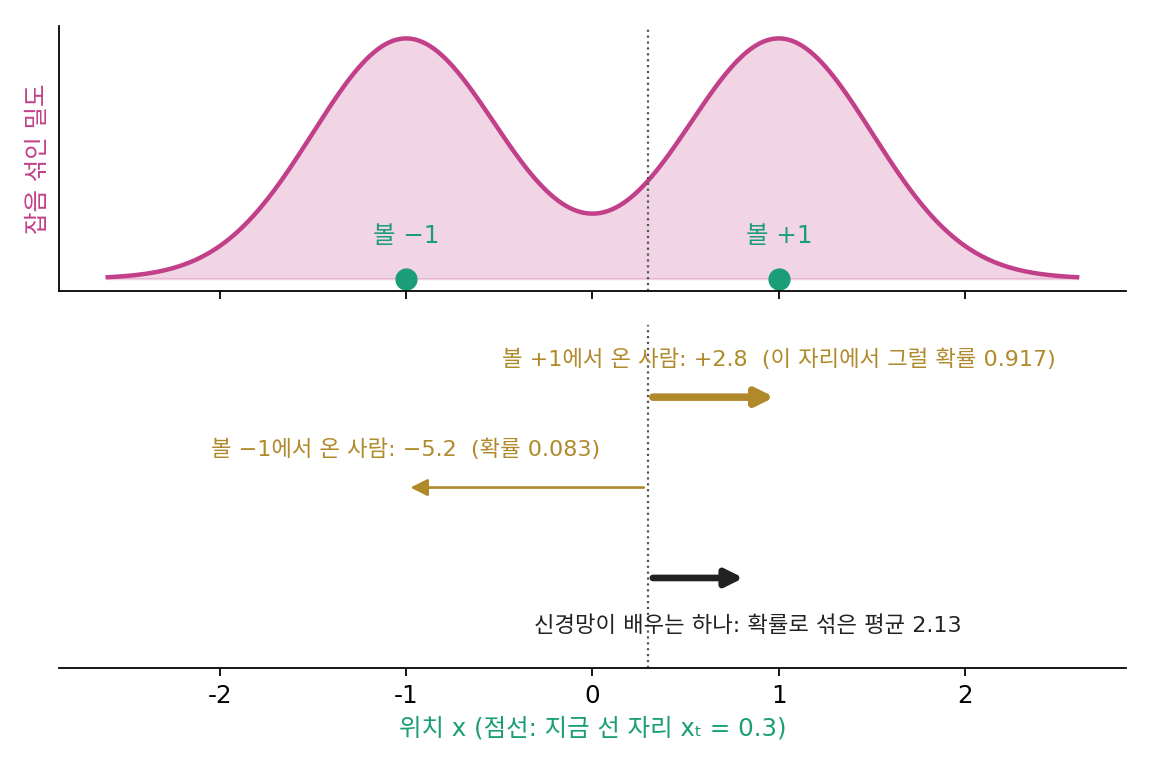
기록을 많이 뽑아, 같은 xₜ 근처에 놓인 샘플들의 타깃을 평균 내 보자. 그 평균을 노이즈 섞인 분포의 참 스코어와 비교한다. 두 점 데이터에서는 참 스코어를 (tanh(y/σ²) − y)/σ²로 손으로 적을 수 있다.
import numpy as np
rng = np.random.default_rng(0)

# 데이터: 두 점 ±1 (반반).  기록 한 줄 = (x0, ε) 를 뽑아 x_t = x0 + σ ε
sigma, n = 0.5, 4_000_000
x0 = rng.choice([-1.0, 1.0], n)
xt = x0 + sigma * rng.normal(size=n)
target = -(xt - x0) / sigma**2                      # 조건부 타깃: 떠나온 점 쪽 스코어

def score(y):                                       # 노이즈 섞인 분포의 참 스코어(이 장난감에서만 안다)
    return (np.tanh(y / sigma**2) - y) / sigma**2

for y in [0.0, 0.3, 1.0]:                           # (1) 같은 자리의 타깃을 평균 내면
    near = np.abs(xt - y) < 0.02
    print(f"y={y}: 조건부 타깃 평균 {target[near].mean():6.3f}   참 스코어 {score(y):6.3f}")

cands = {"0을 내놓는 신경망": lambda y: 0 * y,      # (2) 손실 두 가지를 여러 후보로 비교한다
         "정규분포 스코어 −y/1.25": lambda y: -y / (1 + sigma**2),
         "참 스코어의 0.8배": lambda y: 0.8 * score(y)}
for name, f in cands.items():
    dsm = np.mean((f(xt) - target)**2)              # 디노이징 스코어 매칭 손실 (기록만으로 계산)
    true = np.mean((f(xt) - score(xt))**2)          # 참 스코어와의 거리 (보통은 계산할 수 없음)
    print(f"{name:16s} DSM {dsm:.4f}  참 스코어와의 거리 {true:.4f}  차 {dsm - true:.4f}")
# y=0.0: 조건부 타깃 평균 -0.028   참 스코어  0.000
# y=0.3: 조건부 타깃 평균  2.112   참 스코어  2.135
# y=1.0: 조건부 타깃 평균 -0.003   참 스코어 -0.003
# 0을 내놓는 신경망       DSM 3.9981  참 스코어와의 거리 2.9009  차 1.0972
# 정규분포 스코어 −y/1.25 DSM 3.2000  참 스코어와의 거리 2.1030  차 1.0970
# 참 스코어의 0.8배      DSM 1.2136  참 스코어와의 거리 0.1160  차 1.0976
(1)에서 xₜ = 0.3의 타깃은 +2.8과 −5.2 두 값뿐인데 평균은 2.1이다. 0.917 × 2.8 + 0.083 × (−5.2) = 2.135가 참 스코어와 같고, 샘플 값이 조금 작은 것은 0.3 둘레 폭 0.02의 칸에서 평균을 냈기 때문이다. (2)는 더 놀랍다. 어떤 후보를 넣든, 기록만으로 계산한 손실과 참 스코어와의 거리는 같은 상수(약 1.097)만큼 차이 난다. 상수는 신경망과 상관없으니, 기록으로 만든 손실을 줄이는 것은 참 스코어와의 거리를 줄이는 것과 똑같은 일이다.
왜 그럴까? 제곱 오차를 가장 작게 하는 하나의 답은 같은 xₜ에 놓인 샘플들의 타깃의 평균(조건부 기댓값)이고, 그 평균은 트위디 공식(노이즈 섞인 점에서 원래 점의 평균을 스코어로 구하는 식, E[x₀ ∣ xt] = xt + σt²s)을 스코어 쪽으로 다시 적은 것과 같기 때문이다.
조건부 스코어들의 평균은, 어느 데이터 점에서 출발했는지 모르는 채 모두 합친 노이즈 섞인 분포의 스코어, 곧 참 스코어다. 정답 스코어를 한 번도 보지 않고, 노이즈를 섞어 본 기록만으로 참 스코어를 배운다. 이 방법을 디노이징 스코어 매칭 (섞은 노이즈를 되돌리는 스코어를 정답 삼아 스코어를 배우기 / denoising score matching)이라 한다. 앞으로 디퓨전 모델의 학습은 모두 이 생각 위에 선다.
ML에서: 학습 루프 한 바퀴
실제 학습은 이 기록 만들기를 미니배치마다 반복한다. 학습용 그림 한 장 x₀를 고르고, 노이즈 레벨 t를 고르고, 그림과 같은 크기의 표준정규 노이즈 ε를 뽑아 섞은 xt를 신경망에 넣고, 신경망의 출력과 타깃의 제곱 오차로 파라미터 θ를 한 스텝 고친다. 그림이 몇만 장뿐이어도 노이즈는 매번 새로 뽑으므로 기록은 끝없이 생긴다. 송(Yang Song)과 에르몬(Stefano Ermon)의 2019년 모델처럼, 노이즈 크기를 입력으로 함께 받는 신경망 하나가 모든 노이즈 레벨의 스코어를 맡는다.
문제 4. 우산을 몇 개 들여놓을까
편의점 점장이 내일 팔릴 우산 수를 숫자 하나로 예상해 본사에 보내면, 본사는 예상과 실제 판매량의 차이를 제곱해서 점수를 깎는다. 내일 비가 올 확률은 30%이고, 비가 오면 100개, 안 오면 20개가 팔린다. (가) 어떤 숫자를 보내야 깎이는 점수의 기댓값이 가장 작은가? (나) 더 그럴듯한 쪽인 20개를 보내면 기댓값으로 얼마나 깎이는가?
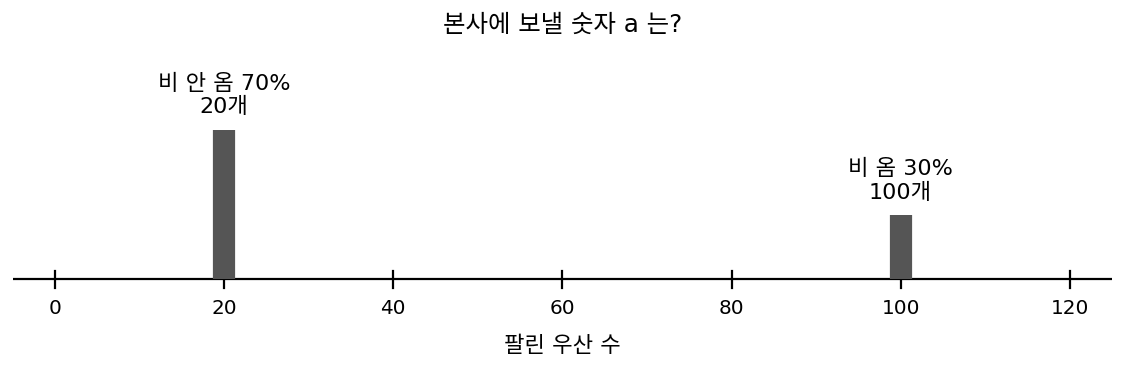
깎이는 점수의 기댓값을 보내는 숫자 a의 식으로 적어 볼게요. 0.3(100 − a)² + 0.7(20 − a)²이고, a로 미분해서 0으로 놓으면… a = 0.3 × 100 + 0.7 × 20 = 44예요. 판매량의 기댓값 그대로네요.
44면 깎이는 기댓값은 0.3 × 56² + 0.7 × 24² = 1,344야. (나)처럼 20개를 보내면 비 올 때 80개 차이의 제곱이라 6,400, 확률 30%를 곱하면 1,920이고.
20개가 더 그럴듯한 숫자인데도 더 깎이네요. 왜 그럴까요?
44개는 실제로는 절대 안 나오는 판매량인데 그게 제일 덜 깎이네요. 한 번 크게 틀리는 것보다 양쪽으로 적당히 틀리는 게 제곱에서는 이득이구나.
답이 둘 중 하나로 갈리는데 어느 쪽인지 모르면, 제곱 오차는 둘을 확률로 섞은 값을 고르게 해요.
문제 5. 조건부 타깃과 참 스코어
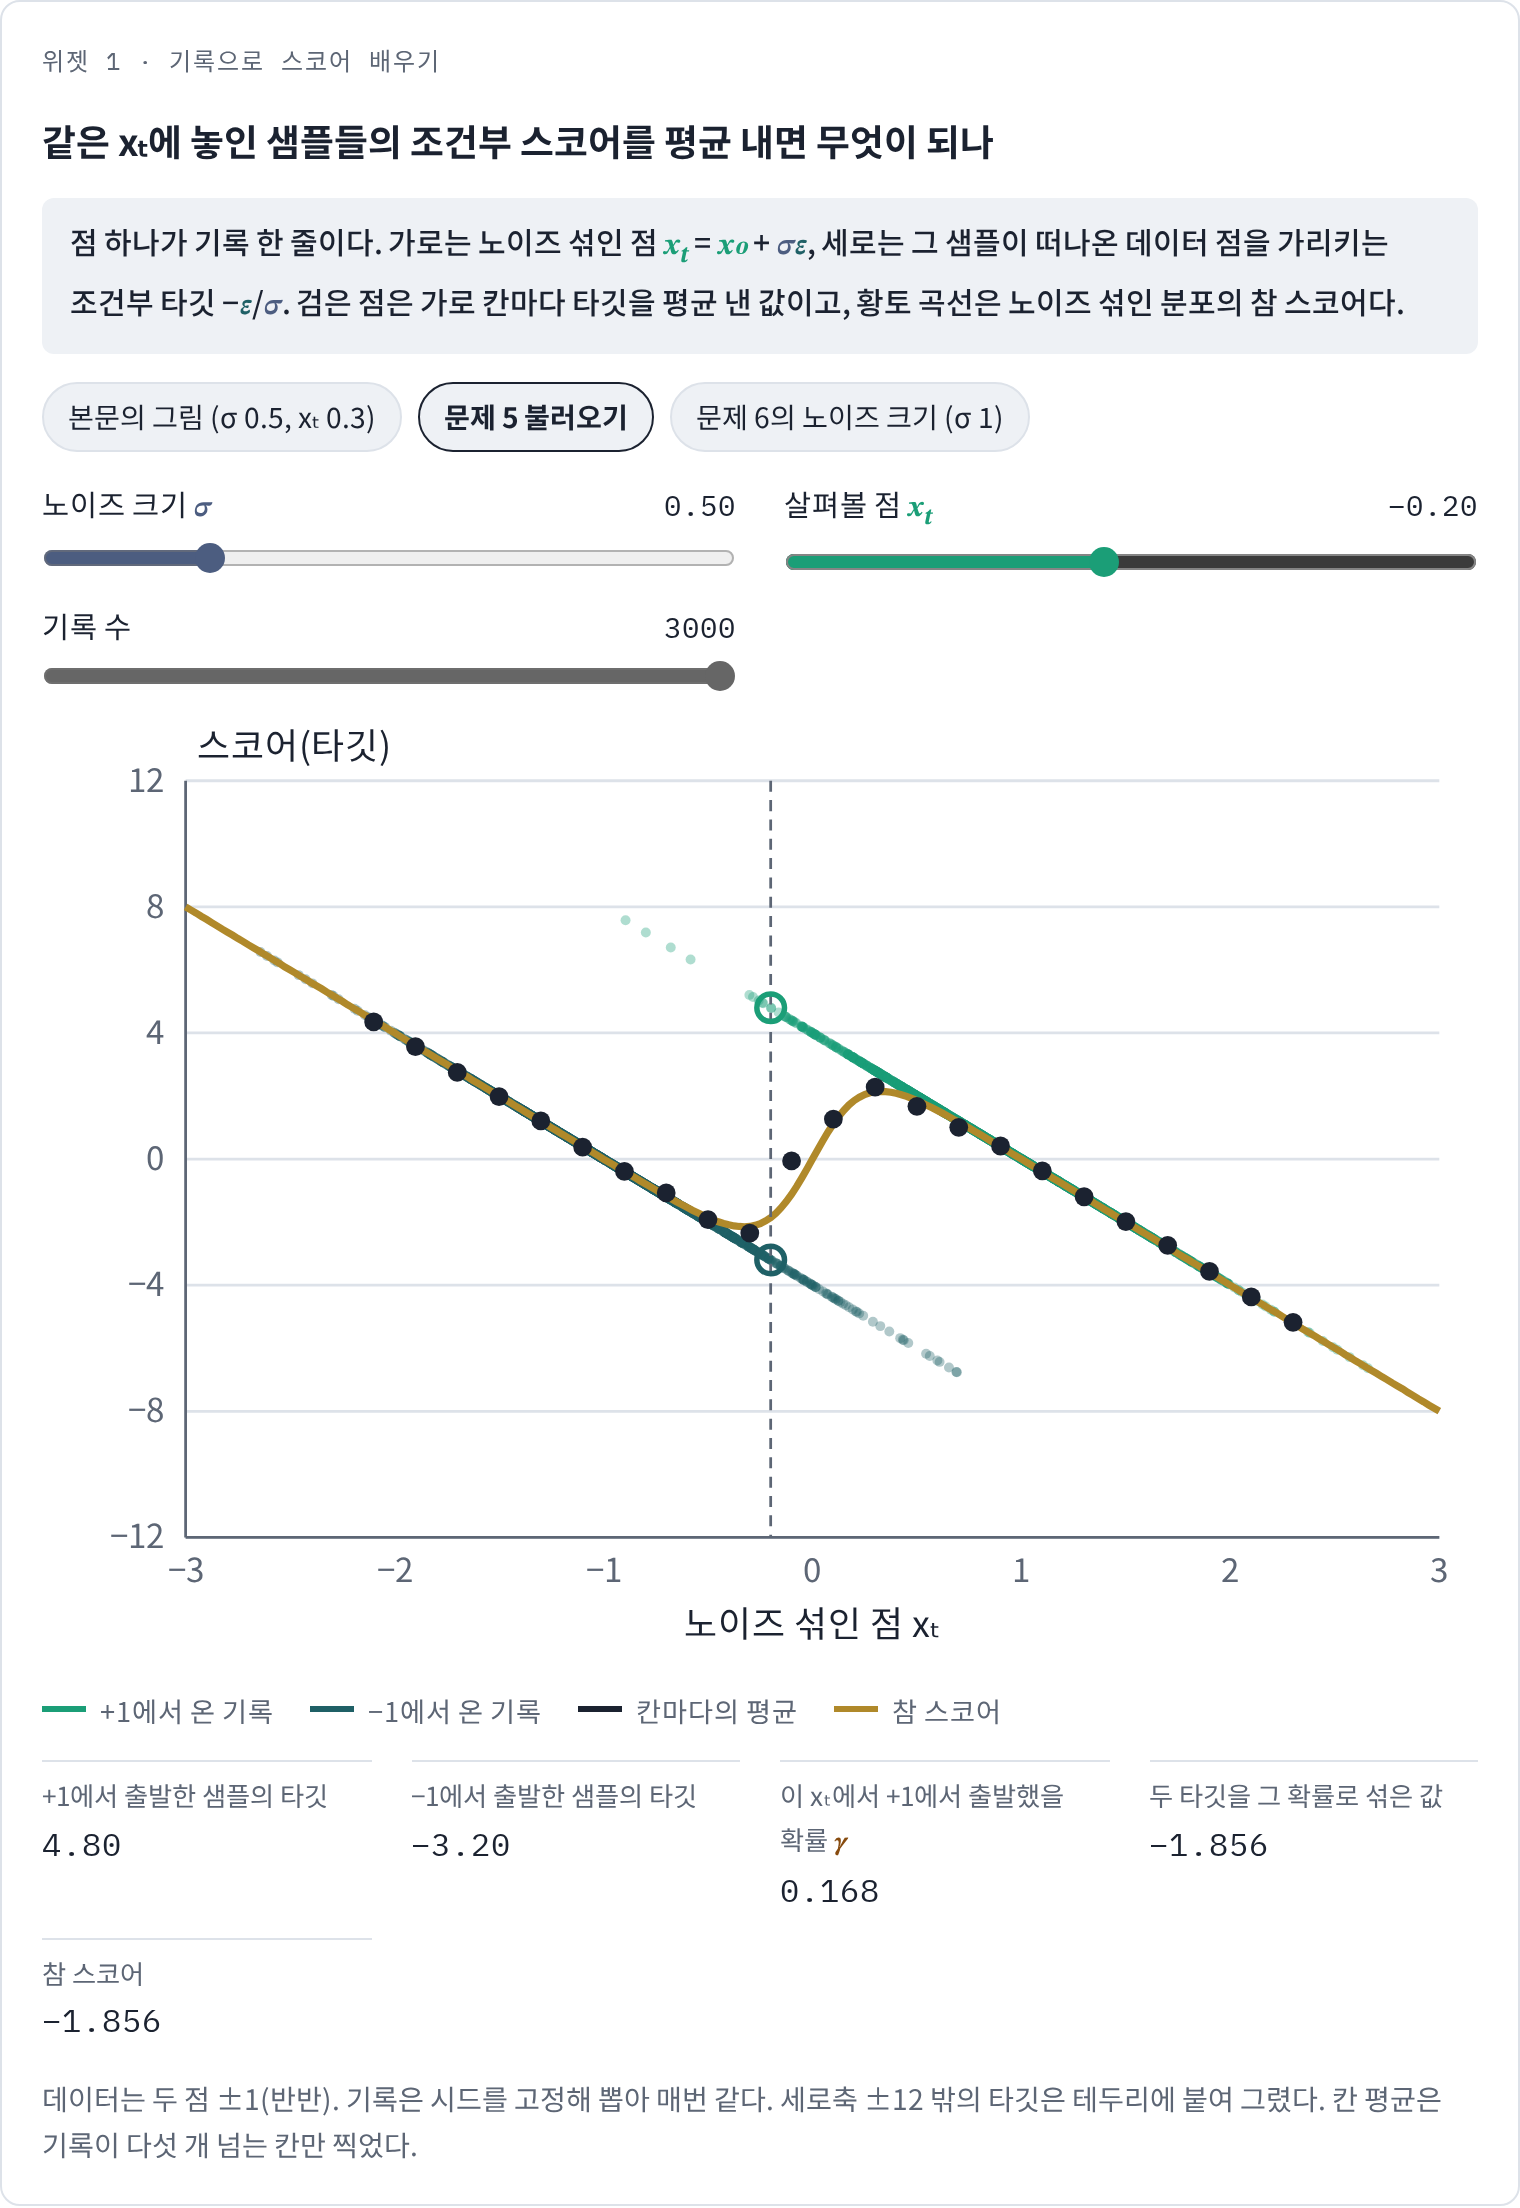
데이터가 두 점 ±1(반반)이고 노이즈 σ = 0.5를 섞는다. (가) xt = −0.2에 놓인 샘플의 조건부 타깃 −(xt − x₀)/σ²는 어떤 값들을 가질 수 있는가? (나) 디노이징 스코어 매칭을 완벽하게 풀었을 때 신경망이 xₜ = −0.2에서 내놓는 값은? (풀어 본 뒤 위젯 1의 「문제 5 불러오기」로 확인해 보자.)
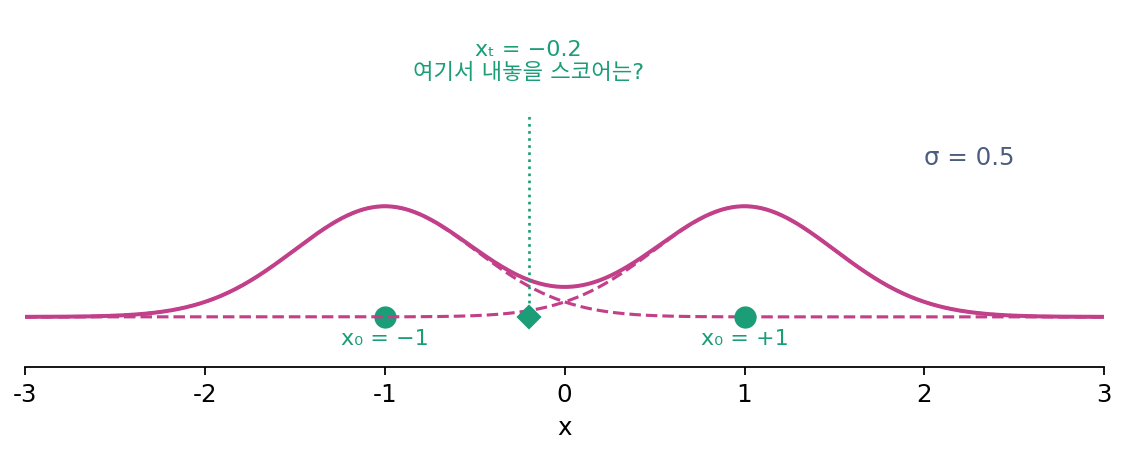
(가)는 x₀가 +1이면 −(−0.2 − 1)/0.25 = 4.8, −1이면 −(−0.2 + 1)/0.25 = −3.2예요. (나)는 우산 문제처럼 둘을 섞으면 되겠죠. 두 데이터 점이 반반이니까 0.5 × 4.8 + 0.5 × (−3.2) = 0.8이에요.
0.8이면 스코어가 어느 쪽을 가리켜요? −0.2에서 가까운 데이터 점은 어느 쪽이고요?
양수니까 오른쪽, +1 쪽이요. 그런데 −0.2는 −1에 더 가까운데… 이상하네요.
우산 문제에서 섞는 비율은 무엇이었어요? 「비가 올 확률」을 언제 알게 된 확률이었죠?
내일 날씨에 대해 지금 아는 확률이요. 여기서도 처음의 반반으로 섞지 말고, xₜ = −0.2를 본 뒤의 확률로 섞어야 하네요. −0.2는 −1 쪽에 더 가까우니까 −1에서 출발한 샘플이 더 많아요.
본 뒤의 확률은 두 정규분포 밀도의 높이를 비교하면 될 것 같아. 둘 다 σ = 0.5니까 높이는 −0.2에서 각 데이터 점까지의 거리로만 정해지고.
그 비교를 +1에서 왔을 확률 γ 하나로 적어 볼래요?
높이의 비를 확률로 바꾸면… (1 + tanh(−0.2/0.25))/2 = 0.168이에요.
그럼 0.168 × 4.8 + 0.832 × (−3.2) = −1.856. 이번엔 음수라서 −1 쪽을 가리켜.
참 스코어 (tanh(y/σ²) − y)/σ²에 넣어도 −1.856이야.
그래요. 샘플 하나의 조건부 스코어와 신경망이 배우는 스코어는 달라요. 신경망은 그 xₜ에 올 수 있었던 모든 샘플의 조건부 스코어를, xₜ를 본 뒤의 확률로 섞어요.
「전체 확률의 법칙」을 평균에 쓴 거네요. 조건을 붙여 나눠 풀고, 그 조건의 확률로 다시 섞는 거요.
문제 6. 손실이 0까지 내려가지 않는다
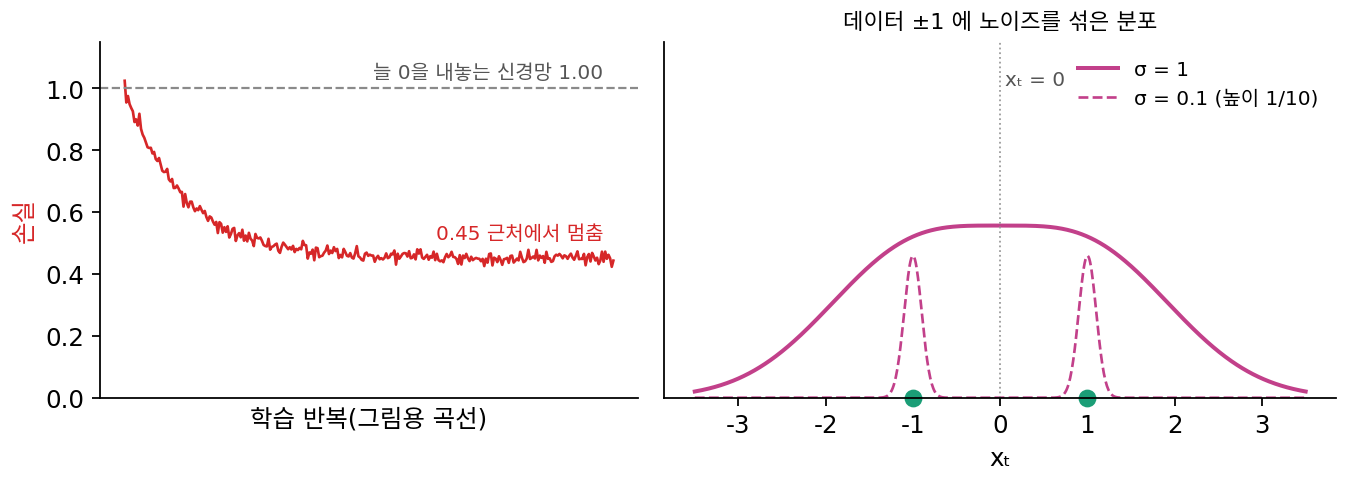
데이터 두 점 ±1, 노이즈 σ = 1 하나로 디노이징 스코어 매칭을 학습했더니, 손실이 0.45 근처에서 더 내려가지 않는다. 늘 0을 내놓는 신경망의 손실은 1.00이다. (가) 학습이 덜 된 것인가? 가장 잘 배운 신경망의 손실은 얼마인가? (나) 같은 데이터에서 σ = 0.1이면 그 최솟값은 얼마인가? (다) 노이즈 레벨마다 손실 값을 그대로 비교하면 무엇이 틀리는가?
손실이 0이 될 때까지 더 돌려야죠. 신경망을 키우거나 학습률을 바꿔 볼게요.
xₜ = 0에 놓인 샘플들의 타깃부터 봐요. 몇 가지 값이 있어요?
+1에서 왔으면 −(0 − 1)/1 = +1, −1에서 왔으면 −1이요. 0은 한가운데라 반반이고요.
그럼 신경망은 xₜ = 0에서 무엇을 내놓아야 가장 덜 틀려요?
반반이니까 0이요. 그래도 오차 제곱은 어느 쪽이든 1이에요. 아무리 키워도 xₜ = 0에서는 1을 못 줄이네요.
그럼 xₜ = 0 말고 다른 자리에도 이렇게 못 줄이는 오차가 있겠네. 손실의 최솟값은 xₜ마다 타깃이 흔들리는 정도, 조건부 분산을 평균 낸 거 아닐까?
타깃 −(xt − x₀)/σ²에서 xt를 고정하면 흔들리는 건 무엇이에요?
x₀뿐이에요. 그러니까 x₀의 조건부 분산을 σ⁴로 나누면 돼요. ±1 데이터면 그 분산이 1 − tanh²(xt/σ²)이고요.
그걸 샘플로 평균 내 보니까 0.450이야. 학습은 다 된 거였네.
(나)는 계산하기 전에 추측해 봐요. 노이즈가 0.1이면 xₜ를 보고 어느 데이터 점에서 출발했는지 얼마나 확실해요?
두 데이터 점 사이가 2인데 노이즈가 0.1이면 거의 확실해요. 조건부 분산이 0에 가까우니까 최솟값도 0에 붙겠네요.
계산해 보니까 진짜 0.0000이야. 그런데 0을 내놓는 신경망의 손실은 1/σ² = 100이 돼.
(다)는 그럼, 손실 0.45가 나쁜 숫자가 아니었던 거네요. 노이즈 레벨마다 최솟값도 다르고 처음 높이도 1/σ²로 다르니까, 숫자 그대로 「σ = 1이 σ = 0.1보다 못 배웠다」고 하면 틀려요. σ = 2면 최솟값 0.050, 처음 0.25라서 또 다르고요.
그래요. 손실 곡선은 같은 노이즈 레벨끼리, 최솟값을 뺀 뒤에 비교해야 해요.
위젯 1에서 σ = 1, xₜ = 0 으로 두고 xₜ = 0 근처의 타깃 점들이 어떻게 분포해 있는지 확인해 봐요.