픽셀 패치: 토큰 하나가 폭만큼 커지면
견주어 본 여섯 모델은 모두 VAE 로 줄인 잠재 그림을 패치로 자르고 속도(또는 잡음)를 내놓는다. 토큰 하나가 픽셀 16 × 16칸을 맡으니, 픽셀 그림을 16 × 16칸씩 바로 잘라도 토큰은 4,096개로 같고 압축기도 필요 없다. 다른 점은 토큰 하나에 든 수다. FLUX.1 의 토큰 하나는 2 × 2 × 16 = 64개의 수를 폭 3072짜리 벡터로 옮기지만, 픽셀 16 × 16칸은 16 × 16 × 3 = 768개의 수다.
토큰 하나의 수는 신경망이 한 번에 내놓는 수이기도 하다. 그 수가 마지막 층 앞의 폭보다 많으면 출력은 폭만큼의 차원에 갇힌다. 그때 모든 방향에 퍼진 잡음과 속도는 손실을 (내놓는 수 − 폭) 아래로 줄이지 못하고, 차원이 낮은 면 근처에 모인 깨끗한 그림만 같은 신경망으로 맞힐 수 있었다(매니폴드 가설, 원래 그림 예측). 트랜스포머에서 그 두 수는 이렇게 정해진다.
FLUX.1 은 D = 64를 폭 d = 3072로 다루니 벽까지 멀다. 압축기 없이 픽셀을 16 × 16칸으로 자르면 D = 768이 DiT-B 의 폭 768에 닿는다. 트랜스포머에서도 그 벽이 그대로 나올까?
역사: 다시 그림으로
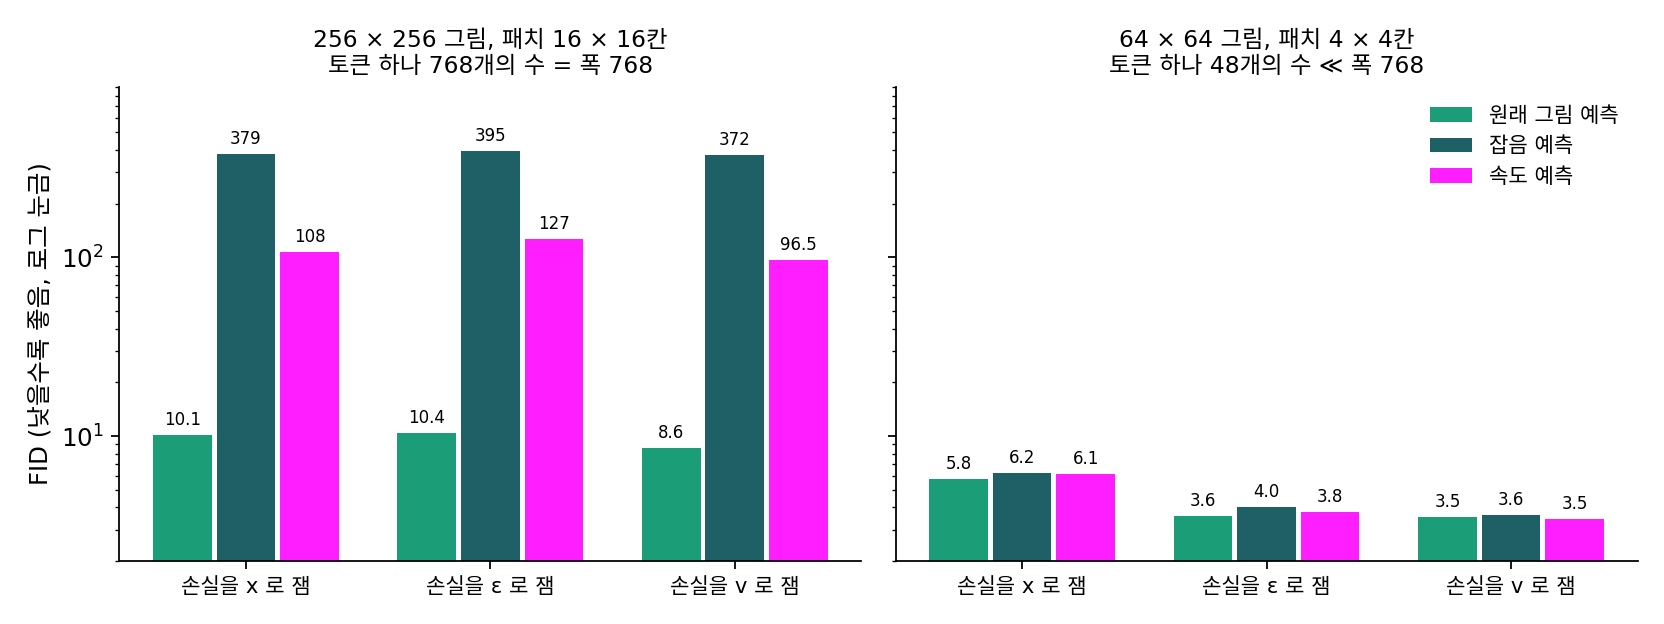
이 물음을 직접 시험한 것은 2025년 11월 MIT 의 리(Tianhong Li)와 허(Kaiming He)다. 논문 제목은 「잡음 제거 생성 모델이 잡음을 제거하게 하자(Back to Basics: Let Denoising Generative Models Denoise)」다. 256 × 256 그림을 16 × 16칸 패치로 잘라 폭 768인 ViT 에 넣고 출력 꼴 셋과 손실을 재는 공간 셋의 아홉 칸을 견주자, 토큰 하나의 수가 폭과 같은 이 설정에서 잡음·속도를 내놓는 여섯 칸은 FID 96~395로 무너지고, 원래 그림을 내놓는 세 칸만 8.6~10.5였다. 64 × 64 그림을 4 × 4칸으로 자르면(토큰 하나에 48개) 아홉 칸이 모두 괜찮았다. 그들은 이 구조를 「그냥 그림 트랜스포머(Just image Transformers)」, 줄여 JiT 라 불렀다.
ML에서: 픽셀 위의 트랜스포머
리·허의 최종 모델은 신경망이 원래 그림을 내놓고 손실은 속도 공간에서 재는 조합이다(논문은 시간을 거꾸로 적어 1이 데이터, 속도도 x − ε 이지만 내용은 같다). ImageNet 256 × 256 에서 가장 큰 JiT-G/16(매개변수 20억)은 FID 1.82, 512 × 512 의 JiT-G/32 는 1.78이었다. 같은 표에서 잠재 위의 DiT-XL/2 는 2.27이지만, 미리 학습한 바깥 그림 인코더의 특징을 함께 쓰는 잠재 모델(표현 정렬 REPA 1.42, 표현 오토인코더 RAE 1.13)은 아직 앞선다. 한계도 논문에 있다. 실험은 분류 라벨을 조건으로 한 ImageNet 뿐이고 글로 그림을 만드는 실험은 없다. 가장 큰 모델은 320에폭 무렵부터 FID 가 나빠져 학습을 일찍 멈췄다.
ComfyUI 에도 들어왔다. Chroma Radiance 의 한 판과 HiDream-O1 은 픽셀 패치에서 원래 그림을 내놓고 (입력 − 출력)/시간으로 속도를 만든다(comfy/ldm/chroma_radiance/model.py, comfy/ldm/hidream_o1/model.py). 패치가 16 × 16칸이면 1024 × 1024 픽셀 그림도 토큰 4,096개라, 몸통의 계산은 잠재 모델과 같은 꼴이다.
문제 16. 패치 한 변을 얼마까지 키울까
픽셀 그림(채널 C = 3)을 한 변 a칸 패치로 잘라 폭 d인 트랜스포머에 넣는다. (가) 토큰 하나의 수 D가 폭을 넘지 않는 가장 큰 a를 2의 거듭제곱 가운데에서 고르면, d = 768, 3072, 6144에서 각각 얼마인가? (나) 1024 × 1024 그림을 그 a로 자르면 토큰은 몇 개인가? (다) 신경망이 속도를 내놓는다면 a를 (가)의 값까지 키워도 괜찮은가? 원래 그림을 내놓는다면?
(가)는 3a² ≤ d 를 풀면 돼요. 768이면 a² ≤ 256이라 16, 3072면 1024라 32, 6144면 2048이라 2의 거듭제곱 가운데 32요. (나)는 16이면 64 × 64 = 4,096개, 32면 32 × 32 = 1,024개고요. 그럼 폭 3072짜리 모델은 패치를 32로 키워 토큰을 4분의 1로 줄이면 되겠네요.
(다)를 보죠. 나선 장난감에서 속도 예측은 한 번에 내놓는 수가 폭과 같을 때 어땠어요?
폭 256에 256개를 내놓을 때 속도 예측의 손실이 134로 원래 그림 예측(7.58)의 18배였어요. 벽 D − d 는 0인데도요. 벽은 손실이 내려갈 수 있는 바닥일 뿐이라, 바닥에 닿기 전부터 배우기가 어려워졌어요. 속도를 내놓는 모델이면 a를 폭에 닿을 때까지 키우면 안 돼요.
원래 그림을 내놓으면 리·허의 표에서 16 × 16 패치가 폭 768에 딱 닿아도 FID 8.6~10.5로 버텼어요. JiT-G/32 는 토큰 하나 3,072개를 폭 1,664로 받아 폭을 넘었는데도 1.78이었고요.
그래요. 패치를 두 배로 키우면 토큰은 4분의 1, 어텐션 쌍은 16분의 1이 돼요. 원래 그림 예측은 그 손잡이를 폭 가까이까지 돌릴 수 있게 해 줘요.
짐을 접을 수 있으면 같은 차에 더 큰 짐을 싣는 거랑 같네요.
문제 17. 토큰 하나의 수와 폭
다음은 여러 모델의 설정이다. DiT-XL/2: 256 × 256 그림, SD VAE(가로세로 1/8, 채널 4), 패치 한 변 2, 폭 1152. FLUX.1 [dev]: 1024 × 1024, 1/8·채널 16, 패치 2, 폭 3072. FLUX.2 [dev]: 1/16·채널 128, 패치 1, 폭 6144. JiT-B/16: 256 × 256 픽셀, 패치 16, 폭 768. JiT-B/32: 512 × 512 픽셀, 패치 32, 폭 768. HiDream-O1: 1024 × 1024 픽셀, 패치 32, 몸통 폭 4096인데, 첫 층이 패치를 1024개의 수로 줄였다가 4096으로 넓힌다. (가) 모델마다 토큰 하나의 수를 폭으로 나눈 값은? (나) 잠재 디퓨전 모델들이 잡음·속도 예측으로도 무너지지 않았던 까닭을 이 값으로 말하라. (다) HiDream-O1 의 첫 층은 정보를 버리는데 왜 해가 되지 않을까?
(가) DiT-XL/2 가 2 × 2 × 4 = 16을 1152로 나눠 0.014, FLUX.1 이 64/3072 = 0.021, FLUX.2 가 128/6144 = 0.021이요. JiT-B/16 은 768/768 = 1, JiT-B/32 는 3,072/768 = 4. HiDream-O1 은 3,072/4096 = 0.75요.
HiDream-O1 은 토큰이 처음에 지나는 가장 좁은 곳이 어디죠?
1024개짜리 층이요. 거기서 보면 3,072/1024 = 3이에요. JiT-B/32 처럼 폭보다 큰 패치를 좁은 길로 넣는 거네요.
(나)는 잠재 모델은 토큰 하나의 수가 폭의 50분의 1도 안 돼. 잡음이 모든 방향에 퍼져 있어도 그 방향이 다 폭 안에 들어가니까 벽이 안 보인 거야.
그럼 VAE 는 잡음 맞히기의 어려움을 풀어 준 걸까요?
푼 게 아니라 안 보이게 한 거예요. 토큰을 작게 만든 덕에 벽 앞까지 가지 않았을 뿐이고, 픽셀로 큰 패치를 자르는 순간 그 벽이 다시 나와요.
(다)는 줄이면 정보를 버리니까 그만큼 그림이 나빠지는 것 아니에요?
신경망이 끝에서 내놓아야 하는 것이 무엇이었죠? 그게 몇 개의 수로 적히나요?
깨끗한 그림 조각이요. 조각은 3,072개의 수지만 그림이 사는 좁은 면 위에 있으니까, 그 면을 담을 만큼만 남기면 되네요. 잡음을 맞혀야 했다면 3,072개 방향을 다 날라야 하니 1024에서 막혔겠고요.
그래요. 리·허도 768개의 수를 16개까지 줄인 첫 층에서 무너지지 않았고, 32~512개로 줄이면 오히려 FID 가 1.3쯤까지 좋아졌다고 보고했어요.
시험 범위가 교과서 세 단원이면 요약 노트 세 장이면 충분한 거네요. 교과서를 통째로 베낄 필요가 없어요.