내재적 확률성: 라벨을 알아도 남는 흩어짐
라벨을 넣은 MLP는 3들의 평균을 그렸고, 실제 3 그림들과의 제곱 거리는 평균 45.0이 남았다. 학습한 모델이 기대에 못 미치면 흔히 「더 크게, 더 오래」를 떠올린다. 이 45.0도 그렇게 하면 줄어들까? 답하려면 남은 오차가 어디서 오는지부터 봐야 한다. MLP의 출력은 이미 평균 그림이었다. 그러니 남은 오차는 3들이 평균 그림에서 떨어진 정도, 곧 3들끼리 얼마나 다른가다.
같은 3, 6,131가지
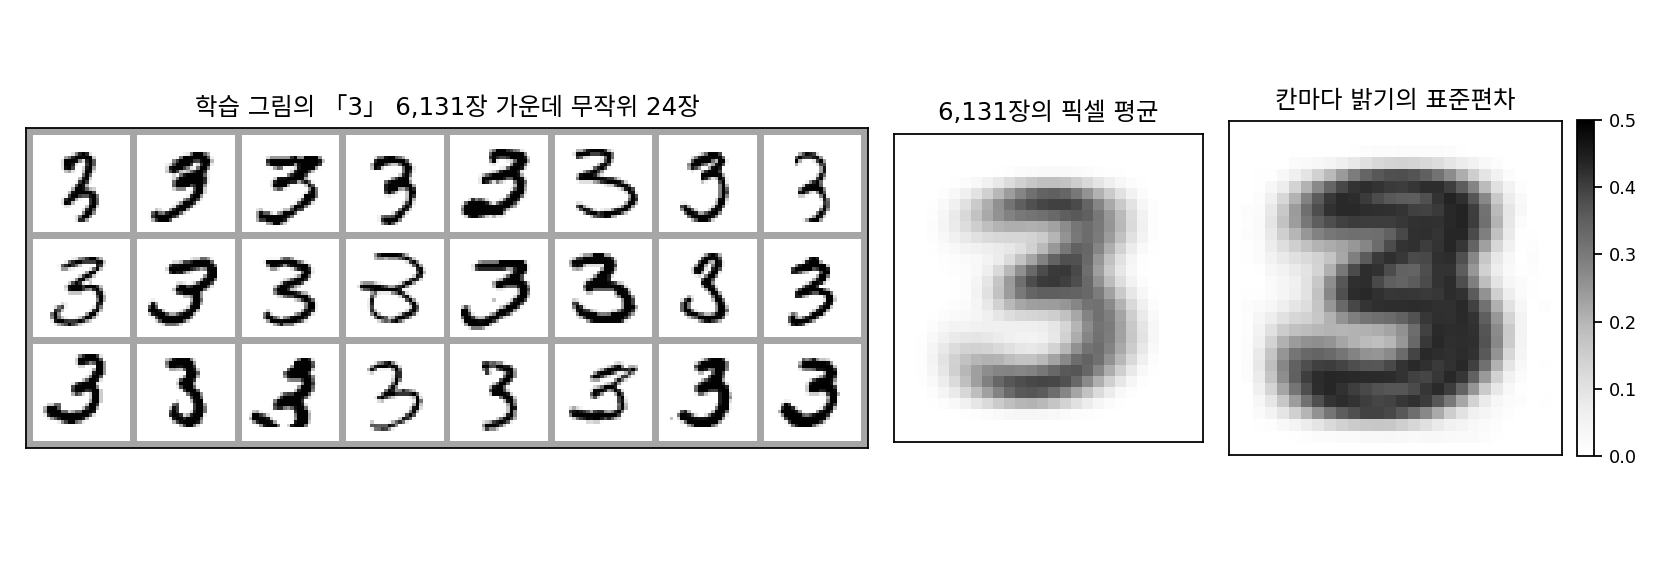
학습 그림에서 3을 두 장 무작위로 골라 784칸의 제곱 거리를 재면 평균 89.9다. 한편 3들의 평균 그림과 5들의 평균 그림 사이는 9.7, 3과 8의 평균 그림 사이는 13.2다. 아무 3 두 장이 「평균 3」과 「평균 5」보다 아홉 배쯤 멀다. 오른쪽 지도를 보면 다름은 어느 한 칸이 아니라 획이 지나가는 띠 전체에 퍼져 있다. 사람마다 획의 자리, 기울기, 굵기, 고리의 크기가 다르기 때문이다.
라벨이 정하는 몫과 남는 몫
학습 그림 60,000장이 얼마나 흩어져 있는지를, 그림마다 전체 평균 그림과의 제곱 거리를 재서 평균 내면 52.73이다. 라벨을 알면 전체 평균 대신 그 라벨의 평균 그림에서 재면 되고, 그러면 41.80이 남는다. 라벨이 줄여 준 몫은 10.93, 전체의 21%뿐이다. 이 셈을 식으로 적으면 이렇다.
두 몫이 그냥 더해지는 것은, 라벨마다의 평균에서 벗어난 몫이 그 라벨 안에서 평균 0이라 서로 곱한 항이 사라지기 때문이다.
남는 몫 41.80은 신경망 없이 데이터만으로 계산한 값이다. 그런데 라벨을 넣은 MLP의 학습 손실(그림 한 장의 784칸 제곱 오차 합의 평균)이 41.86이다. 신경망이 배운 끝이 데이터만 보고 계산한 남는 몫과 거의 같다.
반대 방향은 딴판이다. 같은 MNIST에서 분류기는 시험 그림의 94.8%에 0.9가 넘는 확률을 주고, 시험 그림의 교차 엔트로피는 0.077 nat이다(nat은 자연로그로 잰 정보의 단위. 0이면 정답을 확률 1로 맞힌 것). 그림을 보면 라벨은 거의 정해진다. 라벨을 보면 그림은 거의 정해지지 않는다.
이렇게 조건을 알아도 답에 남는 흩어짐, 모델이 아니라 데이터 자체에 들어 있는 흩어짐을 내재적 확률성 (데이터에 원래 들어 있는 흩어짐 / aleatoric uncertainty)이라 한다. 라벨 「3」 하나로는 흩어짐의 79%가 정해지지 않고, 그림을 내놓으려면 생성기가 이 몫을 어떻게든 채워야 한다. 라벨 안에는 그 몫을 정할 정보가 없다. 그러니 채우는 길은 3들이 흩어진 모양대로 골라 내는 것, 곧 뽑기뿐이다. 생성이 본래 무작위일 수밖에 없는 까닭이 여기에 있다.
ML에서: 모델을 키워도 남는 손실
언어 모델에서도 같은 몫이 숫자로 잡혔다. 호프만(Jordan Hoffmann)과 동료들은 2022년, 언어 모델의 손실을 「모델을 키우면 줄어드는 항」, 「학습 데이터를 늘리면 줄어드는 항」, 그리고 둘 다 줄이지 못하는 상수 항의 합으로 맞췄다. 상수 항은 토큰 하나에 1.69 nat이었고, 논문은 이 항을 「자연 글의 엔트로피」에 해당한다고 적었다. 앞 문맥을 다 알아도 다음 낱말이 하나로 정해지지 않는 몫이다.
문제 4. 두 반의 시험 점수
1반과 2반은 학생 수가 같다. 수학 시험 평균은 1반 70점, 2반 80점이고, 반 안에서 점수의 표준편차는 두 반 모두 10점이다. (가) 학생 한 명의 점수를 전교 평균 하나로 맞히면 제곱 오차의 평균은 얼마인가? (나) 몇 반인지 듣고 그 반의 평균으로 맞히면? (다) 학생 수를 두 배로 늘리면 (나)의 값이 줄어드는가?
전교 평균은 75점이고, 반 안 표준편차가 10이니까 (가)는 10² = 100이요.
2반 학생 하나를 75점으로 맞히면, 그 반 평균 80점에서부터 이미 5점 빗나가고 시작하지 않아요?
아, 반 평균이 전교 평균에서 5점씩 벗어난 것도 더해야 하네요. 100 + 5² = 125요.
(나)는 반 평균으로 맞히니까 반 사이의 몫 25가 빠지고 100이 남아. 반을 알려 줘서 줄어든 건 125 가운데 25, 20%야.
(다)는요?
학생이 많아지면 평균이 더 정확해지니까 줄지 않을까요?
반 평균은 처음부터 70점, 80점으로 알고 있었잖아. 더 정확해질 게 없어. 남은 100은 같은 반 안에서 학생마다 다른 몫이라, 몇 반인지만 들어서는 줄일 수가 없어.
MNIST에서 라벨이 흩어짐을 21%만 줄인 거랑 같은 셈이네요. 반이 라벨이고 점수가 그림이고요.
조교님이 「분반만 알려 주면 네 학점 맞혀 줄게」 하는 거랑 같아요. 분반 평균까지는 맞혀도 제 학점은 못 맞히죠.
문제 5. 남는 몫의 양 끝
학습 그림 x와 라벨 y의 흩어짐을 위 식처럼 「라벨이 정하는 몫」과 「남는 몫」으로 나눈다. (가) 학습 그림의 3 6,131장이 모두 한 장의 복사본이었다면 3의 남는 몫은 얼마인가? 그때 「3」을 받아 그림을 내놓는 일은 어떤 일이 되는가? (나) 라벨을 그림과 상관없이 무작위로 붙였다면 두 몫은 각각 얼마쯤이 되는가? (다) 실제 MNIST에서 라벨 하나 안의 흩어짐이 가장 작은 숫자는 1(22.5), 가장 큰 숫자는 2(50.8)다. 왜 그럴까?
(가)는 모든 3이 평균 그림과 똑같으니까 0이야.
그럼 그 3을 내놓는 생성기는 무엇을 하면 돼요?
그 한 장을 꺼내 주면 끝이죠. 뽑을 것도 없어요. 생성이라기보다 복사네요.
(나)는요?
라벨이 엉망이면 라벨이 정하는 몫이 더 커지지 않을까요? 라벨끼리 평균이 더 들쭉날쭉해질 것 같은데요.
반대 같아. 라벨을 아무렇게나 붙이면 라벨마다 0부터 9까지가 고루 섞이니까, 라벨마다의 평균 그림이 다 전체 평균 그림이랑 거의 같아져. 그러면 라벨이 정하는 몫은 0 가까이, 남는 몫은 전체 52.73 거의 다야.
실제 MNIST의 21%는 그 두 끝 사이 어디쯤이에요?
0 쪽에 훨씬 가까워요. 라벨이 정해 주는 건 일부고, 그림의 생김새 대부분은 라벨 밖에 있어요.
(다)는요?
1은 막대 하나라 사람마다 다르게 쓸 거리가 별로 없어요. 2는 아래에 고리를 넣는 사람도 있고 꺾는 사람도 있고요.
그러면 남는 몫이 라벨마다 다르구나. 생성기는 1을 그릴 때보다 2를 그릴 때 골라야 할 것이 두 배쯤 많은 거네.
두 몫이 그냥 더해지는 게 선형대수에서 직교하는 두 성분의 길이 제곱을 더하는 피타고라스랑 같아. 곱한 항이 0이라서 사라지는 것까지.
문제 6. 신경망을 아홉 배로 키우면
라벨을 넣고 그림을 받는 MLP를 10 → 256 → 784(매개변수 204,304개)에서 10 → 1024 → 1024 → 784(1,864,464개)로 키우고, 학습 그림 전체를 10번이 아니라 30번 돌렸다. 작은 MLP의 학습 손실은 41.86이었다. (가) 큰 MLP의 학습 손실은 얼마나 내려갈 것 같은가? (나) 실제로는 1번 돌린 뒤 42.12, 5번 41.95, 10번 41.87, 30번 41.83이었다. 무엇을 뜻하는가? (다) 「3」을 넣은 출력과 3들의 평균 그림 사이 제곱 거리는 작은 MLP가 0.09, 큰 MLP가 0.042다. 큰 MLP는 무엇을 더 잘하게 되었나?
매개변수가 아홉 배니까 꽤 내려가겠죠. 30 밑으로는 갈 것 같은데요.
(나)의 숫자를 데이터만으로 계산한 남는 몫 41.80 옆에 놓아 봐요.
41.83이면 41.80에서 0.03 위예요. 서른 번을 돌려도 거기 붙어서 안 내려가네요.
41.80은 라벨만 받는 함수라면 무엇이든 넘을 수 없는 바닥이야. 제곱 오차를 가장 작게 하는 답이 조건부 평균이었고, 조건부 평균에서 잰 오차가 바로 41.80이니까.
그럼 큰 MLP가 키운 덩치는 어디에 쓰였을까요? (다)를 봐요.
평균 그림에 더 바짝 붙었어요. 0.09가 0.042로요. 평균을 더 정확히 그리는 데만 쓰였네요. 흐린 건 그대로고요.
모델이 덜 배워서 생긴 오차는 모델을 키우고 데이터를 늘리면 줄어요. 데이터에 원래 있는 흩어짐은 줄지 않아요. 큰 MLP는 앞의 것을 거의 0으로 만들었고, 남은 41.8은 거의 다 뒤의 것이에요.
그럼 생성기가 할 일은 이 41.8을 줄이는 게 아니라, 이 흩어짐을 그대로 그려 내는 거네요. 손실 하나만 내려다보고 있으면 그게 안 보이고요.
시험 범위 밖에서 나온 문제는 밤새 공부해도 못 맞히는 거랑 같네요. 공부로 줄이는 몫과 공부로는 안 줄어드는 몫이 따로 있어요.