여러 머리 어텐션: 한 번에 여러 가지로 읽기
셀프 어텐션의 비중은 더해서 1이므로, 토큰 하나가 받아 가는 것은 늘 값들의 평균 하나다. 「a red cube on top of a blue sphere」에서 「cube」 토큰이 자기 색을 알려 주는 「red」도 읽고 싶고, 자기가 어디에 놓이는지 알려 주는 다른 낱말도 읽고 싶다고 하자. 두 값을 (1, 0)과 (0, 1)이라 하면, 비중을 반씩 나눈 평균은 (0.5, 0.5)다. 이 벡터만 보고는 「둘을 반씩 읽었다」와 「둘 다 아닌 무언가를 읽었다」를 가르기 어렵다. 한 토큰이 색과 자리처럼 여러 가지를 따로 한꺼번에 읽게 할 수는 없을까?
역사: 머리 하나로는 평균이 막는다
바스와니와 동료들은 질의·열쇠·값을 한 벌로 한 번에 쓰지 않고, 짧은 조각 여러 벌로 나눠 따로 어텐션을 건 뒤 이어 붙였다. 논문의 기본 모델은 폭 512를 64씩 여덟 벌로 나눴는데, 조각마다 길이가 8분의 1이라 계산량은 한 벌짜리와 비슷하다. 왜 나눌까? 논문은 「머리 하나로는 평균이 이것을 막는다」고 적고, 같은 계산량에서 벌 수만 바꿔 영어–독일어 번역을 비교한 표도 실었다. 한 벌이면 번역 점수(BLEU, 기계 번역을 사람 번역과 비교해 겹치는 낱말 묶음으로 매기는 점수)가 24.9, 여덟 벌이면 25.8, 열여섯 벌도 25.8, 서른두 벌이면 25.4였다. 나누는 것이 낫지만, 너무 잘게 나누면 조각 하나가 짧아져 다시 떨어진다.
머리마다 다른 것을 읽는다
학습된 모델의 머리들은 정말 서로 다른 것을 읽을까? 글 인코더로 많이 쓰는 CLIP ViT-L/14 의 글 쪽(12층, 층마다 12벌)에 「a red cube on top of a blue sphere」를 넣고 비중을 뽑았다. 이 인코더는 토큰이 자기와 앞 토큰만 읽도록 가려져 있다(마스크는 이 장 끝 절에서 다룬다).
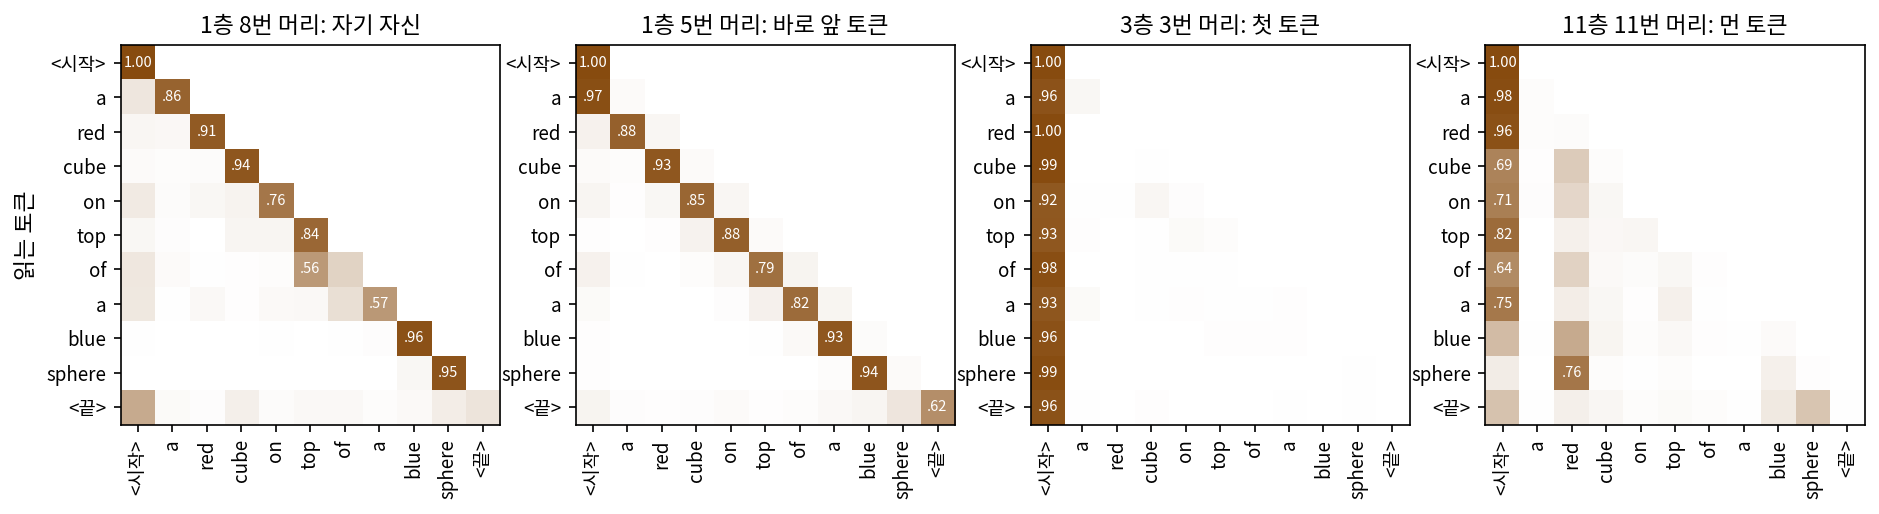
머리마다 읽는 방식이 뚜렷이 다르다. 한 머리는 「sphere」가 자기 자신에 0.95를 주고, 다른 머리는 「cube」가 바로 앞 「red」에 0.93, 「sphere」가 바로 앞 「blue」에 0.94를 준다. 셋째 머리는 거의 모든 토큰이 문장 첫 토큰에 0.9 넘게 준다. 뒤쪽 층의 한 머리에서는 「sphere」가 일곱 토큰 앞의 「red」에 0.76을 준다. 이렇게 질의·열쇠·값을 여러 벌로 나눠 벌마다 따로 비중을 매기고, 받아 간 것을 이어 붙여 다시 섞는 어텐션을 여러 머리 어텐션 (여러 벌로 나눠 따로 읽기 / multi-head attention)이라 하고, 한 벌을 머리라 부른다.
ML에서: 디퓨전 모델들의 머리
ComfyUI 설정으로 보면 Stable Diffusion 1.x 의 어텐션 블록은 단계와 상관없이 머리 8개를 쓴다. 폭이 320, 640, 1280이니 머리 하나의 길이는 40, 80, 160이다. SDXL 은 반대로 머리 하나의 길이를 64로 묶어 두고 폭에 따라 머리 수를 바꾼다(640이면 10개, 1280이면 20개, 설정 num_head_channels 64). FLUX.1 은 폭 3072를 머리 24개 × 128로 나누고, 그 128을 앞에서 본 회전 위치 인코딩의 16 + 56 + 56으로 쓴다. 머리 수는 「머리 몇 개로 나눠 읽을까」와 「머리 하나의 질의·열쇠가 얼마나 길까」를 맞바꾸는 설계 선택이다.
문제 7. 머리를 나누면 무엇이 늘고 무엇이 그대로인가
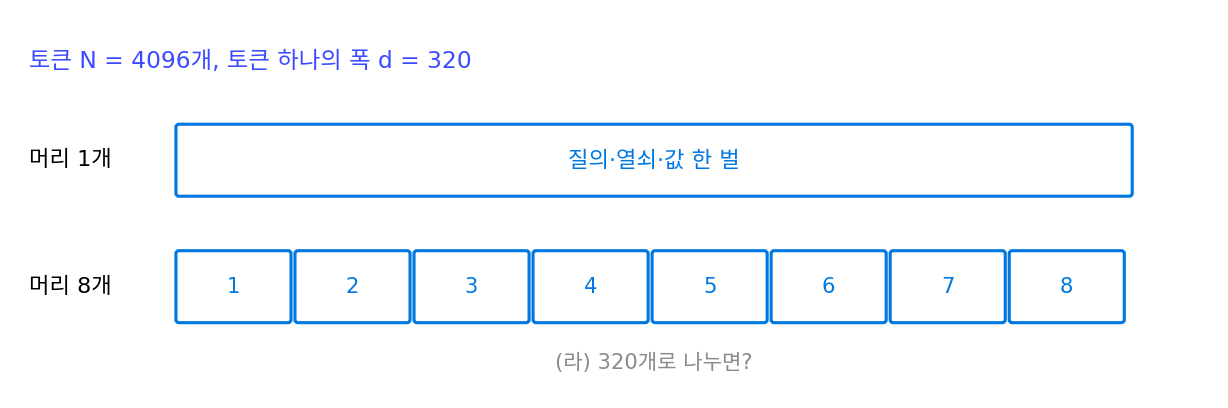
폭 d = 320, 토큰 N = 4096인 셀프 어텐션을 머리 1개와 8개로 짠다. (가) 행렬 WQ, WK, WV, WO의 파라미터는 각각 몇 개인가(바이어스 빼고)? (나) 점수를 매기는 곱셈은 몇 번인가? (다) 둘이 같다면 머리 8개는 무엇을 더 가진 것인가? (라) 머리를 320개로 나누면 어떻게 될까?
머리가 8개면 행렬도 8벌이니까 파라미터가 8배 아니에요?
머리 하나의 질의는 길이가 얼마죠? 그 질의를 만드는 행렬의 크기는요?
320 ÷ 8 = 40이니까 머리 하나는 320 × 40이에요. 여덟 개를 옆으로 붙이면… 320 × 320이네요.
결국 한 벌일 때와 같은 행렬을 여덟 칸으로 자른 거구나.
넷 합쳐 409,600개, 머리 수와 상관없어요.
(나)도 같아. 머리 하나면 4096² × 320번, 여덟이면 8 × 4096² × 40번, 둘 다 5,368,709,120번이야.
그럼 (다)는요? 셈은 같은데 무엇이 달라졌죠?
곱셈 수가 같으면… 다른 건 소프트맥스의 수예요. 한 벌이면 토큰마다 비중 분포가 하나고, 여덟 벌이면 여덟 개예요.
분포가 하나일 때와 여덟 개일 때, 토큰 하나가 읽을 수 있는 것은 어떻게 달라요?
하나면 평균을 하나밖에 못 내는데, 여덟 개면 서로 다른 토큰 여덟 곳을 동시에 거의 전부 읽을 수 있어요. 같은 재료로 평균을 여러 번 낼 권리를 산 거네요.
(라)는 머리 하나의 길이가 1이네요. 그럼 질의와 열쇠가 수 하나라 점수가 「q × k」 곱 하나예요. 무엇을 찾는지 수 하나로만 말해야 하니 너무 좁아요. 논문 표에서 32벌(머리 하나의 길이 16)이 16벌보다 떨어진 것도 머리 하나가 너무 짧아서겠네요.
그래요. 머리 수를 늘리면 머리 하나의 표현력을 내줘야 해요. 어느 쪽 끝도 좋지 않아요.
피자 한 판을 여덟 조각으로 나누면 피자 양은 그대로인데 여덟 사람이 각각 다른 토핑 쪽을 고를 수 있는 거네요. 320조각으로 자르면 한 조각에 토핑이 제대로 올라가지도 않고요.
문제 8. 머리마다 읽는 것을 평균 내면
위 그림의 CLIP 글 인코더에서 1층(0부터 세어 0층)의 머리 12개가 「cube」에서 「red」로 주는 비중은 0.123, 0.016, 0.323, 0.206, 0.930, 0.013, 0.544, 0.020, 0.090, 0.070, 0.112, 0.025다. (가) 머리 12개를 평균 내면 얼마인가? (나) 머리를 하나만 두었다면 그 머리는 「cube」 자리에서 「red」를 얼마나 읽었을까? 평균값이 그 답인가? (다) 「5번 머리는 형용사와 명사를 잇는 머리다」라고 말해도 되는가?
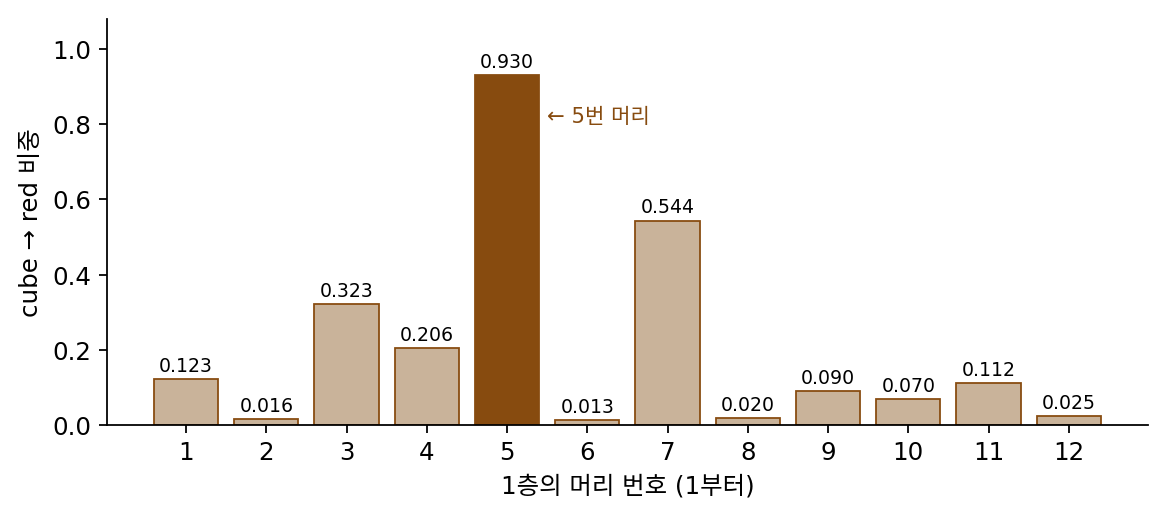
(가)는 다 더해서 12로 나누면 0.206이에요. 그럼 머리 하나였으면 0.206쯤 읽었겠네요.
머리를 평균 낸 비중은 어떤 소프트맥스에서 나온 값이죠?
어… 어떤 소프트맥스에서도 안 나왔어요. 머리마다 다른 점수로 따로 낸 비중을 제가 그냥 평균 낸 거예요.
머리를 하나만 두고 학습했다면 그 머리는 다른 행렬을 배웠을 테니까, 0.206은 아무 머리의 답도 아니야.
그래도 머리가 하나라면 못 하는 일은 말할 수 있어요. 「red」에 0.93을 주면 다른 토큰에 줄 비중은 얼마나 남죠?
얼마 안 남아요. 합이 1이니까 첫 토큰이나 자기 자신에 크게 줄 수 없어요. 지금은 그 일들을 다른 머리들이 나눠 맡고 있는 거네요.
(다)는요?
「blue sphere」에서도 5번 머리가 0.94였어요. 두 문장에서 다 형용사에서 명사로 크게 줬으니까, 형용사와 명사를 잇는 머리라고 해도 될 것 같은데요.
두 문장 다 형용사가 명사 바로 앞에 붙어 있잖아. 그냥 바로 앞 토큰을 읽는 머리여도 똑같이 나오지 않아?
그러네. 두 문장만으로는 어느 쪽인지 못 가려. 「a red」의 「red」가 바로 앞 「a」에 크게 주는지 봐야 알겠다. 내가 본 건 그 머리가 이 문장들에서 보인 읽기 경향뿐이었어.
그래요. 문장 하나의 비중 표는 그 머리가 이 문장에서 보인 읽기 경향을 엿보는 창이지 머리의 정의가 아니에요. 형용사와 명사를 잇는다고 말하려면, 형용사와 명사가 붙어 있지 않은 문장을 많이 넣어 봐야 해요.