밀도와 확률: 가장 진한 곳에 가장 많이 떨어지지는 않는다
이 장 첫머리의 3072차원 노이즈는 확률밀도가 가장 높은 원점 근처에 하나도 오지 않았다. 동전처럼 셀 수 있는 대상과 달리 노이즈는 연속적인 값을 갖고, 연속 분포에는 확률밀도(넓이나 부피 하나당 들어 있는 확률)가 있다. 밀도가 가장 높은 곳에 샘플도 가장 많이 모일까? 3072차원은 그릴 수 없으니, 눈으로 볼 수 있는 2차원 과녁부터 살펴보자.
다트판
실력자가 정중앙을 노리고 던지면, 다트가 중앙 둘레에 2차원 정규분포로 퍼진다고 하자. 표준편차는 σ(시그마) = 3cm다. 그렇다면 다트는 어디에 가장 많이 꽂힐까?
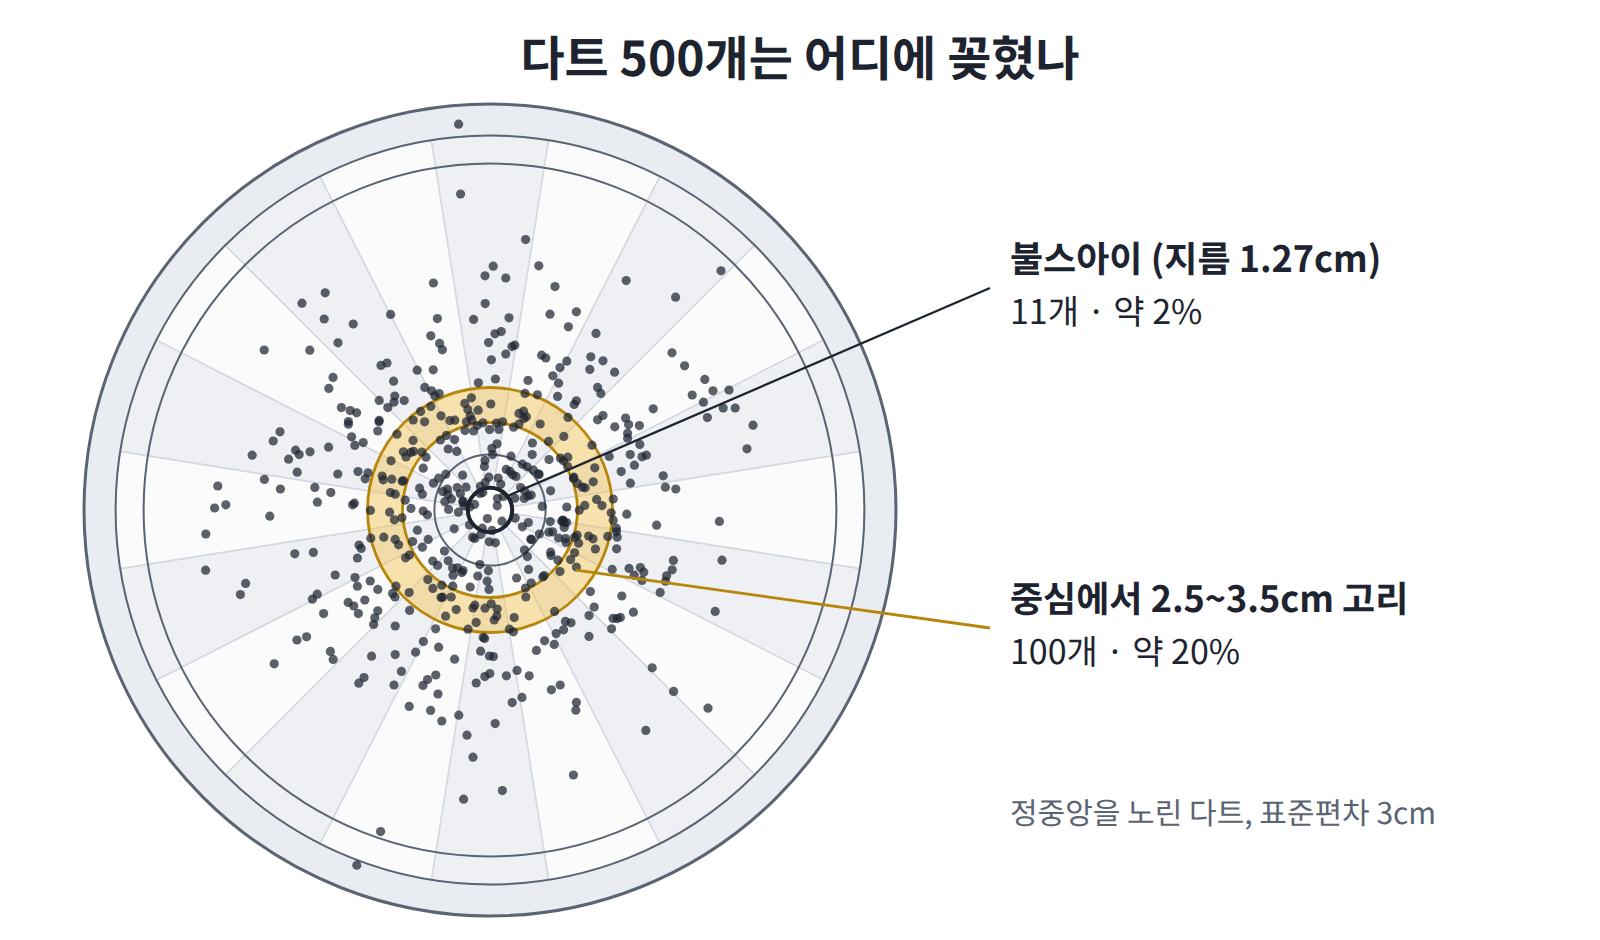
밀도만 보면 정중앙이 답이다. 그러나 정중앙 한 점은 넓이가 0이므로, 정확히 거기에 꽂힐 확률은 0이다. 그러므로 점이 아니라 실제 크기가 있는 영역끼리 비교해야 한다. 불스아이와 그 바깥의 고리 하나를 실제 크기로 비교하면 다음과 같다.
| 영역 | 넓이 | 밀도 (중심 대비) | 꽂힐 확률 |
|---|---|---|---|
| 불스아이 (지름 1.27cm, 실제 다트판의 정중앙) | 1.27 cm² | 1 | 약 2% |
| 중심에서 2.5~3.5cm 고리 | 18.9 cm² | 약 0.6 | 약 20% |
고리는 중심에서 떨어져 있으므로 밀도가 중심보다 낮다. 밀도로는 중심이 약 1.6배 높지만, 넓이가 약 15배 차이 나기 때문에 확률은 오히려 고리가 약 9배 높다. 곧 확률밀도가 가장 높은 곳과 확률이 가장 많이 모인 곳은 다르다. 어떤 영역에 떨어질 확률은 "밀도 × 그 영역의 넓이(부피)"이므로, 밀도가 높아도 넓이가 작으면 확률은 작고, 밀도가 조금 낮아도 넓이가 크면 확률은 커질 수 있다. 이를 일반적으로 쓰면, 2차원에서 중심으로부터의 거리가 r일 확률은 r·e^(−r²/2σ²)에 비례하고, 이것은 r = σ에서 최대가 된다. 다시 말해 가장 흔한 거리는 0이 아니라 표준편차 근처다.
동전과 견주어 보면 이 결과가 낯설지 않다. 밀도는 미시상태 하나의 확률에, 넓이는 그런 미시상태가 몇 개인지, 곧 경우의 수에 해당한다. 앞면 2개가 자주 나온 것이 경우의 수가 많아서였듯이, 고리에 다트가 많이 꽂히는 것도 고리의 넓이가 커서다.
ML에서: 가장 확률 높은 문장은 어색하다
LLM 디코딩에서도 같은 현상을 볼 수 있다. 매 단계 가장 확률이 높은 토큰을 고르는 방식(greedy, beam search)으로 얻은 문장은 반복적이고 부자연스럽다. 가장 확률이 높은 문장 하나는 불스아이처럼 "밀도"는 높지만, 사람이 실제로 쓰는 문장들은 조금씩 덜 그럴듯한 대신 그 수가 훨씬 많은 고리 쪽에 있기 때문이다. 확률이 높은 토큰 몇 개 안에서 무작위로 뽑는 nucleus sampling이 제안된 배경이 바로 이것이다 (Holtzman 외, “The Curious Case of Neural Text Degeneration”, 2019).
문제 12. 실력이 좋아진 선수의 다트
연습을 거듭해 정중앙을 노린 다트가 표준편차 1cm의 2차원 정규분포로 퍼지는 선수가 있다. 불스아이(지름 1.27cm)와 중심에서 2.5~3.5cm 떨어진 고리 가운데 어디에 더 많이 꽂히는가?
표준편차 3cm일 때 넓이가 15배인 고리가 9배 많이 받았잖아요. 과녁은 그대로니까 이번에도 고리죠. 밀도가 조금 낮아도 넓이가 이기니까요.
그 선수는 고리까지의 거리 3cm가 표준편차 한 개만큼이었어요. 이번 선수에게 3cm는 표준편차 몇 개예요?
세 개요. 그러면 고리의 밀도는 중심의 e^(−3²/2) = e^(−4.5) ≈ 0.011배, 1% 남짓이에요. 넓이 15배로는 못 메워요.

계산해 보니 불스아이가 약 18%, 고리가 약 4%네요. 이번에는 불스아이가 네 배 넘게 많아요. 넓이가 늘 이기는 게 아니었어요.

넓이 차이는 그대로 15배인데, 밀도 차이가 90배로 벌어졌으니까요. 고리가 이기느냐는 넓이만으로 정해지지 않고, 그 고리가 표준편차에 견주어 어디 있느냐로 정해져요. 그럼 이 선수의 다트는 어디에 가장 많이 몰릴까요?
가장 흔한 거리는 표준편차 근처니까 중심에서 1cm쯤이요. 0.5~1.5cm 고리를 계산하면 약 56%가 거기 꽂혀요.
과녁은 그대로인데 선수의 표준편차에 따라 답이 뒤집히네요. 같은 채점표라도 조교가 어느 점수대에 가장 많이 체크하게 될지는 그해 학생들 실력에 달린 거랑 같아요.
민준아, 다트판이 3072차원이면 r 대신 r³⁰⁷¹이 곱해지니까 전부 한참 바깥 고리에 꽂히겠다.
문제 13. 가장 그럴듯한 결과 하나와 가장 흔한 결과들
앞면 확률이 0.6인 동전을 10번 던진다. 확률이 가장 높은 결과(앞뒤 순서까지 정한 미시상태) 하나는 무엇이고 그 확률은 얼마인가? 앞면이 정확히 6개 나올 확률과 비교하라.
앞면이 60%니까 가장 그럴듯한 결과는 앞면 6개, 뒷면 4개인 결과 아니에요?
순서까지 정한 결과 하나의 확률을 직접 비교해 볼까요? HHHHHHTTTT 하나와 HHHHHHHHHH 하나요.
0.6⁶ × 0.4⁴ ≈ 0.0012이고, 모두 앞면은 0.6¹⁰ ≈ 0.0060이네요. 모두 앞면이 다섯 배나 높아요.

네. 결과 하나로는 모두 앞면이 가장 그럴듯해요. 그런데 앞면 6개인 결과는 C(10, 6) = 210가지라서, 묶으면 210 × 0.0012 ≈ 0.25예요. 모두 앞면이 실제로 나올 확률은 0.006뿐이고요. 다트판의 정중앙과 고리 이야기와 같아요. 한 점의 밀도는 정중앙이 가장 높지만 다트는 고리에 꽂히죠.
"가장 그럴듯한 하나"와 "실제로 나오는 것"이 다르다는 거네요.
문제 14. greedy 디코딩으로 뽑은 문장은 샘플에 나올까
언어 모델이 매 단계 가장 확률이 높은 토큰에 0.6을, 나머지 수많은 토큰에 합쳐서 0.4를 준다고 하자. 토큰 10개짜리 문장을 greedy로 만들면 그 문장의 확률은 얼마인가? 같은 모델에서 무작위로 샘플링하면, 10번 모두 1등 토큰이 뽑혀 greedy 문장과 같아질 확률은?
아까 동전 문제랑 같네요. 1등 토큰이 앞면이고요. greedy 문장은 모두 앞면인 결과니까 0.6¹⁰ ≈ 0.006이에요.
샘플링해서 greedy 문장이 나올 확률도 똑같이 0.006이야. 샘플 문장은 보통 1등 토큰이 여섯 개쯤이고 네 개쯤은 다른 토큰이 섞여.
둘 다 맞아요. greedy 문장은 모델이 보기에 가장 그럴듯한 문장 하나지만, 모델이 실제로 쓰는 문장들과는 모양이 달라요. 그래서 greedy나 beam search로 만든 문장이 반복적이고 밋밋하게 느껴지는 거예요.