고차원의 껍질: 샘플은 반지름 √d에 모인다
2차원 다트판에서도 가장 흔한 거리가 0이 아니었다. 그렇다면 확산 모델의 노이즈처럼 차원이 3072나 되면 어떻게 될까? 이 장 첫머리에서 노이즈의 노름이 거의 언제나 55.4였던 이유가 여기에 있다.
역사: 벨먼의 「차원의 저주」
1950년대 미국 랜드 연구소의 수학자 리처드 벨먼은 여러 단계에 걸쳐 결정을 내리는 문제를 푸는 방법(동적 계획법)을 만들었다. 이 방법을 컴퓨터로 돌리려면 문제의 상태를 나타내는 변수마다 값을 촘촘히 나눈 표를 채워야 하는데, 변수가 하나 늘 때마다 채울 값의 개수가 몇 배씩 불어났다. 변수 하나를 100등분하면 값 100개면 되지만, 같은 간격으로 변수 10개를 나누면 100¹⁰ = 10²⁰개가 된다. 벨먼은 1957년 책 『동적 계획법』(Dynamic Programming)에서 이 어려움을 「차원의 저주」라고 불렀다. 저차원에서 기른 직관이 고차원에서는 번번이 틀린다는 경고였다. 부피가 공의 겉껍질에 몰리는 아래의 현상도 그 직관이 틀리는 대표적인 경우다.
d차원의 반지름 분포
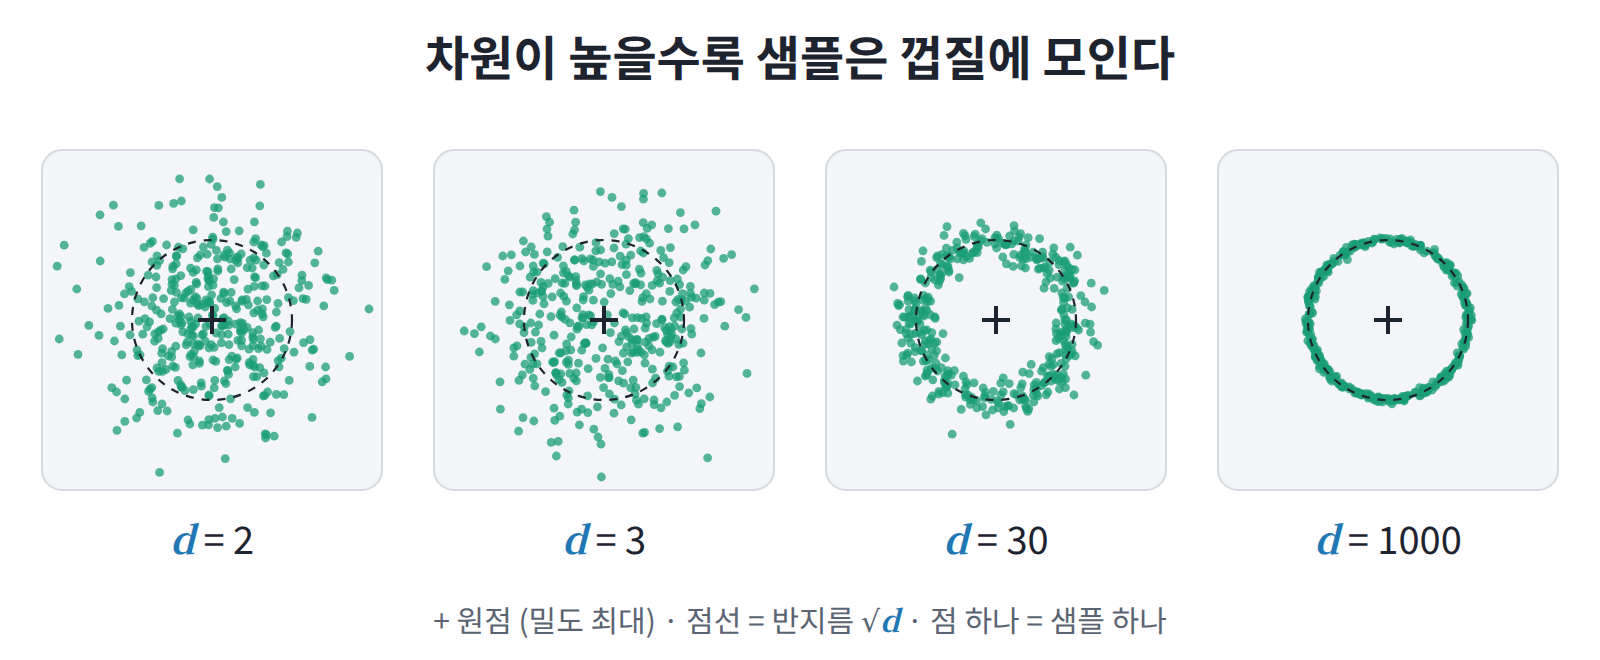
다트판의 고리에서 출발하자. 반지름 r, 폭 dr인 2차원 고리의 넓이는 둘레 2πr × 폭 dr이라 r에 비례한다. 3차원에서 두께 dr인 껍질의 부피는 겉넓이 4πr² × 두께 dr이라 r²에 비례한다. 차원이 하나 늘 때마다 r이 하나씩 더 곱해지므로, d차원에서 두께 dr인 껍질의 부피는 r^(d−1) dr에 비례한다. 그래서 d차원 표준정규분포에서 반지름이 r에서 r + dr 사이일 확률은 다음과 같다. 다트판의 "밀도 × 넓이"가 d차원에서는 "밀도 × 껍질의 부피"가 된다.

두 인수는 서로 반대로 움직인다. 밀도는 원점에서 최대이고 r이 커질수록 줄어드는 반면, 껍질의 부피는 원점에서 0이고 고차원에서는 r이 커질수록 매우 빠르게 늘어난다. 그러므로 두 인수의 곱은 원점도 아니고 아주 먼 곳도 아닌 어딘가에서 최대가 된다. 그 위치를 찾으려면 로그를 취해 미분하면 되는데, (d − 1)/r − r = 0, 즉 r ≈ √d에서 최대다.
고차원에서 부피가 바깥쪽에 몰리는 정도는 극단적이다. 이를테면 1000차원 공에서는 바깥쪽 두께 1%의 껍질이 전체 부피의 1 − 0.99¹⁰⁰⁰ ≈ 99.996%를 차지한다. 공의 부피가 사실상 모두 겉껍질에 들어 있는 셈이다.
좌표로 보면 동전 문제와 같다
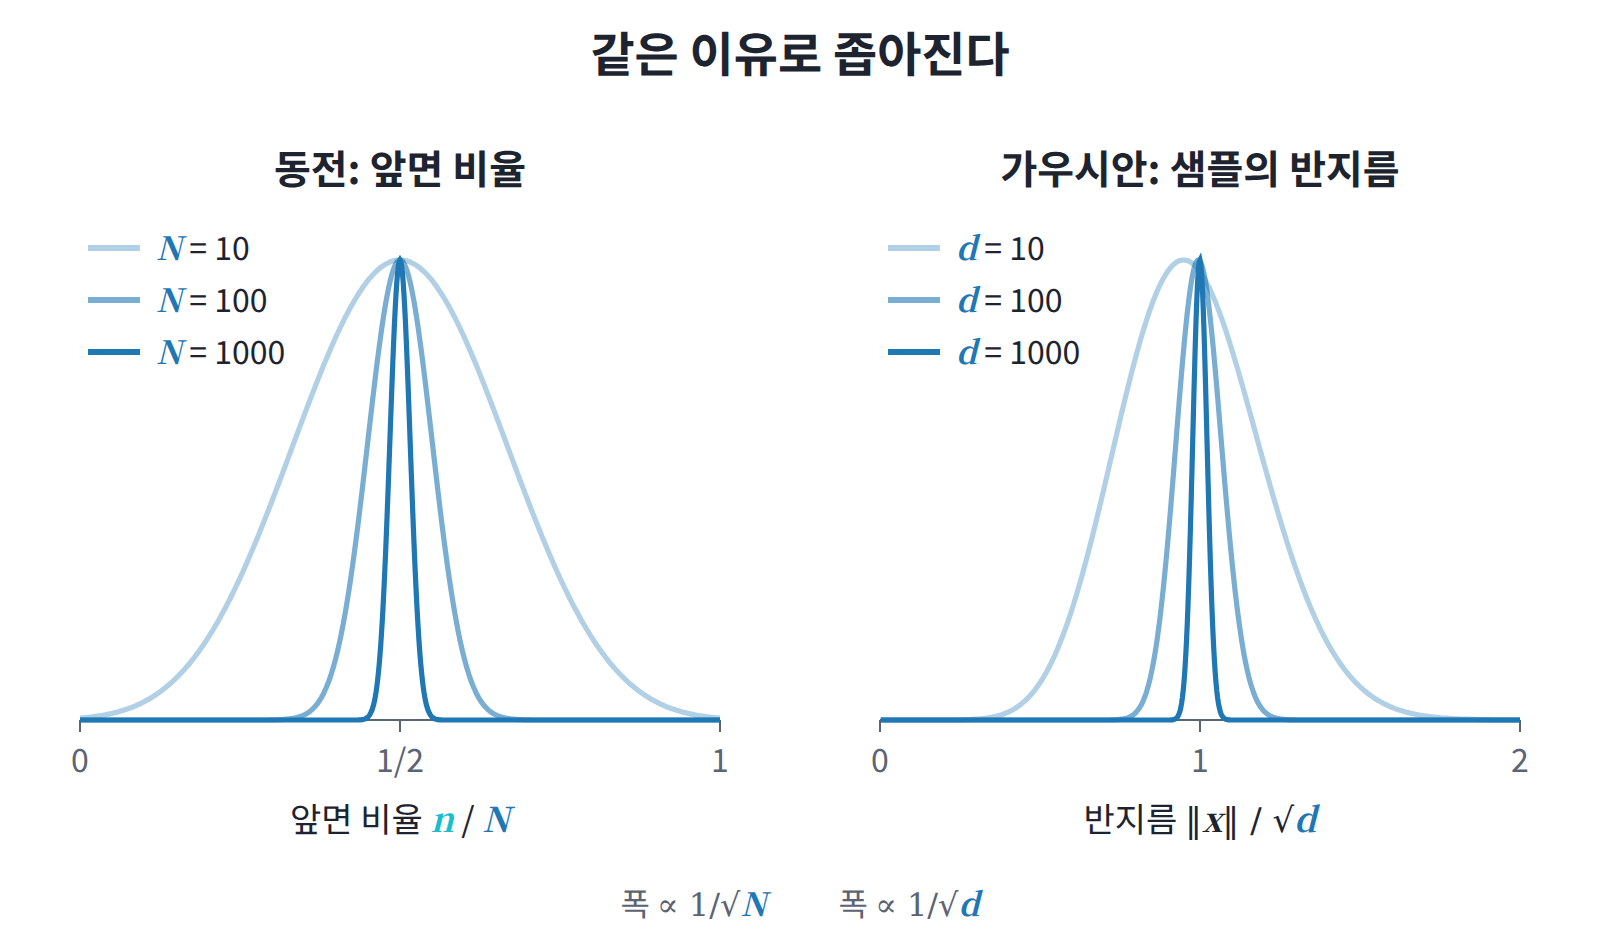
이 결과는 동전 문제와 같은 방식으로도 이해할 수 있다. ‖x‖² = x₁² + … + x_d²이고, 각 xᵢ²는 평균 1, 분산 2인 독립 변수다. 그러므로 ‖x‖²의 평균은 d, 표준편차는 √(2d)이고, 상대적 흔들림은 √(2/d)로 줄어든다. 동전 N개의 상대적 흔들림이 1/√N으로 줄어들었던 것과 같은 모양이다.
다시 말해 각 좌표가 동전 하나, ‖x‖²가 거시상태(앞면 개수)에 해당한다. 동전 100개가 50 근처에 몰리는 것과 같은 이유로 샘플이 반지름 √d 근처에 몰리는 것이다. ‖x‖²의 상대적 흔들림이 √(2/d)로 줄어드니, d가 커질수록 껍질은 반지름에 비해 상대적으로 얇아진다.
ML에서: 노이즈, 보간, 이상 탐지
고차원 샘플이 "가장 확률이 높은 점"이 아니라 "경우의 수가 많은 얇은 영역"에 있다는 사실은 ML 실무 곳곳에 나타난다. 정보이론에서는 이 영역을 전형 집합(샘플이 실제로 모이는 영역, typical set)이라 부른다.
가장 직접적인 예는 확산 모델의 노이즈다. 순수 노이즈 x ~ N(0, I)(좌표마다 평균 0, 분산 1인 표준정규분포. N은 normal의 머리글자이고 I는 단위행렬이다)는 원점이 아니라 반지름 √d의 껍질 위에 있다. 이를테면 CIFAR 크기(d = 3072) 이미지라면 노이즈의 노름은 약 55.4다.
이 사실은 두 노이즈 사이를 이어 중간 이미지를 만드는 잠재공간 보간에서 곧바로 문제를 일으킨다. 생성 모델의 잠재공간을 둘러보는 방법을 정리한 화이트(White, 2016)도 흔히 쓰던 직선 보간이 모델이 익힌 분포를 벗어난다고 지적했다. 두 샘플을 직선으로 이으면 중간점이 어디에 놓이고 어떻게 이어야 하는지는 아래 문제에서 계산해 보자.
이상 탐지(학습 데이터와 다른 입력을 가려내는 일, anomaly detection)에서는 이 차이가 더 또렷하게 드러난다. 개·트럭·말 같은 사물 사진(CIFAR-10)으로 학습한 생성 모델이 한 번도 본 적 없는 집 번지 숫자 사진(SVHN)에 오히려 더 높은 likelihood를 주는 현상이 보고되었다 (Nalisnick 외, “Do Deep Generative Models Know What They Don’t Know?”, 2019). 같은 연구진은 "밀도가 높다"와 "전형적이다"가 다르다는 점을 이용해, likelihood가 높은지 대신 학습 데이터의 likelihood가 보통 모이는 범위, 곧 전형 집합 안에 드는지로 판정하는 검정을 제안했다 (Nalisnick 외, “Detecting Out-of-Distribution Inputs to Deep Generative Models Using Typicality”, 2019).
세 경우는 분야가 서로 다르지만 같은 교훈을 준다. "한 점의 밀도"와 "그런 점이 얼마나 많은가"를 혼동하면 틀린 판단을 하게 된다는 것이다.
문제 15. 오렌지 껍질은 부피의 몇 %인가
지름 10cm인 공 모양 오렌지의 껍질 두께가 0.5cm다. 껍질은 오렌지 전체 부피의 몇 %인가? 같은 비율(반지름의 10%)의 껍질이 1000차원 공에서는 부피의 몇 %를 차지하는가?
껍질 두께가 반지름 5cm의 10%니까 부피도 10%요.
속살은 반지름 4.5cm인 공이죠. 공의 부피는 반지름의 세제곱에 비례하니까 속살은 전체의 몇 배예요?

0.9³ = 0.729배요. 그럼 껍질은 1 − 0.729 = 27%네요. 두께는 10%인데 부피는 거의 세 배예요.
d차원이면 0.9의 d제곱이 되니까, 1000차원에서는 0.9¹⁰⁰⁰ ≈ 2 × 10⁻⁴⁶. 속살은 사실상 없고 부피 전부가 껍질이에요.

피자도 테두리 1cm를 떼면 생각보다 많이 줄죠. 2차원에서도 1 − 0.9² = 19%예요. 차원이 오를 때마다 바깥쪽 몫이 불어나요.
문제 16. 고차원 샘플의 노름
x ~ N(0, I)이고 d = 3072일 때, ‖x‖는 대략 얼마이고 샘플마다 얼마나 흔들리는가? (풀어 본 뒤 위젯 3의 「문제 16~18」 단추로 확인해 보자.)
평균이 0이니까 ‖x‖도 0 근처 아니에요?

각 좌표 xᵢ의 평균은 0이지만, ‖x‖는 좌표를 제곱해서 더한 거라 음수가 될 수 없어요. 양수 3072개를 더한 게 0 근처일 수는 없죠. 평균이 0인 것과 크기가 0인 것은 다릅니다.
각 xᵢ²의 평균이 1, 분산이 2니까 ‖x‖²의 평균은 3072, 표준편차는 √(2 × 3072) ≈ 78.4. 그러니까 ‖x‖ ≈ √3072 ± 78.4 = 55.4 ± 78.4요.
그러면 ‖x‖가 음수가 되는 샘플도 흔하다는 뜻이 되는데요?
아… 78.4는 ‖x‖²의 흔들림이지 ‖x‖의 흔들림이 아니네요.
네. 제곱을 벗기면 흔들림도 바뀌어요. ‖x‖²이 Δ(델타)만큼 흔들리면 ‖x‖는 대략 Δ/(2‖x‖)만큼 흔들립니다. 78.4 / (2 × 55.4) ≈ 0.71이에요. 그러니까 ‖x‖ ≈ 55.4 ± 0.71. 3072차원 샘플은 거의 전부 반지름 55.4, 두께 1 남짓의 껍질 위에 있어요.
동전 3072개 던지면 앞면이 거의 1536개 근처에 오는 거랑 같은 거네요.
문제 17. 두 샘플 사이를 직선으로 이으면
x, y가 d = 3072인 N(0, I)에서 독립적으로 뽑은 두 샘플일 때, 중간점 (x + y)/2의 노름은 대략 얼마인가? 이미지 생성 모델에서 두 노이즈 사이를 이렇게 보간하면 어떤 문제가 생기는가?
둘 다 노름이 55.4니까 중간점도 55.4 아니야?
아니야. ‖x + y‖² = ‖x‖² + ‖y‖² + 2x·y인데, 독립인 고차원 벡터는 거의 직교해서 x·y ≈ 0이야. 그러니까 ‖x + y‖² ≈ 2 × 3072이고, 2로 나누면 ‖(x + y)/2‖² ≈ 3072/2. 노름은 √1536 ≈ 39.2.
서연 학생이 맞아요. 중간점은 반지름 55.4 껍질의 한참 안쪽, 39.2에 있어요. 문제 16에서 봤듯이 샘플은 55.4 ± 0.71에만 나오니까, 39.2는 모델이 학습 중에 한 번도 본 적 없는 영역입니다. 그래서 직선 보간한 중간 이미지가 흐리거나 색이 빠진 것처럼 나와요.
그럼 어떻게 이어야 해요?
서울에서 뉴욕까지 직선으로 가면 땅속을 뚫고 지나가죠. 비행기는 지구 표면을 따라 가는 가장 짧은 길(대권 항로)로 갑니다. 보간도 반지름을 유지하면서 껍질 표면을 따라가야 해요. 이게 구면 보간(slerp)이고, 생성 모델에서 노이즈를 보간할 때 표준처럼 쓰입니다.
결국 이 장 내내 같은 얘기네. 가장 밀도 높은 곳이나 평균 위치가 아니라, 경우의 수가 많은 곳에 샘플이 있다는 거.
문제 18. 껍질 위에서는 가까움을 무엇으로 재나
문장이나 이미지를 나타내는 벡터(임베딩)를 d = 3072차원 N(0, I)에서 뽑은 벡터처럼 생각하자(널리 쓰이는 문장 임베딩 모델인 OpenAI의 text-embedding-3-large도 3072차원 벡터를 낸다). (a) 서로 무관한 두 벡터 사이의 거리 ‖x − y‖는 대략 얼마이고 얼마나 흔들리는가? (b) 모든 벡터가 반지름 R인 껍질 위에 있을 때 ‖x − y‖²를 두 벡터 사이의 각 θ로 나타내라. (c) 고차원 벡터가 서로 비슷한지는 무엇으로 재는 것이 자연스러운가?
비슷한 벡터를 찾는 거면 거리를 재면 되잖아요. 가까울수록 비슷한 거죠.
그럼 무관한 두 벡터부터 재 봅시다. ‖x − y‖²을 펼치면 어떻게 되죠?
‖x‖² + ‖y‖² − 2x·y요. 문제 17처럼 무관한 고차원 벡터는 x·y ≈ 0이니까 2 × 3072 = 6144이고, 거리는 √6144 ≈ 78.4예요.
흔들림은요?
x − y는 좌표마다 분산이 2니까 ‖x − y‖²의 표준편차는 2√(2 × 3072) ≈ 157. 문제 16에서처럼 제곱을 벗기면 157 / (2 × 78.4) ≈ 1.0. 그러니까 78.4 ± 1.0이에요.
직접 200쌍을 뽑아 재 보니 전부 75.4에서 81.0 사이예요. 아무 두 벡터나 거리가 다 78 근처라는 거네요. 그럼 거리는 뭘 재고 있는 거예요?
그걸 따져 봐야죠. 방금 펼친 식에서 ‖x‖²과 ‖y‖²은 어떤 값이었죠?
샘플은 전부 껍질 위에 있으니까 둘 다 R²으로 정해져 있어요. 그러면 거리에서 실제로 바뀌는 건 x·y 하나뿐이고, x·y = R² cos θ니까 ‖x − y‖² = 2R²(1 − cos θ). 껍질 위에서는 거리가 결국 각도를 재고 있었네요.
그래요. 저차원이라면 반지름이 제각각이라 이 식은 특별한 경우일 뿐이지만, 고차원에서는 샘플이 거의 다 껍질 위에 있으니 거의 언제나 성립해요. 거리가 담은 정보는 각도 하나라는 거죠. 그러면 처음부터 각도를 재는 편이 낫겠죠. cos θ = x·y / (‖x‖‖y‖), 이것이 코사인 유사도(cosine similarity)예요. 무관한 두 벡터에서는 이 값이 얼마쯤 나올까요?
x·y는 평균 0, 분산 1인 곱 3072개의 합이니까 표준편차가 √3072이고, R² = 3072로 나누면 cos θ ≈ 0 ± 1/√3072 ≈ 0 ± 0.018이에요. 무관한 벡터끼리는 거의 직각이네요.
그러니 cos θ가 0.6인 쌍은 무관한 쌍들의 흔들림 0.018보다 30배 넘게 튀어나와 보여요. 같은 쌍을 거리로 재면 √(2 × 3072 × 0.4) ≈ 49.6이어서, 78.4 ± 1.0 무리에서 멀리 떨어져 있고요. 모두가 같은 껍질 위에 있으면 두 잣대는 같은 말을 해요. 그런데 실제 임베딩은 길이가 조금씩 제각각이에요. 민준 학생, x를 두 배로 늘린 2x와 x 사이의 거리는요?
‖2x − x‖ = ‖x‖ ≈ 55.4요. 방향이 똑같은데도 거리로는 코사인 0.6인 쌍(49.6)보다 더 멀게 나오네요. 코사인으로는 1인데요.
길이의 차이가 거리에 그대로 섞여 들어오는 거예요. 길이는 모델마다 뜻과 상관없는 이유로도 달라지니까, 방향만 보고 싶으면 길이로 나눠서 모두를 같은 껍질 위로 옮기면 돼요.
길이를 1로 맞추면 ‖x − y‖² = 2(1 − cos θ)니까, 그다음부터는 거리로 재든 코사인으로 재든 가까운 순서가 똑같아요. 정보는 처음부터 방향에 있었던 거네요.
그래서 임베딩 검색에서 벡터를 길이 1로 맞추고 내적으로 재는 거였구나! 고차원에서는 크기가 다 비슷비슷하니까 비슷함은 방향으로 재는 거예요.
선형대수 시간에 두 벡터의 사이각을 내적을 두 길이로 나눠 구했던 게 이거였네. 그때는 각을 구하는 공식일 뿐이었는데, 고차원에서는 그게 가까움을 재는 자였어.