최대 엔트로피 원리: 평균만 지키고 나머지는 가장 고르게
평균 4.5를 지키는 수열을 모두 똑같이 믿고 세었더니, 우리가 떠올린 어느 후보보다 엔트로피가 큰 분포가 나왔다. 세는 일은 원래 엔트로피가 가장 큰 분포를 고르게 되어 있는 것일까? 그렇다면 세지 않고도 그 분포를 곧바로 가리키는 규칙이 있을 것이다.
역사: 라플라스에서 제인스까지
정보가 부족할 때 확률을 어떻게 매길지는 확률론만큼 오래된 질문이다. 19세기 초 라플라스는 달리 생각할 이유가 없으면 모든 경우에 같은 확률을 주자고 했고, 이 규칙은 뒤에 이유 불충분 원리라 불렸다. 1877년 볼츠만은 전체 에너지가 정해진 기체 분자들의 배치(분자 하나하나가 어떤 에너지를 가졌는지 빠짐없이 적은 목록 하나. ML의 미니배치와는 다른 말)를 세어, 배치를 가장 많이 만드는 에너지 분포가 지수 모양임을 보였다. 합이 정해진 주사위 수열을 센 일도 이와 같은 구조다. 1948년 섀넌이 엔트로피를 정보의 양으로 정의하면서, 볼츠만이 센 경우의 수의 로그와 같은 꼴의 양이 「얼마나 모르는가」를 재는 말로도 쓰이게 되었다. 그러나 볼츠만의 계산이 사실은 「주어진 평균만 지키고 나머지는 모른다고 적는」 추론 규칙이라는 것이 분명해진 것은 20세기 중반의 일이다.
1957년 스탠퍼드의 물리학자 에드윈 제인스는 『피지컬 리뷰』에 낸 논문의 요약 첫머리에 이렇게 적었다. 「정보 이론은 부분적인 지식을 바탕으로 확률분포를 세우는 구성적인 기준을 주며, 최대 엔트로피 추정이라 불리는 통계적 추론으로 이어진다. 이것은 주어진 정보에서 가능한 가장 치우치지 않은 추정이다. 곧, 빠진 정보에 대해 최대한 아무것도 단정하지 않는다.」 그는 통계역학을 물리 이론이 아니라 추론의 한 예로 보자고 제안했다. 분배함수를 구하는 데서 시작하는 통상의 계산 규칙은 에르고드 가정(오래 기다리면 계가 가능한 상태를 고루 거친다는 가정) 같은 물리적 가설 없이도, 평균 에너지만 알려져 있을 때 엔트로피를 최대로 하는 분포를 고르라는 요구에서 곧바로 나온다는 것이다.
제인스는 이 원리를 라플라스의 규칙을 넓힌 것으로 소개했다. 최대 엔트로피 분포는 「달리 생각할 이유가 없다」는 소극적인 이유가 아니라 빠진 정보에 대해 최대한 아무것도 단정하지 않는 유일한 분포라는 적극적인 이유로 내세울 수 있고, 「달리 생각할 이유」, 곧 알려진 평균이 있을 때 라플라스의 규칙을 어떻게 고쳐야 하는지도 정확히 알려 준다는 것이다. 그가 여름학교에서 던진 평균 눈 4.5의 주사위 문제도 이 원리로 푼 예였다.
세어 보면 엔트로피가 가장 큰 조합이 이긴다
엔트로피가 가장 크다는 것은 세어서 설명할 수 있다. N번의 굴림에서 눈 1~6이 각각 n₁, …, n₆번 나오는 수열의 수는 N!/(n₁!⋯n₆!)이고, 굴림 수가 크면 이 수의 로그는 N × (비율 nₖ/N의 엔트로피)에 가깝다. 따라서 평균이 4.5인 여러 눈 개수 조합 가운데 가장 많은 수열이 몰리는 조합은 엔트로피가 가장 큰 조합이다. N = 1000에서 세어서 얻은 분포 모양의 조합 (55, 78, 114, 166, 239, 348)과 후보 라 모양의 조합 (24, 81, 138, 195, 252, 310)은 둘 다 눈의 합이 4500이지만, 앞의 조합을 만드는 수열이 뒤의 조합보다 약 5.06 × 10⁷배 많다. 엔트로피 차이 0.018 nat에 굴림 수 1000을 곱한 약 18이 지수에 올라간 셈이다(정확히 세면 ln(5.06 × 10⁷) = 17.7). 굴림 수가 늘수록 엔트로피가 가장 큰 조합 말고는 비교가 안 될 만큼 드물어진다.
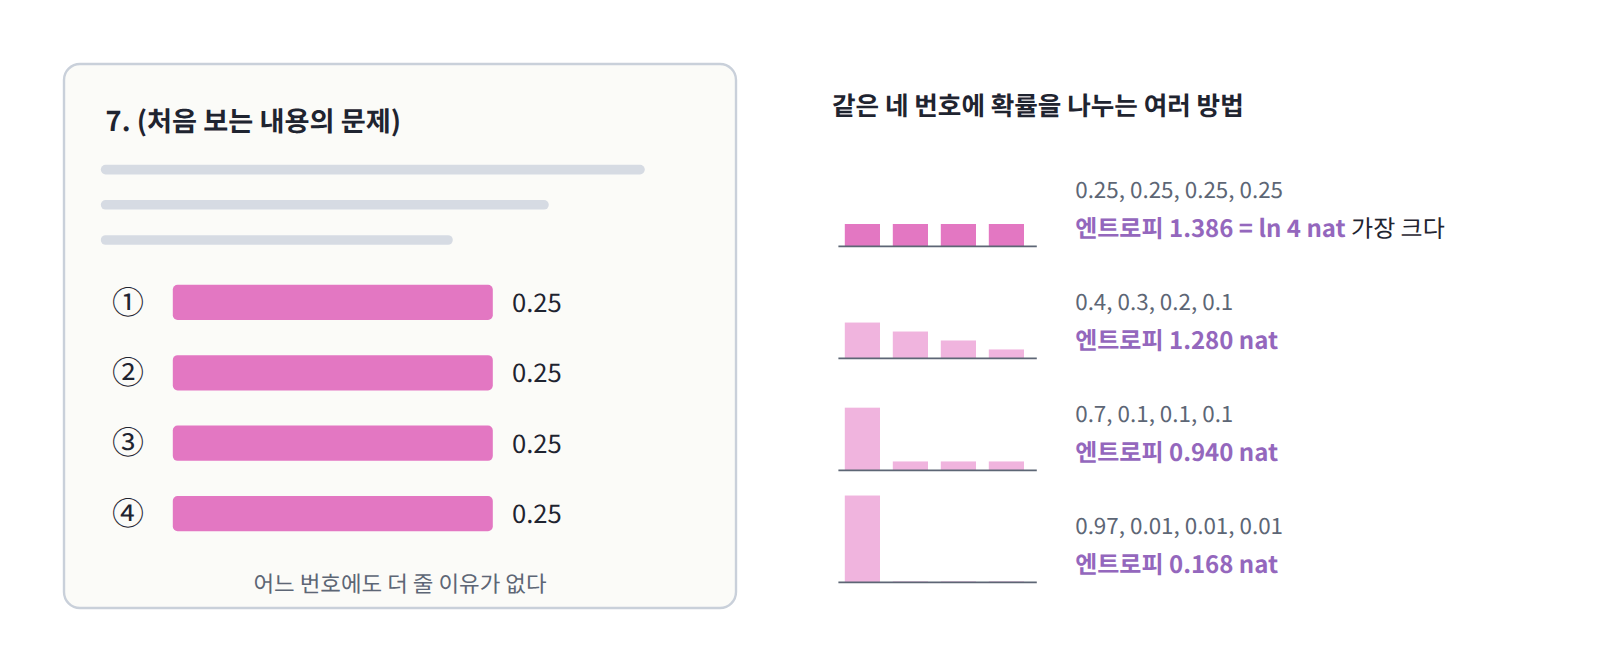
수열을 세는 일은 굴림 수가 늘수록 금세 감당할 수 없게 된다. 게다가 평균이 4.4로 바뀌거나, 눈이 여섯이 아니라 수백 가지인 문제(어휘 수만 개 가운데 다음 토큰 고르기처럼)를 만날 때마다 처음부터 다시 세야 한다. 그렇다면 세지 않고도 같은 답에 이르는 규칙을 적을 수는 없을까? 실마리는 평균조차 모를 때 우리가 하는 일에 있다. 사지선다 시험에서 전혀 모르는 문제를 만나면 우리는 네 번호에 4분의 1씩 확률을 준다. 이것이 라플라스의 규칙이고, 아무 제약이 없을 때 엔트로피가 가장 큰 분포가 균등 분포이므로 엔트로피를 최대로 하라는 말로 바꿔 적을 수 있다. 주사위 문제는 여기에 「평균 눈은 4.5」라는 정보 하나가 더해진 경우였고, 세어서 얻은 답은 그 평균을 지키는 분포 가운데 엔트로피가 가장 큰 분포였다. 두 경우를 한 문장으로 묶으면, 알려진 평균들을 모두 지키는 분포 가운데 엔트로피가 가장 큰 것을 고르라는 규칙이 된다. 이것이 최대 엔트로피 원리 (알려진 평균만 지키고 나머지는 가장 고르게, principle of maximum entropy)다. 엔트로피가 더 작은 분포를 고르면, 그만큼 주어지지 않은 정보를 가정한 셈이 된다.
ML에서: 아무것도 배우지 않은 분류기
막 초기화한 분류기는 입력을 보고도 어느 클래스인지 아직 아무것도 모른다. 사지선다에서 모르는 문제를 만난 수험생과 같은 처지인데, 이 원리를 따르면 그런 분류기는 어떤 예측을 내야 하고 그때 교차 엔트로피 손실은 얼마여야 할까? 아래 문제에서 실제 학습 첫 장면으로 따져 보자.
문제 2. 학습 첫 미니배치의 손실
(가) 클래스가 100개인 이미지 분류기를 막 초기화하고 첫 미니배치의 교차 엔트로피 손실을 찍었더니 9.8이 나왔다. 아무것도 배우지 않은 분류기라면 손실이 얼마여야 하는가? 9.8은 무엇을 뜻하는가? (나) 사기 거래 탐지처럼 양성이 10%, 음성이 90%인 이진 분류에서, 클래스 비율 말고는 아무것도 모르는 분류기는 어떤 예측을 내야 하고 그때 손실은 얼마인가? 출력이 sigmoid(마지막 층의 값)라면 마지막 층의 편향(bias 항)은 처음에 얼마로 두면 되는가?

처음에는 원래 손실이 크잖아요. 학습하다 보면 내려갈 테니 그냥 돌리면 될 것 같은데요.

아무것도 모르는 분류기라면 정답 클래스에 확률을 얼마 줘야 하죠?

100개 가운데 어느 것인지 전혀 모르니까 1/100씩이요. 그러면 손실은 어느 샘플에서나 −ln(1/100) = ln 100 = 4.605예요.
9.8이면 정답에 준 확률이 평균적으로 e^(−9.8) ≈ 0.00006쯤이라는 거네요. 1/100보다 백 배 넘게 작아요. 아무것도 모르면서 엉뚱한 클래스를 단정하고 시작한 거예요.

그래요. 그러면 학습 첫 몇백 걸음은 데이터를 배우는 게 아니라 그 근거 없는 단정을 지우는 데 쓰여요. 처음 손실이 ln 100 근처인지만 봐도 마지막 층 초기화가 잘못됐는지 알 수 있어요. 안드레이 카파시(Andrej Karpathy)가 2019년 블로그에 정리한 신경망 학습 요령에도 「처음 손실이 −log(1/클래스 수)인지 확인하라」는 항목이 있어요.
공부 안 한 과목 시험에서 다 찍어도, 보기가 넷이면 25%는 맞아야 정상이죠. 10%가 나왔다면 찍는 요령부터 잘못된 거고요.

(나)는 클래스가 둘이니까 반반이고, 기준 손실은 ln 2 = 0.693이죠.

양성이 10%라는 건 알고 있지 않나요?
아, 그게 알려진 평균이에요. 양성이면 1, 음성이면 0인 표시의 평균이 0.1이라는 것 하나를 지키고 나머지는 가장 고르게 두면 되는데, 클래스가 둘뿐이니까 그 평균이 곧 분포예요. (0.1, 0.9)를 예측하고, 손실은 −0.1 ln 0.1 − 0.9 ln 0.9 = 0.325예요. 반반으로 예측하면 데이터가 어떻든 손실이 0.693이니까, 시작부터 0.37 nat을 거저 잃는 셈이고요.
sigmoid(b) = 0.1이 되려면 b = ln(0.1/0.9) = −2.197이에요. 아는 비율만큼은 처음부터 믿고 시작하는 거네요.

카파시의 같은 글에도 양성과 음성이 1 대 10이면 처음부터 0.1쯤을 예측하도록 편향을 두라는 항목이 있어요. 모르는 건 고르게, 아는 비율은 그대로. 이 절에서 세운 원리 그대로예요.