지수족: 평균 여러 개를 지키는 분포
지금까지는 알려진 평균이 에너지 하나뿐이었다. 그런데 데이터에서 평균을 하나만 재는 일은 드물다. 회귀의 잔차라면 평균과 제곱 평균을 함께 재고, 분류라면 입력의 특징마다 클래스별 평균을 잰다. 평균을 둘, 셋 알게 되면 답의 모양은 어떻게 바뀔까?
역사: 몇 개의 수로 데이터를 요약하기
1920년대 초 피셔는 표본 전체를 들고 다니지 않고 몇 개의 수로 요약해도, 분포를 정하는 매개변수에 대해 잃는 것이 없는 경우를 따로 가려냈다. 이런 요약을 충분통계량이라 한다. 정규분포라면 표본이 백 개든 만 개든 표본의 합과 제곱합 두 수만 들고 있으면, 평균과 분산을 추정하는 데 필요한 것을 모두 가진 셈이다. 그렇다면 어떤 분포가 이런 성질을 가질까? 1935년과 1936년에 다르무아, 쿠프먼, 피트먼이 서로 따로 답을 냈다. 값이 나올 수 있는 범위가 매개변수에 따라 바뀌지 않는 분포 가운데, 표본이 아무리 늘어도 정해진 개수의 수로 요약할 수 있는 것은 지수 모양의 분포들뿐이었다. 데이터를 몇 개의 평균으로 요약해도 되는 분포와, 몇 개의 평균만 알 때 고르는 최대 엔트로피 분포가 같은 모임이라는 것은 아래 계산에서 드러난다.
평균과 제곱 평균을 함께 알 때
공정한 주사위처럼 평균 눈은 3.5인데, 눈의 제곱 평균은 공정한 주사위의 15.17보다 큰 15.5라는 것까지 안다고 하자. 제곱 평균이 크다는 것은 1이나 6처럼 가운데서 먼 눈이 더 자주 나온다는 뜻이다. 두 평균을 함께 지키면서 엔트로피가 가장 큰 분포를 구하면 (0.197, 0.160, 0.144, 0.144, 0.160, 0.197)로, 가운데가 낮고 양 끝이 높은 대칭 모양이 나온다. 이 분포의 로그를 눈 k로 적으면 ln p = (상수) + 0.0525 × (k − 3.5)²이고, 펼치면 눈 k와 그 제곱 k²의 일차식이다. 평균 하나만 알 때 확률의 로그가 눈의 일차식이었듯, 평균 둘을 알면 확률의 로그가 그 두 양의 일차식이 된다.
제약이 여러 개일 때
일반적인 계산도 같다. 상태 x의 함수 φ₁(x), φ₂(x), …의 평균이 각각 φ̄₁, φ̄₂, …로 알려져 있으면, 제약마다 승수 θₐ를 하나씩 붙여 같은 미분을 하면 된다. 확률의 로그가 φₐ들의 일차식이 되어 다음 모양의 분포를 얻는다.
이런 분포들의 모임을 지수족 (평균 몇 개로 정해지는 최대 엔트로피 분포의 모임, exponential family)이라 한다. 평균을 아는 함수 φₐ는 모델이 데이터에서 넘겨받는 것이 이 평균들뿐이라는 뜻에서 통계학에서는 충분통계량이라고도 부른다. 에너지를 E = −Σθₐφₐ로 쓰면 볼츠만 분포와 같은 모양이므로, 특징 φₐ는 에너지 자리에 서는 양이고 승수 θₐ는 그 특징에 붙은 역온도다. 어떤 평균을 아느냐에 따라 익숙한 분포들이 모두 이 모양으로 나온다.
| x가 가질 수 있는 값 | 알려진 평균 | 최대 엔트로피 분포 | ML에서 만나는 모습 |
|---|---|---|---|
| 유한 개 | 없음 | 균등 분포 | 학습 전의 균등 예측 |
| 유한 개 | ⟨E⟩ | 볼츠만 분포 | softmax (E = −로짓) |
| 0 또는 1 | ⟨s⟩ | 베르누이 분포, 확률 = sigmoid(θ) | 이진 분류 |
| 실수 | ⟨x²⟩ | 평균 0인 정규분포 | E_θ = θx²/2, MSE 손실 |
| 실수 | ⟨x⟩, ⟨x²⟩ | 정규분포 | 가우시안 출력층 |
| 실수 | ⟨∣x∣⟩ | 라플라스 분포 | MAE (L1) 손실 |
| 0 이상 실수 | ⟨x⟩ | 지수분포 | 사건 사이의 대기 시간 |
실수 전체에서 아무 평균도 모르면 최대 엔트로피 분포가 없다. 무한히 넓은 곳에 고르게 퍼진 분포는 정규화할 수 없으므로 퍼진 정도를 알려 주는 평균이 적어도 하나 있어야 하고, E_θ = θx²/2도 θ가 0 이하이면 정규화할 수 없다.
ML에서: 출력층은 어떤 평균을 넘겨받을지 고르는 일
표의 오른쪽 칸처럼 ML에서 흔히 쓰는 출력층은 대부분 어떤 평균을 지키는 최대 엔트로피 분포다. 이진 분류의 sigmoid는 ⟨s⟩ 하나를, softmax는 ⟨E⟩를, 가우시안 출력층은 ⟨x⟩와 ⟨x²⟩를 지킨다. 그래서 출력층과 손실을 고르는 일은 데이터에서 어떤 평균을 넘겨받고 나머지는 단정하지 않을지를 고르는 일이기도 하다.
문제 5. 6이 나올 확률만 알 때
평균 눈 대신 「6이 나올 확률이 0.3」이라는 것만 알려진 주사위가 있다. 최대 엔트로피 분포를 구하고, 이것을 특징 φ(i) = (i가 6이면 1, 아니면 0)의 지수족으로 적을 때 승수 θ를 구하라. 이 분포의 평균 눈은 얼마인가?
6이 자주 나온다는 건 큰 눈 쪽으로 치우쳤다는 거니까, 평균 4.5 문제처럼 눈이 커질수록 확률이 같은 비율로 늘어나게 하면 되겠죠. 6을 0.3에 맞추고 나머지를 지수로 깔면…

잠깐, 1부터 5까지에 대해서는 아무것도 안 들었잖아. 5가 1보다 자주 나온다는 건 어디서 온 거야? 남은 0.7을 다섯 눈이 0.14씩 똑같이 나눠야지.

서연 학생 말대로 해 보고, 그게 정말 지수족 모양인지 확인해 볼까요?
특징이 6인지 아닌지뿐이니까 p ∝ e^(θφ)는 1~5에서 모두 1이고 6에서만 e^θ예요. 1~5가 같은 확률을 갖는 게 자동으로 나오네요. e^θ = 0.3/0.14이니까 θ = ln(0.3/0.14) = 0.762이고, 엔트로피는 1.737이에요.
평균 눈은 0.14 × (1 + 2 + 3 + 4 + 5) + 0.3 × 6 = 3.9네요. 지수 모양이라고 해서 늘 눈에 대한 지수인 게 아니었어요. 지킨 평균의 특징에 대한 지수고, 특징이 구별하지 않는 눈끼리는 끝까지 같은 확률이에요.
6이 아닐 때로 조건을 걸면 나머지 다섯 눈은 균등하니까, 정보가 닿지 않는 곳에서는 라플라스의 규칙이 그대로 살아 있는 거네.
문제 6. MSE와 MAE는 무엇을 믿는가
회귀 모델의 잔차가 {−2, −1, 1, 2}로 나왔다. (가) 잔차의 제곱 평균만 알 때와 절댓값 평균만 알 때의 최대 엔트로피 분포를 각각 구하고, 그 분포로 잰 잔차의 평균 음의 로그우도를 비교하라. (나) 잔차에 10이 하나 더해지면 어떻게 되는가?
MSE는 미분이 매끄러워서 쓰고 MAE는 이상치(outlier, 무리에서 크게 벗어난 값)에 강해서 쓰는 거잖아요. 손실 고르는 데 최대 엔트로피가 무슨 상관이에요?
계산부터 해 봐요. 제곱 평균만 알 때의 분포가 뭐였죠?
실수 위에서 ⟨x²⟩만 알면 평균 0인 정규분포예요. ⟨x²⟩ = 2.5니까 N(0, 2.5)이고, 평균 음의 로그우도는 ½ ln(2πe × 2.5) = 1.877이에요. 절댓값 평균만 알면 p ∝ e^(−|x|/b)인 라플라스 분포이고, ⟨|x|⟩ = 1.5가 b가 돼서 1 + ln(2b) = 1 + ln 3 = 2.099예요. 둘 다 그 분포의 엔트로피랑 똑같이 나오네요.

MSE를 줄이는 것은 잔차가 정규분포를 따른다고 두고 최대우도를 하는 것과 같고, MAE를 줄이는 것은 라플라스 분포로 두는 것과 같아요. 최대 엔트로피로 읽으면 MSE는 「잔차에 대해 제곱 평균 말고는 아무것도 믿지 않겠다」는 선택이고, MAE는 「절댓값 평균만 믿겠다」는 선택이에요.

6이 나올 확률만 알 때 지수가 눈이 아니라 「6인가」라는 특징에 붙었던 거랑 같네요. 여기서는 특징을 x²으로 고르느냐 |x|로 고르느냐가 분포 모양을 정하고요.
(나)를 해 볼게요. 10이 들어가면 제곱 평균은 (4 + 1 + 1 + 4 + 100)/5 = 22로 뛰어서 정규분포 쪽은 2.964, 절댓값 평균은 16/5 = 3.2라 라플라스 쪽은 1 + ln 6.4 = 2.856이에요. 아까는 정규분포가 이겼는데 이번엔 라플라스가 이겼어요. 이상치에 강하다는 게 이 말이었네요.
제곱 평균은 10 하나 때문에 2.5에서 22로 아홉 배 가까이 뛰는데, 절댓값 평균은 1.5에서 3.2로 두 배쯤만 늘어. 어떤 평균을 믿느냐가 이상치 하나에 모델이 얼마나 흔들리는지를 정하는 거야.
조교님이 과제마다 정답과의 차이를 제곱해서 평균 내면, 크게 틀린 과제 하나가 학기 평가 전체를 끌고 가는 거랑 같네요.
문제 7. 왜 하필 엔트로피인가
서연은 「고르게 퍼진 정도」를 엔트로피 대신 확률의 제곱합 Σpᵢ²로 재자고 제안했다. 제곱합이 작을수록 고르게 퍼진 분포이기 때문이다. (가) 평균 눈 4.5를 지키면서 Σpᵢ²를 가장 작게 하는 분포를 구하고 최대 엔트로피 분포와 비교하라. (나) 굴림 1000번의 눈 개수 조합으로 두 분포를 비교하라. (다) 서로 아무 관계가 없는 주사위 두 개가 각각 평균 4.5라는 것을 알 때, 두 주사위의 결합 분포(joint)를 한꺼번에 골라 보라. 두 기준은 어떻게 다른가?
엔트로피는 로그가 들어가서 번거로운데, 제곱합은 이차식이라 라그랑주 승수를 쓰면 pᵢ가 눈의 일차식으로 바로 나와요. 풀면 (0.024, 0.081, 0.138, 0.195, 0.252, 0.310)이에요. 첫 절 표의 후보 라, 곧 확률이 눈에 대해 곧은 선으로 늘어나는 분포네요. 엔트로피도 1.595라서 최대 엔트로피 분포의 1.614와 거의 같아요. 이 정도면 취향 차이 아닌가요?
거의 같다고? (나)는 아까 셌잖아. 굴림 1000번에서 지수 모양 조합을 만드는 수열이 곧은 선 모양 조합보다 5.06 × 10⁷배 많았어. 5천만 배면 취향 차이치고는 좀 크지 않냐?
그건 수열을 세서 비교한 거잖아. 경우의 수를 세는 논증은 처음부터 엔트로피에 유리하게 짜여 있어. 수열을 똑같이 믿는다는 가정 자체를 받아들이지 않으면 제곱합도 얼마든지 쓸 수 있는 거 아니야?

좋은 반론이에요. 그럼 세는 이야기는 빼고 (다)로 가 봐요. 두 주사위는 서로 아무 관계가 없어요.
결합 분포는 36칸이고 제약은 첫 주사위의 평균 4.5, 둘째 주사위의 평균 4.5예요. 확률이 음수가 되지 않게 하고 제곱합을 최소화하면… 어? 첫 주사위의 분포가 (0.040, 0.077, 0.124, 0.184, 0.253, 0.322)로 나와요. 주사위 하나만 볼 때는 (0.024, 0.081, …)였는데 옆에 주사위 하나를 더 놓았을 뿐인데 답이 바뀌었어요. 게다가 둘 다 1이 나올 확률이 정확히 0이에요.
그러니까 첫 주사위가 1이면 둘째는 절대 1이 안 나온다는 거네. 서로 아무 관계도 없다며. 옆 분반 시험 결과를 듣고 우리 분반 점수 예상을 바꾸는 거랑 뭐가 달라.
공분산도 −0.59로 음수예요. 제곱합 기준이 없던 상관을 만들어 냈어요.
최대 엔트로피로 같은 문제를 풀면요?
제약이 두 개니까 p(i, j) ∝ e^(θ₁i + θ₂j) = e^(θ₁i) × e^(θ₂j)로 곱으로 쪼개져요. 각 주사위의 분포는 하나만 볼 때와 똑같은 (0.054, 0.079, …)이고, 둘은 독립으로 남아요. 지수는 합을 곱으로 바꾸니까 독립인 제약이 독립인 분포를 만들고, 제곱합은 그렇게 쪼개지지 않으니까 곱을 못 만드는 거네요.
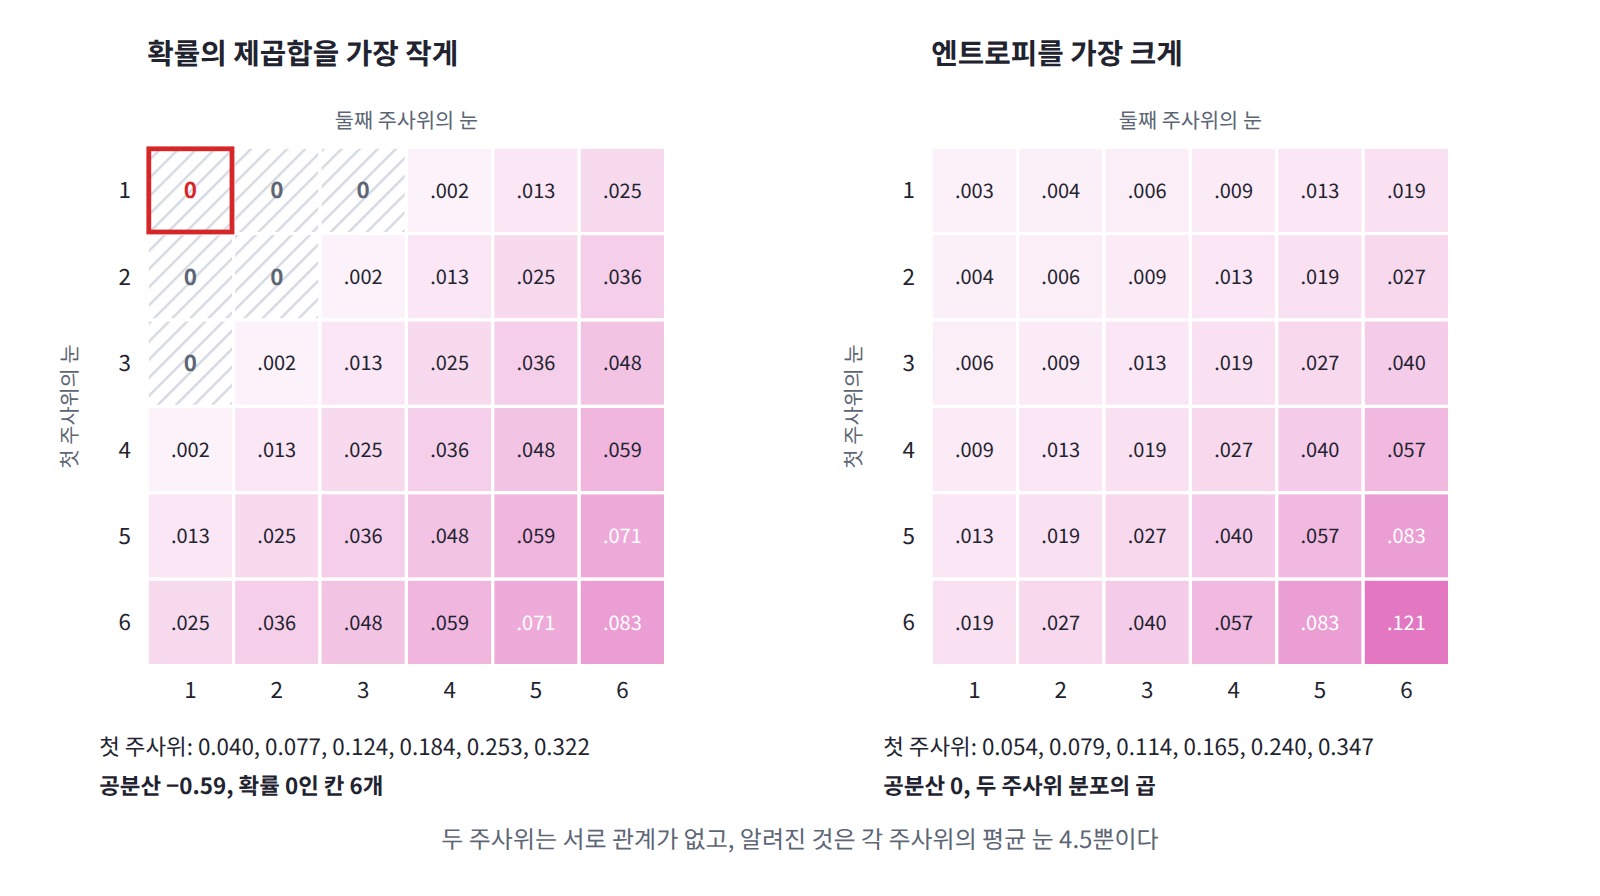
쇼어와 존슨(1980)은 일관된 추론 규칙이라면 지켜야 할 요구 네 가지를 적었어요. 답이 하나로 정해질 것, 상태의 이름이나 좌표를 바꿔도 답이 같을 것, 독립인 계에 대한 정보는 따로 쓰든 합쳐서 쓰든 같은 답을 줄 것, 상태의 일부에 대한 정보는 그 부분 안에서만 쓰든 전체에서 쓰든 같은 답을 줄 것. 그리고 이 네 요구를 모두 지키는 기준은 엔트로피 하나뿐이고, 평균을 듣기 전부터 믿던 분포가 따로 있으면 그 분포에서 멀어진 정도를 재는 상대 엔트로피 하나뿐이라는 것을 보였어요. 방금 제곱합이 깨뜨린 것이 셋째 요구예요.
수열을 세는 논증을 믿지 않아도, 관계없는 것은 관계없게 두라는 요구만으로 엔트로피가 남는다는 거네요. 세는 쪽에서 와도, 공리 쪽에서 와도 같은 곳에 도착하고요.
그럼 제곱합은 주사위 하나에서만 그럴듯해 보였던 거네. 너 아까 취향 차이라고 했지?
한 번 틀린 걸로 제곱까지 할 필요는 없잖아.