KL의 방향: 근사가 참 분포보다 좁아지는 까닭
질서 쪽으로 틀리는 것은 자석만의 사정일까? 이 장 첫머리의 사후분포(잠재변수 두 개의 상관계수가 0.9인 정규분포)에는 격자도 이웃도 없는데, 좌표 상승으로 찾은 곱 분포는 참 분포보다 좁아졌다. 어느 쪽으로 틀릴지는 무엇이 정할까?
봉우리 둘을 정규분포 하나로
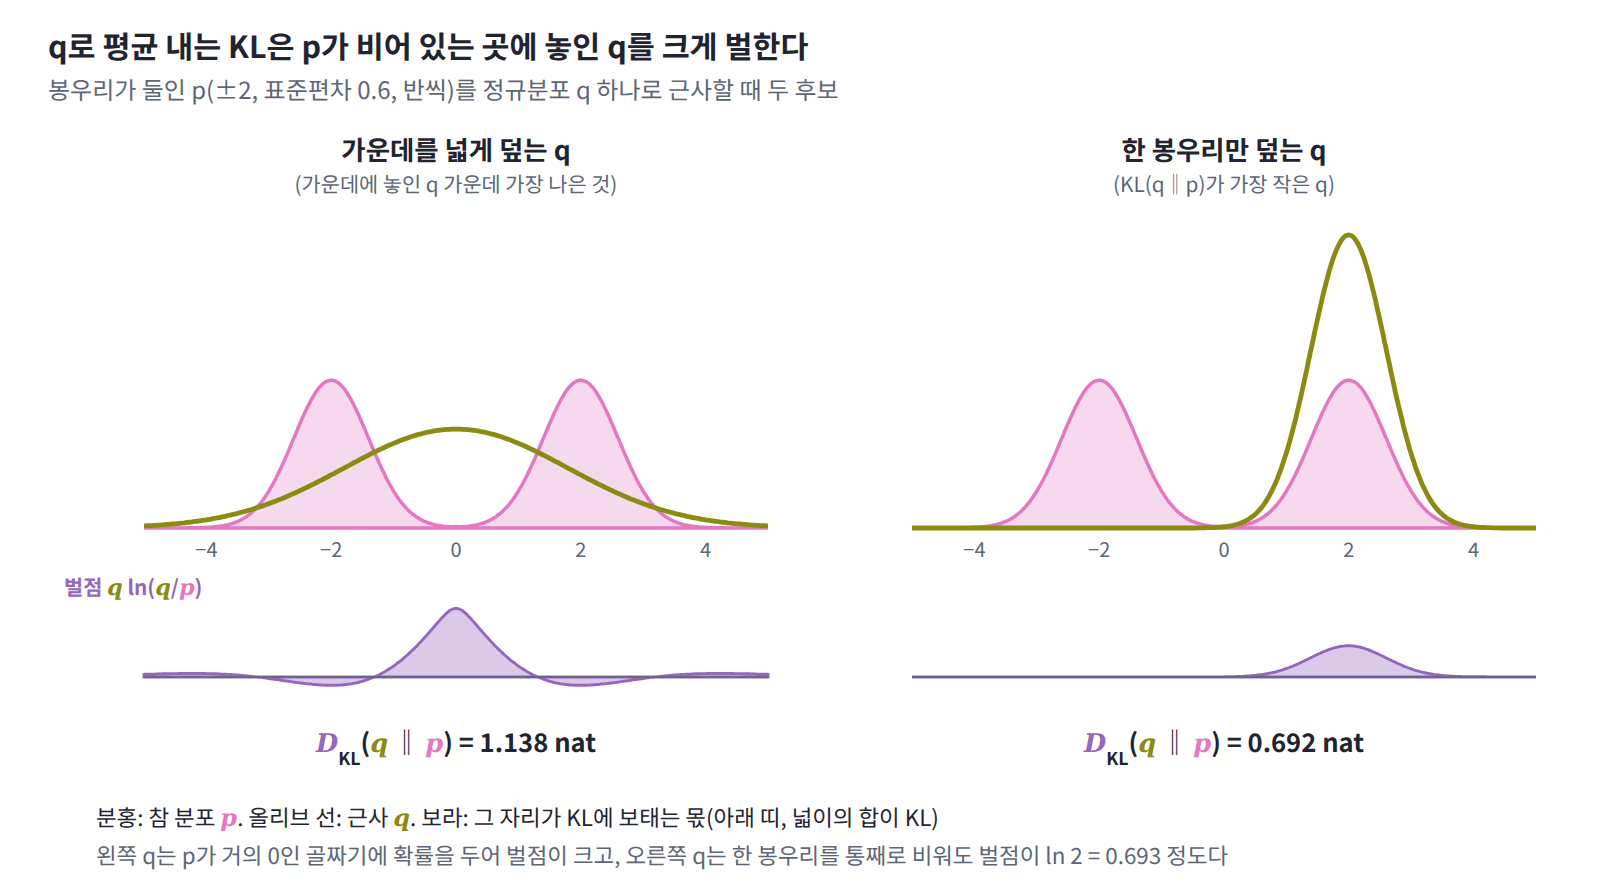
틀리는 방향은 목적 함수의 모양에도 새겨져 있다. F[q] − F = kT × D_KL(q‖p)의 KL은 q로 평균을 낸 ln(q/p)이므로, 참 분포 p가 거의 0인 곳에 q가 확률을 조금이라도 두면 ln(q/p)가 커서 벌점이 크다. 반대로 p가 큰 곳을 q가 비워 두는 것은 q로 평균을 낼 때 그 자리가 거의 들어가지 않아 벌점이 작다. 그래서 q는 참 분포 안쪽의 확실한 곳에 머물며 참 분포보다 좁아지고, 봉우리가 둘이면 하나만 덮는다. 계산할 수 없는 p로 평균을 내야 하는 반대 방향의 KL, D_KL(p‖q)는 처음부터 쓸 수 없었으니, 이 치우침은 계산할 수 있는 기준을 고른 값이다.
ML에서: 변분 추론과 VAE의 대각 정규분포
평균장 변분 추론은 이 치우침을 그대로 물려받는다. 블라이와 동료들의 리뷰에 적힌 「변분 추론은 일반적으로 사후분포의 분산을 과소평가한다. 이는 목적 함수에서 비롯된 결과다」라는 문장을, 이 장을 마친 독자는 「KL(q‖p)는 p가 작은 곳에 놓인 q에 큰 벌점을 주므로 q는 p의 안쪽에 머문다. 곱 분포는 상관 방향으로 퍼질 수 없으니, 다른 변수를 고정했을 때의 좁은 폭을 고른다」로 읽게 된다. 좌표 상승 코드에서 본 상관계수 0.9의 정규분포에서 그 폭은 0.436이었다.
VAE의 인코더가 내놓는 대각 정규분포도 평균장 모임이다. 다만 데이터마다 따로 최적화하지 않고 신경망 하나가 모든 데이터의 평균과 분산을 한꺼번에 내놓는다는 점이 다르다. 그렇다면 인코더를 키우면 ELBO와 로그우도 사이의 틈은 줄어들까? 아래 문제 12에서 두 데이터의 사후분포로 따져 보자.
문제 11. 어느 쪽 KL을 줄일까
(가) βJ = 1.5, 편향이 없는 스핀 두 개에서 D_KL(p‖q)를 가장 작게 하는 곱 분포와 D_KL(q‖p)를 가장 작게 하는 곱 분포를 구하고, 각각을 상대의 기준으로도 재라. (나) 평균 (1, −1), 분산 1, 상관계수 0.8인 정규분포에서 두 기준이 고르는 곱 분포의 표준편차와 KL 값을 비교하라. (다) 평균장은 왜 D_KL(q‖p) 쪽을 쓰는가?
최대우도가 D_KL(데이터‖모델)을 줄이는 거니까, 근사도 D_KL(p‖q)를 줄이는 쪽이 자연스러울 것 같아요. 곱 분포에서 이걸 가장 작게 하는 건 각 스핀의 주변 분포를 그대로 곱한 거예요. 여기서는 평균이 0이니까 두 동전 모두 반반이고, KL은 0.502예요.
평균장은 m = ±0.859였지. D_KL(q‖p)가 0.625야. 그럼 네 게 더 작으니까 더 좋은 거 아니야?
기준이 다르잖아. 각자 상대 기준으로 재 봐야지.
반반인 q를 D_KL(q‖p)로 재면 0.855, 평균장 q를 D_KL(p‖q)로 재면 1.838이에요. 둘 다 자기 기준에서만 이기네요.

두 q가 각각 무엇을 크게 틀렸는지 보면 이유가 보여요.
반반인 q는 두 스핀이 반대일 확률에 0.5를 줘요. 참 분포에서는 0.047밖에 안 되는 곳이라, q로 평균을 내는 KL에서 벌점이 커요. 평균장 q는 (아래, 아래)에 0.005만 줘요. 참 분포에서는 0.476이나 되는 곳을 거의 비운 거라 p로 평균을 내는 KL에서 벌점이 커지고요.
정규분포는요?
좌표 상승 코드의 식대로면 곱 분포의 표준편차가 √(1 − 0.8²) = 0.6이에요. D_KL(p‖q) 쪽은 주변 분포를 그대로 쓰니까 표준편차 1이고요. 이번엔 두 KL 값이 둘 다 −½ ln(1 − 0.64) = 0.511로 같은데, 하나는 좁게 안쪽만, 하나는 넓게 바깥까지 덮어요.
그럼 사후분포의 불확실성이 중요하면 D_KL(p‖q) 쪽이 나은데, 왜 평균장은 굳이 좁아지는 쪽을 써요?
아, D_KL(p‖q)를 계산하려면 p로 평균을 내야 하잖아. 그게 되면 애초에 근사할 필요가 없지. D_KL(q‖p)는 q로 평균을 내니까 E만 알면 되고, ln Z는 상수라서 빠지고.

그래요. 계산할 수 있는 쪽이 하나뿐이었고, 그 대가가 좁아지는 치우침이에요. 이 장 첫머리에서 대각 정규분포를 내놓는 VAE 인코더가 자기 잠재변수를 지나치게 확신한 이유도 이거고요.
친구가 강남역 아니면 홍대입구에 있다고 할 때, D_KL(p‖q)식은 두 역을 다 챙기려고 그 사이 어딘가에서 넓게 기다리는 거고, D_KL(q‖p)식은 아무도 없는 곳에 서 있는 게 싫어서 한 역에 가서 기다리는 거네요. 운이 나쁘면 못 만나지만, 적어도 엉뚱한 데 서 있지는 않아요.
문제 12. 인코더를 키우면 틈이 줄까
잠재변수가 둘인 VAE에서 데이터 A의 사후분포는 평균이 어떤 값이든 분산 1, 상관계수 0.6인 정규분포이고, 데이터 B의 사후분포는 분산 1, 상관계수 0인 정규분포라고 하자. 인코더는 데이터마다 대각 정규분포를 내놓고, 평균은 늘 정확히 맞힌다고 하자. (가) 아주 작은 인코더가 두 데이터에 같은 표준편차 하나만 내놓을 수 있다면, 두 데이터의 틈 D_KL(q‖p)의 합을 가장 작게 하는 표준편차와 그때의 틈은 얼마인가? (나) 인코더를 얼마든지 키워 데이터마다 표준편차를 따로 낼 수 있다면 틈은 얼마까지 줄어드는가? (다) 인코더 출력에 두 잠재변수의 상관계수 하나를 더하면 어떻게 되는가?
(가)는 표준편차 하나로 두 데이터를 맞추는 거라 0.883일 때 합이 가장 작고, 틈은 A에서 0.2442, B에서 0.0283, 합쳐서 0.2725 nat이에요. 인코더가 작아서 생긴 손해니까, 인코더를 키우면 0까지 줄겠죠.
그럼 (나)에서 데이터 A의 틈이 실제로 0이 되는지 계산해 볼래요?

A는 상관계수가 0.6이니까 가장 나은 대각 정규분포의 표준편차가 √(1 − 0.36) = 0.8이고, 틈은 −½ ln 0.64 = 0.223이에요. B는 표준편차 1로 정확히 맞아서 0이고요. 합이 0.223에서 더는 안 줄어요.
0.2725 가운데 인코더를 키워서 줄어든 건 0.049뿐이네. 나머지 0.223은 데이터 A 하나만 따로 최적화해도 남는 몫이야. 인코더가 아니라 대각이라는 모양이 막고 있는 거지.
(다)는요?
상관계수까지 내놓으면 q가 참 사후분포와 똑같아질 수 있으니까 틈이 0이에요. 좌표 상승 코드에서 완전 공분산 q의 틈이 0이었던 것과 같아요.
그래서 틈을 줄이려는 연구는 인코더를 키우는 쪽보다 q의 모임 자체를 넓히는 쪽으로 갔어요. 완전 공분산 정규분포를 쓰거나, 간단한 분포를 가역 변환에 여러 번 통과시켜 모양을 바꾸는 방법(레젠데와 모하메드가 2015년에 낸 흐름 모형, normalizing flow)이 그런 예예요.
답안지에 숫자 두 개만 적는 네모를 주면, 아무리 똑똑한 학생이 와도 그 네모에 안 들어가는 답은 못 쓰는 거네요. 학생보다 답안지 양식을 바꿔야죠.