분배함수: 나눗셈에 쓰고 버리던 합
softmax를 짜 본 독자라면 분모의 합을 계산해 확률을 맞춘 뒤 그 합은 따로 챙기지 않았을 것이다. 손실을 계산할 때 잠깐 로그를 취해 쓰고 나면 코드 어디에도 남지 않는데, 그렇다면 확률을 맞추려고 나눈 합 Z는 그저 나눗셈에 쓰고 버리는 숫자일까?
에너지의 기준점
먼저 모든 에너지에 같은 상수 c를 더해 보자. 그러면 볼츠만 인자가 모두 e^(−βc)배가 되고 Z도 똑같이 e^(−βc)배가 되므로, Z로 나눈 확률 pᵢ는 바뀌지 않는다. 산의 높이를 해수면에서 재든 어느 마을을 기준으로 재든 두 봉우리의 높이 차는 같은 것처럼, 에너지에는 절대적인 0이 없고 어디를 기준으로 삼을지는 계산하는 사람이 정한다. 기준점을 옮긴 흔적은 확률에는 남지 않고, Z가 e^(−βc)배가 된 데에만 남는다. 이처럼 모든 미시상태의 볼츠만 인자를 더한 합 Z를 분배함수 (정규화 합, partition function)라 한다.
에너지 값으로 묶기
Z가 무엇을 담고 있는지는 에너지가 같은 미시상태들을 묶어 보면 더 잘 보이는데, 에너지가 E인 미시상태의 개수를 g(E)라 하면 다음과 같다.
에너지 0 또는 ε 두 값만 가질 수 있는 입자(에너지 값, 곧 준위가 둘이라 2준위 입자라고 한다) 세 개로 확인해 보자. 입자가 셋뿐이면 미시상태가 2³ = 8개라 하나하나 손으로 셀 수 있어서, 에너지 값으로 묶는 효과를 가장 작게 볼 수 있다. x = e^(−βε)로 두고 βε = ln 2(x = 1/2)로 잡으면 다음 표가 된다.
| 총에너지 | 미시상태 수 g | 미시상태 하나의 볼츠만 인자 | 곱 | 확률 |
|---|---|---|---|---|
| 0 | 1 | 1 | 1 | 0.296 |
| ε | 3 | 0.5 | 1.5 | 0.444 |
| 2ε | 3 | 0.25 | 0.75 | 0.222 |
| 3ε | 1 | 0.125 | 0.125 | 0.037 |
곱의 합이 Z = 3.375다. 일반적으로는 Z = 1 + 3x + 3x² + x³ = (1 + x)³인데, 분배함수가 입자 하나의 분배함수 1 + x의 세제곱으로 쪼개지는 것은 입자들이 서로 독립적으로 상태를 고르기 때문이다. 그 덕분에 입자 하나가 에너지 ε 쪽(들뜬 상태)에 있을 확률은 다른 입자와 상관없이 x/(1 + x) = 1/(1 + e^(βε))로 정해지고, x = 1/2이면 1/3이다. 미시상태 하나의 볼츠만 인자는 에너지 0인 상태가 가장 크지만, 개수를 곱해 에너지 값으로 묶으면 ε가 가장 흔하다는 점을 눈여겨 두자.

ML에서: 가장 큰 로짓을 빼는 습관
softmax를 볼츠만 분포로 번역하면 softmax를 다룰 때 몸에 밴 습관들이 물리의 성질로 읽힌다. 로짓 전체에 상수를 더해도 결과가 같은 것은 에너지의 기준점을 옮긴 것이다. overflow를 막으려고 가장 큰 로짓을 빼는 습관이 물리의 말로 무엇이고, 그때 Z에는 무슨 일이 생기는지는 아래 문제 7에서 따져 본다.
ML에서: KL로 묶인 최적 정책
LLM(large language model, 대규모 언어 모델)을 사람의 선호에 맞추는 RLHF(reinforcement learning from human feedback, 사람의 피드백으로 하는 강화학습)에서는 보상을 높이되 기준 정책에서 너무 멀어지지 않게 한다. 이처럼 멀어진 정도를 KL(Kullback–Leibler 발산, 두 분포가 얼마나 다른지 재는 양)로 재며 보상을 높이는 목적 함수의 최적 정책도 볼츠만 분포 모양이다. 응답이 세 개뿐인 경우로 먼저 세어 보자. 기준 모델이 응답 셋을 0.5, 0.3, 0.2의 확률로 내놓고, 보상 모델이 매긴 보상이 0, 1, 2라고 하자. 기준 확률마다 e^(보상)을 곱하면 0.5, 0.3 × e = 0.816, 0.2 × e² = 1.478이고, 합 2.793으로 나누면 새 정책은 0.179, 0.292, 0.529다. 기준 모델이 가장 덜 내놓던 셋째 응답이 보상 덕분에 가장 흔해졌지만, 보상이 0인 첫째 응답도 기준 확률 때문에 사라지지 않는다. 보상을 계수 τ로 나누고 곱하면 일반적인 꼴이 된다. RLHF 논문들은 이 계수를 β로 적지만, 이 절에서 β는 역온도이므로 여기서는 온도 자리라는 뜻을 살려 τ로 쓴다.
에너지 값별로 적은 볼츠만 분포 g(E)e^(−βE)/Z와 나란히 놓으면, 기준 정책 π_ref가 축퇴도 g(E)의 자리에 있다. 에너지가 같아도 미시상태가 많은 에너지 값이 더 자주 나오듯, 보상이 같아도 기준 모델이 원래 자주 내놓던 응답이 더 자주 뽑힌다. 이 모양이 왜 최적인지도 짧게 확인할 수 있다. 보상의 평균에서 τ × KL을 뺀 값을 확률의 합이 1이라는 조건 아래 응답마다의 확률로 미분해 0으로 두면 r(y) − τ(ln(π*(y)/π_ref(y)) + 1) = 상수가 되고, 이 극값 조건을 π*에 대해 풀면 최적 정책의 식 π* ∝ π_ref·e^(r/τ)가 나온다.
문제 6. 세 스피커의 데시벨
소리의 크기를 재는 데시벨(dB)은 10 dB 커질 때마다 귀에 닿는 소리 에너지가 10배가 되도록 정한 로그 눈금이다. 세 스피커가 각각 70, 60, 50 dB로 울린다. (가) 세 소리를 합친 에너지에서 첫 스피커가 차지하는 비율과, 합친 소리의 dB을 구하라. (나) 소음계의 기준(0 dB)을 다르게 잡아서 세 값이 모두 20씩 낮게 읽힌다면, (가)의 두 답은 어떻게 되는가?
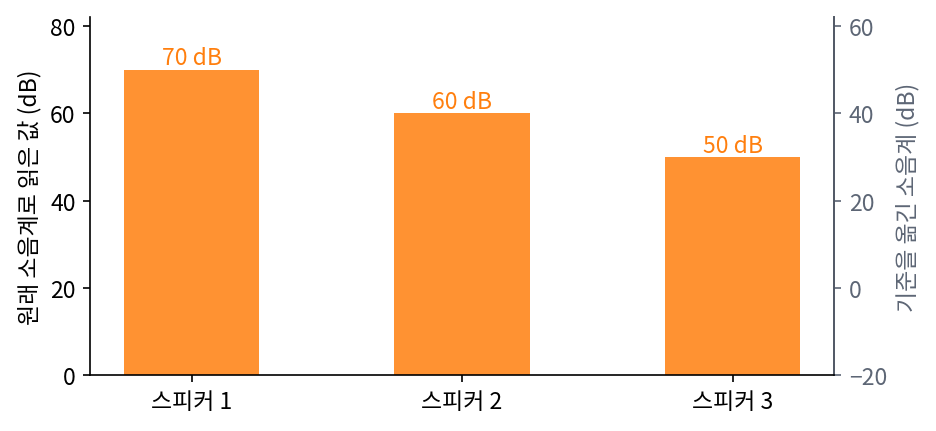

70 + 60 + 50 = 180 dB… 이건 제트기보다 크네요. 그럼 평균을 내서 60 dB요.

dB는 로그 눈금이라 그대로 더하거나 평균 내면 안 돼. 에너지로 되돌려서 더해야지. 기준 에너지를 1로 두면 10⁷, 10⁶, 10⁵이야.
그럼 합은 1.11 × 10⁷이고 첫 스피커는 10⁷/(1.11 × 10⁷) = 0.901이네. 합친 소리는 몇 dB야?

합을 다시 dB로 바꾸면 10 log₁₀(1.11 × 10⁷) = 70.45 dB야.

평균 60은커녕, 가장 큰 70에서 0.45밖에 안 늘었네요. 제일 센 소리가 거의 다 정하는 거고요.
(나)는요? 기준을 바꾸면 세 값이 모두 바뀌는데요.

50, 40, 30 dB면 에너지는 10⁵, 10⁴, 10³이에요. 셋 다 100분의 1이 됐으니까 첫 스피커의 비율은 0.901로 같고, 합친 소리는 50.45 dB로 20만 내려가요.
첫 스피커의 비율은 dB의 차이만 보고, 합친 dB는 기준을 옮긴 만큼 함께 옮겨지네요. 에너지로 되돌려 더한 뒤 다시 로그를 취하는 계산이라서요.

여행 경비 영수증에 달러와 엔이 섞여 있으면 숫자끼리 더하지 않고 원화로 바꿔 더하는 거랑 같네요.
문제 7. 가장 큰 로짓 빼기
로짓 z = (1000, 999, 990)의 softmax 확률과 ln Z = logsumexp(z)를 float32로 계산하려 한다. float32가 담을 수 있는 가장 큰 수는 약 e^(88.7)이다. (가) e^(z)를 그대로 계산하면 어떻게 되는가? (나) 모든 로짓에서 가장 큰 로짓 1000을 빼고 계산하면 확률과 ln Z는 얼마인가? 왜 빼도 되는지 볼츠만 분포의 말로 설명하라.
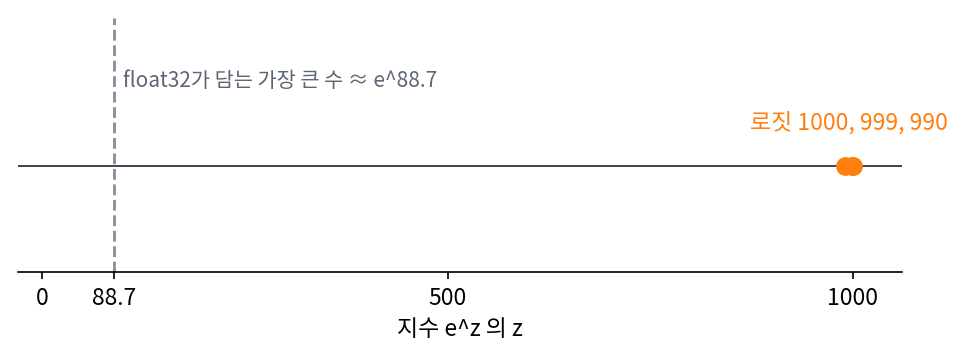
(가)는 e^(1000)이 inf라서 inf/inf = nan이에요. 그래서 다들 가장 큰 로짓을 빼죠. (0, −1, −10)이면 e⁰ + e⁻¹ + e⁻¹⁰ = 1.368, 확률은 (0.731, 0.269, 0.00003), ln Z = ln 1.368 = 0.313이에요.
확률은 맞는 것 같은데 ln Z가 0.313이면 이상해. 로짓 1000짜리 항 하나만 해도 e^(1000)인데 합의 로그가 1000보다 작을 수는 없잖아.

로짓 전체에서 1000을 뺀 것은 볼츠만 분포의 말로 무엇을 한 거죠?
에너지가 −z니까 모든 에너지에 1000을 더한 거예요. 에너지의 기준점을 옮긴 거라 확률은 그대로겠네요.

그럼 기준점을 옮긴 흔적은 어디에 남죠?

Z요. Z가 e^(1000)분의 1로 줄었으니 ln Z에 1000을 다시 더해야 해요. 1000.313이에요.
빼 둔 걸 마지막에 다시 더하는 거였네요. 가장 큰 로짓을 빼는 건 바닥 상태의 에너지를 0으로 맞춰서 볼츠만 인자를 모두 1 이하로 만드는 거고요. 이거 문제 6(세 스피커의 데시벨)이랑 같아요. 로짓이 dB 자리, ln Z가 합친 dB 자리예요. 기준을 옮겨도 비율(softmax 확률)은 그대로고, 합친 값은 옮긴 만큼 옮겨졌잖아요.

그래요. 그리고 ln Z = 1000.313처럼, 합친 값이 가장 큰 항 근처에 머무는 것도 문제 6의 데시벨 합에서 본 것과 같아요.
문제 8. 라벨 세 개의 sigmoid
사진 한 장에 「바다」「배」「사람」 세 라벨을 독립적으로 붙이는 분류기가 로짓 (2, 0, −1)을 내놓았다. (가) 각 라벨이 붙을 확률, (나) 라벨 조합 (바다 O, 배 X, 사람 O)의 확률을 구하라. (다) 여덟 가지 라벨 조합 전체에 softmax를 쓰는 분류기와는 언제 같은가?
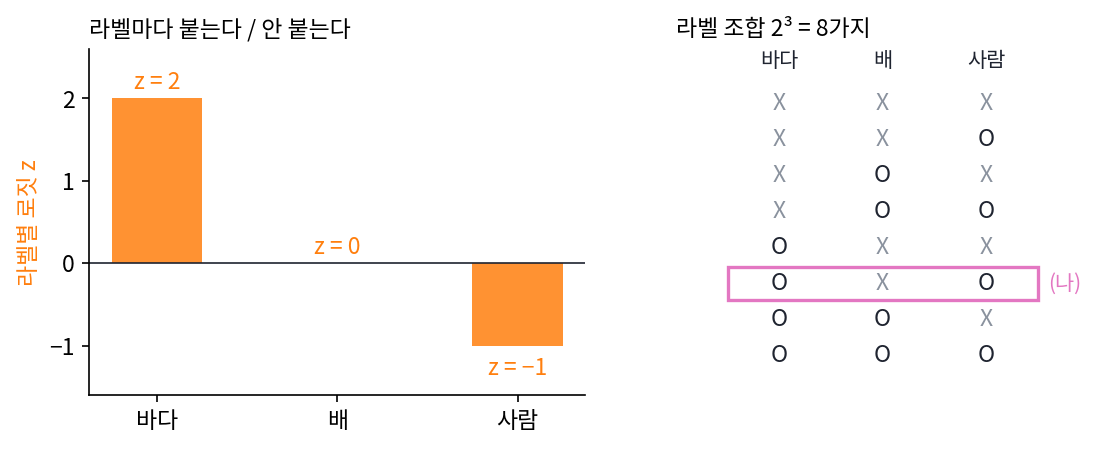
sigmoid 세 개면 0.881, 0.5, 0.269인데 합이 1.650이에요. 확률이니까 1.650으로 나눠서 (0.534, 0.303, 0.163)으로 맞춰야죠.
민준아, 그건 셋 중 하나만 고를 때 얘기야. 이 분류기는 라벨마다 붙는지 안 붙는지를 따로 정하는 거라서 합이 1일 이유가 없어. 바다 사진에 배랑 사람이 같이 있을 수도 있잖아.
볼츠만 분포로 읽어 봐요. 라벨 하나는 「붙음」과 「안 붙음」 두 상태를 가진 2준위계예요. 붙음의 에너지를 −z, 안 붙음의 에너지를 0으로 두면요?
붙음은 e^z, 안 붙음은 1이니까 붙을 확률은 e^z/(1 + e^z)… 이게 sigmoid네요! 라벨마다 이미 따로 정규화돼 있으니 다시 나누면 안 되는 거고요. (나)는 0.881 × (1 − 0.5) × 0.269 = 0.118이에요.
(다)는 여덟 조합 전체를 하나의 계로 보면 돼요. 조합 s = (s₁, s₂, s₃)의 에너지를 E(s) = −(2s₁ + 0·s₂ − s₃)로 두면 Z는 여덟 항의 합인데, (1 + e²)(1 + e⁰)(1 + e⁻¹) = 22.95로 인수분해돼요. (바다, 사람) 조합은 e^(2 − 1)/22.95 = 0.118. 같네요! 그럼 두 분류기는 항상 같은 거죠?
이거 입자 세 개의 e^(−βE)를 모두 더한 합이 (1 + x)³으로 쪼개지던 거랑 똑같다. 입자가 라벨로 바뀐 것뿐이야.
그때 인수분해가 된 이유가 뭐였죠?
입자들이 서로 독립이라서요. 에너지가 입자별 에너지의 합이니까요… 아, 항상은 아니네요. 「바다」와 「배」가 같이 붙을 때 에너지를 더 낮추는 항 −J s₁s₂를 넣으면 곱으로 안 쪼개져요.
그래요. 여덟 조합의 softmax는 그런 상호작용 항을 배울 수 있고, 라벨별 sigmoid는 에너지가 라벨별 합으로 쪼개진다고 미리 가정한 모델이에요. 독립인 입자들의 Z가 곱이 되는 것과 똑같은 이유로 독립인 라벨들의 확률이 곱이 되는 거예요.