해밀토니안 몬테카를로: 멀리 굴려도 거절되지 않는 제안
이제 이 장을 연 HMC의 물음으로 돌아갈 수 있다. 음의 로그 확률을 땅의 높이로 삼아 leapfrog로 공을 한참 굴린 뒤 도착한 곳을 제안하면, 멀리 보냈는데도 왜 거의 거절되지 않을까?
역사: 쿼크에서 신경망으로
1987년, 이 오래된 역학은 전혀 다른 곳에서 쓸모를 찾았다. 양성자 속 쿼크의 성질을 컴퓨터로 계산하던(격자 양자색역학) 물리학자 듀안, 케네디, 펜들턴, 로웨스는 분자 동역학처럼 운동방정식을 풀어 먼 곳까지 이동하고, 수치 오차는 메트로폴리스의 수락 단계로 바로잡는 방법을 만들어 「하이브리드 몬테카를로」라고 불렀다. 토론토 대학의 닐은 1990년대에 이 방법을 신경망 가중치의 사후분포에서 샘플을 뽑는 데 쓰며 통계학에 들여왔고, 뒤에 쓴 해설에서는 약자 HMC는 그대로 두되 무엇을 하는 방법인지 더 잘 드러나는 「해밀토니안 몬테카를로」라는 이름을 썼다. 2014년 호프먼과 겔먼은 궤적의 길이를 자동으로 정하는 NUTS를 내놓았고, 이것이 뒤에 Stan의 기본 샘플러가 되었다. 쿼크와 신경망이라는 전혀 다른 문제에서, 백오십 년 전의 역학이 가진 어떤 성질이 쓸모가 있었던 것일까?

지금은 PyMC에서 sample() 한 줄이면 HMC가 돌잖아요. 쿼크 계산에서 통계로 건너오는 게 그렇게 큰일이었어요?

그 한 줄 뒤에 무엇이 숨어 있는지 봐요. leapfrog 한 스텝마다 무엇을 계산해야 했죠?

위치에너지의 그래디언트요. 음, 목표 분포가 신경망 가중치의 사후분포면 가중치 하나하나로 미분해야 하는데….

그래요. 닐이 다룬 신경망은 역전파로 그 그래디언트를 셈할 수 있었어요. 아무 모델이나 대신 미분해 주는 자동미분 도구가 흔해진 건 그 뒤의 일이에요.

굴리는 길이도 그렇네요. NUTS가 2014년에 나왔으니까, 그 전에는 몇 스텝 굴릴지를 사람이 정해야 했던 거고요.

길게 굴리면 계산이 아깝고 너무 짧게 굴리면 랜덤 워크와 별로 다르지 않으니, 문제마다 손으로 맞춰야 했어요.
그런데 그렇게 멀리 굴린 제안을 받을지 말지는 어떻게 정해요? 쿼크든 신경망이든, 굴리고 나서 거절당하면 그래디언트를 계산한 게 다 헛수고잖아요.
HMC를 몇 줄로
leapfrog로 HMC를 짜 보자. 목표 분포는 100차원 표준정규분포이고, 위치에너지는 음의 로그 확률 U(q) = ‖q‖²/2다. 한 번의 업데이트는 운동량을 새로 뽑고, leapfrog로 10스텝 굴리고, 에너지가 변한 만큼만 확률적으로 거절하는 세 단계다. 스텝 크기 0.15로 10스텝이면 한 번에 시간 1.5만큼 굴러가는데, 이 목표 분포에서 공이 한 번 왕복하는 시간이 2π ≈ 6.28이므로 그 4분의 1 가까이다. 비교를 위해 랜덤 워크 메트로폴리스도 돌린다. 랜덤 워크 메트로폴리스의 스텝 크기 0.24는 표준정규분포 같은 목표에서 차원이 d일 때 2.38/√d로 잡으면 가장 효율이 좋다는 결과(로버츠·겔먼·길크스, 1997)에 d = 100을 넣은 값이고, 이때 수락률은 약 23%가 되어야 한다.
import numpy as np
rng = np.random.default_rng(0)
d = 100
U      = lambda q: 0.5 * q @ q            # 목표 분포 π(q) ∝ e^(-U), 100차원 표준정규분포
grad_U = lambda q: q

def hmc_step(q, eps=0.15, L=10):
    p = rng.standard_normal(d)             # 운동량을 새로 뽑는다
    H0 = U(q) + 0.5 * p @ p
    qn, pn = q.copy(), p.copy()
    for _ in range(L):                     # leapfrog L스텝
        pn -= 0.5 * eps * grad_U(qn)
        qn += eps * pn
        pn -= 0.5 * eps * grad_U(qn)
    H1 = U(qn) + 0.5 * pn @ pn
    if rng.random() < np.exp(H0 - H1):     # 수락 확률 min(1, e^(-ΔH))
        return qn, True
    return q, False

def rwm_step(q, s=0.24):                   # 비교: 랜덤 워크 메트로폴리스
    qn = q + s * rng.standard_normal(d)
    if rng.random() < np.exp(U(q) - U(qn)):
        return qn, True
    return q, False

for name, step in (("HMC", hmc_step), ("RWM", rwm_step)):
    q, acc, xs = np.zeros(d), 0, []
    for t in range(5000):
        q, a = step(q)
        acc += a
        xs.append(q[0])
    xs = np.array(xs[1000:])
    r1 = np.corrcoef(xs[:-1], xs[1:])[0, 1]  # 이웃한 샘플끼리의 상관
    print(name, "수락률", acc / 5000, "지연 1 자기상관", round(r1, 3))
# HMC 수락률 0.981 지연 1 자기상관 0.093
# RWM 수락률 0.2376 지연 1 자기상관 0.99
HMC는 한 번에 시간 1.5만큼 굴러가는데도 제안의 98%가 받아들여지고, 이웃한 두 샘플의 상관은 0.093으로 거의 독립이다. 랜덤 워크는 24%만 받아들여지고 이웃한 샘플의 상관이 0.99라서 사실상 같은 자리에 머문다. HMC는 한 번 업데이트할 때 그래디언트를 10번 계산하므로 공정하게 비교하려면 랜덤 워크에 10스텝을 주어야 하지만, 랜덤 워크 샘플은 10스텝 떨어져도 상관이 0.90으로 여전히 높다. 코드의 수락 단계에 자코비안 행렬식이 나오지 않는다는 점도 눈여겨보자. leapfrog의 행렬식 1이 여기서 쓰인다.
각 단계를 떠받치는 성질
HMC의 역할은 샘플을 뽑고 싶은 분포 π(q)를 물리계로 번역하는 것이다. 음의 로그 확률을 위치에너지로 삼고, 실제로는 없던 운동량 p를 표준정규분포에서 뽑아 붙이면, 위치와 운동량의 결합 분포(joint)가 e^(−ℋ)에 비례하는 위상공간 분포가 된다.
이 장에서 본 성질들이 각 단계의 근거가 된다. 결합 분포 e^(−ℋ)는 에너지만의 함수이므로 정확한 해밀턴 흐름은 이 분포를 바꾸지 않는다. 흐름이 에너지를 보존하므로 Δℋ는 거의 0이고 수락 확률은 거의 1이다. 그리고 흐름이 부피를 보존하므로, 제안의 확률을 계산할 때 붙어야 할 자코비안 행렬식이 1이 되어 수락 확률에 나타나지 않는다. leapfrog는 이 가운데 부피 보존과 되돌릴 수 있는 성질(운동량의 부호를 뒤집으면 같은 길을 거슬러 온다)을 정확히 지키고 에너지 보존만 근사로 지키는데, 남은 에너지 오차는 메트로폴리스 수락 단계가 바로잡는다. 그래서 시간을 잘게 나눠 근사했는데도(이산화) HMC가 도는 마르코프 체인(바로 앞 샘플만 보고 다음 샘플을 뽑아 줄줄이 이어 가는 방식)의 정상 분포, 곧 오래 돌린 뒤 더는 변하지 않는 분포(stationary distribution, 정규분포와는 다른 말)는 정확히 π다.
flowchart LR
    A["현재 위치 q"] --> B["운동량 p 새로 뽑기<br/>표준정규분포에서"]
    B --> C["leapfrog로 L스텝 굴리기<br/>부피 보존 · 되돌릴 수 있음"]
    C --> D["수락 확률 min(1, e^−Δℋ)<br/>에너지가 거의 보존되어 ≈ 1"]
    D -->|수락| E["새 위치 q′"]
    D -->|거절| F["q에 그대로 머묾"]
HMC 한 번의 업데이트와 각 단계를 떠받치는 성질. 운동량 뽑기는 에너지를 바꾸고, leapfrog는 에너지 등고선을 따라 멀리 옮기며, 수락 단계는 남은 에너지 오차만 바로잡는다.
ML에서: 닐의 한 줄
닐(Neal, 2011)의 HMC 해설은 논문 요약에서 이렇게 말한다. 「해밀턴 동역학이 쓸모 있는 열쇠는 부피를 보존한다는 것이다. 그래서 그 궤적으로 복잡한 변환을 만들어도 계산하기 어려운 자코비안 행렬식을 따질 필요가 없고, 이 성질은 시간을 잘게 나눠 동역학을 근사할 때도 정확히 유지할 수 있다.」 닐의 이 문장은 「리우빌 정리 덕분에 행렬식이 1이고, leapfrog는 행렬식이 1인 전단 변환의 합성이라 시간을 잘게 나눠도 1이다」라는 뜻이다. 같은 글에서 닐은 차원 d가 커질 때 독립 샘플 하나를 얻는 비용이 랜덤 워크는 d²에 비례해 늘지만 HMC는 d^(5/4)에 비례해 늘 뿐이라는 것도 보였다. leapfrog에서는 에너지 오차의 평균이 스텝 크기의 네제곱에 비례해 작아지기 때문이다.
문제 13. HMC의 수락 확률
목표 분포가 1차원 표준정규분포(U(q) = q²/2)이다. 현재 위치 q = 1에서 운동량 p = 0.5를 뽑고, 스텝 크기 0.5로 leapfrog를 한 스텝 가서 (q′, p′)를 얻었다. 이 제안의 수락 확률을 구하라.
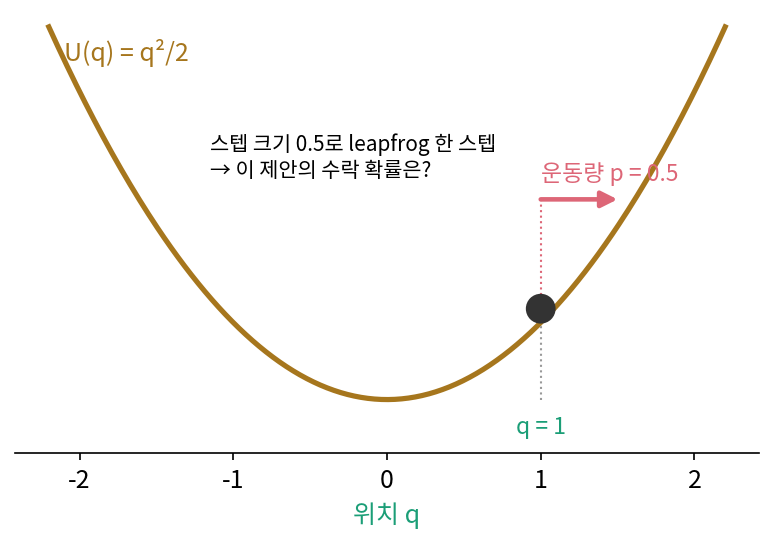

leapfrog부터요. p = 0.5 − 0.25 × 1 = 0.25, q′ = 1 + 0.5 × 0.25 = 1.125, p′ = 0.25 − 0.25 × 1.125 = −0.03125.
그다음 수락 확률은 어떻게 구할까요?
메트로폴리스니까 π(q′)/π(q) = e^(−(1.125² − 1)/2) = e^(−0.133) ≈ 0.876. 87.6%요.

계산은 맞는데, 그건 랜덤 워크 메트로폴리스의 공식이에요. HMC가 샘플을 뽑는 분포는 무엇이었죠?

π(q)… 아니, 운동량까지 붙인 결합 분포 e^(−ℋ)요. 운동량도 같이 따져야 하는 거네요.
ℋ = q²/2 + p²/2로 계산하면 처음엔 0.5 + 0.125 = 0.625, 도착하면 0.6328 + 0.0005 = 0.6333이에요. Δℋ = 0.0083이니까 수락 확률은 e^(−0.0083) ≈ 0.992, 99.2%예요.
위치만 보면 확률이 낮은 쪽으로 올라갔는데, 운동에너지를 써서 올라간 거라 에너지 합은 거의 그대로네요. 언덕을 뛰어 올라가다 속도가 줄어든 공이요.
그런데 원래 메트로폴리스–헤이스팅스에서는 제안 분포의 비율도 곱해야 하잖아요. 여기서는 그게 왜 없어요?
두 가지 덕분이에요. leapfrog 끝에서 운동량의 부호를 뒤집으면, 도착점에서 같은 스텝으로 출발했을 때 원래 자리로 돌아와요. 그래서 가는 제안과 거꾸로 오는 제안이 하나씩 맞물려요. 그리고 이 변환의 행렬식이 1이라 밀도를 옮길 때 붙는 자코비안 행렬식도 1이에요. 둘 다 1이라서 식에서 사라진 거예요.
그럼 leapfrog 대신 오일러 방법으로 굴리면요?
행렬식이 1이 아니라서(이 문제에서는 1 + 0.5² = 1.25) 그 인수를 따로 곱해야 하고, 부호를 뒤집어 거꾸로 돌려도 제자리로 오지 않아서 가는 제안과 오는 제안이 맞물리지 않아요. min(1, e^(−Δℋ))를 그대로 쓰면 틀린 분포에서 샘플을 뽑게 돼요. HMC가 leapfrog를 고집하는 이유예요.