모멘텀 최적화: 마찰이 넓이를 줄여 손실 최소점에 멈춘다
HMC는 마찰 없이 공을 굴려 분포 전체를 돌아다녔다. ML에서 공을 굴리는 또 한 곳은 최적화의 모멘텀 방법인데, 모멘텀 계수를 1로 두면 손실 최소점에 멈추지 못하고 영원히 흔들린다. 그렇다면 모멘텀 계수가 1보다 작으면 왜 최소점에 멈출 수 있을까?
한 스텝의 넓이 배율
우리가 모멘텀 SGD라 부르는 업데이트는 소련의 폴랴크가 1964년 논문에서 내놓은 「무거운 공」(heavy-ball) 방법이다. 폴랴크는 지난 스텝을 기억하는 이 방법이 해 근처에서 그래디언트만 쓰는 방법보다 훨씬 빨리 수렴한다는 것을 보였다. 이름대로 손실을 위치에너지 U(θ)로 보면, 이 업데이트는 운동량이 있는 공의 운동이다.
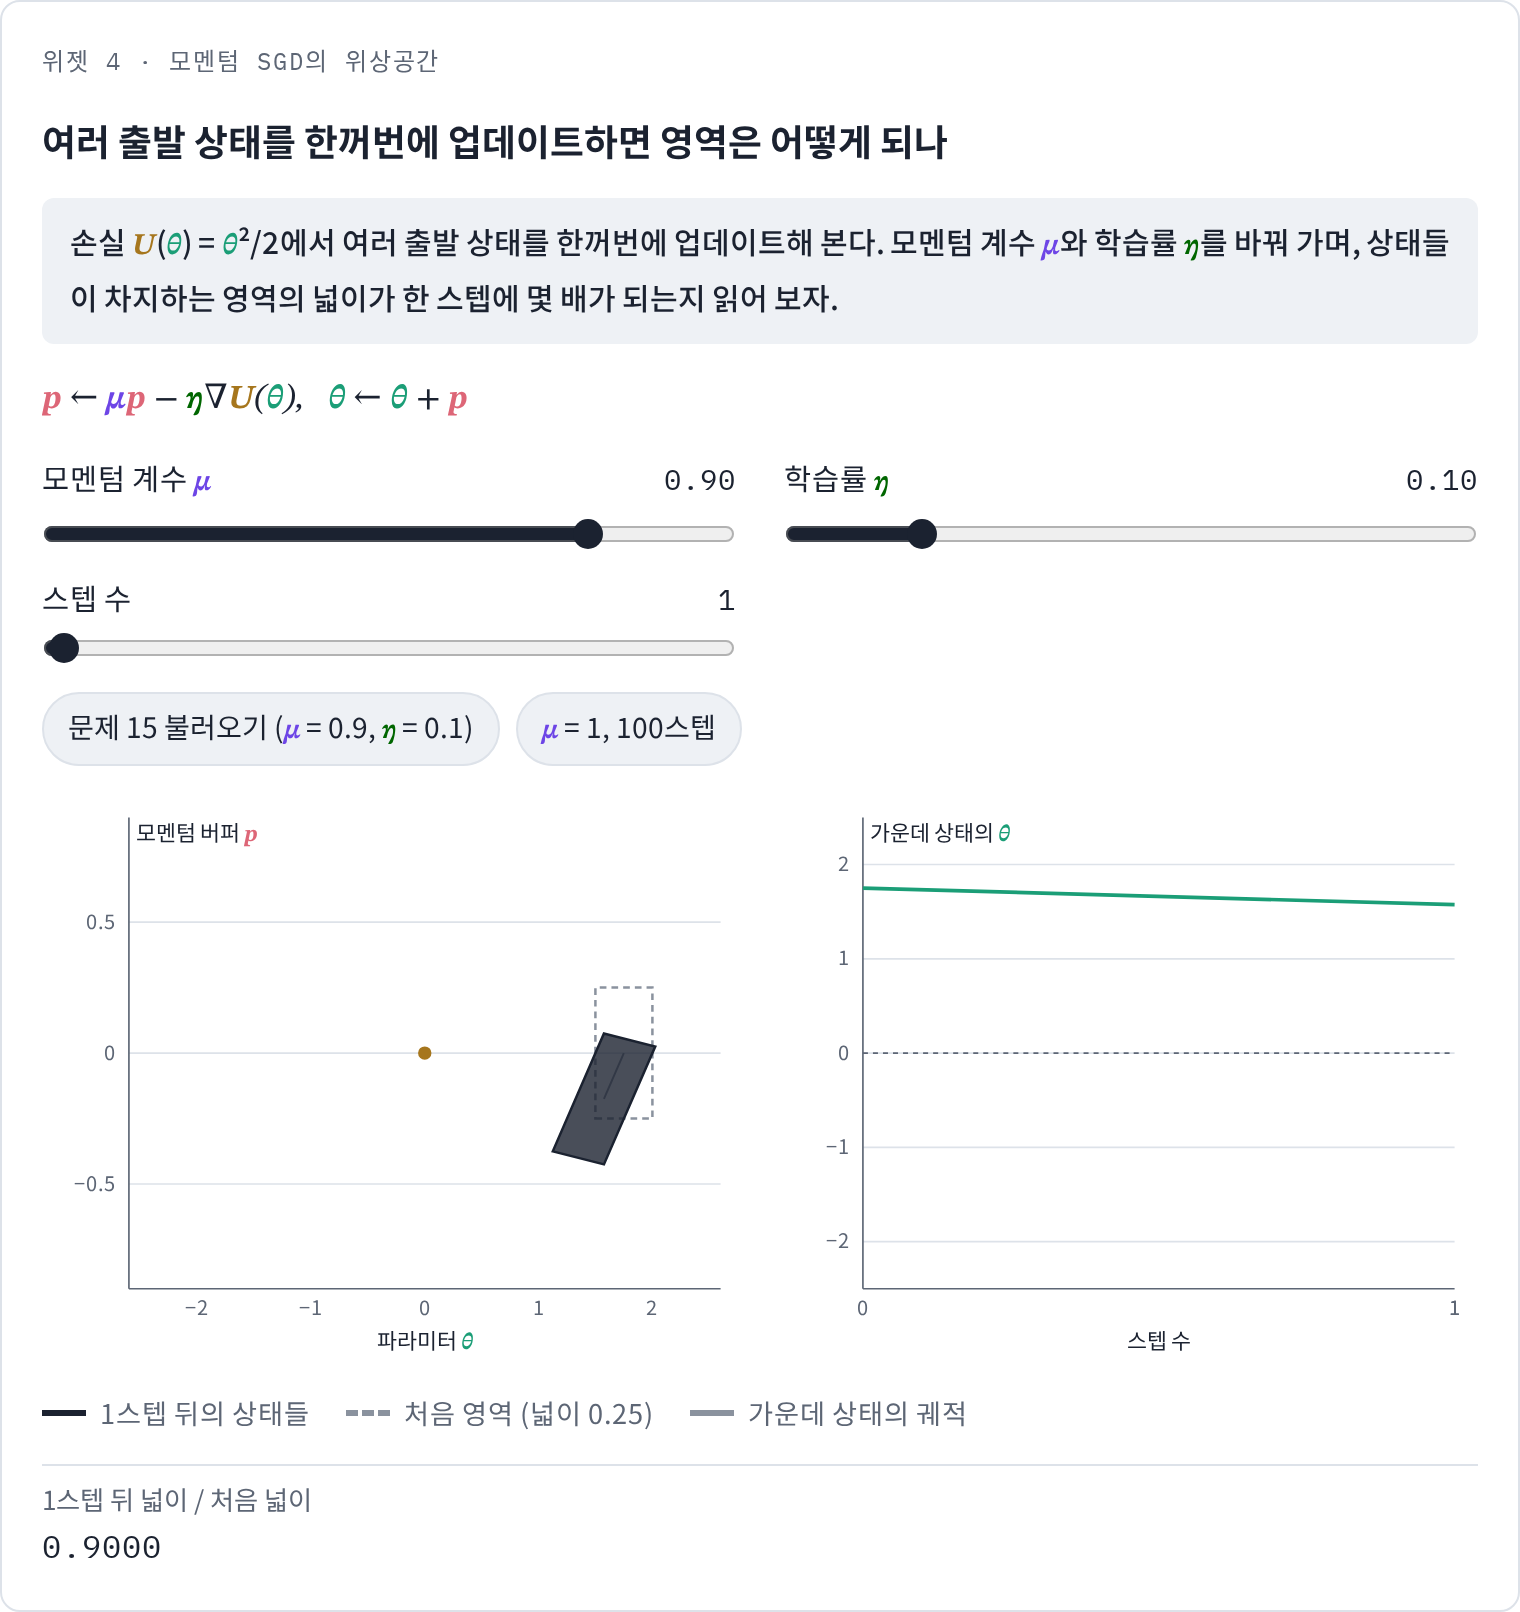
μ(뮤) = 1이면 이 업데이트는 운동량을 먼저 바꾸고 새 운동량으로 위치를 옮기는, 마찰 없는 공 굴리기다. 마찰 없는 해밀턴 흐름은 위상공간의 넓이를 바꾸지 않았고, 넓이가 그대로이면 넓은 영역에서 출발한 상태들이 한 점으로 모일 수 없다. 그런데 최적화가 수렴한다는 것은 여러 출발점이 모두 손실이 가장 낮은 점, 곧 (θ, p) = (손실 최소점, 0)이라는 한 점으로 모여든다는 뜻이다. 앞에서 진자에 마찰을 넣자 넓이가 줄어들었듯, 모멘텀 계수 μ < 1이 운동량을 깎는 마찰 노릇을 한다면 넓이도 줄어들 것이다. 그렇다면 한 번의 업데이트는 넓이를 몇 배로 바꾸고, 그 배율은 학습률에도 달려 있을까? 아래 위젯에서 여러 출발 상태를 한꺼번에 업데이트해 보며 짐작해 보고, 문제 15에서 직접 계산해 보자.

문제 14. 밀어 주지 않는 그네
아무도 밀어 주지 않는 그네가 공기 저항 때문에 조금씩 잦아든다. 한 번 왕복할 때마다 가장 멀리 가는 거리도 0.9배, 가장 낮은 곳을 지나는 속력도 0.9배가 된다고 하자. 위치–운동량 평면에서 그네 상태 여러 개가 차지하는 넓이는 한 번 왕복할 때마다 몇 배가 되는가? 10번 왕복하면?
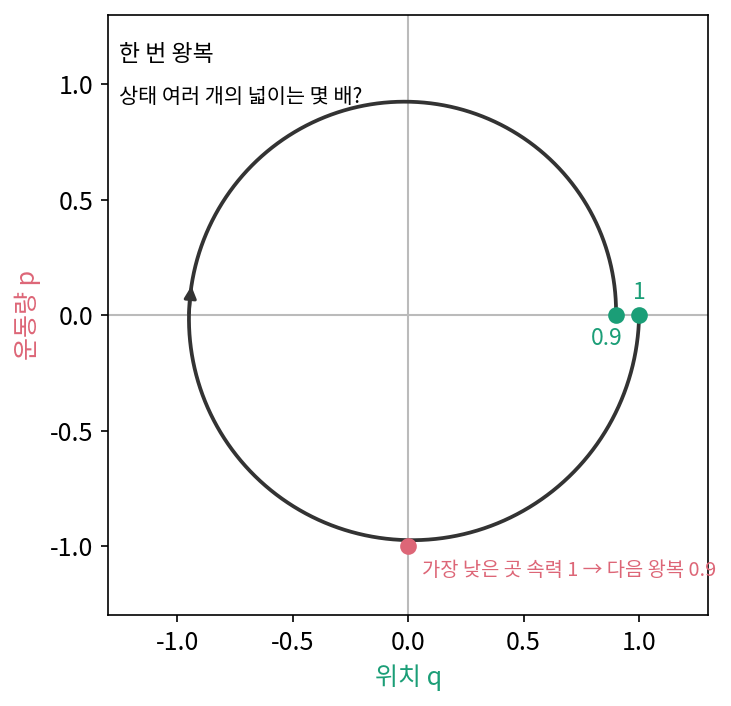

흔들리는 폭이 0.9배니까 넓이도 0.9배요. 10번이면 0.9^10 ≈ 0.35배.

넓이는 가로 곱하기 세로잖아. 위치 방향도 0.9배, 운동량 방향도 0.9배면?

아, 0.9 × 0.9 = 0.81배네요. 10번이면 0.81^10 ≈ 0.12배.

그럼 계속 왕복하면 그 상태들은 어디로 가죠?

넓이가 0으로 줄어드니까 가장 낮은 곳에 멈춘 상태인 원점 한 점으로 모여요. 마찰 없는 그네였다면 넓이가 그대로라 한 점에 모일 수 없었을 거고요.
문제 15. 모멘텀 SGD의 위상공간
손실 U(θ) = θ²/2를 모멘텀 SGD(p ← μp − η∇U(θ), θ ← θ + p)로 최소화한다. 학습률 η = 0.1, 모멘텀 계수 μ = 0.9일 때 한 번의 업데이트가 (θ, p) 평면의 넓이를 몇 배로 바꾸는지 구하고, μ = 1이면 어떻게 되는지 말하라. (풀어 본 뒤 위젯 4의 「문제 15 불러오기」로 확인해 보자.)
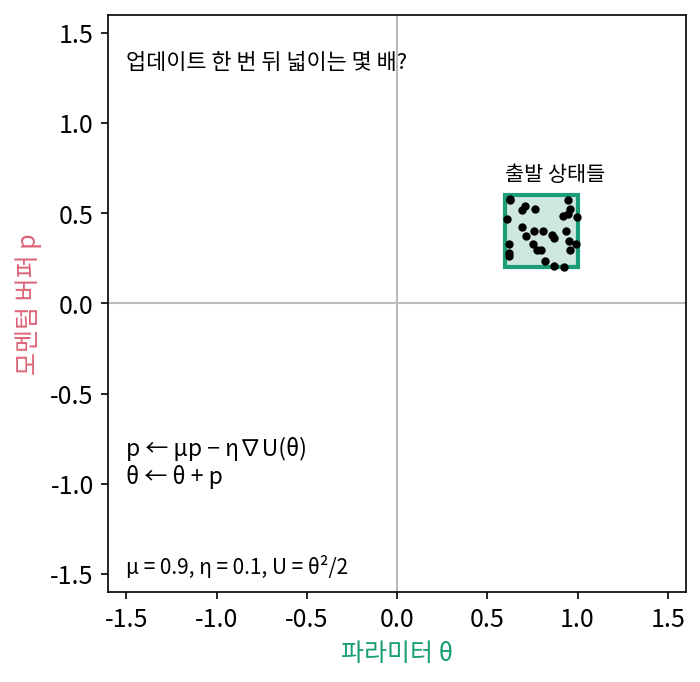
아까 문제 14(밀어 주지 않는 그네)랑 같은 거죠? 버퍼에 0.9를 곱하니까 운동량 방향이 0.9배, 위치 방향도 0.9배, 그래서 넓이는 0.81배요.
위치에는 0.9를 곱하지 않잖아. θ ← θ + p라서 위치는 줄어들지 않고 새 운동량만큼 옮겨지기만 해. 그네처럼 두 방향이 다 줄어든다고 볼 수 없어.
어… 그럼 위치 방향은 1배라서 넓이도 0.9배? 그런데 학습률이 위치를 움직이니까 그것도 섞일 것 같은데. 뭔가 헷갈리네.
직접 계산해 봐요. 업데이트 전후의 (θ, p) 사이의 자코비안 행렬이요.

p′ = 0.9p − 0.1θ, θ′ = θ + p′ = 0.9θ + 0.9p예요. (θ, p) 순서로 쓰면 행렬은 [[0.9, 0.9], [−0.1, 0.9]]이고 행렬식은 0.81 + 0.09 = 0.9예요.
0.9면 모멘텀 계수랑 같은데? 우연인가.
η를 바꿔 봐도… μ(1 − η) + μη = μ라서 항상 μ네요.

그래요. 한 스텝마다 넓이가 0.9배, 50스텝이면 0.9^50 ≈ 0.0052배예요. 운동량을 매번 0.9배로 깎는 게 마찰이고, 마찰이 넓이를 줄여 상태들을 바닥으로 모아요. μ = 1이면요?
행렬식이 1이니까 넓이가 보존되고… 돌려 보니까 200스텝 뒤에도 θ가 0.68이고, 마지막 50스텝 동안에도 진폭 1 안팎으로 계속 오가요. 수렴을 안 해요!
μ = 1이면 p ← p − η∇U, θ ← θ + p잖아. 어디서 본 꼴인데….
문제 12에서 민준 학생이 순서를 바꾼 두 줄과 견주어 볼까요?
스텝 크기를 √η로 보고 운동량의 눈금만 바꾸면 민준이가 만든 운동량 먼저 업데이트하는 적분법이랑 똑같은 식이네요. 그네를 시뮬레이션하고 있었던 거예요.
과제에서 μ = 0.99로 했을 때 손실이 한참 출렁였던 게 이거였네요. 마찰이 1%밖에 없었던 거예요.

그래서 HMC와 모멘텀 최적화는 같은 기계예요. HMC는 마찰을 0으로 두고 운동량을 다시 뽑아서 분포 전체를 돌아다니고, 최적화는 마찰로 운동량을 깎아서 한 점에 멈춰요.