NWJ 하한은 어떤 f-발산에든 쓸 수 있는 일반적인 방법이다. 그런데 최대우도 학습, 지식 증류, 상호정보량에서 실제로 재려는 발산은 대부분 KL이다. KL 하나만 재면 되는 경우라면, 같은 비평 함수로 참값에 더 가까운 하한을 얻을 수는 없을까?
역사: 돈스커와 바라단
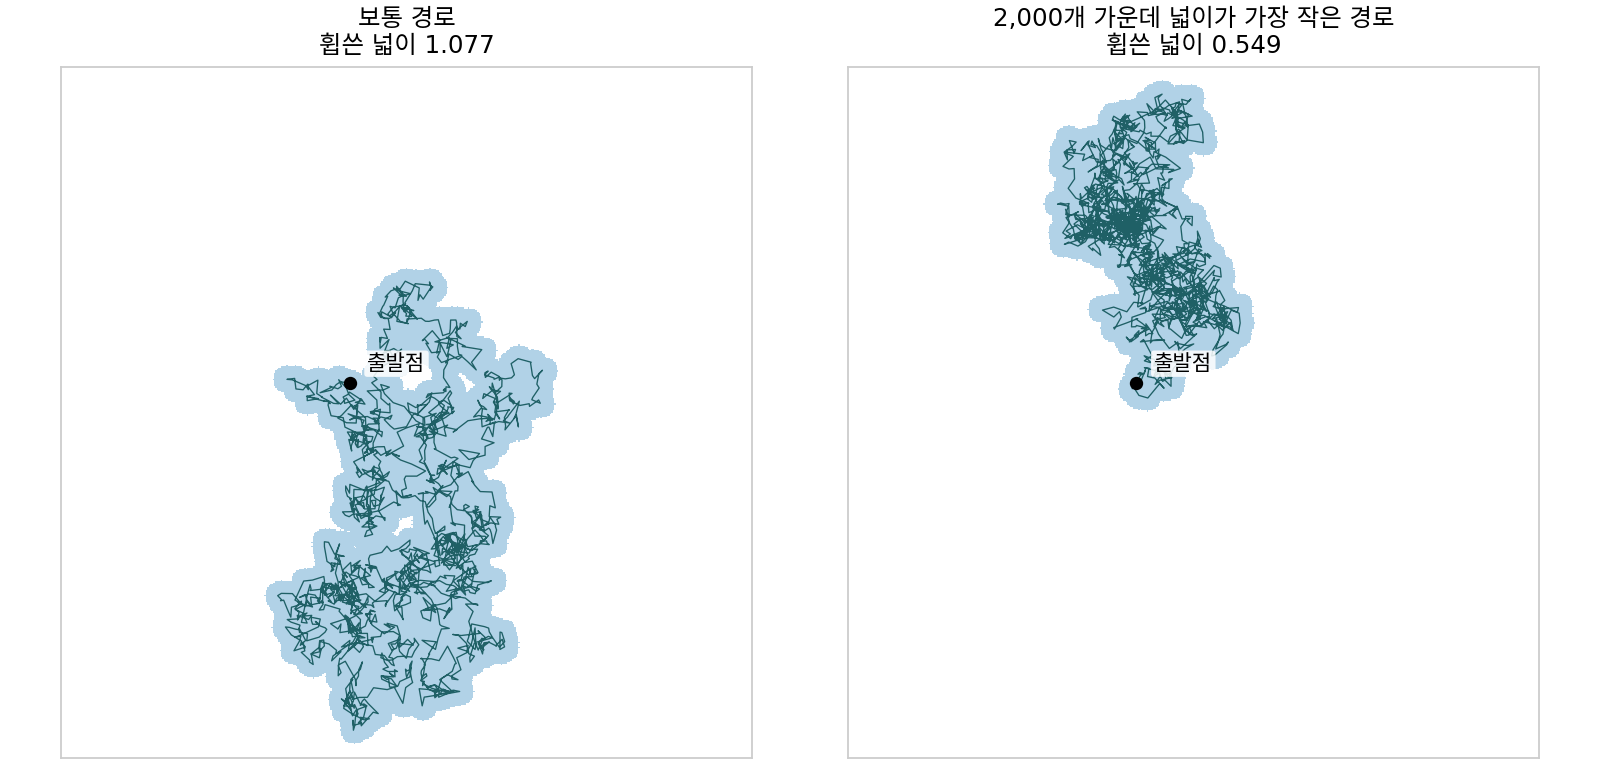
KL을 함수에 대한 최대화 문제로 쓰는 표현은 ML보다 훨씬 먼저 확률론에서 나왔다. 돈스커와 바라단이 붙든 것은 오랫동안 무작위로 떠도는 입자에 관한 물음이었다. 이를테면 작은 공을 끌고 떠도는 입자가 시간 t 동안 휩쓸고 지나간 자리(모양 때문에 「위너 소시지」라 부른다)의 부피는 t가 길어지면 어떻게 될까? 두 사람은 1975년에 위너 소시지 부피에 관한 답을 증명했다. 이런 물음에서는 좀처럼 일어나지 않는 경로가 평균값을 좌우하기 때문에, 두 사람은 1975년부터 1983년까지 네 편으로 낸 논문 「긴 시간에서 어떤 마르코프 과정 기댓값의 점근 계산」에서 드문 사건의 확률을 다루는 대편차 이론을 쌓아 올렸다. 지수 함수의 평균에 로그를 씌운 값을 분포에 대한 최대화로 바꿔 쓰는 식이 그 도구 가운데 하나이고, 아래에서 KL에 쓰는 돈스커–바라단 표현이 그 바꿔 쓰기에서 나왔다. 바라단은 2007년 아벨상을 받았는데, 수상 이유는 「확률론에 대한 근본적인 기여, 특히 대편차의 통일된 이론을 세운 것」이었다.
평면 위 브라운 운동 2,000개를 같은 시간 떠돌게 해 반지름 0.05인 원판이 휩쓴 자리(위너 소시지)를 잰 결과, 보통 경로는 넓이 1.077을 휩쓸고 가장 좁게 휩쓴 경로는 0.549에 그쳤다. e^(−20·넓이)의 평균을 내면 넓이 하위 1%의 경로가 그 합의 63%를 차지해, 드문 경로가 평균을 좌우한다. 직접 시뮬레이션해 그린 그림(sources/ch05/history_figs.py)
김민준
소시지 부피라면 컴퓨터로 입자를 수없이 떠돌게 해 놓고 평균을 내면 되잖아요.
선생님
본문에서 이런 물음의 평균을 좌우하는 게 무엇이라고 했죠?
이서연
좀처럼 일어나지 않는 경로요. 아, 그러면 시뮬레이션을 아무리 많이 돌려도 그 경로는 거의 안 나오겠네요.
선생님
그래요. 거의 뽑히지 않는 경로가 평균을 정하니까 샘플을 늘리는 것만으로는 답에 다가가기 어려워요. t가 길어질수록 그런 경로는 더 드물어지고요. 드문 사건의 확률이 얼마나 빠르게 작아지는지를 식으로 붙잡는 이론이 먼저 있어야 했어요.
김민준
그 이론이 대편차 이론이고, 지수 함수의 평균에 로그를 씌운 값을 분포에 대한 최대화로 바꿔 쓰는 식이 거기서 나온 거군요.
이서연
그 바꿔 쓰기를 거꾸로 하면 KL이 비평 함수에 대한 최대화가 된다는 거죠? 그럼 같은 비평 함수를 넣었을 때 NWJ 하한보다 큰 값을 줄까요?
KL을 위한 더 날카로운 하한
출발점은 로그 분배함수의 식 ln Z = max_p(Σ pᵢzᵢ + H(p)), 곧 로짓 점수와 엔트로피의 합을 가장 크게 하는 분포가 softmax이고 그 최댓값이 ln Z라는 식이다. 로짓 대신 임의의 함수 z(x)를, 균등한 기준 대신 분포 q를 기준으로 두고 같은 계산을 하면 엔트로피 자리에 q에 대한 KL이 들어간다.
KL을 비평 함수 z에 대한 최댓값으로 쓴 표현을 돈스커–바라단 표현 (Donsker–Varadhan representation, DV)이라 한다. 최적의 비평 함수는 밀도 비의 로그에 어떤 상수를 더해도 좋다. 또 ln y ≤ y/e가 모든 양수 y에서 성립하므로, 같은 z를 넣으면 돈스커–바라단 쪽이 NWJ 하한보다 항상 크거나 같다.
flowchart TD
  A["f-발산 D_f(p‖q)<br/>밀도 비 p/q가 필요"] --> B["f를 켤레로 풀기<br/>f(u) = sup_z (zu − f*(z))"]
  B --> C["⟨z⟩_p − ⟨f*(z)⟩_q<br/>샘플 평균만 필요"]
  C --> D["KL이면 NWJ 하한<br/>⟨z⟩_p − ⟨e^(z−1)⟩_q (f-GAN)"]
  E["ln⟨e^z⟩_q와 KL(·‖q)는<br/>서로의 켤레"] --> F["DV 하한<br/>⟨z⟩_p − ln⟨e^z⟩_q (상호정보량 재기에 씀)"]
  D -. "같은 z면 DV ≥ NWJ" .-> F
NWJ 하한과 DV 하한 모두 밀도 비를 켤레 뒤로 숨겨 샘플 평균만 남기고, 최적의 비평 함수는 둘 다 밀도 비의 로그에 상수를 더한 꼴인데, NWJ는 그 상수가 1로 정해져 있고 DV는 아무 상수나 된다.
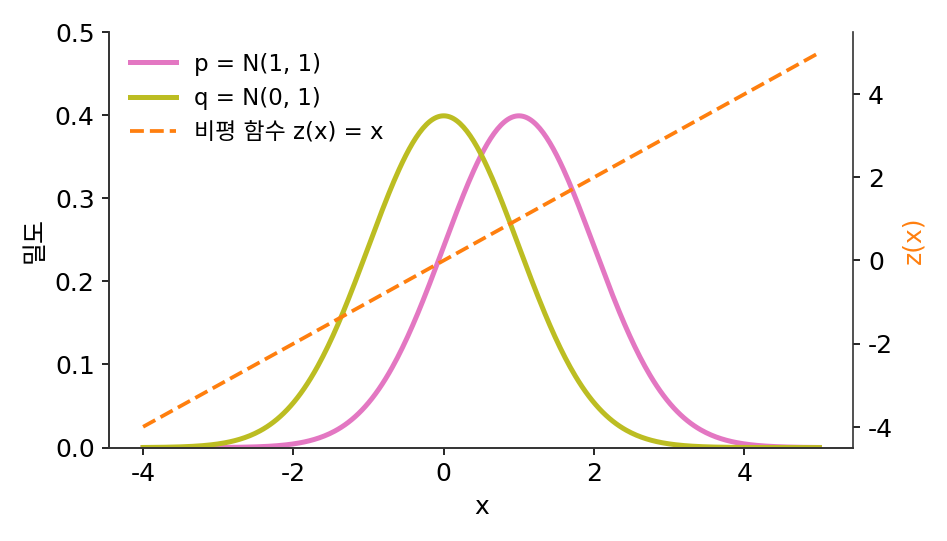
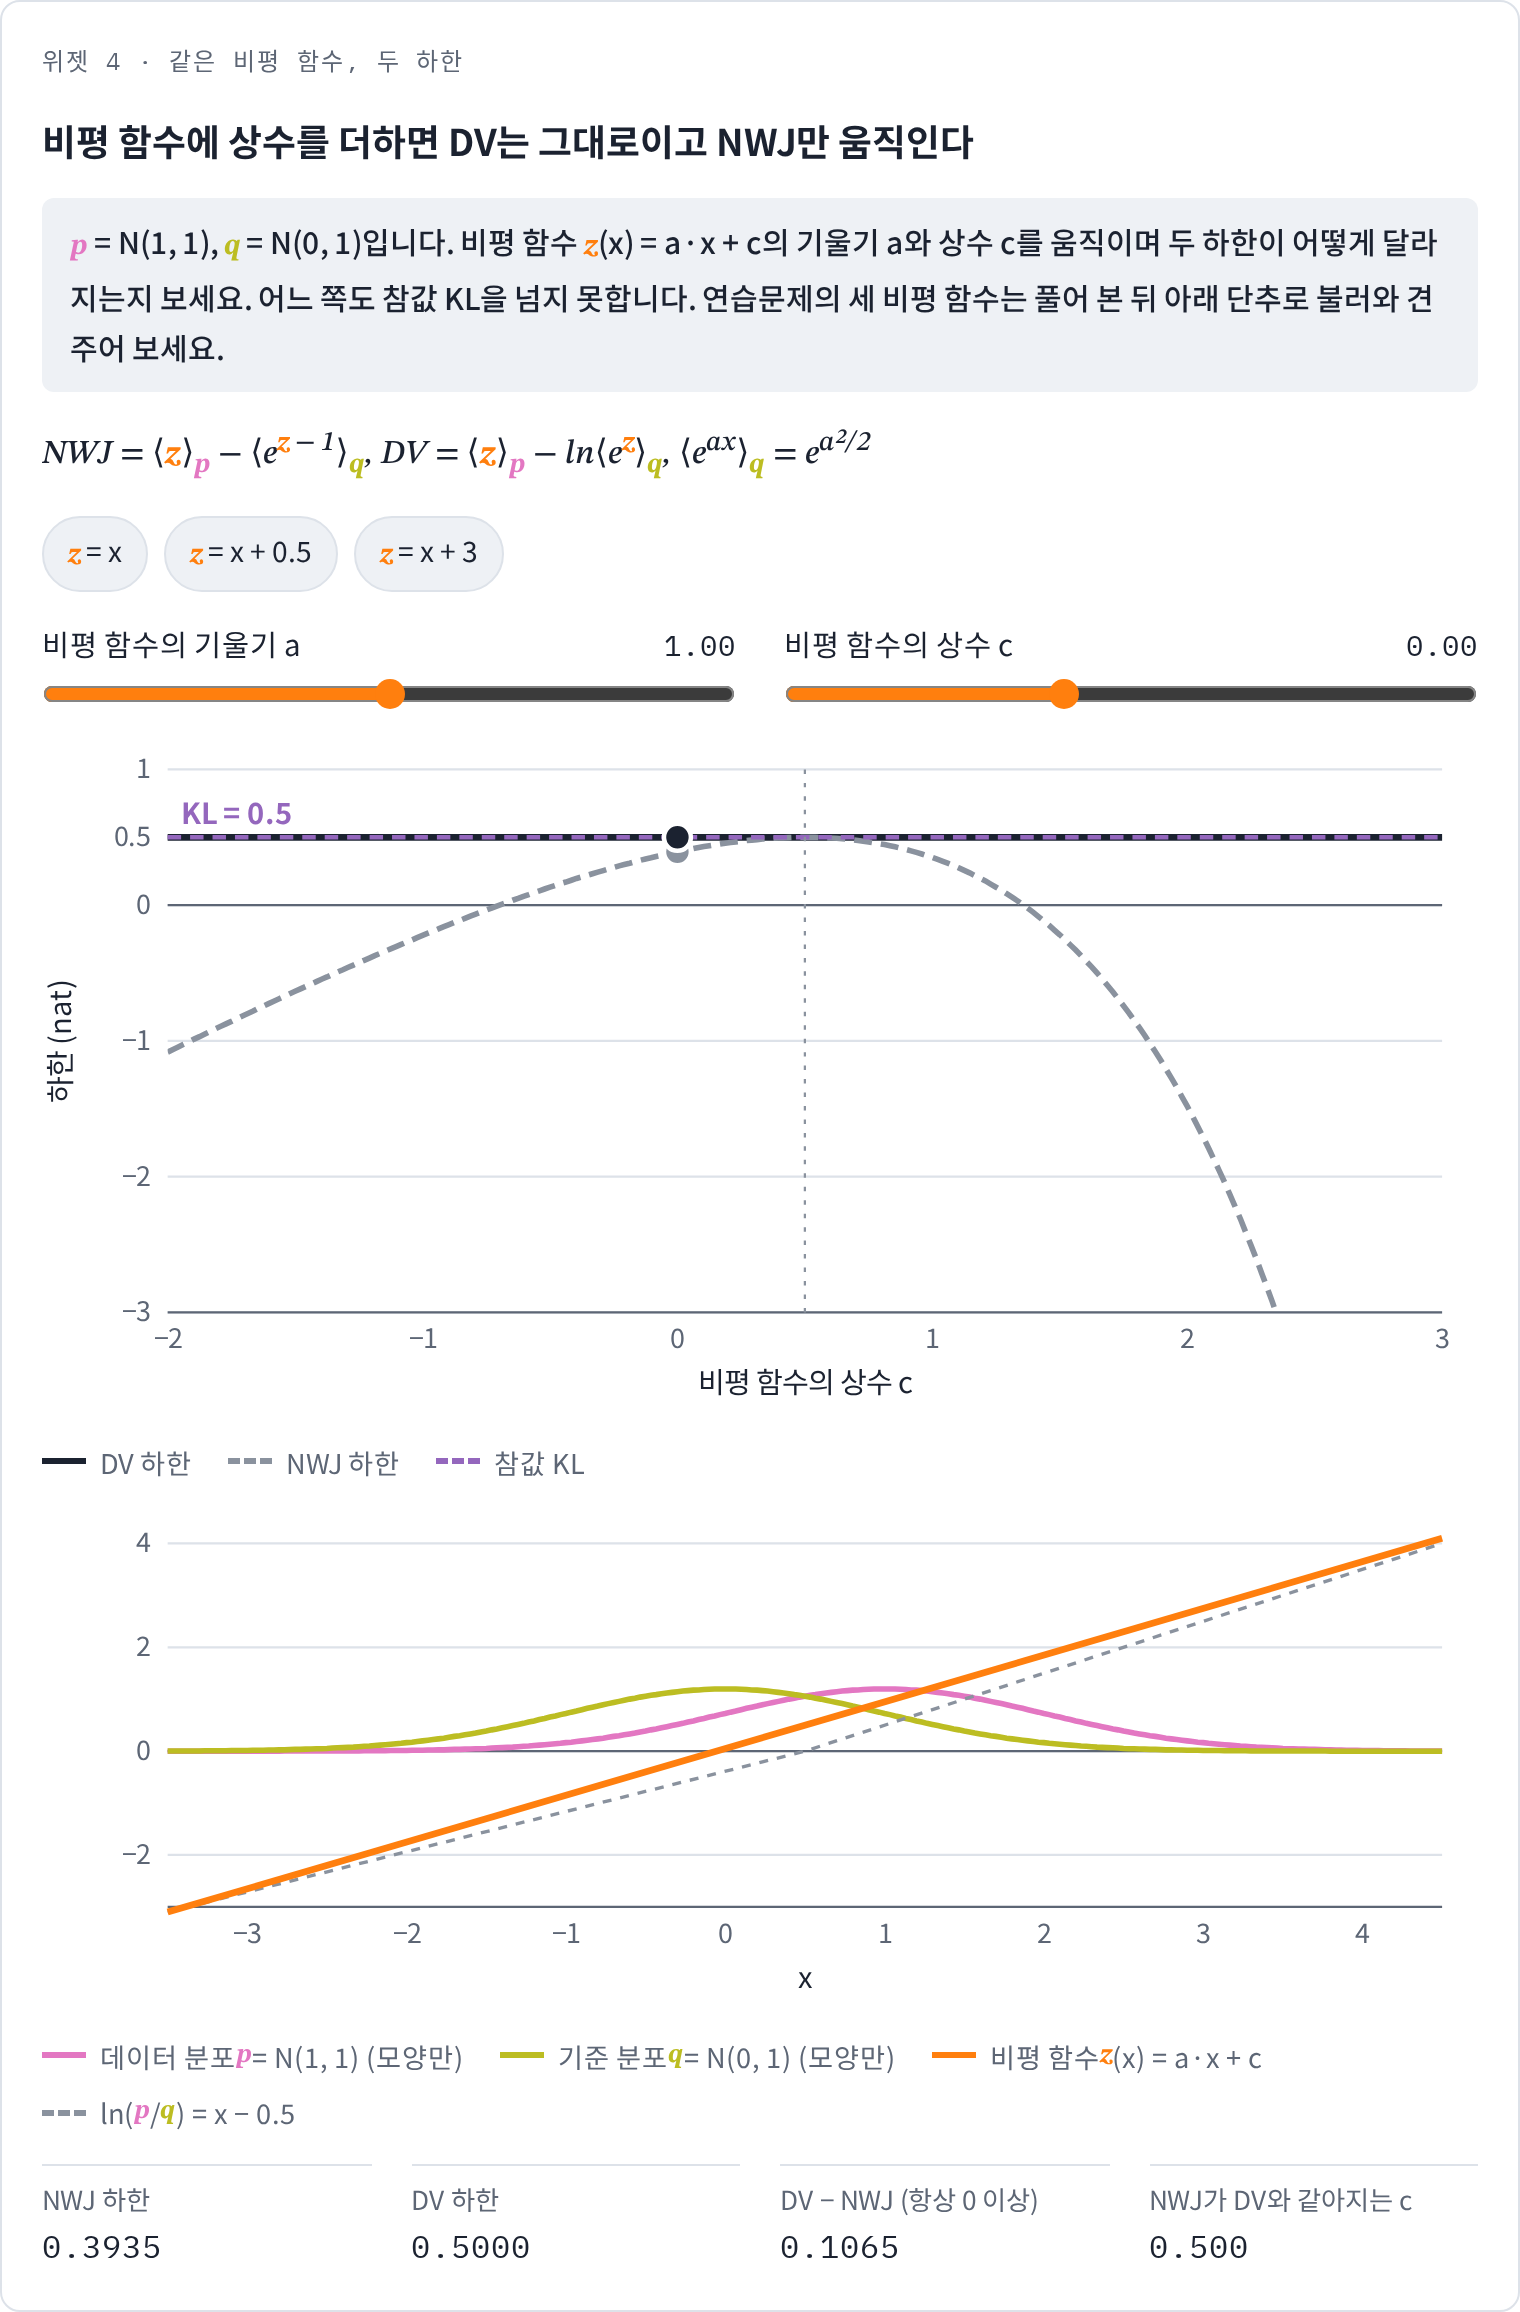
데이터 분포 p는 평균 1, 분산 1인 정규분포이고 기준 분포 q는 표준정규분포다. 분산이 같은 두 정규분포의 KL은 평균 차이의 제곱을 분산의 두 배로 나눈 값이라, 두 분포의 KL은 1²/2 = 0.5다. 비평 함수 z(x) = x를 NWJ 하한 ⟨z⟩_p − ⟨e^(z − 1)⟩_q와 돈스커–바라단(DV) 하한 ⟨z⟩_p − ln⟨e^z⟩_q에 넣어 비교하라. (q가 표준정규분포이면 ⟨e^(ax)⟩_q = e^(a²/2)다. 풀어 본 뒤 위젯 4의 단추로 세 비평 함수를 불러와 확인해 보자.)
데이터 분포 p = N(1, 1), 기준 분포 q = N(0, 1)과 비평 함수 z(x) = x
하한이요. 어떤 z를 넣어도 KL보다 작거나 같은 값이에요. 아, 0.39가 나온 건 틀린 게 아니라 z가 최적이 아니라는 뜻이네요.
이서연
DV는 1 − ln e^(1/2) = 0.5. 같은 z인데 DV는 참값이 나오네요. 왜 다르지?
선생님
최적의 비평 함수가 무엇이었는지 떠올리고 z = x와 견주어 봐요.
이서연
밀도 비의 로그요. ln(p/q) = x − 0.5니까 z = x는 거기서 상수만 달라요. DV는 그 상수 차이를 상관하지 않는 거고요.
선생님
그럼 NWJ가 원하는 최적의 z는요?
이서연
NWJ의 최적 비평 함수는 1 + ln(p/q)였으니까 x + 0.5예요. 넣어 보면 1.5 − ⟨e^(x − 0.5)⟩_q = 1.5 − 1 = 0.5. 이번엔 참값이에요.
김민준
그럼 상수를 크게 잘못 잡으면 어떻게 돼요? z = x + 3을 넣어 볼게요. NWJ는 4 − e^(2.5) ≈ −8.18이고… DV는 4 − ln e^(3.5) = 0.5. 우와, NWJ는 음수까지 떨어지는데 DV는 꼼짝도 안 하네요.
선생님
샘플 400만 개로 몬테카를로 계산해도 NWJ는 0.394, 0.501, −8.17이고 DV는 세 경우 모두 0.501이 나와요. 그럼 같은 z에서 DV가 항상 NWJ보다 크거나 같다는 걸 보일 수 있을까요?
이서연
⟨z⟩_p는 둘이 같으니까 빼는 항만 비교하면 돼요. y = ⟨e^z⟩_q라 두면 ln y ≤ y/e를 보이면 되는데… 이걸 어떻게 보이지.
선생님
y/e − ln y가 언제 가장 작아지는지 보면요?
이서연
미분하면 y = e에서 최소이고 그때 값이 1 − 1 = 0이에요. 해석학 연습문제로 자주 나오는 부등식인데 여기서 만날 줄은 몰랐네요.
김민준
그럼 신경망으로 KL을 잴 때 DV를 많이 쓰는 이유가 이거군요. 근데 스터디에서 DV는 로그 안에 평균이 들어 있어서 미니배치로 구한 그래디언트에 편향이 생긴다고 들었어요.
선생님
맞아요. 미니배치 평균의 로그는 참 평균의 로그와 기댓값이 다르니까요. 그래서 실제로는 분모 쪽 평균을 여러 미니배치에 걸친 이동 평균으로 바꿔 그래디언트의 편향을 줄이기도 해요. NWJ는 편향은 없는 대신 상수까지 맞춰야 하고요. 두 하한은 같은 르장드르 변환에서 나왔지만, 켤레를 다루는 방식이 달라서 실무에서의 장단점이 갈려요.