볼록이 아닌데 왜 통하나
볼록 함수라면 이 책은 많은 것을 장담할 수 있었다. 어느 두 점을 이은 현이 그래프 아래로 내려가지 않으면 극소가 곧 최소이고, 어디서 출발하든 경사하강은 같은 최소점에 닿는다. 그런데 신경망의 손실은 볼록이 아니다. 은닉 유닛 두 개의 가중치를 맞바꾸면 손실이 똑같은 다른 파라미터가 생기고, 원래 파라미터와 맞바꾼 파라미터를 반씩 섞은 가운데에서는 두 유닛이 같은 계산을 하게 되어 손실이 올라간다. 쓸 만한 신경망이면 거의 언제나 이렇다. 그러면 출발점에 따라 엉뚱한 웅덩이에 갇혀야 할 텐데, 파라미터가 수십억 개인 신경망들은 씨앗을 바꿔도 대개 비슷하게 낮은 손실에 닿는다. 볼록이라는 약속 없이 무엇이 학습을 지켜 주고 있을까?
역사: 역전파 논문이 적어 둔 걱정
볼록이 아닌 손실에서 경사하강이 낮은 곳에 닿느냐는 물음은 신경망 학습만큼 오래되었다. 1986년 러멜하트, 힌턴, 윌리엄스는 『네이처』에 역전파 논문을 실으면서 끝에 이 방법의 가장 뚜렷한 약점을 직접 적었다. 오차 곡면에 극소가 있을 수 있어서 경사하강이 전체의 최소를 찾는다는 보장이 없다는 것이다. 그리고 바로 이어서, 여러 태스크를 해 본 경험으로는 크게 나쁜 극소에 갇히는 일이 매우 드물었고, 그런 일은 태스크를 겨우 해낼 만큼만 연결을 둔 신경망에서 겪었으며, 연결을 몇 개 더하면 늘어난 차원이 장벽을 돌아가는 길을 만들어 준다고 썼다.
서른 해 남짓 뒤 리하오(Hao Li)와 동료들은 2018년 「신경망의 손실 지형 시각화」에서 학습이 끝난 신경망의 손실을 무작위 두 방향의 평면 위에 그려, 층 56개짜리 ResNet 의 지형이 지름길 연결을 빼면 울퉁불퉁해지고 지름길을 두면 고르게 된다는 것을 보였다. 걱정은 그대로 남았지만, 지형의 모양이 신경망의 짜임에 따라 달라진다는 것은 눈으로 보이게 되었다.
폭만 넓혀 보기
러멜하트와 동료들의 말, 연결을 더하면 갇히는 일이 줄어든다는 말을 가장 작은 실험으로 확인해 보자. 볼록성을 따질 때 쓴 자료를 그대로 쓴다. 표준정규분포에서 뽑은 2차원 점 200개(씨앗 0)에, 두 좌표의 부호가 같으면 1이고 다르면 0인 정답을 붙인다. 직선 하나로는 가를 수 없는 XOR 꼴이다. 은닉층 하나(tanh)짜리 신경망을 학습률 0.5의 경사하강으로 20000스텝 학습시키되, 은닉 유닛 수만 2, 4, 8, 16, 32, 64로 바꾸고 폭마다 무작위 출발점 20개(씨앗 1~20)에서 돌렸다. 학습 규칙도 자료도 학습률도 같고, 다른 것은 폭과 출발점뿐이다. 끝 손실이 0.05 아래면 낮은 곳에 닿았다고 치자(폭 4의 가장 좋은 끝 손실 0.0275의 두 배쯤으로 이 책에서 정한 기준이다).
| 은닉 유닛 수 (파라미터 수) | 0.05 아래에 닿은 출발점 | 가장 낮은 끝 손실 | 가장 높은 끝 손실 |
|---|---|---|---|
| 2 (9) | 0/20 | 0.4235 | 0.6030 |
| 4 (17) | 11/20 | 0.0275 | 0.4761 |
| 8 (33) | 20/20 | 0.0030 | 0.0086 |
| 16 (65) | 20/20 | 0.0013 | 0.0022 |
| 32 (129) | 20/20 | 0.0011 | 0.0015 |
| 64 (257) | 20/20 | 0.0010 | 0.0015 |
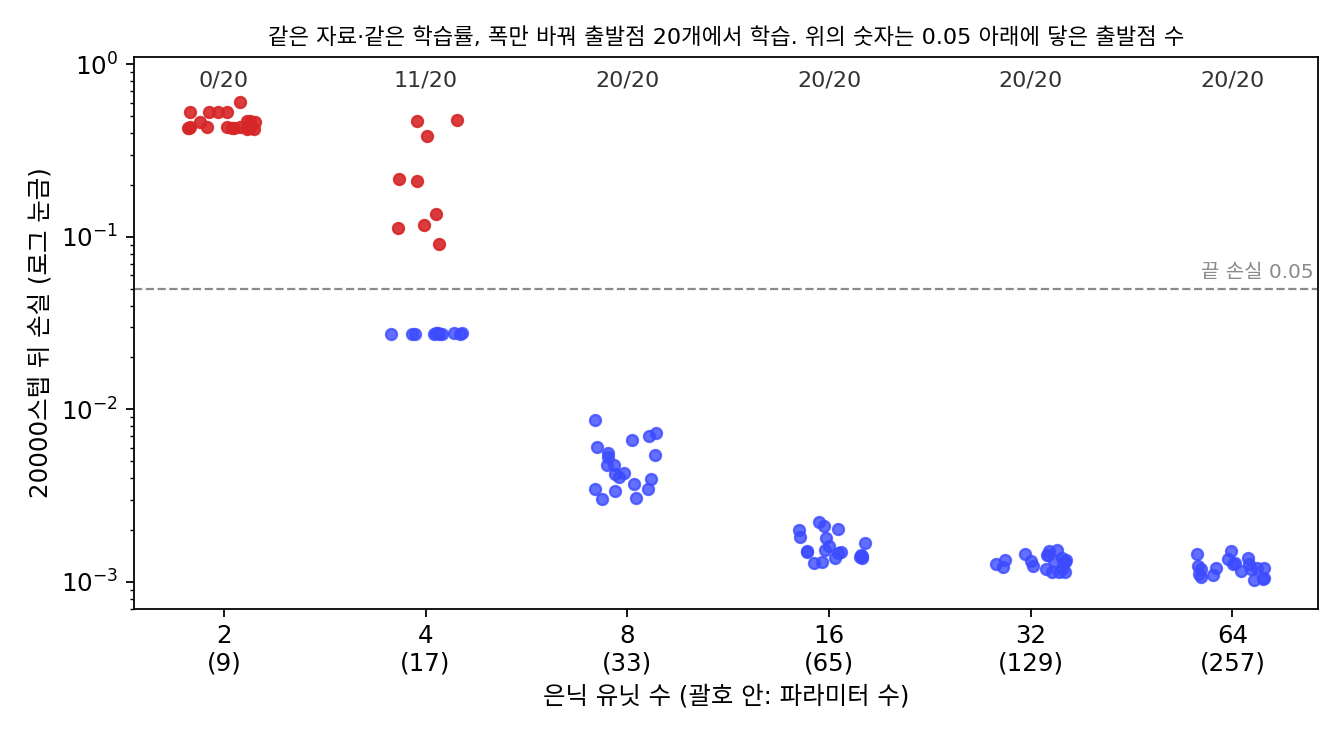
폭 2는 XOR 꼴을 풀기에 유닛이 모자라서 20번 모두 0.42 위에 머문다. 폭 4는 볼록성을 따질 때 본 모습과 같다(그때는 출발점 여덟 개 가운데 세 개가 더 높은 곳 근처에 머물렀다). 출발점 20개 가운데 11개는 0.0275 둘레에 닿고, 나머지 9개는 0.09에서 0.48 사이의 서로 다른 곳 근처에 머문다. 출발점이 도착지를 정하는 지형이다. 그런데 폭을 8로 늘리자 20번 모두 0.01 아래(가장 높아도 0.0086)에 닿는다. 폭 64에서는 가장 나쁜 출발점과 가장 좋은 출발점의 끝 손실이 0.0010과 0.0015로, 1.5배 차이 안에 든다. 파라미터가 늘었으니 지형은 더 복잡해졌을 텐데, 공은 오히려 출발점을 덜 탄다.
이 표가 보여 주는 것과 보여 주지 않는 것을 가려 두자. 이 작은 문제에서 폭을 넓히자 나쁜 곳에 멈추는 출발점이 사라졌다는 사실은 표에 보이지만, 왜 사라졌는지는 표가 말해 주지 않는다. 그래도 이 책이 지나오며 주운 조각 셋으로 짐작해 볼 수는 있다. 손실 지형을 다룰 때, 한 줄로 묶으면 웅덩이였던 자리가 차원을 하나 늘리자 한쪽으로는 내리막인 말안장 자리로 바뀌는 것을 보았다. 차원이 아주 많으면 모든 방향이 동시에 오르막인 자리가 드물어질 수 있다는 짐작이 여기서 나온다. 초기화와 잔차 연결은 층을 수십 겹 쌓아도 그래디언트가 사라지거나 터지지 않게 지형의 출발점을 다듬었다. 그리고 폭이 끝없이 넓어지면 학습하는 동안 특징이 거의 움직이지 않아 신경망이 선형 모델처럼 배운다는 신경 탄젠트 커널의 그림(「μP」에서 본 게으른 학습)에서는, 손실이 사실상 그릇처럼 다뤄진다.
그러나 어느 조각도 실제 신경망을 다 덮지 못한다. 차원이 많으면 나쁜 웅덩이가 드물다는 것은 짐작이지 정리가 아니고, 게으른 학습은 특징이 움직이지 않는다는 바로 그 가정 때문에 실제 큰 모델이 특징을 배우는 모습을 설명하지 못한다. μP 는 특징이 움직이지 않는 게으른 학습을 벗어나려고 나왔다. 위의 실험도 점 200개짜리 장난감이고, 폭이 넓어지면 손실을 더 낮출 수 있는 표현력도 함께 커지므로 「출발점을 덜 탄다」와 「더 잘 맞출 수 있다」가 섞여 있다.
ML에서: 같은 손실, 다른 바닥
남은 물음은 둘이다. 하나는 지금까지 물은 것, 볼록이 아닌 지형에서 경사하강이 왜 낮은 곳에 닿는가이고, 다른 하나는 그 뒤의 물음이다. 폭 64에서 출발점 20개는 모두 손실 0.001 둘레에 닿았지만, 같은 손실을 내는 파라미터가 같은 파라미터는 아니다. 은닉 유닛을 맞바꾼 것만으로도 서로 다른 최소점이 생긴다. 학습 손실을 거의 0으로 만드는 최소점이 수없이 많을 때 옵티마이저가 그 가운데 어느 것을 고르느냐는 「암묵적 편향」과 「이중 하강」에서 다룬 물음이고, 고른 최소점이 처음 보는 데이터에서도 잘 맞는가는 학습 손실만으로는 답할 수 없다. 왜 낮은 곳에 닿는지, 그리고 닿은 곳이 왜 좋은 곳인지, 두 물음 모두 아직 완결된 답이 없다.