스펙트럼 정규화: 층마다 가장 큰 특잇값으로 나눈다
그래디언트 페널티는 판별기를 가장 좋은 모양에 가깝게 만들었지만 값이 싸지 않다. 스텝마다 판별기의 그래디언트를 입력에 대해 구하고, 그 그래디언트의 길이를 다시 가중치로 미분해야 한다. 역전파로 구한 값을 다시 역전파해야 하니, 역전파를 한 번 더 하는 계산이다. 게다가 페널티는 진짜와 가짜를 잇는 선분 위에서만 걸리므로, 생성기가 움직여 가짜의 자리가 바뀌면 페널티가 걸리는 자리도 따라 바뀐다. 립시츠 상수를 모든 자리에서 장담하면서도 값싼 길은 없을까? 층을 쌓은 신경망의 립시츠 상수는 층마다의 스펙트럼 노름을 곱한 값을 넘지 않았으니, 층마다 스펙트럼 노름을 1로 맞추면 된다.
역사: 파워 이터레이션을 한 번만
2018년 2월, 일본의 프리퍼드 네트웍스(Preferred Networks)에서 일하던 미야토 다케루(宮戸岳)와 가타오카 도시키(片岡俊基), 리쓰메이칸 대학의 고야마 마사노리(小山雅典), 국립정보학연구소의 요시다 유이치(吉田悠一)가 「생성적 적대 신경망을 위한 스펙트럼 정규화」를 공개했다(ICLR 2018). 층마다 가중치를 그 층의 가장 큰 특잇값으로 나눠 쓰자는 생각 자체는 단순했고, 그들이 공을 들인 곳은 비용이었다. 가장 큰 특잇값은 파워 이터레이션(행렬과 그 전치를 번갈아 곱해 가장 크게 늘어나는 방향을 찾는 반복)로 어림하는데, 가중치는 학습 스텝마다 조금씩만 바뀌므로 지난 스텝의 벡터를 이어 쓰면 반복을 스텝마다 한 번만 돌려도 충분했다.
그들은 그래디언트 페널티와 견주어 두 가지를 짚었다. 그래디언트 페널티는 스텝마다 순전파와 역전파를 한 번 더 해야 하니 계산이 무겁다는 것, 그리고 페널티가 지금 생성기가 만든 샘플 근처에만 걸리기 때문에 생성기의 분포가 바뀌면 그 효과도 흔들리고, 실제로 학습률을 높이면 WGAN-GP 가 불안정해지는 것을 보았다는 것이다. 스펙트럼 정규화는 샘플이 아니라 가중치 행렬 자체를 묶으므로 생성기의 분포가 바뀌어도 효과가 달라지지 않는다고 했다. 또 하나 흥미로운 것은, 그들이 가장 좋은 결과를 낸 손실이 바서슈타인 거리의 어림이 아니라 경첩 손실(진짜 점수가 1보다 크고 가짜 점수가 −1보다 작으면 더 벌하지 않는 손실)이었다는 점이다.
같은 실험에 정규화를
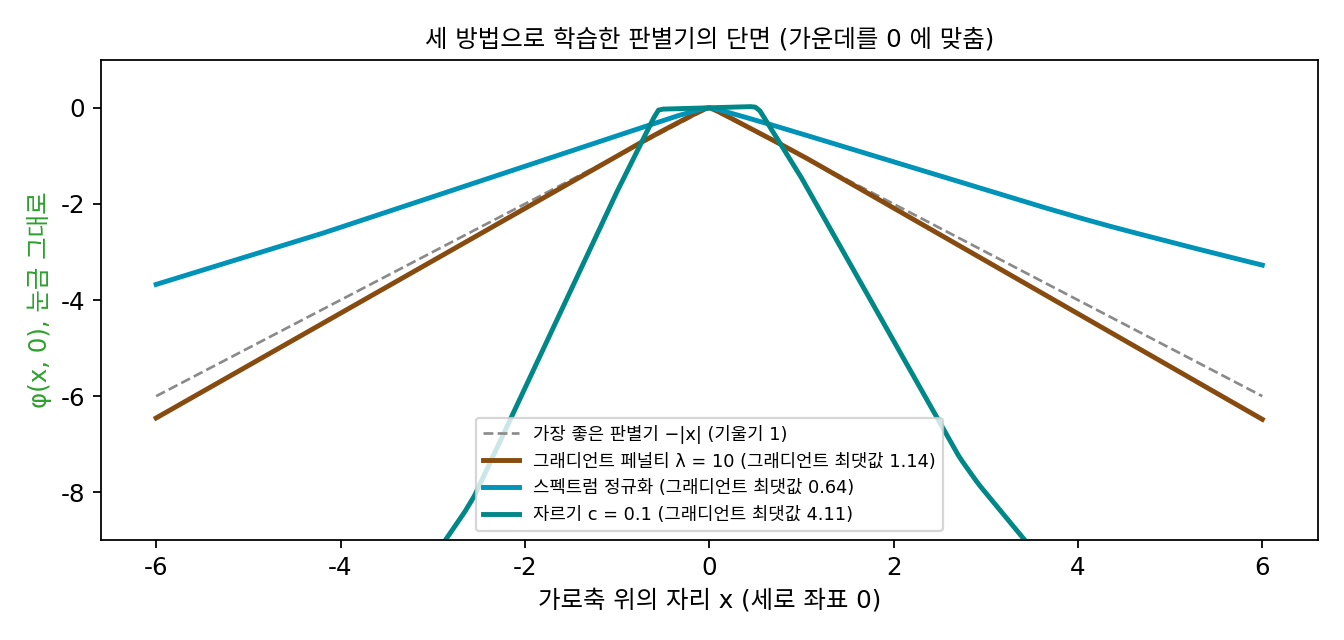
평면 위 실험에서 판별기의 네 층 모두에 스펙트럼 정규화를 걸고(스텝마다 파워 이터레이션 한 번), 페널티 없이 Adam 으로 6,000스텝 학습시켰다(씨앗 고정). 층마다 가장 큰 특잇값이 1이니, 곱셈 부등식에 따라 판별기 전체의 립시츠 상수는 1을 넘지 않는다.
점수 차는 0.7436으로 참값 1.2533의 59%다. 판별기의 그래디언트 길이는 평면 어디서도 0.6426을 넘지 않았고, 진짜와 가짜 사이 무작위 점에서는 평균 0.5929였다. 층마다 1로 묶었는데 판별기 전체의 그래디언트 길이는 1에 한참 못 미친 것이다. 곱셈 부등식은 「층마다 가장 크게 늘이는 방향이 서로 이어진다」는 가장 나쁜 경우의 상한이라, 실제 판별기는 그 아래에 머문다. 점수 차를 그래디언트 최댓값으로 나누면 1.157로 참값의 92%이니, 판별기의 모양은 가장 좋은 판별기에 꽤 가깝다. 눈금이 작을 뿐이다.
이렇게 신경망의 층마다 가중치 행렬 W를 그 가장 큰 특잇값 σmax(W)로 나눠 써서 층마다 스펙트럼 노름을 1로 맞추고, 신경망 전체의 립시츠 상수를 1 이하로 묶는 방법을 스펙트럼 정규화 (층마다 가장 큰 특잇값으로 나누기 / spectral normalization)라 한다.
ML에서: 디퓨전 이전의 생성 모델들
스펙트럼 정규화는 판별기를 묶는 값싼 방법으로 빠르게 퍼졌다. 2019년 딥마인드의 앤드루 브록(Andrew Brock), 제프 도너휴(Jeff Donahue), 캐런 시모니언(Karen Simonyan)이 ImageNet 의 범주마다 사진 같은 그림을 만든 BigGAN 은, 앞선 연구를 따라 판별기뿐 아니라 생성기에도 스펙트럼 정규화를 걸었다. 같은 해의 StyleGAN 은 R1 페널티를 썼다. 2017년부터 몇 해 동안 GAN 의 그림이 빠르게 좋아진 데에는, 판별기의 립시츠 상수를 묶어 판별기가 생성기에게 쓸모 있는 그래디언트를 계속 주게 한 이 장의 세 방법(가중치 자르기, 그래디언트 페널티, 스펙트럼 정규화)이 큰 구실을 했다. 2021년 OpenAI 의 프라풀라 다리왈(Prafulla Dhariwal)과 알렉스 니콜(Alex Nichol)은 「디퓨전 모델이 이미지 합성에서 GAN 을 이긴다」를 내고, 그 뒤로 그림을 만드는 모델의 중심은 디퓨전 모델로 옮겨 갔다.
문제 15. 두 층의 스펙트럼 정규화
활성화 없는 두 층 판별기 φ(x) = w₂ᵀW₁x가 있고, W₁ = diag(2, 1)이다. 층마다 가장 큰 특잇값으로 나누는 스펙트럼 정규화를 건 뒤의 그래디언트 길이를 w₂ = (1, 0), (0, 1), (1, 1)/√2일 때 각각 구하라. 정규화 뒤 판별기 전체의 립시츠 상수가 1이 되는 것은 어느 경우인가?

층마다 1로 나눴으니까 셋 다 1이죠. 곱셈 부등식이 1이잖아요.

w₂ = (0, 1)일 때 판별기는 입력의 어느 칸을 보죠?
W₁이 첫째 칸은 2배, 둘째 칸은 1배 하고, w₂ = (0, 1)은 둘째 칸만 읽으니까 정규화 전 그래디언트는 1이에요.
정규화하면요?

W₁은 2로, w₂는 1로 나누니까 0.5요. 1이 아니네요.

(1, 0)이면 2배로 늘인 첫째 칸을 읽으니 정규화 전 2, 정규화 뒤 1이야. (1, 1)/√2면 정규화 전 1.581, 뒤 0.7906이고. 1이 되는 건 둘째 층이 첫째 층이 가장 크게 늘인 방향을 읽을 때뿐이야.

평면 실험에서 스펙트럼 정규화 판별기의 그래디언트 최댓값이 0.64였던 것과 연결해 볼까요?
네 층이 각자 가장 크게 늘이는 방향이 서로 어긋나 있으면… 층마다 1이어도 곱한 결과는 1보다 작을 것 같아요. w₂ = (0, 1)처럼 다음 층이 앞 층의 가장 센 방향을 안 읽는 경우가 섞여 있는 거죠.
그럼 스펙트럼 정규화가 장담하는 건 무엇이죠?

립시츠 상수를 1 「이하」로 장담할 뿐, 1이 되게 하지는 않아요. 부등식의 상한과 실제 값을 구별하라는 게 해석학 시간 내내 들은 말이었는데 여기서도 나오네요.

팀원마다 「최대 출력」을 똑같이 맞춰 놔도, 서로 잘하는 일이 엇갈리면 팀 전체 성과는 그보다 낮은 거랑 같네요. 팀원의 최대 출력이 층마다의 스펙트럼 노름이고요.
문제 16. 스펙트럼 정규화 판별기의 점수 차
평면 위 실험에서 진짜 p = N(0, I), 가짜 q = N(0, 2²I)이고 바서슈타인 거리의 참값은 1.2533이다. 스펙트럼 정규화 판별기의 점수 차는 0.7436, 그래디언트 페널티 판별기의 점수 차는 1.3619였다. (가) 두 값을 바서슈타인 거리의 어림으로 읽으면 각각 몇 % 틀리는가? (나) 생성기 쪽에서 보면 두 판별기가 주는 그래디언트는 어떻게 다른가? (다) 미야토와 동료들이 가장 좋은 결과를 낸 손실이 바서슈타인 거리의 어림이 아니었다는 것은 무엇을 말해 주는가?
스펙트럼 정규화는 41% 작고, 그래디언트 페널티는 9% 커요. 그래디언트 페널티가 훨씬 정확하니까 무조건 그래디언트 페널티를 써야겠네요.
생성기가 바라는 것은 점수 차의 「값」인가요, 점수 차를 줄이는 「방향」인가요?
방향이요. 생성기는 판별기의 그래디언트를 따라 가짜를 옮기니까요. 스펙트럼 정규화 판별기는 그래디언트 길이가 0.6쯤으로 작지만 모양은 원뿔에 가까워서, 가짜를 원점 쪽으로 미는 방향은 같아요. 학습률을 조금 키우면 같은 스텝이 되겠네요.
문제 8의 이야기야. 상한이 K로 묶여만 있으면 점수 차는 K × W₁이고 방향은 같아. 스펙트럼 정규화 판별기는 K가 1보다 작고 위치마다 조금씩 달라서 정확한 눈금은 아니지만, 판별기의 점수 차가 끝없이 커지지 않게는 막아 줘. 점수 차가 묶여 있기만 하면 손실을 꼭 바서슈타인 거리의 어림으로 읽지 않아도 돼.

그래요. 그럼 이 장에서 판별기를 립시츠로 묶은 것이 결국 무엇 때문이었는지 한 문장으로 말해 볼까요?

판별기가 진짜와 가짜를 너무 날카롭게 갈라서 생성기에게 가는 그래디언트가 사라지거나 터지는 것을 막고, 점수가 「얼마나 먼지」를 담게 하려고요. 바서슈타인 거리는 그 생각을 처음 수학으로 정당화해 준 틀이고, 실제 학습에서는 거리의 정확한 값보다 그래디언트가 쓸모 있는지가 더 중요했어요.

점수의 절댓값보다 「어디를 고치면 오르는지」를 알려 주는 채점이 좋은 채점이라는 거네요. 문제 4의 부분 점수 이야기로 돌아왔어요.