암기–일반화 전이: 외우기를 멈추는 자리
디노이징에서는 원 위의 점 20,000개로 무게 평균을 내어 가장 좋은 디노이저를 계산했고, 학습 점만 보고 배운 디노이저가 무엇을 하는지는 측정하지 않았다. 그 점이 몇 개뿐이라면 어떨까? 이번에 볼 것은 라벨이 없는 생성 모델이고, 그림 생성 모델이 학습 그림을 거의 그대로 다시 그리는 일은 실제로 일어난다. 같은 입력에 늘 같은 답을 내는 생성기는 룩업 테이블이고, 학습 그림 가운데 하나를 무작위로 선택해 주는 생성기도 그림이 다양할 뿐 새 그림은 하나도 만들지 않는다. 디퓨전 모델은 노이즈를 걷는 디노이저를 배워 그림을 만든다. 그런데 학습 그림만 보고 가장 잘 걷는 디노이저를 만들면, 그 디노이저는 새 그림을 만들까 학습 그림을 꺼내 줄까? 그리고 실제 디퓨전 모델은 학습 그림이 몇 장일 때 꺼내 주기를 멈출까?
역사: 겹치지 않는 두 절반으로 배운 두 디노이저
2023년 칼리니와 동료들이 그림 생성 모델 Stable Diffusion에서 학습 그림을 거의 그대로 되살린 그림을 발견한 일은 디퓨전 모델도 외운다는 것을 보여 주었다. 그렇다면 외우지 않을 때는 무엇을 배우는가를 물은 연구가 이어졌다.
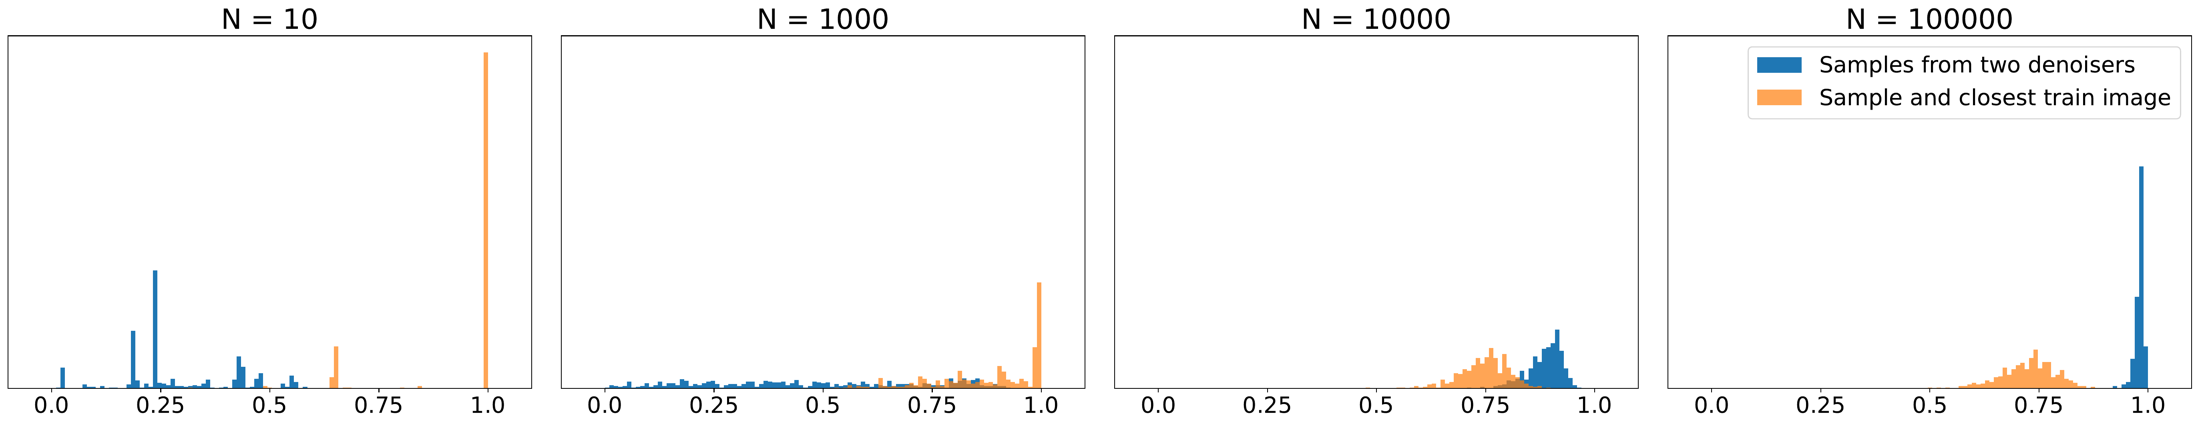
디노이징에서 만난 카드코다이 팀은 같은 논문(ICLR 2024)에서 간단한 실험도 했다. 논문 제목은 「디퓨전 모델의 일반화는 기하에 맞춰진 조화 표현에서 나온다(Generalization in Diffusion Models Arises from Geometry-Adaptive Harmonic Representations)」다. 얼굴 사진 자료 CelebA를 80 × 80으로 줄여, 학습 그림 수 N을 1장부터 10만 장까지 바꿔 가며 디노이저를 학습시켰다. 그리고 같은 N에서 서로 겹치지 않는 두 묶음으로 디노이저 둘을 따로 학습시켜, 같은 노이즈에서 출발해 그림을 만들어 비교했다. N이 1~100장이면 디노이저는 학습 그림을 외워, 두 디노이저가 각자 자기 학습 그림을 내놓았다. 1,000장이면 학습 그림과 비슷하지만 군데군데 일그러진 그림이 나왔고, 10만 장이면 두 디노이저가 거의 똑같은 그림을 만들었다. 서로 다른 그림으로 배웠는데 같은 것을 배운 것이다.
학습 그림 수만 바꿔 가며 두 번씩 학습시키는 거면, 생각만 떠올리면 누구나 할 수 있었을 것 같은데요.
두 디노이저가 「거의 똑같은 그림」을 만들려면 먼저 무엇이 되어 있어야 할까요?
음… 둘 다 그림을 제대로 만들 줄 알아야죠. 둘 다 엉망이면 같은지 다른지 볼 것도 없고요.
그래요. 노이즈를 걷어 그럴듯한 그림을 만드는 디퓨전 모델이 자리 잡은 것이 2020년 무렵이에요. 그 전에는 비교할 만한 디노이저부터 없었고, 「외우지 않을 때는 무엇을 배우나」라는 물음도 칼리니와 동료들이 외운 그림을 발견한 뒤에야 나왔어요.
그런데 1,000장에서 군데군데 일그러진 그림이 나왔다는 건 외우기와 새로 만들기 사이 어딘가였다는 거잖아요. 그 사이가 한 자리에서 확 바뀌는지 천천히 바뀌는지는 얼굴 그림 몇 장으로 알 수 있어요?
얼굴은 새 그림이 어디에 있어야 맞는지부터 말하기 어렵죠. 그래서 새 점이 놓일 곳이 분명한 자료로 작게 다시 해 보려는 거예요.
원 위의 점이면 새 점이 원 위에 있는지 눈으로 보이겠네요. 학습 점이 몇 개일 때부터 원 전체로 퍼지기 시작할까요?
원 위의 점으로 다시 해 보기
그 실험을 평면에서 작게 다시 해 보자. 자료는 디노이징에서 쓴 반지름 1인 원 위에서 각도를 0°~360° 사이에서 균일하게 아무렇게나 뽑은 점이다. 원을 선택한 것은 「학습 점으로 돌아가는가, 원 전체로 퍼지는가」를 눈으로 구분할 수 있고, 처음 보는 점이 어디에 있어야 하는지(원 위)가 분명하기 때문이다.
먼저 학습 점만 보고 만들 수 있는 가장 좋은 디노이저를 적어 보자. 학습 점 N개 가운데 하나에 노이즈가 섞여 x가 되었다면, 원래 점을 제곱 오차가 가장 작게 추정하는 값은 학습 점들의 가중 평균이다. 가까운 학습 점일수록 무게가 크다. 디노이징에서 원 위 점 20,000개로 낸 무게 평균과 같은 식이고, 다른 것은 평균에 넣는 점이 학습 점 N개뿐이라는 것이다.
f*의 출력은 늘 학습 점의 가중 평균이다. 노이즈 세기 σ를 큰 값에서 작은 값으로 줄여 가며 이 디노이저로 노이즈를 걷어 내면, 끝에 가서는 무게가 가장 가까운 학습 점 하나에 집중되고 출력은 그 학습 점이 된다. 학습 자료에서 가장 잘하는 디노이저는 룩업 테이블이다.
이제 원 위의 학습 점으로 작은 신경망 디노이저를 학습시킨다. 디노이저 fθ(x, σ)는 노이즈 낀 점과 노이즈 세기를 받아 원래 점을 추정하는 MLP(파라미터 33,794개)이고, 학습 점에 노이즈를 섞어 가며 원래 점을 맞히도록 6,000스텝 학습시킨다. 학습 점 수 N은 4, 10, 40, 100, 400, 1,000, 4,000으로 바꾼다. 학습한 디노이저로 노이즈 세기 3에서 0.002까지 40스텝에 걸쳐 노이즈를 걷어 점 1,000개를 만든다(sources/memorization/s3_denoiser.py).
만든 점이 새로운지는 가장 가까운 학습 점까지의 거리로 측정한다. 다만 학습 점이 많으면 원 위 어디에 점을 찍어도 가까운 학습 점이 있으므로, 원에서 새로 뽑은 점 1,000개의 같은 거리와 비교한다. 원에서 조금 벗어난 것이 섞이지 않게 거리는 원 위의 각도로 측정한다. 두 거리의 가운데값의 비를 「새로움 비」라 하자. 0이면 학습 점을 그대로 내놓은 것이고, 1 근처면 원에서 새로 뽑은 점만큼 학습 점과 떨어져 있는 것이다(sources/memorization/s3b_angle.py).
| 학습 점 수 N | 신경망: 새로움 비 | 신경망: 점이 있는 칸 (10°씩 36칸) | f*: 새로움 비 | f*: 점이 있는 칸 |
|---|---|---|---|---|
| 4 | 0.004 | 7 | 0.000 | 4 |
| 10 | 0.077 | 27 | 0.000 | 8 |
| 40 | 0.927 | 36 | 0.000 | 28 |
| 100 | 0.984 | 36 | 0.000 | 35 |
| 400 | 0.903 | 36 | 0.021 | 36 |
| 1,000 | 1.025 | 36 | 0.160 | 36 |
| 4,000 | 1.009 | 36 | 0.571 | 36 |
학습 점이 4개이면 신경망도 f*처럼 학습 점 넷으로 돌아가지만, 10개이면 대부분 학습 점 근처에 붙고 일부가 그 사이로 번진다. 40개부터는 만든 점이 학습 점 위가 아니라 원 위 아무 데나 떨어져서 새로움 비가 1에 가깝다. 원에서 벗어난 정도의 가운데값은 어느 N에서나 0.0012~0.0018이니, 만든 점은 원 위에 있다. 같은 학습 점을 본 f*는 N = 100까지 새로움 비가 0이다. 큰 N에서 f*의 새로움 비가 오르는 것은 학습 점 사이의 평균 간격(각도 2π/N, N = 1,000이면 0.0063, 4,000이면 0.0016)이 가장 작은 노이즈 세기 0.002에 가까워지거나 그보다 좁아져, 노이즈를 다 걷은 끝에도 이웃 학습 점끼리 섞이기 때문이다. 이렇게 학습 자료 수가 늘면서 생성 모델이 학습 자료를 꺼내 주다가 자료가 사는 곳 전체로 퍼져 새것을 만들기 시작하는 넘어감을 암기–일반화 전이 (외우기에서 새로 만들기로의 넘어감, memorization–generalization transition)라 한다.
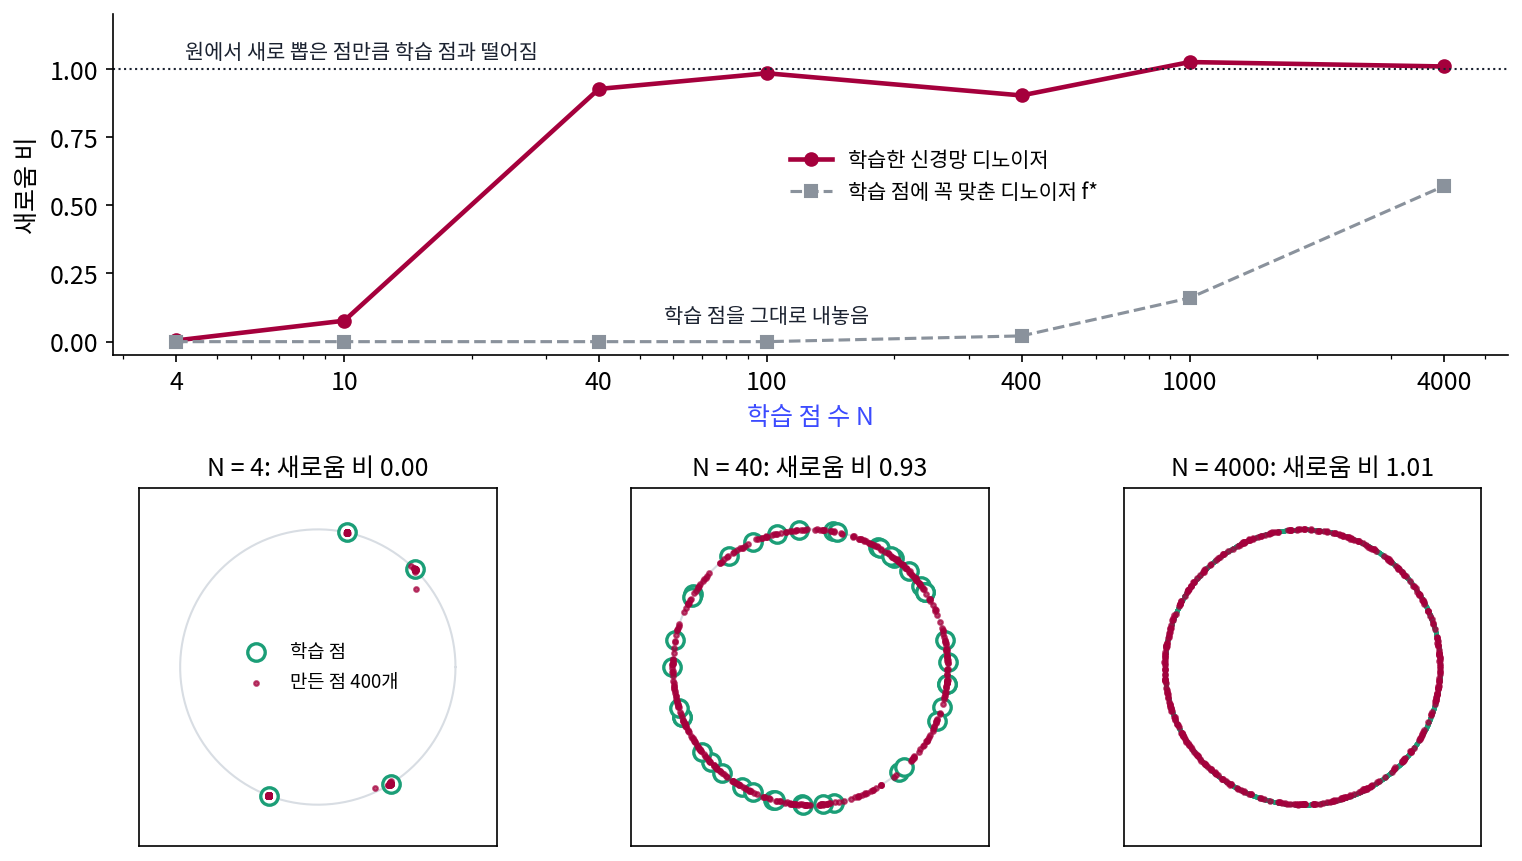
압축의 말로 읽으면 이렇다. 학습 점 N개를 그대로 지니는 설명의 길이는 N에 비례해 늘고, 「반지름 1인 원」이라는 설명의 길이는 N이 늘어도 늘지 않는다. 학습 점이 적을 때는 점을 그대로 적는 설명이 짧고, 많아지면 원이라는 설명이 훨씬 짧다. 신경망은 학습 자료를 맞히려고 했을 뿐인데, 자료가 많아지자 학습 자료에서 가장 잘하는 f*와 달리 짧은 설명인 「원」에 가까운 답을 냈다. 신경망이 왜 「원」에 가까운 답을 내는지에 대해 카드코다이 외는 디노이저가 그림의 기하에 맞춰진 축에서 계수를 줄이는 방식으로 일한다는 설명을 내놓았다. 원 위의 장난감에서 본 것은 넘어감 자체까지이고, 넘어감이 일어나는 원인이 그림에서와 같은지는 이 실험으로 말할 수 없다.
ML에서: 겹친 그림이 많으면 더 외운다
칼리니와 동료들은 「신경망 언어 모델의 암기를 측정하기(Quantifying Memorization Across Neural Language Models)」(ICLR 2023)에서 언어 모델이 「얼마나 외우는가」를 측정했다. 모델이 클수록, 학습 자료에서 같은 글이 여러 번 겹쳐 나올수록, 앞에 주는 문맥이 길수록 외운 글을 더 많이 내놓으며 셋 다 로그와 선형 관계를 따른다는 것이 그들의 보고다. 원 위의 실험으로 말하면, 같은 학습 점이 여러 번 들어간 자료는 서로 다른 점 수 N이 더 작은 자료와 비슷하다. 학습 자료에서 겹친 글과 그림을 제외하는 일이 외우기를 줄이는 방법으로 거론되는 것도 이 때문이다.
ML에서: 거의 같은 글을 찾는 자카드 유사도
겹친 글을 제외하려면 먼저 찾아야 한다. 글자가 똑같은 글은 쉽게 찾지만, 낱말 하나만 다른 글은 글자를 비교하는 방법으로는 탐지되지 않는다. 이럴 때 쓰는 척도는 식물학에서 왔다. 스위스의 식물학자 폴 자카드(Paul Jaccard)는 1901년 알프스 골짜기 몇 곳의 식물 목록을 비교하면서, 두 곳에 함께 자라는 종이 얼마나 되는지를 「공통 계수(coefficient de communauté)」라고 불렀다. 두 목록에 함께 든 종 수를 어느 한쪽에라도 든 종 수로 나눈 값이고, 지금은 자카드 유사도 (Jaccard similarity)라고 부른다.
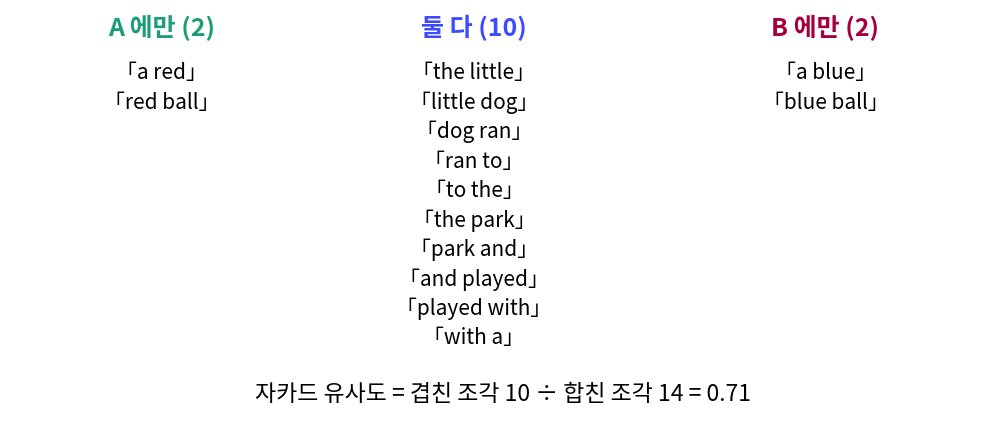
글에 쓰려면 글을 식물 목록처럼 조각의 집합으로 바꾼다. 낱말 두 개짜리 조각으로 자르면 「the little dog ran to the park and played with a red ball」은 조각이 12 개이고, red 를 blue 로 바꾼 문장도 12 개다. 두 문장에 함께 든 조각이 10 개, 어느 한쪽에라도 든 조각이 14 개라서 자카드 유사도는 10 ÷ 14 ≈ 0.71 이다(sources/memorization/s6_jaccard.out).
글이 수천만 개면 둘씩 모두 비교할 수 없다. 1997년 브로더(Andrei Broder)는 검색 엔진 알타비스타가 모은 웹 페이지에서 거의 같은 페이지를 찾으려고, 글마다 짧은 요약만 지니고 비교하는 방법을 논문 「문서의 닮음과 포함에 대하여(On the Resemblance and Containment of Documents)」로 냈다. 논문이 실린 곳은 「수열의 압축과 복잡도(Compression and Complexity of Sequences)」 학회였다. 조각을 모두 해시 함수 하나에 넣어 가장 작은 해시 값 하나만 남긴다. 합친 조각 14 개 가운데 해시 값이 가장 작은 조각은 균일하게 하나 뽑힌 것과 같고, 그 조각이 함께 든 10 개 가운데 하나일 때만 두 문장의 가장 작은 값이 같다. 그래서 가장 작은 값이 같을 확률이 자카드 유사도와 같다. 위 두 문장으로 측정하면 해시 함수 16 개에서 같은 비율이 0.625, 128 개에서 0.711, 1만 개에서 0.721 로 0.714 에 다가간다.
해시 함수 수백 개의 가장 작은 값을 모은 서명이 MinHash 다. 글 전체 대신 숫자 몇백 개만 지녀도 두 글이 얼마나 닮았는지 측정할 수 있으니, 서명은 닮음을 측정하는 데 필요한 만큼만 남긴 압축이다. 언어 모델의 학습 글에서 거의 같은 중복을 지우는 일에도 이 서명이 쓰인다.
문제 7. 받아쓰기 공책
받아쓰기를 준비하는 학생이 단어 하나의 철자를 하나하나 외우는 데 20비트가 든다고 하자. 맞춤법 규칙을 익히는 데는 한 번에 2,000비트가 들고, 규칙을 익힌 뒤에는 단어마다 소리만 2비트로 외우면 된다. (가) 단어 10개, 100개, 1,000개를 준비할 때 두 방법은 각각 몇 비트인가? (나) 단어가 몇 개를 넘으면 규칙이 짧아지는가? (다) 처음 보는 단어가 받아쓰기에 나오면?
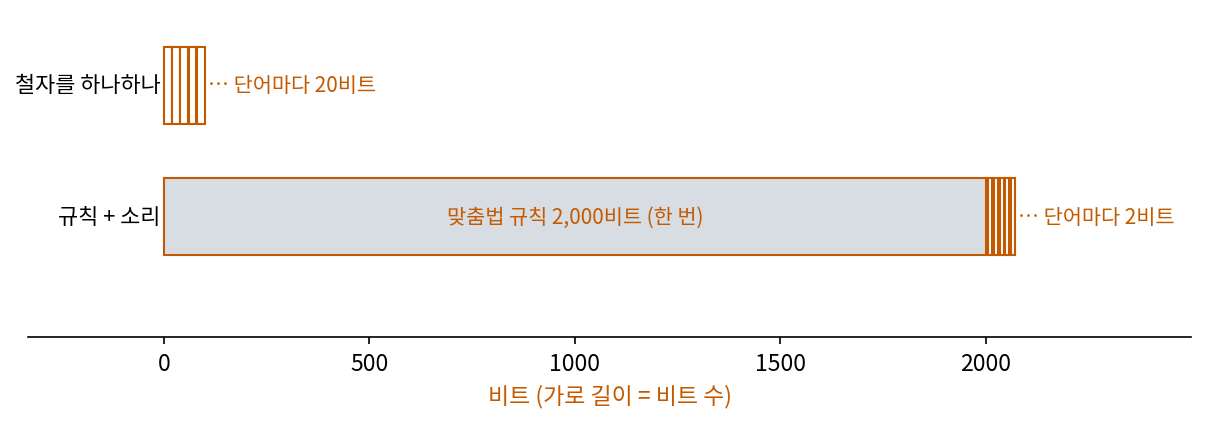
하나하나 외우면 20n, 규칙은 2,000 + 2n 이에요. 단어 10개면 200 대 2,020, 100개면 2,000 대 2,200, 1,000개면 20,000 대 4,000비트예요.
100개까지는 하나하나 외우는 게 짧고, 1,000개면 규칙이 다섯 배 짧네. (나)는 20n > 2,000 + 2n 이니까 n > 111.1, 112개부터 규칙이 짧아.
(다)는요?
철자를 하나하나 외운 학생은 처음 보는 단어를 못 써요. 규칙을 익힌 학생만 소리를 듣고 쓰고요.
그럼 단어가 10개뿐인 받아쓰기라면, 규칙을 익히는 데 2,000비트를 쓰는 건 손해일까요?
그 10개만 볼 거면 손해예요. 1,820비트나 더 들어요. 그런데 처음 보는 단어가 나올 거라면 이야기가 달라지고요. 어느 설명이 짧은지가 단어 수에 따라 바뀌는 거네요.
원 위의 디노이저랑 같네. 학습 점이 적으면 점을 그대로 적는 게 짧고, 많으면 「원」이라는 규칙이 짧아. 짧은 쪽이 바뀌는 자리가 전이가 일어나는 자리고.
문제 8. 학습 점 둘 사이에서
학습 점이 원 위 각도 0°의 (1, 0)과 90°의 (0, 1) 둘뿐일 때, 학습 점에 꼭 맞춘 디노이저 f*에 원 위 45°의 점과 40°의 점을 넣는다. (가) 노이즈 세기 σ = 1, 0.3, 0.1에서 두 학습 점이 받는 무게와 f*의 출력은? (나) 45°의 점에 대한 출력은 원 위에 있는가? (다) f*로 만든 점이 원 위의 새 점이 될 수 있는가?
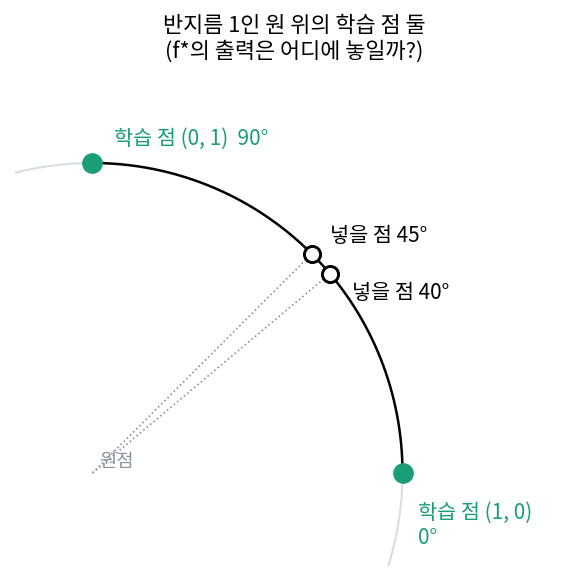
코드로 돌렸어요. 45°에서는 σ 가 무엇이든 무게가 0.5, 0.5라서 f* = (0.5, 0.5)예요. 40°는 σ = 1에서 0.531, 0.469, σ = 0.3에서 0.797, 0.203, σ = 0.1에서는 거의 1, 0이라 f* = (1, 0)이에요.
45°의 점을 넣었을 때 나온 점은 원 위에 있나요?
(0.5, 0.5)의 길이는 0.707이에요. 원 안쪽, 두 학습 점을 잇는 선분의 가운데예요.
그래도 (0.5, 0.5)는 학습 점에 없던 점이잖아. 45° 근처에서 시작하면 원 안쪽에 새 점이 계속 나오는 거잖아.
σ = 0.1에서 40°의 점은 어디로 갔죠?
음… (1, 0)으로요. σ 를 줄이면 조금만 한쪽에 가까워도 더 가까운 학습 점으로 끌려가네요. 딱 45°에 서 있지 않는 한, 노이즈를 다 걷어 내면 학습 점 둘 가운데 하나가 돼요. 새 점이 나오는 게 아니었어요.
f* 의 출력은 늘 학습 점의 가중 평균이니까, 나올 수 있는 건 학습 점을 이은 선분 위뿐이야. 원 위의 새 점은 만들 수 없어. 학습 점 사이를 섞는 건 새로 만드는 게 아니라 흐리게 하는 거지.
문제 9. 겹치지 않는 두 절반
원 위의 학습 점을 겹치지 않는 두 묶음 A, B로 나눠 디노이저 둘을 따로 학습시키고, 같은 처음 노이즈에서 점을 만들어 짝지은 두 점의 거리를 측정한다. 실험 결과 묶음마다 4개일 때 거리의 가운데값은 1.19, 400개일 때 0.047이었고, 원 위에서 아무렇게나 뽑은 두 점의 거리의 가운데값은 1.42다. (가) 두 결과를 해석하라. (나) 디퓨전 모델이 학습 그림을 외웠는지 확인할 때 이 방법이 학습 그림과의 거리를 측정하는 것보다 나은 점은 무엇인가?
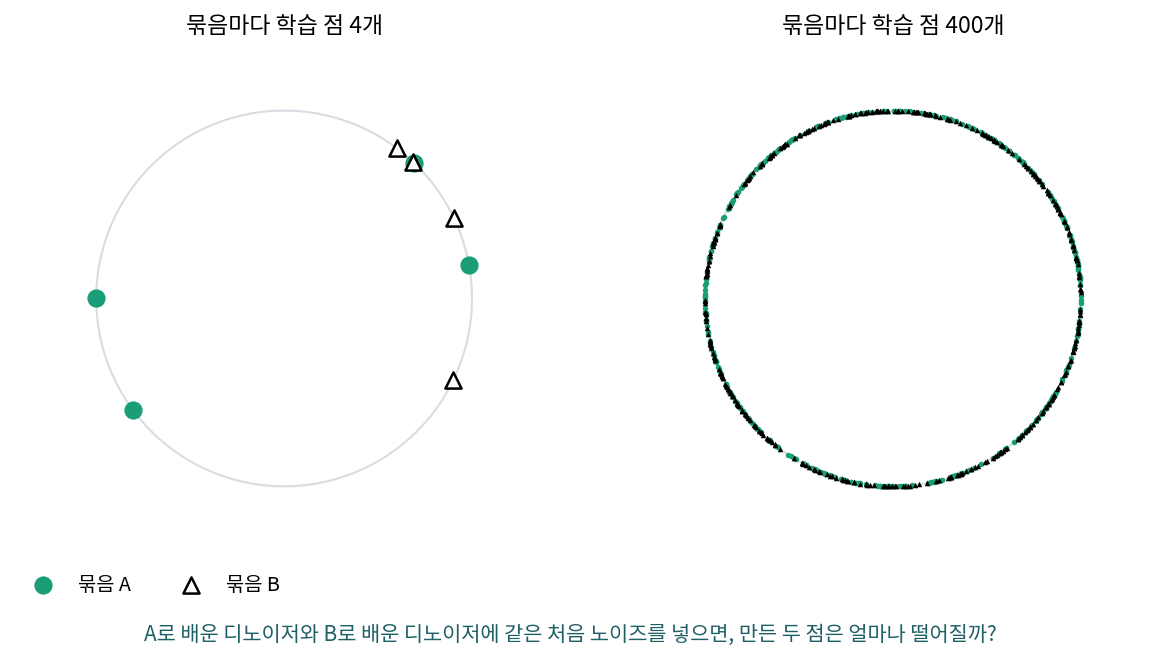
4개씩이면 1.19라서 아무렇게나 뽑은 두 점의 1.42에 가까워요. 두 디노이저가 서로 다른 점을 내놓은 거예요. 400개씩이면 0.047이라 거의 같은 점이고요.
4개씩일 때 두 디노이저는 각각 무엇을 내놓았을까요?
각자 자기 학습 점이요. A와 B의 학습 점이 서로 다르니까 같은 노이즈에서 출발해도 다른 데로 가요.
400개씩이면 A와 B는 점을 하나도 같이 안 썼는데 같은 데로 가잖아. 그럼 둘이 배운 건 각자의 학습 점이 아니라 둘이 함께 가진 것, 원이라는 거네.
그래요. (나)는요? 학습 그림과의 거리만 측정하면 어떤 일이 있을 수 있죠?
학습 그림이 아주 많으면 새 그림도 어느 학습 그림과는 가까울 수 있어요. 원 위에 점이 4,000개면 어디에 찍어도 가까운 학습 점이 있었던 것처럼요. 그래서 원에서 새로 뽑은 점과 비교해야 했고요.
두 절반 방법은 「무엇과 가까운가」를 묻지 않고 「다른 자료로 배워도 같은 것을 배우나」를 물어요. 같은 것을 배웠다면 그건 어느 한쪽 학습 자료에만 있는 것이 아니니까 외운 게 아니에요.
두 동네 기상대가 서로 다른 해의 기록만으로 따로 예보 모델을 만들었는데 내일 예보가 같게 나오면, 어느 해 기록을 외운 게 아니라 날씨가 도는 규칙을 둘 다 찾은 거겠네요. 서로 다른 해의 기록이 묶음 A와 B고요.