같은 것 지우기: 정확한 중복과 거의 같은 중복
서연이 처음 짚은 것은 같은 대화가 여러 번 들어 있는 문제였다. 중복을 찾는 가장 쉬운 방법은 글을 소문자로 바꾸고 띄어쓰기를 하나로 모은 뒤, 글자가 똑같은 것을 세는 것이다. 루나 말투 대화에서는 135 개(1.1%)가 나왔다.
정확한 중복만 지우면 쉼표 하나, 낱말 하나가 다른 대화는 남는다. 그런 대화는 몇 개나 될까? 서연은 예전 정보이론 수업에서 「겹친 글이 많으면 모델이 더 외운다」는 이야기와 함께 들은 잣대를 떠올렸다.
이번에는 두 대화를 낱말 다섯 개짜리 조각으로 자른다.
A: I cannot see your hand. What is it?
B: I cannot see your hand. Is it soft or hard?
A 의 다섯 낱말 조각: "i cannot see your hand", "cannot see your hand what", "see your hand what is", "your hand what is it"
B 의 다섯 낱말 조각: "i cannot see your hand", "cannot see your hand is", "see your hand is it", "your hand is it soft", "hand is it soft or", "is it soft or hard"
겹친 조각 1 개, 합친 조각 9 개 → 자카드 유사도 1/9 ≈ 0.11
대화 11,875 개를 둘씩 모두 비교하면 7,000만 쌍이 넘으므로, 대화마다 MinHash 서명을 만들어 서명이 닮은 쌍만 자세히 비교한다. 두 대화의 가장 작은 해시 값이 같을 확률이 두 대화의 자카드 유사도와 같다는 성질을 쓰는 것이다. 해시 함수 128 개로 128 칸 서명을 만들고, 네 칸씩 32 묶음으로 나눠 한 묶음이라도 똑같은 쌍만 후보로 삼은 뒤, 진짜 자카드 유사도가 0.7 이상인 쌍을 같은 묶음으로 모았다.
# sources/data-fix/dedup.py 에서
def shingles(t):                      # 낱말 다섯 개짜리 조각의 집합
    w = WORD.findall(t.lower())
    return {" ".join(w[i:i + K]) for i in range(len(w) - K + 1)}

def minhash(sh):                      # 해시 함수 128 개마다 가장 작은 값
    h = np.array([hash(s) & ((1 << 61) - 1) for s in sh], dtype=np.uint64)
    return (np.outer(h, A) + B).min(axis=0)
## 일반 대화 판 2(루나 말투, 거른 뒤)  (11,875)
  정확한 중복: 남는 것 11,740, 지울 것 135 (1.1%)
  거의 같음(자카드 >= 0.7): 묶음 11,539, 지울 것 336 (2.8%), 가장 큰 묶음 28
    묶음 크기 28:
      - user: What am I holding in my hand? assistant: I do not know. I cannot see your hand. What is it?
      - user: What am I holding in my hand? assistant: I do not know. I cannot see your hand. Is it soft or hard?
      - user: Luna, what am I holding in my hand? assistant: I do not know. I cannot see your hand. Is it soft or hard?
## 논리 이야기(받은 만큼)  (5,664)
  정확한 중복: 남는 것 5,664, 지울 것 0 (0.0%)
  거의 같음(자카드 >= 0.7): 묶음 5,664, 지울 것 0 (0.0%), 가장 큰 묶음 1
## 타이니스토리즈 V2 앞 10만 편  (100,000)
  정확한 중복: 남는 것 99,997, 지울 것 3 (0.0%)
거의 같은 중복까지 지우면 336 개(2.8%)가 빠진다. 가장 큰 묶음은 「모르면 모른다고 한다」 유형의 「What am I holding in my hand?」 28 개였다. 논리 이야기와 타이니스토리즈 앞 10만 편에서는 거의 없었다(타이니스토리즈의 셋은 빈 이야기다). 이야기는 길어서 우연히 겹치기 어렵고, 짧은 대화일수록 같은 말로 끝나기 쉽다.
역사: 6만 번 나온 문장
2021년 캐서린 리, 대프니 이폴리토, 니컬러스 칼리니 등은 언어 모델 학습에 널리 쓰이던 웹 글 모음 C4 를 뒤지다가, 61 낱말짜리 영어 문장 하나가 학습 글에 61,036 번 그대로 들어 있는 것을 찾았다(「Deduplicating Training Data Makes Language Models Better」). 그들이 살펴본 네 가지 데이터 모두에 중복이 있었고, 검증 글에도 학습 글과 겹치는 글이 있었다. 이런 데이터로 학습한 모델은 시작 문장 없이 쓰게 해도 내놓는 토큰의 1% 넘게가 학습 글을 외운 것이었다. 중복을 지우고 학습하자 외운 출력이 약 10분의 1 로 줄었다.
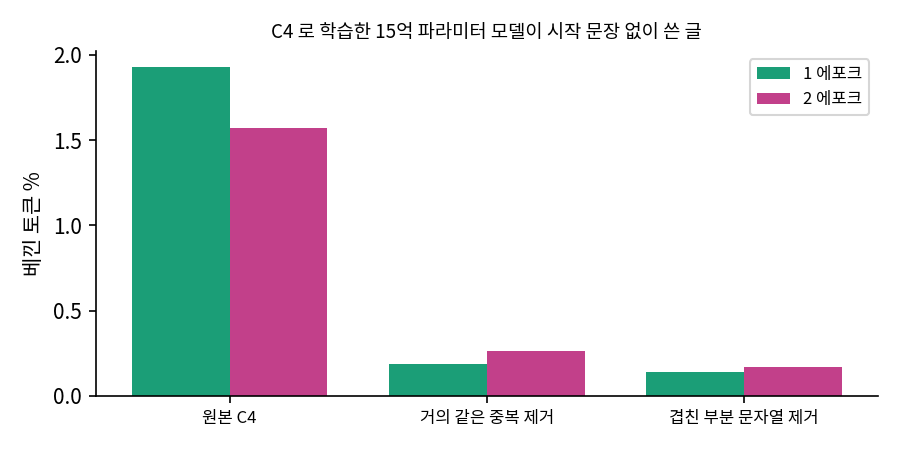
거의 같은 문서를 찾는 데 쓴 방법이 위의 MinHash 다. 글을 낱말 다섯 개 조각으로 자르고, 조각 집합의 서명을 비교해 후보를 고른 뒤 자세히 확인한다. 이 아이디어는 1997년 안드레이 브로더가 웹 문서끼리 얼마나 닮았는지를 짧은 서명으로 대략 측정하려고 낸 것이다. 우리는 그 논문보다 훨씬 작은 데이터에, 서명도 짧게(128 칸) 썼다.
문제 2. 두 대화는 얼마나 닮았나
(가) 「I like red apples」와 「I like green apples」를 낱말 두 개짜리 조각으로 자르면 조각은 각각 몇 개이고, 자카드 유사도는 얼마인가? (나) 같은 두 문장을 낱말 한 개짜리 조각으로 자르면 자카드 유사도는 커지는가, 작아지는가? (다) 「What am I holding in my hand?」 묶음 28 개 가운데 하나만 남기면, 루나는 「모르면 모른다고 한다」를 덜 배우게 될까?

(가)는 조각이 셋씩. 「I like」만 겹치니까 겹친 것 하나, 합친 것 다섯, 0.2.

(나)는 한 낱말이면 넷 가운데 셋이 같으니까 3/5 = 0.6 으로 커져. 조각이 짧을수록 다른 글도 닮아 보여.

그래서 조각의 길이를 정하는 게 「같다」의 기준을 정하는 거예요. (다)는요?

「What am I holding」 말고도 모르는 걸 묻는 대화가 천칠백 개 넘게 남아. 덜 배우진 않을 것 같아.
맞아요. 거의 같은 중복을 지워도 유형마다 남는 대화 수는 크게 바뀌지 않았어요. 「모르면 모른다고 한다」 유형은 1,885 개 가운데 1,757 개가 남았어요(dedup.out).