물음이 같으면 같은 대화일까
중복을 지워도 서연이 처음 본 「Why do we sleep?」는 113 개에서 101 개로, 열에 하나쯤만 줄었다. 답이 서로 달라서 자카드 유사도가 0.7 에 못 미친 것이다. 첫 물음만 놓고 세면 서로 다른 첫 물음은 11,875 개 가운데 6,128 개(51.6%)뿐이다.

그럼 물음 하나에 대화 둘까지만 남기자. 같은 이야기 열 번은 한 번이라니까.

그 규칙이 맞는지는 바로 확인할 수 있어요. 대화 수가 줄어드는 효과와 섞이지 않게, 같은 수를 무작위로 남긴 판도 같이 돌려 봐요.
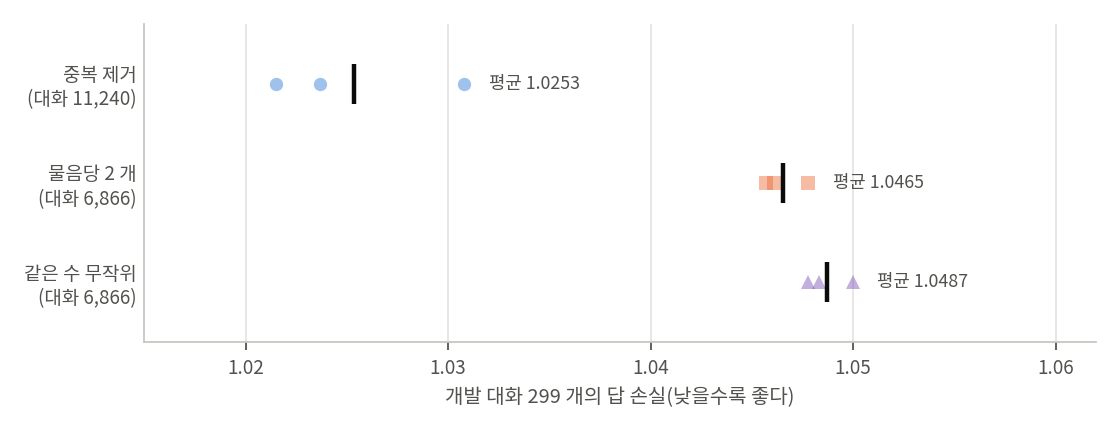
중복을 지운 판에서 같은 첫 물음을 둘까지만 남기면 대화가 11,240 개에서 6,866 개로 줄어든다(sources/data-fix/prep.py). 같은 6,866 개를 무작위로 뽑은 판을 하나 더 만들고, 판마다 시드 셋으로 학습해 떼어 둔 개발 대화 299 개의 루나 답 손실(답 토큰 하나에 대한 크로스 엔트로피, 낮을수록 처음 보는 물음에도 데이터의 답과 가깝게 답한다)을 측정했다.
| 판 | 대화 | 서로 다른 첫 물음 | 개발 답 손실(시드 1 / 2 / 3) |
|---|---|---|---|
| 중복 제거 | 11,240 | 5,815 | 1.0215 / 1.0308 / 1.0237 |
| 물음당 2 개 | 6,866 | 5,815 | 1.0478 / 1.0457 / 1.0461 |
| 같은 수 무작위 | 6,866 | 3,844 | 1.0500 / 1.0478 / 1.0483 |
줄인 두 판은 시드 셋 모두 손실이 0.020~0.023 늘었고, 서로는 거의 같았다(sources/data-fix/summary.out). 물음을 고르게 남기든 아무렇게나 남기든 결과가 같으니, 손실을 늘린 것은 대화 수가 39% 줄어든 일이다. 같은 물음에 답이 다른 대화는 루나에게 연습이 하나 더 있는 것이었다.
같은 말로 같은 것을 말하는 게 중복이에요. 같은 물음에 다른 말로 답한 대화는 킨더테일즈에서 거북이 사실 하나를 천 가지로 쓴 이야기와 같아요. 많을수록 루나가 「잠은 왜 자나」를 여러 길로 들어요.
그럼 고칠게요. 같은 이야기 열 번은 한 번이고, 다른 이야기 열 번은 열 번.
그러니까 많이 넣으면 좋다는 거지.
다른 거면.
그래서 루나 말투 대화는 거의 같은 중복까지 지운 판(11,240 개)으로 정했다. 이 판은 개발 답 손실과 시험지 점수에서 그대로 판과 같았고, 지운 336 개(2.8%)는 루나에게 새로 가르치는 것이 없던 대화였다.
문제 3. 받아쓰기 연습장
(가) 받아쓰기 연습장에 「사과」를 열 번 같은 글씨로 베껴 쓴 아이와, 「사과는 빨갛다」, 「사과를 먹었다」처럼 열 문장에 한 번씩 쓴 아이가 있다. 어느 쪽이 「사과」를 더 잘 쓰게 될까? (나) 루나 말투 대화의 「Why do we sleep?」 113 개는 (가)의 어느 쪽에 가까운가? (다) 「What am I holding in my hand?」 28 개는 어느 쪽에 가까운가?

(가)는 둘 다 사과는 쓸 줄 알게 되겠지만, 뒤쪽 아이가 사과를 문장에 넣어 쓰는 법까지 배워.

(나)는 뒤쪽이네. 물음은 같은데 답이 다 다르니까.
(다)는요?

앞쪽이에요. 답이 「I cannot see your hand」로 거의 같아서 자카드 유사도로 한 묶음이 됐잖아요. 그래서 하나만 남겼고요.

그래요. 중복의 기준은 답까지 같은 말인지예요. 물음만 같은 것은 중복이 아니에요.