생각의 깊이: LLM 물리학 시험과 캐논 층
이 장의 물음
「X 는 1970년에 태어났다. Y 는 X 와 같은 해에 태어났다. Y 는 언제 태어났나?」 사람에게는 문장 두 개를 이어 읽으면 끝나는 물음인데, 파라미터 13억 개짜리 언어 모델을 웹 글 1,000억 토큰으로 학습해도 이런 두 단계 물음에는 찍어서 맞히는 정도밖에 답하지 못했다는 보고가 있다. 대학 연구실이 감당할 수 있는 가장 큰 크기에서 그렇다. 같은 크기에서 모델 구조를 바꿔 보면 벤치마크 점수가 1~2% 오르내리는데, 학습을 시작할 때의 난수 시드만 바꿔도 점수는 2~4% 움직인다. 그렇다면 구조를 바꾼 것이 생각하는 힘을 늘렸는지는 무엇으로 알 수 있을까?
유도 헤드를 찾으면서 우리는 앞에 나온 토큰을 베끼는 일을 헤드 두 개가 나눠 맡는 것을 보았고, 그중 앞 토큰 헤드는 어텐션 헤드 하나를 다 써서 바로 앞 한 칸만 보았다. 지금까지 루나가 읽을 글을 고쳐 왔다면, 이 장은 그 관찰에서 출발해 구조를 고친다.
- 큰 모델을 학습하지 않고도 두 구조의 생각하는 힘을 가를 수 있는 시험은 어떻게 만들까?
- 바로 옆 토큰을 읽는 일을 어텐션 헤드보다 값싼 장치에 맡길 수 있을까? 맡기면 앞 토큰 헤드가 하던 일은 어떻게 될까?
- 그 장치를 덧붙인 GPT 는 여러 단계를 이어 가야 답이 나오는 시험을 같은 스텝 안에 배우기 시작할까?
합성 시험: 작은 모델로 구조를 측정하다
거꾸로 쓴 문장을 넣어 쿠키를 고친 지 며칠 뒤, 서연은 지난번에 막힌 물음을 공책에서 다시 찾았다. 쿠키를 준 사람이 Seoyeon 이라는 것과 Seoyeon 이 호숫가에 산다는 것을 둘 다 알아도, 「쿠키를 준 사람은 어디 살아?」에 답하려면 루나는 두 사실을 이어야 한다. 글을 바꿔 쓰는 일은 사실 하나하나를 늘렸을 뿐이니, 이어 읽는 힘은 구조를 고쳐야 늘지도 모른다. 서연은 라운지 노트북에 작은 모델로 구조를 비교한 논문의 첫 장을 띄웠다.

13억 파라미터 모델이 「Y 는 X 와 같은 해에 태어났다」를 못 이어 읽는다고? 우리 동화 루나는 2,760만 개인데.

그러니까 이 사람이 큰 모델을 버리고 시험지를 새로 만든 거야. 답이 하나로 정해지는 시험만.

오늘은 그 시험을 우리 크기로 줄여서 직접 만들어 볼 거예요. 시험이 생기면 구조를 바꾼 효과를 같은 크기, 같은 스텝에서 비교할 수 있어요.
이 장이 끝나면 우리는 여러 단계 찾기 시험을 직접 만들고, 우리 GPT 와 캐논 층을 덧붙인 GPT 가 같은 크기, 같은 스텝에서 이 시험을 얼마나 맞히는지 비교한다.
역사: 마찰 없는 평면에서 언어 모델을 측정하다
지어낸 전기로 지식을 측정하던 「언어 모델의 물리학」 연작은 지식 말고도 여러 능력을 다룬다. 연작의 홈페이지가 밝힌 불만은 완성된 큰 모델을 시험해 점수를 매기는 방식이었다. 학습 데이터에 시험 문제가 섞였을 수 있고, 수학 점수가 높아도 영어를 잘 읽어서인지 계산을 잘해서인지 가를 수 없다. 그래서 그들은 물리학자가 마찰 없는 평면이나 진공 상자를 쓰듯, 데이터를 처음부터 직접 만들어 한 가지 능력만 떼어 재기로 했다.
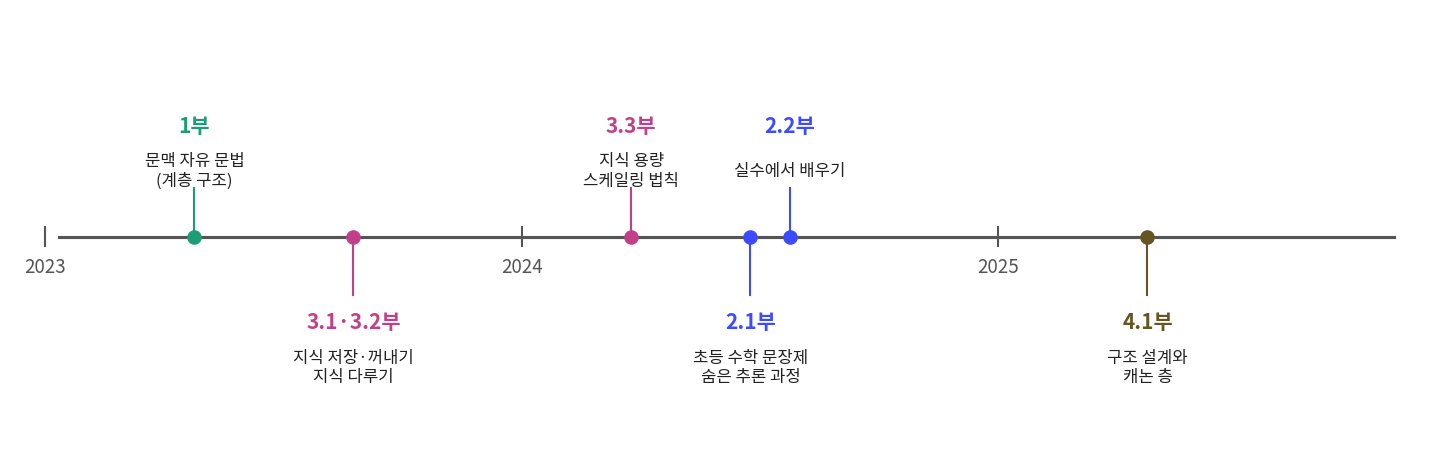
1부(2023)는 문맥 자유 문법(나무 모양 규칙으로 만든 문장)으로 계층 구조를 배우는지를, 2.1·2.2부(2024)는 초등 수학 문장제로 숨은 추론 과정과 실수에서 배우는 법을 재었다. 3.1·3.2·3.3부(2023~2024)는 지어낸 전기로 지식을 어떻게 저장하고 꺼내고 다루는지, 파라미터 하나에 몇 비트를 담는지를 보았다. 4.1부 「구조 설계와 캐논 층의 마법(Architecture Design and the Magic of Canon Layers)」은 알렌주가 혼자 써서 2025년 5월 2일 SSRN 에 처음 올렸고, NeurIPS 2025 본 학회에 실렸다(arXiv 2512.17351). 논문 각주에는 어느 ICML 심사위원이 「너무 놀라워서 믿기 어렵다」며 이 논문을 떨어뜨렸다는 이야기와 함께, 궁금한 독자는 직접 돌려 보라는 말이 적혀 있다. 이 장에서 우리가 하는 일이 그것이다.
한 능력만 떼어 내는 다섯 시험
4.1부는 시험을 고르는 기준을 넷 두었다. 앞 토큰 하나를 베끼는 일처럼 얕은 시험은 층이 적은 모델도 풀어 버리므로 구조의 차이를 드러내지 못하니 쓰지 않는다. 생각을 글로 적어 가며 푸는 사고 체인 없이 모델 안에서만 풀어야 한다. 학습 때보다 긴 글에서 버티는 능력은 시드에 따라 결과가 크게 바뀌어 비교에 쓰지 않는다. 계산기에 맡기면 되는 큰 수 덧셈 같은 능력보다 실제로 두루 쓰이는 능력을 재는데, 이 기준으로 만든 시험이 다섯이다.
| 시험 | 측정하는 능력 | 문제 |
|---|---|---|
| Depo | 추론의 깊이 | 뒤섞어 늘어놓은 화살표를 k 번 따라간 끝의 노드 |
| Brevo | 추론의 너비 | 의존 관계 그래프에서 한 노드가 의존하는 노드를 모두, 위상 순서대로 |
| Capo | 지식 용량 | 지어낸 전기를 파라미터 하나에 몇 비트 담나 |
| Mano | 지식 다루기 | 23 으로 나눈 나머지 사칙연산을 여러 겹 중첩한 식의 값 |
| Lano | 계층 구조 | 문맥 자유 문법의 문장을 이어 쓰기 |
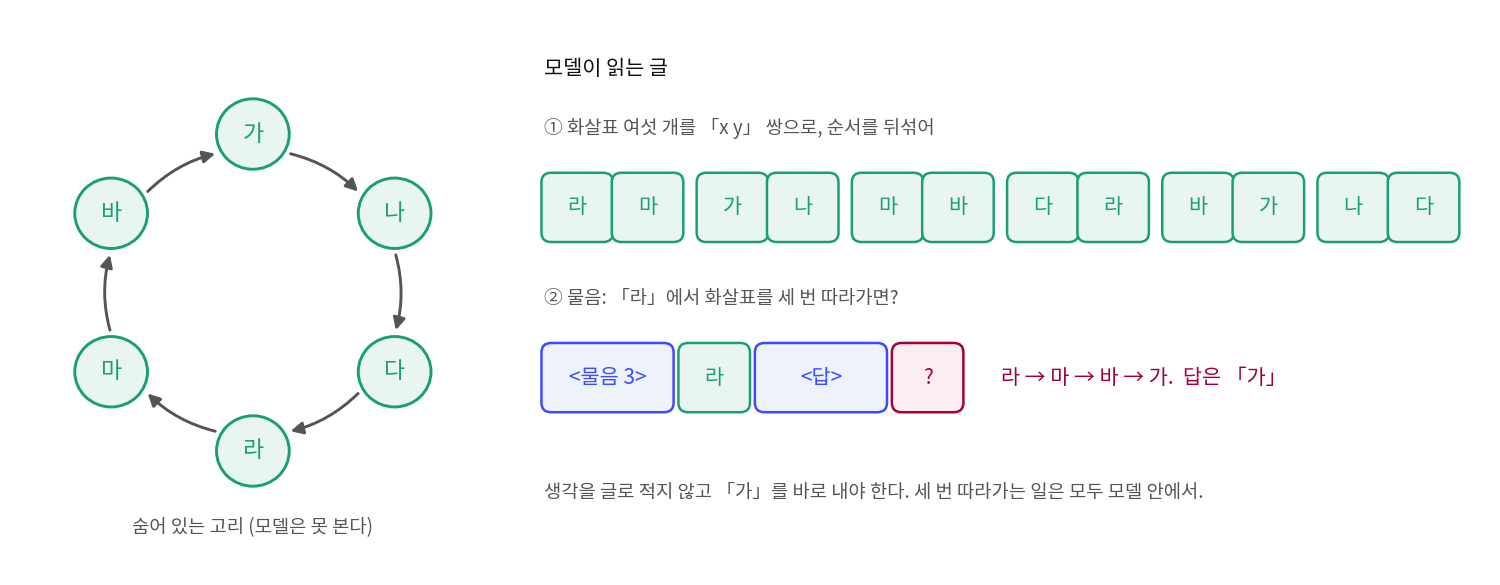
이 장은 첫째 시험 Depo 만 쓴다. 노드 n 개가 한 바퀴 고리를 이루고, 화살표 n 개를 「x y」 쌍으로 순서를 뒤섞어 늘어놓은 뒤, 「노드 q 에서 화살표를 k 번 따라가면 어디인가」를 묻는다. 화살표가 뒤섞여 있으니 한 번 따라갈 때마다 글 전체에서 다음 쌍을 찾아야 하고, 답 토큰은 생각을 적지 않고 바로 내야 한다.
논문의 Depo1 은 노드 이름을 토큰 1~2 개로 짓고 n 을 최대 225~375, k 를 최대 8 까지 두고 문맥 2,048 토큰에 문제를 채웠다. 8~12층, 폭 512~768 의 RoPE 트랜스포머를 최대 8 단계 데이터로 학습하자, 노드가 375 개인 가장 어려운 설정에서는 4 단계 물음도 0~3% 밖에 맞히지 못했다.
우리 시험: 노드 16 개, 최대 4 단계
우리는 4층, 폭 256 의 GPT 로 시험을 줄였다. 노드 이름은 토큰 50 개 가운데 1~2 개로 짓고 마지막 토큰에 「이름 끝」 표시를 붙여 노드 토큰이 100 개다. 학습 문제의 노드 수 n 은 3~16 에서 고르되 작은 n 을 더 자주 뽑고(무게 1/(n + √16), 공식 생성 코드와 같다), 물음의 단계 수 k 는 1~4 에서 고르게 뽑는다. 문제마다 물음은 10 개이고, 문맥 512 토큰에 문제를 앞에서부터 채우며, 손실은 답 토큰에만 건다. 시험은 n = 16 으로 고정하고, k 마다 물음 1,000 개 이상에서 답 토큰을 모두 맞힌 비율을 구한다. 노드가 16 개이니 아무렇게나 골라도 6.25% 는 맞는다.
# sources/canon/depo.py 에서 (공식 생성 코드 facebookresearch/PhysicsLM4 의 depo.py 규칙을 따름)
def problem(rng, n=None, ks=None):
    if n is None:   # 작은 고리를 더 자주: 무게 1/(n + sqrt N)
        cand = list(range(3, args.N + 1))
        n = rng.choices(cand, weights=[1.0 / (i + math.sqrt(args.N)) for i in cand])[0]
    vals = make_words(rng, n)          # 노드 이름 n 개 (토큰 1~2 개)
    rng.shuffle(vals)
    order = rng.sample(range(n), n)    # 화살표를 늘어놓는 순서도 뒤섞는다
    toks = []
    for i in order:
        toks += vals[i] + vals[(i + 1) % n]          # 「x y」 = x -> y
    lab = [0] * len(toks)
    for j, idx in enumerate(rng.sample(range(n), k=min(n, 10))):
        k = ks[j % len(ks)] if ks else rng.randint(1, args.K)
        v1, v2 = vals[idx], vals[(idx + k) % n]      # 답 = k 번 따라간 노드
        toks += [Q0 + k - 1] + v1 + [ANS]
        lab += [0] * (len(v1) + 2)
        toks += v2
        lab += [1] * len(v2)                         # 손실은 답 토큰에만
    ...
문제 1. 생각을 적어도 되면 k 단계 찾기는 무엇이 되나
Depo 는 답 토큰을 바로 내게 한다. 모델이 답 앞에 「라 → 마, 마 → 바, 바 → 가」처럼 중간 노드를 글로 적어도 된다고 하자. (가) 그때 모델이 토큰 하나를 낼 때마다 해야 하는 일은 무엇인가? (나) 그래도 이 시험이 「추론의 깊이」를 측정한다고 할 수 있는가? (다) 요즘의 추론 모델은 긴 사고 체인을 쓰는데, 논문은 왜 굳이 사고 체인 없는 깊이를 따로 측정하려 했을까?

(가)는 쉽네. 「라」 다음을 찾아 「마」를 적고, 그다음엔 「마」 다음을 찾아 「바」를 적고. 매번 한 번만 따라가면 돼.
그럼 k 가 몇이든 토큰 하나에 필요한 건 한 단계 찾기뿐이네. (나)는… 깊이가 아니라 몇 번 되풀이하느냐를 측정하는 시험이 되는 것 같아요.
그래요. 논문도 각주에서 사고 체인을 쓰면 k 단계 물음이 1 단계 찾기로 줄어든다고 적었어요. (다)는요?
음, 사고 체인은 토큰을 쓸 때마다 시간이 드니까요? 안에서 네 단계를 하는 모델이랑 한 단계밖에 못 하는 모델이 둘 다 32 단계 문제를 풀어도, 앞의 모델은 글을 4분의 1 만 쓰면 되잖아요.
논문이 든 예도 그 계산이에요. 안에서 4 단계를 하는 모델이 사고 체인으로 8 번 이어 쓰면 32 단계가 되는데, 구조의 힘은 안에서 한 4 단계 쪽에 있다고 봤어요. 그래서 구조를 고치려면 사고 체인 없는 깊이를 측정해야 한다는 거죠.
그럼 우리 시험에서도 답 앞에는 아무것도 못 적게 해야겠네요. 「<답>」 바로 다음 토큰이 답이게.
문제 2. 시드만 바꿔도 점수가 2~4% 움직이면
13억 파라미터 모델을 1,000억 토큰으로 학습한 뒤 벤치마크로 측정하면, 구조 A 와 B 의 점수 차이는 1~2% 이고 같은 구조에서 난수 시드만 바꾼 점수 차이는 2~4% 였다(논문 그림 1). (가) A 가 B 보다 1.5% 높게 나왔다면 A 가 낫다고 할 수 있나? (나) 시드를 여럿 돌려 평균을 내면 해결될 것 같은데, 실제로 어려운 점은 무엇인가? (다) 합성 시험은 이 문제를 어떻게 피하나?
(가)는 못 하지. 같은 구조끼리도 2~4% 차이가 나는데, 1.5% 는 그 안에 들어가잖아.
(나)는 돈이야. 13억 모델을 1,000억 토큰 학습하는 걸 시드마다 다시 하면, 구조 하나 비교하는 데 큰 학습을 여러 번 해야 해.
맞아요. 그리고 하나 더 있어요. 그 크기의 모델은 두 단계 생년 물음도 찍어서 맞히는 정도였죠. 두 모델이 둘 다 0 근처면요?
둘 다 못 하니까 차이가 아예 안 보여요. 시드를 아무리 늘려도 0 과 0 을 비교하는 거고요. 그럼 (다)는 시험을 작게 만들어서 작은 모델도 어느 정도는 풀게 하고, 학습도 싸게 여러 번 돌리는 거겠네요.
그래요. 합성 데이터는 얼마든지 새로 만들 수 있으니 같은 문제를 두 번 보지도 않아요. 우리도 시드 셋으로 돌릴 거예요.