여러 단계 찾기: 캐논 층을 덧붙인 GPT 는 이 시험을 배울까
캐논 층이 앞 토큰 헤드의 일을 대신한다면 층 하나를 아끼는 효과는 있다. 그런데 화살표를 네 번 따라가야 하는 물음에서는 층 하나를 아끼는 것보다 더 큰 차이가 날까? 우리 시험으로 직접 측정해 보자.
같은 크기, 같은 스텝, 시드 셋
두 모델은 캐논 층 말고는 모두 같다. 4층, 폭 256, 헤드 4 개, 문맥 512 토큰의 GPT 이고, 배치 64 로 8,000 스텝을 학습했다. 옵티마이저는 AdamW(학습률 1e-3, 워밍업 200 스텝 뒤 코사인으로 10% 까지, 가중치 감쇠 0.03, 모멘트 계수 β(베타) = (0.9, 0.98))로, 논문 부록의 설정을 따랐다. 캐논 층을 네 자리에 모두 넣은 모델의 파라미터는 3,360,256 개로, 넣지 않은 모델(3,323,392 개)보다 36,864 개(1.1%) 많다. 학습 데이터는 시드마다 새로 만들고, 시험 문제는 모든 모델이 같은 것을 푼다.
[캐논 없음] 파라미터 3,323,392 개 (캐논 층 0)
  depo_N16_K4_L4_base_s1: k=1:  8.5% k=2:  8.1% k=3:  8.9% k=4:  9.9%
  depo_N16_K4_L4_base_s2: k=1:  8.5% k=2:  7.9% k=3:  9.2% k=4:  8.9%
  depo_N16_K4_L4_base_s3: k=1:  8.3% k=2:  7.9% k=3:  7.7% k=4:  7.3%
[캐논 ABCD] 파라미터 3,360,256 개 (캐논 층 36,864)
  depo_N16_K4_L4_ABCD_s1: k=1: 97.5% k=2: 90.8% k=3: 45.2% k=4: 16.4%
  depo_N16_K4_L4_ABCD_s2: k=1: 96.3% k=2: 92.0% k=3: 72.7% k=4: 40.3%
  depo_N16_K4_L4_ABCD_s3: k=1: 97.8% k=2: 96.8% k=3: 91.0% k=4: 70.7%
  시드 평균: k=1: 97.2% k=2: 93.2% k=3: 69.6% k=4: 42.5% | 가장 낮은 시드~가장 높은 시드: 96.3~97.8 90.8~96.8 45.2~91.0 16.4~70.7
무작위로 고를 때의 정답률: 노드 16 개 가운데 하나 = 6.25%
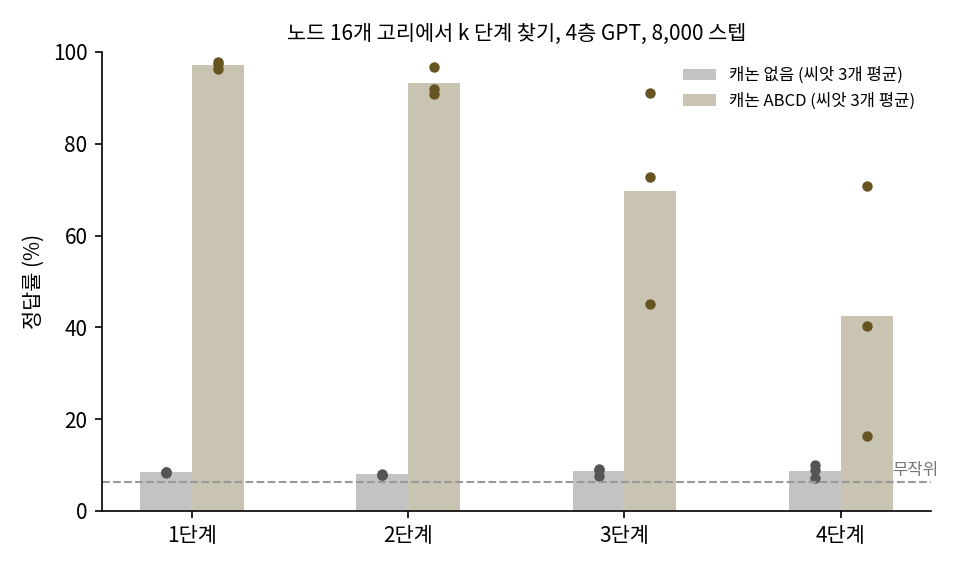
캐논 층이 없는 모델은 세 시드 모두 1 단계 물음부터 8% 언저리에 머물렀다. 캐논 층을 넣은 모델은 세 시드 모두 1 단계를 96% 넘게, 2 단계를 90% 넘게 맞혔고, 3 단계와 4 단계는 시드마다 갈렸다(45.2~91.0%, 16.4~70.7%).
이 표를 「캐논 층이 추론 깊이를 몇 배 늘렸다」로 읽을 수는 없다. 캐논 층이 없는 모델이 가장 쉬운 1 단계조차 배우지 못해 깊이를 측정하지 못했으니, 우리가 본 것은 「8,000 스텝 안에 이 시험을 배우기 시작하느냐」의 차이다. 논문의 모델은 RoPE(회전 위치 부호)를 쓴 8~12층 모델이라 1 단계는 캐논 층이 있든 없든 쉽게 풀었고, 차이는 더 깊은 단계에서 났다. 우리 GPT 는 GPT-2 처럼 위치마다 배우는 위치 임베딩을 쓰는데, 논문은 위치 부호가 없는 모델(NoPE)일수록 캐논 층 덕을 크게 본다고 보고했다.
쉬운 단계부터 차례로 배운다
정답률이 언제 오르는지를 단계마다 따로 보면 순서가 보인다.
2. k 마다 정답률이 처음 50% 를 넘은 스텝 (없으면 -)
  [캐논 ABCD] depo_N16_K4_L4_ABCD_s1: k=1:500 k=2:4000 k=3:- k=4:-
  [캐논 ABCD] depo_N16_K4_L4_ABCD_s2: k=1:500 k=2:4500 k=3:6000 k=4:-
  [캐논 ABCD] depo_N16_K4_L4_ABCD_s3: k=1:500 k=2:3500 k=3:5000 k=4:6500
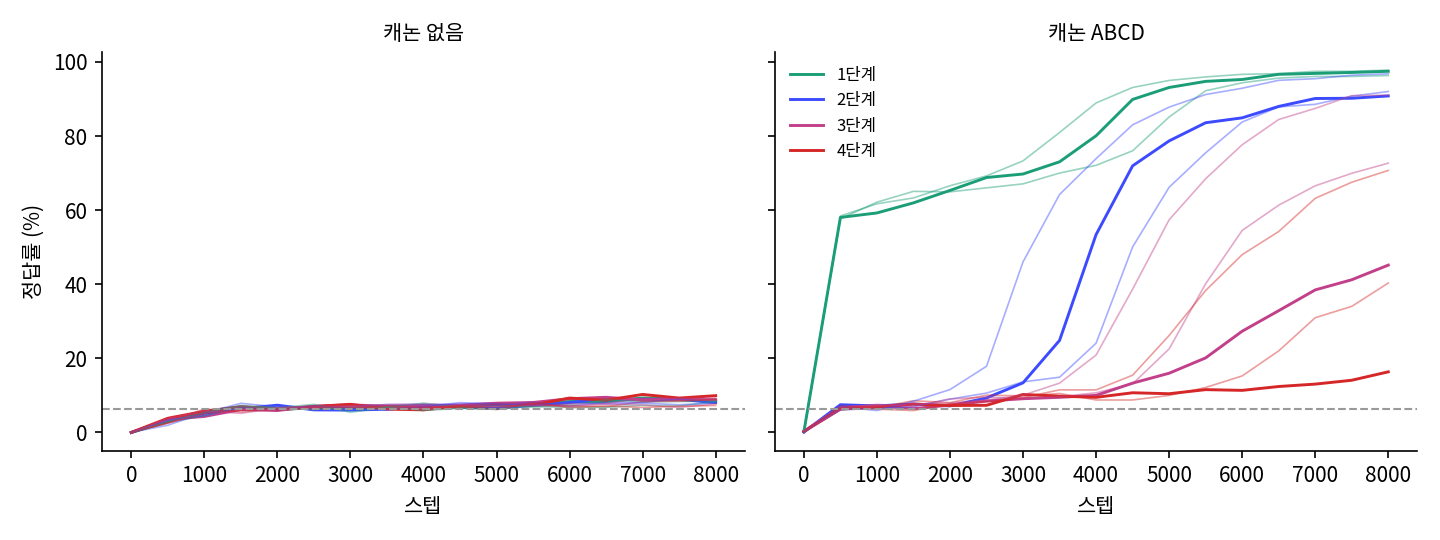
세 시드 모두 1 단계가 500 스텝 만에 먼저 올랐고, 2 단계는 3,500~4,500 스텝, 3 단계는 5,000~6,000 스텝(시드 둘)에 50% 를 넘었다. 4 단계가 50% 를 넘은 것은 시드 3 의 6,500 스텝 하나뿐이다. 모델은 네 단계를 한꺼번에 배우지 않고, 쉬운 단계를 먼저 익힌 다음 그 위에 한 단계씩 쌓았다.
논문은 캐논 층의 큰 효과를 이 순서로 설명한다. 논문의 실험 가운데에는 캐논 층이 1 단계 찾기의 학습 곡선을 거의 바꾸지 않고 2 단계 이상만 크게 올린 경우가 있었고(8층 모델), 첫 층에만 캐논 층을 넣은 모델은 효과의 작은 일부만 얻었다. 그래서 알렌주는 캐논 층이 표현할 수 있는 것을 늘린 것보다 깊은 단계를 배우는 속도를 높인 것이 크다고 보았다. 알렌주와 리의 이론(「역방향 특징 수정(Backward Feature Correction)」, COLT 2023)에 따르면 깊은 함수를 배우는 신경망은 위 층이 k 단계를 배우는 동안 아래 층도 k − 1 단계에는 쓸모없지만 k 단계에는 필요한 특징을 더 갖추도록 함께 고쳐진다. 언어 모델에서는 그 특징이 아래 층에만 아니라 앞 토큰 위치에도 있어야 하므로, 고치는 신호가 층을 따라 내려가면서 토큰 축을 따라 앞으로도 가야 한다. 층 사이에는 잔차 연결이 그 신호를 실어 나르지만, 토큰 사이에는 어디를 볼지 먼저 배워야 하는 어텐션밖에 없다. 캐논 층은 모든 층에 「토큰 축의 잔차 연결」을 깔아 준다는 것이 논문의 설명이다.
캐논 층이 없는 모델이 1 단계에서 이미 막혔으니 우리 결과로는 이 설명을 시험하지 못하고, 쉬운 단계부터 차례로 배웠다는 순서가 논문의 그림과 같다는 데까지만 말할 수 있다.
캐논 층이 없는 모델에 스텝을 더 주면
캐논 층이 없는 모델은 이 시험을 못 배우는 걸까, 늦게 배우는 걸까? 시드 1 로 스텝을 2.5 배인 20,000 스텝까지 늘린 기록이 있다.
[캐논 없음, 20,000 스텝] 파라미터 3,323,392 개 (캐논 층 0) | 마지막 k=1: 19.2% k=2: 10.8% k=3: 8.9% k=4: 10.9% | 8,000 스텝에서 k=1:8.9% k=2:8.6% k=3:9.4% k=4:8.9%
이 실행은 학습률 스케줄(워밍업 뒤 코사인으로 줄이기)을 20,000 스텝에 맞춰 짰으므로, 8,000 스텝 시점의 값(8.9%)이 8,000 스텝에서 끝나는 실행(시드가 같고 8.5%)과 조금 다르다. 16,000 스텝까지 10% 안팎이던 1 단계 정답률이 그 뒤로 오르기 시작해 20,000 스텝에서 19.2% 가 되었다. 시드 하나의 기록이지만, 못 배우는 쪽보다 아주 늦게 배우는 쪽에 가깝다.
늦게라도 배우기는 한다. 그래도 같은 8,000 스텝에 나란히 세우면, 파라미터 36,864 개(1.1%)를 더한 캐논 층이 낸 차이는 이만큼이다. 위 줄은 이 시험의 시드 평균이고, 아래 줄은 캐논 층을 처음 넣어 본 어텐션 전용 1층 모델의 무작위 반복 글 시험이다(sources/canon/analyze.out).
| 측정한 것(시드 평균) | 캐논 층 없음 | 캐논 층 넣음 |
|---|---|---|
| 4층 GPT 의 1 단계 / 2 단계 정답률(8,000 스텝) | 8.4% / 8.0% | 97.2% / 93.2% |
| 어텐션 전용 1층 모델의 무작위 반복 글 두 번째 절반 손실(10,000 스텝) | 12.517 | 5.299 |
앞 토큰 헤드가 하던 일을 캐논 층에 맡기자 1층 모델에도 유도 헤드가 생겼고, 같은 층을 넣은 4층 GPT 는 우연(6.25%) 언저리를 맴돌던 시험을 같은 스텝 안에 배우기 시작했다.
한 번 따라가는 것도 8% 였던 애가 두 번까지 93% 야. 무게는 1.1% 만 더 줬는데.

큰 모델 없이 구조의 차이를 갈라 낸 거예요. 시험지를 우리가 직접 만들었으니 할 수 있었던 일이고요. 다만 3·4 단계는 시드마다 16.4% 에서 91.0% 까지 갈렸어요. 큰 모델에서도 그런지, 깊이를 몇 배 늘렸는지는 아직 쓰지 않아요.
문제 5. 「캐논 층이 생각의 단계를 0 에서 4 로 늘렸다」
캐논 층이 없는 4층 GPT 는 8,000 스텝에서 1 단계 정답률 8.4%(시드 평균), 20,000 스텝에서 19.2%(시드 1)였고, 캐논-ABCD 모델은 8,000 스텝에서 4 단계 42.5%(시드 평균, 시드마다 16.4~70.7%)였다. (가) 「캐논 층을 넣으면 4층 GPT 가 생각할 수 있는 단계가 0 에서 4 로 늘어난다」는 문장에서 맞지 않는 곳은 어디인가? (나) 같은 시드 1 에서 캐논 없는 모델에 스텝을 2.5 배 준 결과(20,000 스텝)와 캐논 모델의 8,000 스텝 결과를 나란히 놓으면 무엇이 보이나? (다) 논문의 「추론 깊이 2~4 배」와 같은 종류의 비교를 하려면 실험을 어떻게 바꿔야 하나?
그 문장 맞는 것 같은데? 캐논이 없으면 1 단계도 못 하고, 있으면 4 단계까지 맞히잖아. 0 에서 4.

캐논 층이 없는 모델을 20,000 스텝까지 돌린 기록을 같이 볼까요?

8,000 스텝에서는 1 단계 8.9% 였는데 마지막엔 19.2%… 올라가고 있었네요. 못 하는 게 아니라 늦은 거면 「0」은 틀린 말이에요.

「4」도 이상해. 4 단계 정답률은 시드마다 16.4% 에서 70.7% 까지였잖아. 4 단계를 「할 수 있다」고 하려면 몇 % 를 넘어야 한다는 기준부터 있어야지.
그럼 (나)는요?

스텝을 2.5 배 줘도 캐논 없는 모델은 1 단계 19.2%, 캐논 모델은 같은 시드에서 1 단계 97.5% 예요. 차이가 줄긴 해도 여전히 커요.
(다)는 캐논 층이 없는 모델도 1 단계는 푸는 설정을 골라야 비교가 되겠다. 층을 늘리든 RoPE 로 바꾸든 해서 둘 다 출발선에 세운 다음, 몇 단계까지 같은 정답률을 넘는지를 보는 거야.
그래요. 우리 실험이 보여 준 건 「캐논 층이 있으면 이 시험을 훨씬 일찍 배우기 시작한다」예요. 논문의 숫자는 둘 다 배우기 시작한 뒤 몇 단계까지 가느냐를 측정한 것이라, 우리 결과를 그 숫자와 같은 줄에 놓으면 안 돼요.