캐논 층: 이웃 토큰을 옆으로 섞는 가벼운 층
웹 글을 읽힌 2층 모델에서 앞 토큰 헤드(층 1 헤드 1)는 바로 앞 위치에 가중치 0.961 을 주었다. 256 칸 어디든 볼 수 있는 헤드가 늘 한 칸 옆만 보았는데, 그 헤드를 지우면 무작위 반복 글의 손실이 7.15 나 올랐으니 빠질 수 없는 일을 하고 있었다. 알렌주는 같은 관찰을 「이웃한 토큰끼리 정보를 넘기는 데 전역 어텐션을 쓰는 것은 대포로 새를 잡는 일」이라고 적었다. 바로 앞 몇 토큰을 읽는 일만 따로 맡는 값싼 장치를 두면 어떨까?

256 칸을 다 볼 수 있는 헤드를 옆 한 칸 보는 데 다 쓰는 거잖아요. 아깝지 않아요?

같은 생각을 논문에 적은 사람이 있어요. 그 일을 더 값싼 층에 맡겨 보죠.
그림의 가로 칸을 글의 토큰 위치로 바꾸면 우리가 바라는 장치가 되는데, 언어 모델은 뒤 토큰을 보면 안 되니 커널은 지금 위치와 그 앞만 덮어야 한다.
지금 토큰에 바로 앞 세 토큰을 칸마다 더한다
4.1부가 정의한 캐논 층(Canon layer, 이웃 토큰을 옆으로 섞는 층)은 위치 t 의 벡터에 그 앞 세 위치의 벡터를 칸마다 다른 무게로 곱해 더한다. 논문은 이름을 파헬벨의 「캐논 D장조」에서 따왔다고 적었는데, 바이올린들이 같은 선율을 정해진 박자만큼 늦게 따라 연주해 겹치는 모습이 앞 토큰들을 조금씩 늦춰 겹쳐 더하는 계산과 닮았기 때문이다.
합성곱의 말로 하면 길이 4 의 인과 합성곱(뒤를 보지 않는 합성곱)을 채널마다 따로 건 것이다. 회상한 합성곱 층은 출력 채널마다 입력 채널을 모두 섞었지만, 캐논 층은 칸 하나가 같은 칸의 앞 토큰들만 읽으니 무게가 폭의 네 배밖에 되지 않는다. 논문은 이 층을 트랜스포머 층 하나 안의 네 자리에 넣을 수 있다고 했다. 어텐션 앞 층 정규화 다음(A), 어텐션 안에서 쿼리·키·값을 만든 다음(B), MLP 앞 층 정규화 다음(C), MLP 안에서 활성화 함수 앞(D)이다. 넷을 모두 넣은 것을 캐논-ABCD 라 부른다.
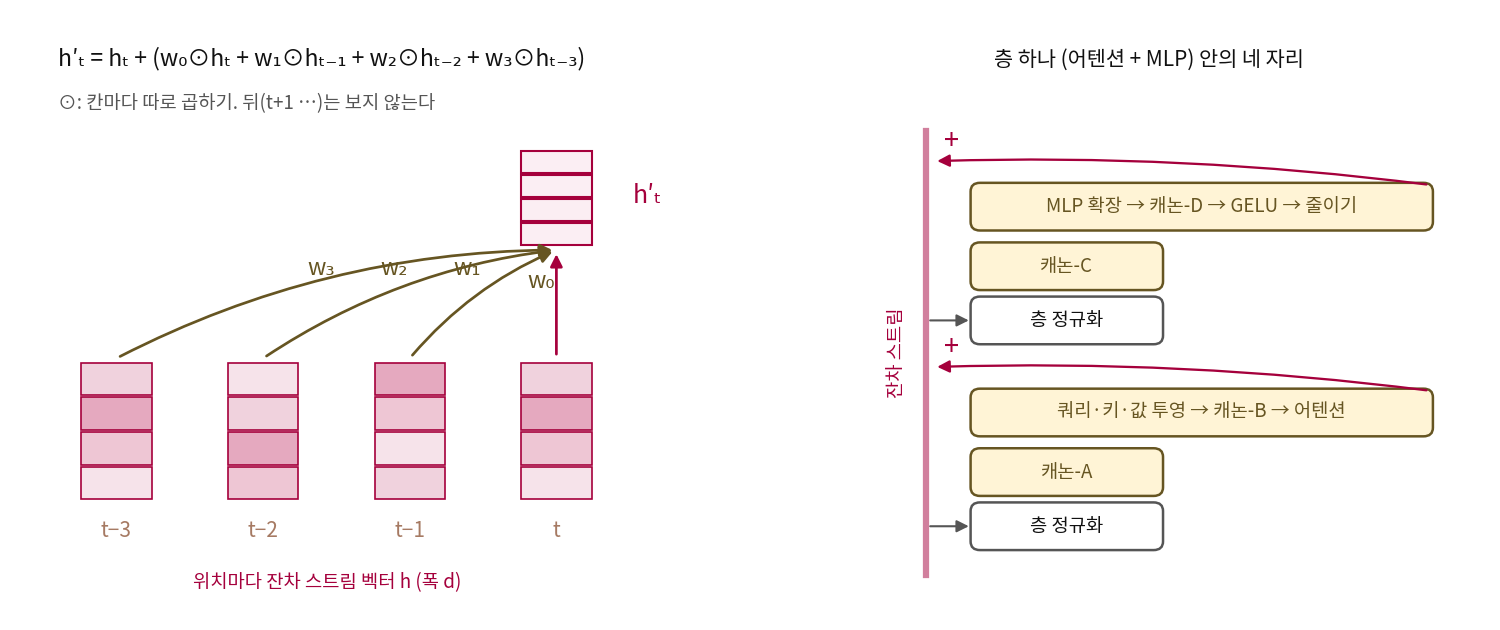
논문은 자리마다 효과가 쌓인다고 보고해서, 우리는 넷을 다 넣는다. 논문은 또 무게를 학습하지 않고 무작위로 정해 둔 캐논 층만으로도 성능이 눈에 띄게 오른다고 보고했고, 본 실험에서는 학습하는 길이 4 의 합성곱에 잔차 연결을 더한 것을 썼다. 공식 코드(facebookresearch/PhysicsLM4, Apache-2.0)도 같은 계산을 바이어스와 활성화 함수 없이 구현한다. 우리 구현은 공용 GPT 를 고치지 않고 이어받아 캐논 층만 끼웠다.
# sources/canon/canon_gpt.py 에서
class Canon(nn.Module):
    """h + (바로 앞 세 토큰과 지금 토큰의 칸별 가중합). 입력·출력 (B, T, C)."""
    def __init__(self, dim, kernel=4):
        super().__init__()
        self.kernel = kernel
        self.conv = nn.Conv1d(dim, dim, kernel, groups=dim, bias=False)  # groups=dim: 칸마다 따로

    def forward(self, x):
        y = F.pad(x.transpose(1, 2), (self.kernel - 1, 0))  # 앞쪽만 0 으로 채워 뒤를 보지 않게
        return x + self.conv(y).transpose(1, 2)

class CanonBlock(G.Block):
    def forward(self, h, cache=None):
        a = self.ln_1(h)
        if self.canonA is not None:
            a = self.canonA(a)          # A: 어텐션 앞
        h = h + self.attn(a, cache)     # B 는 어텐션 안, 쿼리·키·값 투영 다음
        if self.has_mlp:
            c = self.ln_2(h)
            if self.canonC is not None:
                c = self.canonC(c)      # C: MLP 앞
            h = h + self.mlp(c)         # D 는 MLP 안, GELU 앞
        return h
1층 모델에 캐논 층을 덧붙이면
캐논 층이 앞 토큰 헤드의 일을 대신할 수 있는지는 유도 헤드를 찾던 웹 글 실험으로 바로 시험할 수 있다. 데이터와 모델은 그때와 같다. ClimbMix 웹 글을 어휘 8,192 개의 BPE 로 자르고, 층마다 헤드 8 개, 폭 256, 문맥 256 토큰인 어텐션 전용 모델을 배치 32, 학습률 1e-3 으로 학습한다. 다만 이번에는 10,000 스텝(8,192만 토큰)까지만 학습하고 시드를 셋으로 늘렸다. 비교할 모델은 1층, 1층에 캐논 층을 넣은 것, 2층이다. MLP 가 없으니 캐논 층은 A 와 B 자리에만 넣었다(sources/canon/recall.py).
[1층] 파라미터 2,426,880 개 (캐논 층 0)
  recall_L1_base_s1: 검증 손실 4.5482 | 무작위 반복 글 처음 12.863 두 번째 12.814 | 최고 유도 점수 0.012 | 웹 글 반복 처음 4.610 두 번째 4.332
[1층 + 캐논 AB] 파라미터 2,430,976 개 (캐논 층 4,096)
  recall_L1_AB_s1: 검증 손실 4.2737 | 무작위 반복 글 처음 12.997 두 번째 4.753 | 최고 유도 점수 0.697 | 웹 글 반복 처음 4.376 두 번째 1.942
  recall_L1_AB_s2: 검증 손실 4.2851 | 무작위 반복 글 처음 13.000 두 번째 5.808 | 최고 유도 점수 0.713 | 웹 글 반복 처음 4.407 두 번째 2.208
  recall_L1_AB_s3: 검증 손실 4.2734 | 무작위 반복 글 처음 12.902 두 번째 5.335 | 최고 유도 점수 0.753 | 웹 글 반복 처음 4.372 두 번째 2.008
  시드 평균: 검증 손실 4.2774, 무작위 반복 글 두 번째 5.299
[2층] 파라미터 2,690,560 개 (캐논 층 0)
  recall_L2_base_s1: 검증 손실 4.3054 | 무작위 반복 글 처음 13.029 두 번째 8.833 | 최고 유도 점수 0.358 | 웹 글 반복 처음 4.407 두 번째 2.719
  …
  시드 평균: 검증 손실 4.2984, 무작위 반복 글 두 번째 8.652
  recall_L2_base_s1: 최고 유도 점수가 처음 0.3 을 넘은 토큰 수 53.2M
  recall_L2_base_s2: 최고 유도 점수가 처음 0.3 을 넘은 토큰 수 57.3M
  recall_L2_base_s3: 최고 유도 점수가 처음 0.3 을 넘은 토큰 수 41.0M
(1층 모델의 다른 두 시드도 최고 유도 점수가 0.012 였다. 전체 출력은 sources/canon/analyze.out 3절.) 층이 하나뿐인 모델은 세 시드 모두 유도 점수가 0.012 에 머물렀고, 무작위 반복 글의 두 번째 절반을 처음 절반만큼 못 맞혔다. 같은 모델에 무게 4,096 개를 더해 캐논 층을 넣자 유도 점수가 0.697~0.753 이 되었고, 두 번째 절반 손실이 12 언저리에서 4.753~5.808 로 떨어졌다. 층을 하나 더 쌓은 2층 모델은 파라미터가 263,680 개 더 많은데도 10,000 스텝에서 유도 점수 0.358~0.411, 두 번째 절반 손실 8.438~8.833 이었고, 웹 글 검증 손실도 1층 + 캐논(평균 4.2774)이 2층(평균 4.2984)보다 낮았다.
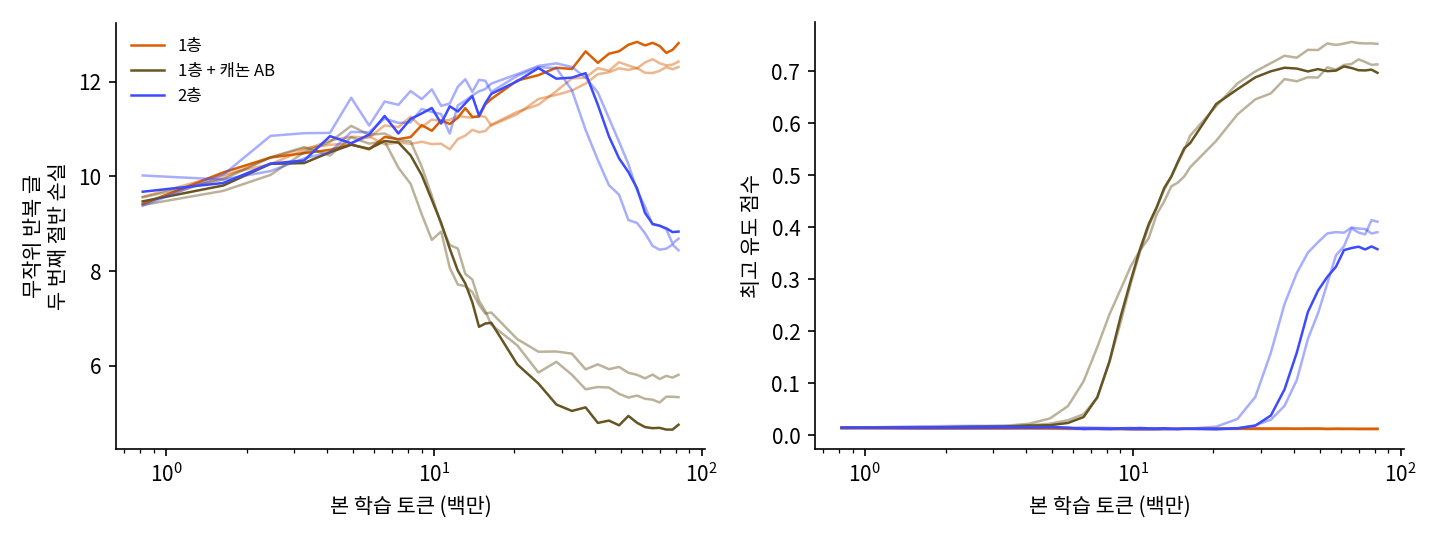
유도 점수가 처음 0.3 을 넘은 때도 1층 + 캐논은 980만~1,060만 토큰, 2층은 4,100만~5,730만 토큰이었다(같은 2층을 30,000 스텝 일정으로 학습한 유도 헤드 실험에서는 3,850만~3,930만 토큰이었는데, 일정과 시드가 함께 달라 왜 다른지는 여기서 가리지 않는다). 앞 토큰 헤드와 유도 헤드가 서로 다른 층에서 만나야 하는 2층 모델은 두 헤드가 함께 자리 잡을 때까지 기다려야 했는데, 캐논 층을 넣은 1층 모델은 그 기다림을 건너뛰었다. 1층 + 캐논 모델의 헤드 여덟 개 가운데 바로 앞 위치에 준 어텐션이 가장 큰 헤드도 0.139 였으니, 이 모델에는 앞 토큰 헤드가 아예 없다. 바로 앞 토큰을 읽어 오는 일은 캐논 층이 맡았고, 헤드 하나(유도 점수 0.697)는 캐논 층이 섞어 둔 벡터를 읽어 베끼는 일만 했다.
논문의 그림 5 도 같은 이야기를 한다. 500 토큰 길이의 글에서 앞에 나온 「A B」 쌍을 찾아 B 를 베끼는 시험에, 층 하나뿐인 RoPE 트랜스포머는 폭이 128 은 되어야 했지만, 층 둘이거나 층 하나에 캐논 층을 넣으면 폭 16 으로도 100% 를 맞혔다.
문제 3. 캐논 층 하나는 헤드 하나에 비해 얼마나 가벼운가
폭 d = 256, 헤드 8 개(헤드 폭 32)인 어텐션 층을 생각하자. 캐논 층은 들어오는 벡터의 칸마다 길이 4 의 무게를 둔다. (가) 캐논-A(폭 d)와 캐논-B(쿼리·키·값을 이어 붙인 폭 3d)의 무게는 각각 몇 개인가? 출력의 「캐논 층 4,096」과 맞는가? (나) 어텐션 헤드 하나의 쿼리·키·값·출력 행렬 무게(바이어스는 빼고)는 몇 개인가? (다) 캐논-ABCD 를 4층 GPT(MLP 폭 4d)에 모두 넣으면 무게가 몇 개 늘어나는가?

(가)부터 하면 캐논-A 는 256 × 4 = 1,024, 캐논-B 는 768 × 4 = 3,072. 더하면 4,096 이니까 출력이랑 같아.

(나)는 쿼리·키·값이 각각 256 × 32 이고 출력이 32 × 256 이니까 8,192 가 네 개, 32,768 개야. 헤드 하나가 캐논-A 의 32 배네.
그럼 2층 모델이 1층보다 더 가진 263,680 개와 비교하면요?

층 하나를 더 쌓는 데 26만 개를 썼는데, 4,096 개로 더 낮은 손실을 냈네요. 앞 토큰 헤드가 하던 일에 헤드 하나는 정말 비쌌던 거고요.
(다)는 층 하나에 A 256, B 768, C 256, D 1,024 칸이니까 2,304 칸에 무게 넷, 9,216 개. 네 층이면 36,864 개고, 모델 전체 3,360,256 개의 1.1% 야.
논문은 GPT-2 small 크기에서 0.45% 아래라고 적었어요. 다만 무게 수가 적다고 계산 시간까지 적은 건 아니에요. 논문은 13억 파라미터 모델에 캐논-ABCD 를 넣었을 때 전용 CUDA 커널(causal-conv1d)을 쓰고도 H100 에서 순전파 12.4%, 역전파 14.1% 가 더 걸렸다고 적었어요.
문제 4. 층이 하나뿐인데 어떻게 앞 토큰 헤드 없이 베끼나
1층 + 캐논 AB 모델은 앞 토큰 헤드 없이 유도 점수 0.697 을 냈다. 무작위 토큰 글 「… A B … A」에서 마지막 A 다음에 B 를 써야 한다고 하자. (가) 첫 번째 B 위치의 키가 「내 앞 토큰은 A」를 담으려면 캐논 층의 무게 가운데 무엇이 쓰여야 하나? (나) 1층 + 캐논 모델의 결과만으로 「큰 모델에서도 앞 토큰 헤드는 필요 없다」고 말할 수 있나?
(가)는 w₁ 이겠지. 캐논 층을 지난 B 위치의 벡터에는 w₁ ⊙ h(A) 가 더해지니까, 키를 만들 때 A 의 흔적이 같이 들어가.
그럼 마지막 A 위치의 쿼리가 「A」를 찾으면 첫 번째 B 위치의 키가 반응하고, 그 위치 값을 옮기면 B 가 오는 거네. 2층 모델에서는 앞 토큰 헤드가 첫째 층에서 하던 걸 캐논 층이 어텐션 앞에서 해 준 거고.
(나)는 어때요?
못 해요. 우리가 본 건 어텐션 전용 1층 모델이고, 큰 모델의 앞 토큰 헤드가 다른 일도 하는지는 안 봤으니까요. 「이 크기의 모델에서는 캐논 층이 앞 토큰 헤드의 일을 대신했다」까지만요.