토큰 표 다시 짜기: 낱말을 줄이고 프리트레인을 빽빽하게
이 장의 물음
언어 모델은 글을 토크나이저가 잘라 준 토큰으로 읽고, 토큰 표는 모델을 학습하기 전에 한 번 정해지면 그 뒤로는 손대지 않는 것이 보통이다. 그런데 표를 정한 뒤에 읽힐 글이 달라졌다면, 예전의 표는 지금의 글에도 맞을까? 읽힐 낱말과 글을 사람이 고를 수 있는 작은 모델이라면, 정해진 학습 시간 안에 무엇을 남기고 무엇을 넣어야 할까?
정체성 대화를 배운 루나는 「My Daddy is Minjun.」이라고 말하고, 두 사람이 말을 걸면 「Daddy!」 하고 부른다. 숫자를 자리마다 자르는 규칙 하나로 처음 보는 덧셈이 열린 것을 본 날 저녁, 라운지에서 서연은 루나가 두 사람의 이름은 어떻게 읽는지 궁금해져서 토큰 표를 열었다.

루나가 나를 다섯 조각으로 읽어. 「␣S, e, oy, e, on」.
나는 네 조각이야. 「␣M, in, j, un」. 근데 동화에 나오는 Bobo 는 한 칸이네.
엄마 이름이 동화 속 이름보다 길게 읽히는 거네요. 이 표는 누가 정했어요?
표를 정한 것은 타이니스토리즈였다. 동화만 읽던 때에 그 글에서 자주 붙어 나오는 조각을 합쳐 만든 표이고, 그 뒤에 만든 킨더테일즈 이야기와 대화에 「␣Seoyeon」이 9,513 번 나오는데도 표는 그대로였다(sources/tokens/balance_check.out). 세 사람은 이 표를 처음부터 끝까지 읽어 보기로 한다.
이 장이 끝나면 루나의 프리트레인이 바뀐다. 루나는 다섯 살에게 필요한 낱말만 남긴 동화와, 가족과 집과 동네를 말하는 지식 글을 처음부터 함께 읽는다. 모델의 크기(8층, 폭 512)와 학습 스텝은 그대로이고 바뀌는 것은 토큰 표와 읽히는 글이다.
이 장에 나오는 모델은 셋이다. 첫째는 어휘 4,096 의 토큰 표만 다시 짜서 동화를 처음부터 다시 읽힌 실험용 동화 GPT 로, 이름 토큰이 언제 자리를 잡는지 측정하는 데만 쓴다. 둘째는 지금까지처럼 타이니스토리즈 전체를 읽는 프리트레인이고 이 장에서는 「옛 판」이라고 부른다. 셋째는 낱말 목록으로 거른 동화와 지식 글을 읽는 「빽빽한 판」이며, 마지막 절에서 이 판이 프리트레인 단계의 루나가 된다.
- 어휘 4,096 칸 가운데 루나가 실제로 쓰는 칸은 몇 개일까?
- 이름을 토큰 하나로 만들면 루나는 그 이름을 더 잘 쓸까?
- 새 토큰이 쓰인 글은 프리트레인 때 읽혀야 할까, 나중에 읽혀도 될까?
- 낱말을 줄이고 지식 글을 섞으면 무엇을 얻고 무엇을 잃을까?
- 같은 글을 여러 바퀴 되읽으면 모델은 어떻게 달라질까?
- 토큰은 뜻의 단위일까, 다른 무엇의 단위일까?
토큰 표를 함께 읽다: 한 번도 쓰이지 않은 칸
어휘 4,096 칸은 바이트 256 개, 바이트를 합쳐 만든 토큰 3,839 개, 이야기 사이를 가르는 특수 토큰 하나로 되어 있다. 서연은 타이니스토리즈 학습 글 전체를 이 표로 자른 5억 5,265만 토큰에서 칸마다 몇 번 쓰였는지를 세었다(sources/tokens/balance_check.py). 출력의 「병합 토큰」은 합쳐 만든 토큰이고, 「잎」은 다른 토큰의 재료로 쓰이지 않은 토큰이다.
1. 타이니스토리즈 학습 토큰 552,651,810 개
  병합 토큰 가운데     0 번 이하로 쓰임:    9 개 (그 가운데 잎 0 개)
  병합 토큰 가운데    10 번 이하로 쓰임:   29 개 (그 가운데 잎 0 개)
  병합 토큰 가운데   100 번 이하로 쓰임:   88 개 (그 가운데 잎 0 개)
  병합 토큰 가운데 1,000 번 이하로 쓰임:  338 개 (그 가운데 잎 0 개)
  …
  100 번 이하 병합 토큰(적은 순 40 개, 「잎」이면 *): ' kitc':0, ' underst':0, ' caterp':0, ' noteb':0, 'erop':0, ' dishw':0, ' ambul':0, ' sungl':0, ' ornam':0, ' anym':1, ' oce':1, ' helic':1, ' umb':1, 'aghet':1, 'uddenly':2, …

3. 새 말뭉치에서 세 조각 이상으로 잘리는 낱말(나온 횟수 × 아낄 토큰 순 25 개)
        ' Seoyeon'   9,513 번, 5 조각:  S | e | oy | e | on
         ' Minjun'   9,366 번, 4 조각:  M | in | j | un
            ' Ana'   6,177 번, 3 조각:  A | n | a
        ' college'   3,844 번, 3 조각:  coll | e | ge
  …
   ' kindergarten'   1,153 번, 5 조각:  kind | er | g | art | en

「␣kitc」가 0 번이야. 5억 5천만 토큰을 읽는 동안 한 번도 안 쓰였는데 한 칸을 차지하고 있어.

kitchen 을 만들다 만 거네. 바이트 쌍 합치기는 한 번에 두 조각만 붙이니까, 「␣kitchen」이 되려면 「␣kitc」를 거쳐야 했던 거야. 다 만든 뒤에는 「␣kitc」가 혼자 나올 일이 없고.
계단은 다 올라가면 치워도 되잖아요. 「␣underst」도 「␣caterp」도 전부 그런 계단이네요.
1,000 번 이하로 쓰인 338 개 가운데 잎은 하나도 없었다. 338 개 모두가 더 긴 토큰을 만드는 데 재료로 쓰이고 남은 중간 토큰이라는 뜻이고, 합친 토큰 3,839 개의 9% 가까이가 이런 칸이다. 반대로 루나가 날마다 읽는 낱말은 칸을 얻지 못했다. 표를 만들 때의 글에 「Seoyeon」과 「kindergarten」이 없었기 때문이며, 타이니스토리즈에 자주 나오는 「Bobo」와 「Whiskers」 같은 이름 토큰은 114 개나 들어 있다(sources/tokens/audit_merge.out).

고칠 것이 둘이에요. 지금 루나가 읽는 글로 표를 다시 배우면 이름은 저절로 한 칸이 돼요. 중간 토큰은 합치는 방법을 조금 바꿔야 없어지는데, 치조프 연구진이 2024년에 낸 방법이 있어요. 두 조각을 합칠 때마다 방금 쓴 재료를 다시 따져 보고, 혼자서는 쓸모가 없어진 재료를 어휘에서 빼는 거예요.
따지는 기준은 비율 하나다. 조각 a 와 b 를 합쳐 c 를 만든 직후에, a 가 글에 나온 횟수 가운데 b 와 붙어서 나온 횟수의 비율을 구한다. 비율이 문턱(우리는 0.8) 이상이면 a 는 거의 언제나 c 의 안에서만 나오는 조각이므로 어휘에서 빼고, b 도 같은 방법으로 따진다. 「ing」처럼 여러 낱말의 끝에 붙는 조각은 어느 한 낱말과 합쳐져도 다른 낱말에서 계속 쓰이므로 비율이 낮아서 남는다. 뺀 조각이 나중에 다시 자주 나오면 되살린다. 이 책에서는 재료를 따져서 골라 남기는 이 방법을 고른 BPE(Picky BPE)라고 부른다(sources/common/picky_bpe.py).
표를 다시 배울 글은 옛 표를 만들 때 쓴 타이니스토리즈 앞 50MB 에 킨더테일즈 이야기와 루나 대화를 더한 것이고, 더한 글은 조각 수로 전체의 19.7% 다. 어휘는 4,096 칸 그대로 두었다. 합치기를 4,827 번 하는 동안 조각을 986 번 뺐고 113 번 되살렸으며, CPU 만으로 3 초가 걸렸다(sources/retokenize/train_d_w1_T0.8.out).
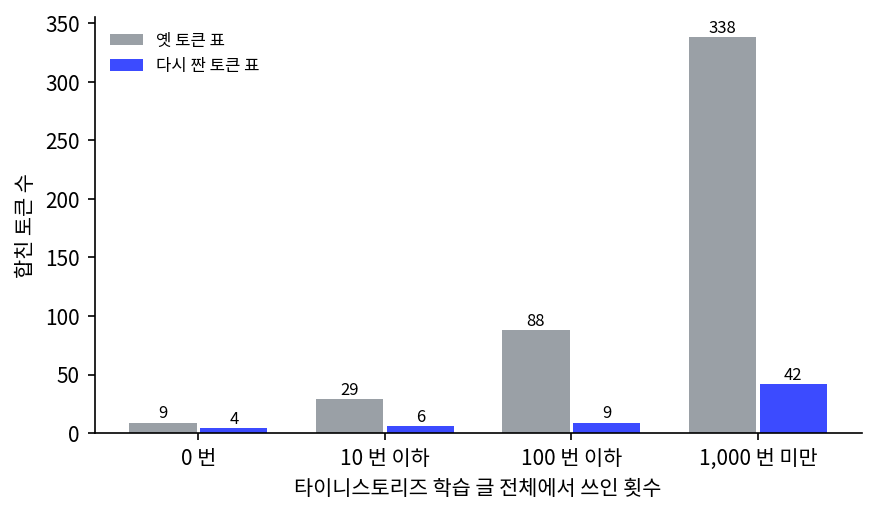
| 옛 토큰 표 | 다시 짠 토큰 표 | |
|---|---|---|
| 1,000 번 미만 쓰인 합친 토큰 | 338 개 | 42 개 |
| 한 번도 안 쓰인 합친 토큰 | 9 개 | 4 개 |
| 「␣Seoyeon」 | 5 조각 | 1 조각 |
| 「␣Minjun」 | 4 조각 | 1 조각 |
| 「␣kindergarten」 | 5 조각 | 1 조각 |
| 「␣college」 | 3 조각 | 1 조각 |
| 바이트당 토큰, 타이니스토리즈 검증 글 | 0.2515 | 0.2489 |
| 바이트당 토큰, 킨더테일즈 이야기 | 0.3056 | 0.2442 |
표의 값은 sources/retokenize/encode_v2.out 과 metrics.out 에서 옮겼다. 드물게 쓰이는 합친 토큰은 338 개에서 42 개로 줄었고, 손으로 넣은 낱말이 하나도 없는데 두 사람의 이름과 유치원과 대학이 한 칸씩을 얻었다. 킨더테일즈 이야기는 같은 글이 20% 적은 토큰으로 잘리므로, 루나는 512 토큰짜리 문맥 한 줄에 가족 이야기를 그만큼 더 담아 읽는다. 타이니스토리즈 글도 1% 덜 쪼개져서, 동화를 읽는 데는 잃은 것이 없다.
한 번도 안 쓰인 칸이 아직 넷 남았네. 뭐야?
「␣Minjun」, 「Minjun」, 「␣Seoyeon」, 「Seoyeon」. 타이니스토리즈에는 우리 이름이 없으니까 0 번이 맞아.
서연의 말은 맞았지만, 루나에게 이름을 쓰게 하려고 하자 그 0 번이 문제가 되었다.
문제 1. 치워도 되는 계단
어떤 글에서 토큰 「␣kitc」가 5,000 번, 「hen」이 8,000 번 나온다고 하자. 「␣kitc」 바로 뒤에 「hen」이 오는 자리는 5,000 번이고, 이 쌍을 합쳐 「␣kitchen」을 만들었다. 문턱은 0.8 이다. (가) 「␣kitc」와 (나) 「hen」은 각각 어휘에 남는가? (다) 조각 하나를 빼면 어휘 4,096 칸에는 무슨 일이 생기는가?

(가)는 5,000 번 가운데 5,000 번이 쌍 안이니까 비율이 1 이야. 0.8 을 넘으니 빠져.
(나)는 8,000 번 가운데 5,000 번이라 0.625. 문턱 아래라서 남아. 「hen」은 암탉으로도 나오고 「then」이나 「when」의 끝으로도 쓰일 테니까.
(다)는 칸이 하나 비는 거죠? 비워 두나요?

비워 두지 않아요. 어휘가 4,096 칸이 될 때까지 합치기를 계속하니까, 빈 칸은 다음으로 자주 붙어 나오는 쌍이 채워요. 우리 표에서는 같은 글을 보통의 BPE 로 배우면 세 조각이던 「␣wardrobe」가 그렇게 한 칸을 얻었어요.