토큰 표 다시 짜기: 낱말을 줄이고 프리트레인을 빽빽하게
쓰인 적 없는 이름: 쓰임 글을 이르게 넣을까 늦게 넣을까
깔끔해진 표로 동화 GPT 를 처음부터 다시 학습하면 무엇이 달라질까? 세 사람은 8층, 폭 512 의 동화 GPT 를 다시 짠 표로 14,000 스텝 학습하고, 킨더테일즈 이야기까지 같은 방법으로 읽혀 보았다. 통하지 않은 길이었다. 같은 바이트를 읽혔을 때 바이트당 비트는 두 표 모두 0.4253 이었고(시드 하나), 가족 사실을 묻는 시험의 정답률도 프리트레인 시드 셋의 범위가 서로 겹쳤다(sources/retokenize/summary.out). 표가 깔끔해진 것만으로는 사실을 더 잘 배우지 않았다.
달라진 것은 엉뚱한 곳에서 나왔다. 민준이 두 이름이 든 시작 문장을 넣고 그리디로 이어 쓰게 하자, 두 모델은 다음과 같이 썼다(sources/retokenize/eval_models.out).
[옛 토큰 표, 그리디] 'Minjun and Seoyeon went to the kindergarten. Serey was a very kind lady who always helped Minjo.\nOne day, Serey was feeling very sad. She had lost her favourite toy and she was very upset. …'
[다시 짠 토큰 표, 그리디] 'Minjun and Seoyeon went to the kindergarten.\nThe next day, the little girl was so excited to seeing a big, beautiful rainbow in the sky. She ran to the rainbow and shouted, "Look! It\'s so pretty!" …'

옛 표는 Serey, Minjo 라고 틀리게라도 썼는데, 새 표는 이름을 아예 안 써.
나는 「the little girl」이 됐네.
한 칸을 줬는데 왜 못 써요? 조각을 이어 붙일 필요도 없잖아요.
원인은 토큰 표에 남아 있던 0 번짜리 칸 넷에 있었다. 「␣Seoyeon」 토큰은 타이니스토리즈 학습 글 5억 4,694만 토큰에 0 번 나온다(sources/retokenize/encode_v2.out). 프리트레인 내내 이 토큰이 정답인 자리가 한 번도 없었으니, 모델은 이 토큰에 확률을 줄 일도 없었다. 반면에 옛 표의 「in」이나 「un」은 다른 낱말의 조각으로 수없이 정답 자리에 왔으므로, 모델은 그 조각들을 이어 「Minjo」라도 만들 수 있었다.
숫자로도 확인된다. 「… named Seoyeon. One day,」까지 주고 다음 토큰이 「␣Seoyeon」일 확률을 측정하면 다시 짠 표의 동화 GPT 는 시드 셋이 0.0000, 0.0001, 0.0000 이었고, 같은 자리에 Lily 를 넣으면 0.62~0.69 였다(sources/retokenize/timing_probe.out). 이름 토큰의 임베딩 벡터는 글에 한 번도 나오지 않는 바이트 토큰들의 벡터와 코사인 유사도가 0.996~0.997 이었다. 코사인 유사도는 두 벡터가 같은 방향이면 1, 상관없는 방향이면 0 근처가 되는 값이므로, 모델 안에서 두 사람의 이름은 한 번도 학습되지 않은 바이트 토큰들과 구별되지 않았다는 뜻이다.
두 사람의 사실 열 가지를 가르치던 때에 이름 토큰 넷을 어휘에 직접 넣어 본 적이 있다. 그때도 글 없이 토큰만 넣은 모델은 이름을 쓰지 않았고, 선생님은 「어디에 쓰는지는 글을 읽어야 배워요」라고 추정으로만 말했다. 이번에는 그 추정을 확인해 볼 수 있다.
낱말의 뜻은 쓰임이라고 했잖아요. 그러면 쓰임을 언제 만나는지도 상관이 있을까요? 아기 때 날마다 들은 이름이랑 다 커서 처음 들은 이름은 다르게 남을 것 같아요.

좋은 대조예요. 이름이 쓰인 글을 같은 양만큼, 한 판은 프리트레인 때 읽히고 다른 판은 나중에 읽혀요. 그 글에 가족의 사실이 섞이면 무엇 때문에 달라졌는지 알 수 없으니, 이름만 나오고 사실은 없는 글이어야 해요.
그런 글은 이름 쏠림을 풀 때 쓴 방법으로 만들 수 있다. 타이니스토리즈 이야기에서 이야기를 이끄는 아이의 이름만 바꿔 쓰는 것이다(sources/retokenize/make_usage.py). 그 아이가 남자아이면 Minjun, 여자아이면 Seoyeon 으로 바꾸었고, 가족을 가리키는 낱말이나 킨더테일즈 사실의 값(turtle, noodles 등)이 한 번이라도 나오는 이야기는 미리 뺐다. 이렇게 만든 12,000 편을 쓰임 글이라고 부르자. 쓰임 글에서 두 사람은 공을 차고 공원에 가는 아이일 뿐이다.
One day, a boy named Minjun went to the pitch to play. He was very fit and loved to run. Minjun saw his friends and they started to play a game. They kicked a ball and ran very fast. Minjun was happy to play with his friends. While they were playing, they saw a big dog. The dog was running fast too.
다시 짠 표의 동화 GPT 로 세 판을 만들었는데, 「없음」은 쓰임 글을 읽히지 않은 판이다. 「이르게」는 프리트레인이 읽는 토큰의 0.5% 를 쓰임 글로 바꿔 끼워 처음부터 다시 학습한 판이고, 바꾼 줄은 14,000 스텝에 고르게 흩어져 있다. 「늦게」는 프리트레인은 그대로 두고, 킨더테일즈 이야기를 읽히는 1,000 스텝에 같은 양의 쓰임 글을 끼운 판이다. 세 판 모두 그 뒤에 킨더테일즈 이야기를 같은 방법으로 읽혔고, 프리트레인 시드를 셋으로 바꿔 가며 측정했다.
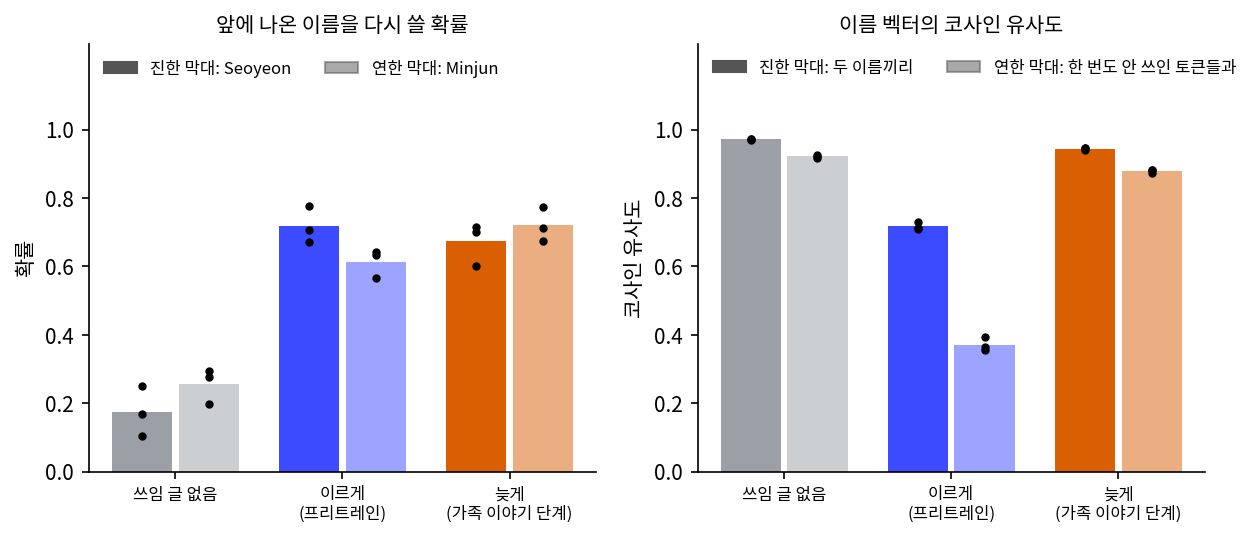
| 쓰임 글 | 「␣Seoyeon」을 다시 쓸 확률 | 「␣Minjun」을 다시 쓸 확률 | 두 이름 벡터의 코사인 | 한 번도 안 쓰인 토큰들과의 코사인 |
|---|---|---|---|---|
| 없음 | 0.10~0.25 | 0.20~0.30 | 0.97 | 0.92~0.93 |
| 이르게(프리트레인) | 0.67~0.78 | 0.57~0.64 | 0.71~0.73 | 0.35~0.39 |
| 늦게(가족 이야기 단계) | 0.60~0.72 | 0.68~0.77 | 0.94~0.95 | 0.87~0.88 |
값은 시드 셋의 범위다(sources/retokenize/timing_probe.out). 쓰임 글을 읽힌 두 판은 모두 이름을 쓰게 되었다. 다시 쓸 확률이 0.10~0.30 에서 0.57~0.78 로 올라서, 대조로 넣은 Lily 의 0.61~0.76 과 같은 수준이 되었다. 이름을 쓰는 법은 쓰임 글을 언제 읽혀도 생긴 것이다.
오른쪽 두 열은 다르다. 이르게 읽힌 판만 이름 벡터가 한 번도 안 쓰인 토큰들에서 떨어져 나왔고(0.92~0.93 에서 0.35~0.39), 두 이름도 서로 다른 방향을 얻었다(0.97 에서 0.71~0.73). 늦게 읽힌 판은 같은 양의 글을 읽고 이름도 잘 쓰는데, 벡터는 0.87~0.88 로 거의 제자리였다. 세 판의 범위는 서로 겹치지 않는다.
같은 글을 같은 만큼 읽었는데, 언제 읽었느냐로 갈리네.
늦게 배운 판은 이름을 부를 줄은 아는데, 속으로는 아직 모르는 글자 옆에 두고 있는 거네요.
측정한 대로만 말하면 그래요. 쓰는 법은 언제든 배우고, 다른 토큰과 구별되는 자리는 프리트레인에서 만난 이름만 얻었어요. 프리트레인은 14,000 스텝 동안 그 이름을 온갖 문맥에서 조금씩 만나게 하고, 나중 단계는 1,000 스텝 안에 몰아서 만나게 해요. 왜 자리가 덜 옮겨지는지까지는 측정하지 않았어요.
동화 실력은 다치지 않아서, 0.5% 를 바꿔 끼운 판의 바이트당 비트는 0.4234~0.4245 로 바꾸지 않은 판의 0.4239~0.4249 와 범위가 겹쳤다(summary.out). 다만 이름이 자리를 잡았다고 사실 정답률이 오르지는 않아서, 가족 사실을 묻는 시험에서 쓰임 글을 넣지 않은 판보다 나아진 판은 없었다. 사실을 얼마나 잘 배우는지는 킨더테일즈를 만들 때 본 대로 사실을 담은 이야기의 가짓수가 정했고, 토큰 표는 그 일을 대신해 주지 못했다.
이 절에서 얻은 규칙은 「새 토큰은 모두 프리트레인 글에 나오게 한다」 하나이고, 다음 절의 토큰 표는 이 규칙에서 출발한다.
문제 2. 0.5% 는 몇 번인가
프리트레인은 14,000 스텝 동안 스텝마다 512 토큰짜리 줄 64 개를 읽는다. (가) 프리트레인이 읽는 토큰은 모두 몇 개인가? (나) 그 가운데 0.5% 를 쓰임 글로 바꾸려면 512 토큰짜리 줄이 몇 개 필요한가? (다) 쓰임 글 12,000 편은 다시 짠 표로 2,235,183 토큰이고, 「Minjun」이 55,599 번, 「Seoyeon」이 25,168 번 나온다. 이르게 읽힌 판은 프리트레인 동안 두 이름을 대략 몇 번씩 만나는가?

(가)는 14,000 × 64 × 512 = 458,752,000 토큰.

(나)는 0.5% 가 2,293,760 토큰이고 512 로 나누면 4,480 줄이야. 스텝이 14,000 개니까 세 스텝에 한 줄쯤 끼는 거네.

(다)는 2,293,760 을 2,235,183 으로 나누면 1.03 바퀴니까, Minjun 을 5만 7천 번, Seoyeon 을 2만 6천 번쯤. 근데 0.5% 는 너무 적은 거 아니야? 이백 줄에 한 줄이잖아.
비율로는 적지만 0 번이 수만 번이 됐어요. 토큰 하나가 자리를 잡는 데는 그 정도면 충분했고, 나머지 99.5% 가 동화여서 동화 실력도 그대로였어요. 「␣kindergarten」이 쓰임 글에 310 번밖에 안 나온 것도 함께 기억해 두세요. 이름 말고 다른 낱말까지 자리를 잡게 하려면 글이 더 필요해요.