토큰 표 다시 짜기: 낱말을 줄이고 프리트레인을 빽빽하게
되읽기: 같은 동화를 다섯 바퀴 넘게
낱말을 줄인 빽빽한 판이 거른 동화를 옛 판보다 못 읽은 이유를 찾으려고, 서연은 두 판의 학습 파일 크기부터 적었다. 옛 판의 학습 파일은 5억 5천만 토큰이어서 14,000 스텝으로는 한 바퀴도 다 읽지 못한다. 빽빽한 판의 학습 파일은 80,260,591 토큰이어서 같은 스텝에 5.72 바퀴를 읽는다. 같은 이야기를 다섯 번 넘게 되읽은 것이 원인일까?
확인하는 방법은 학습 도중을 들여다보는 것이다. 두 판을 같은 명령으로 다시 학습하면서 700 스텝마다 모델을 저장하고, 저장한 모델마다 처음 보는 거른 동화와 학습에서 이미 읽은 거른 동화의 바이트당 비트를 측정했다(sources/dense/repeat_check.py).
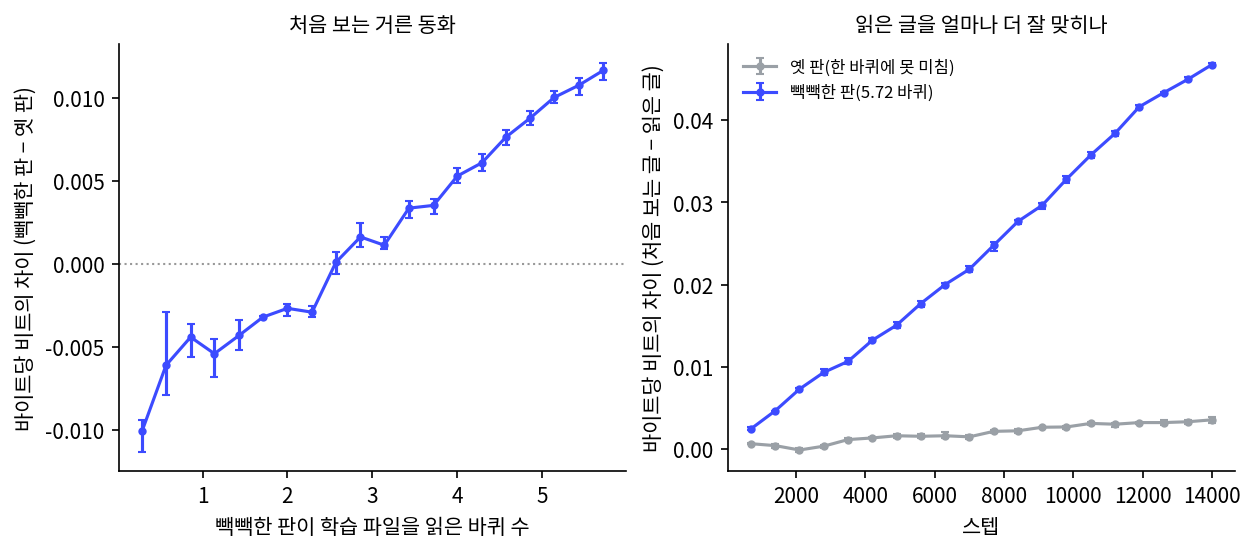
| 스텝 | 빽빽한 판이 읽은 바퀴 | 거른 동화의 차이(빽빽한 판 − 옛 판) | 빽빽한 판의 처음 보는 글 − 읽은 글 | 빽빽한 판의 처음 보는 지식 글 |
|---|---|---|---|---|
| 700 | 0.29 | −0.0113~−0.0094 | 0.0023~0.0027 | 0.6142~0.6238 |
| 2,800 | 1.14 | −0.0068~−0.0045 | 0.0090~0.0098 | 0.4645~0.4682 |
| 7,000 | 2.86 | 0.0010~0.0025 | 0.0215~0.0222 | 0.4338~0.4401 |
| 14,000 | 5.72 | 0.0111~0.0121 | 0.0464~0.0469 | 0.4949~0.5018 |
값은 시드 셋의 범위다(sources/dense/repeat_check.out). 첫 바퀴에서는 민준의 예측대로 빽빽한 판이 거른 동화를 더 잘 읽었고, 두 바퀴 반을 넘는 6,300 스텝 무렵에 두 판이 같아진 뒤로는 바퀴를 돌 때마다 빽빽한 판이 뒤처졌다. 같은 동안 빽빽한 판은 읽은 글을 처음 보는 글보다 점점 더 잘 맞히게 되어서 두 글의 바이트당 비트 차이가 0.002 에서 0.047 로 벌어졌는데, 한 바퀴를 다 못 읽은 옛 판은 끝까지 0.003~0.004 였다. 처음 보는 지식 글도 7,000 스텝 무렵에 0.43~0.44 로 가장 좋았다가 끝에서는 0.49~0.50 으로 나빠졌다. 모델이 글을 읽는 법을 더 배우는 대신 읽은 글을 외우기 시작한 것이다.

낱말을 줄인 게 잘못이 아니라, 줄이고 나니 읽을 글이 모자랐던 거네.

이야기를 더 살려야 해. 낱말 하나 때문에 빠진 이야기가 뭔지 보자.
목록을 다시 들여다보니 「jump」와 「jumping」은 있는데 「jumps」는 2,000 등 밖이라 없었다. 「He jumps.」 한 문장 때문에 이야기 한 편이 빠진 것이다. 목록 안 낱말에 -s, -ing, -er, -est 가 붙은 굴절형은 루나에게 새 낱말이 아니므로, 타이니스토리즈에 200 번 넘게 나온 굴절형 956 개와 빠져 있던 루나 세계 낱말을 더해 낱말 목록을 3,050 개로 늘렸다(sources/dense/lexicon2.out). 남는 이야기는 423,430 편에서 603,839 편으로 늘었다. 지식 글도 70,099 편으로 늘려 두 번만 되풀이했고, 학습 파일은 121,231,659 토큰이 되어 14,000 스텝이 3.78 바퀴를 읽는다(sources/dense/pretrain_mix2s2.out).
토큰 표도 늘어난 낱말에 맞춰 다시 배웠다. 낱말의 바탕과 꼬리가 따로 잘리도록 해서, 굴절형 988 개 가운데 947 개가 「jump|ed」, 「tall|er」처럼 바탕 토큰과 꼬리 토큰으로 읽힌다(sources/dense/tokcheck.out). 「jumped」를 처음 보는 낱말로 따로 외우지 않고 「jump」와 「ed」의 쓰임을 그대로 가져다 쓰게 하려는 것이다.
이 둘째 판이 지금부터의 루나다. 8층, 폭 512 의 몸은 그대로이고, RTX 4090 한 장에서 18.3 분 학습했으며, 둘째 판의 처음 보는 거른 동화에서 바이트당 비트는 시드 셋이 0.3349, 0.3353, 0.3354 였다(sources/dense/runs/dense2s2/train_R_s1.log, sources/dense/run_steps2.out). 검증 글이 첫 판과 다르므로 둘째 판의 0.3349~0.3354 를 첫 판의 0.3361~0.3376 과 나란히 놓지는 않는다. 프리트레인을 바꾸었으니 그 위에 쌓았던 묻고 답하기와 대화는 다시 가르쳐야 하고, 그때까지의 실습은 대화를 아직 배우지 않은 프리트레인 단계의 루나로 한다.
그날 저녁 민준이 자리를 비운 사이에 서연은 시작 문장 칸에 예전의 그 한 줄을 다시 넣었다. 동화만 읽던 루나가 Simon 과 Danbler 를 데려왔던 문장이고, 이번에도 온도 0.8 로 세 번 이어 쓰게 했다(sources/dense/runs/dense2s2/train_R_s1.log).
### 시작 문장: Minjun liked Seoyeon.
[1] Minjun liked Seoyeon. He ate noodles. Luna thought, if my Mommy likes to eat noodles, so she will smile when she eats them.
[2] Minjun liked Seoyeon. On a walk in the snow, he said to a new friend, "Hello." Luna smiled. "He likes gray best," she said.
[3] Minjun liked Seoyeon. She came to Luna and Daddy. She said, "Good night, my Daddy."
이번에는 Simon 이 안 나오네요. 국수를 먹고, 회색을 좋아하고. 다 민준 선배 얘기예요.
…시작 문장 시험이야. 이름을 끝까지 쓰는지 본 거야.
문제 4. 몇 바퀴를 읽는가
프리트레인은 458,752,000 토큰을 읽는다. 옛 판의 학습 파일은 552,675,767 토큰이고, 빽빽한 첫 판은 80,260,591 토큰의 학습 파일을 5.72 바퀴 읽었다. (가) 옛 판은 학습 파일을 몇 바퀴 읽는가? (나) 첫 판의 지식 글은 한 벌을 다섯 번 되풀이해 넣었다. 지식 글 한 편은 프리트레인 동안 몇 번 읽히는가? (다) 처음 보는 지식 글의 바이트당 비트가 7,000 스텝 무렵에 가장 좋았다는 것과 (나)는 어떻게 이어지는가?
(가)는 0.83 바퀴. 첫 판이 일곱 배 가까이 되읽은 거야.
(나)는 5.72 바퀴에 다섯 번씩이니까 28.6 번. 같은 글을 스물아홉 번이나 읽었어?

그래서 (다)가 나오는 거네. 7,000 스텝이면 절반이니까 지식 글은 이미 열네 번쯤 읽었어. 그다음부터는 더 읽어도 처음 보는 글에는 도움이 안 되고 읽은 글만 외워.

둘째 판은 지식 글을 두 번만 되풀이해서 한 편이 7.6 번 읽혀요. 되풀이로 채운 10% 와 서로 다른 글로 채운 10% 는 같은 10% 가 아니에요. 같은 사실을 여러 문장으로 바꿔 써야 꺼내 쓴다는 것을 킨더테일즈에서 봤는데, 프리트레인의 지식 글에서도 되풀이는 외우게만 했어요.