토큰 표 다시 짜기: 낱말을 줄이고 프리트레인을 빽빽하게
빽빽한 프리트레인: 낱말 목록과 지식 글
이름 넷은 프리트레인의 0.5% 로 자리를 잡았지만, 루나가 알아야 하는 것은 이름만이 아니다. 가족의 사실은 프리트레인 뒤의 단계에서 따로 가르쳤고, 앞으로 가르칠 집과 동네의 장소와 수를 세는 낱말도 그렇게 나중에 들어올 참이었다. 프리트레인부터 함께 읽히면 그 낱말들도 이름처럼 자리를 잡지 않을까?

그럼 프리트레인에 다 넣자. 근데 14,000 스텝이 읽는 토큰은 4억 5,875만 개로 정해져 있잖아. 넣는 만큼 동화가 빠져.

동화에서 뺄 걸 고르면 되지 않을까? 루나가 평생 쓸 일 없는 낱말이 든 이야기도 많을 텐데.

타이니스토리즈가 했던 일을 한 번 더 하는 거예요. 엘단과 리는 웹 글 대신 서너 살이 알아듣는 낱말의 동화로 글을 좁혀서 작은 모델이 말을 하게 했어요. 우리는 그 동화를 다섯 살 루나에게 필요한 낱말로 한 번 더 좁혀요. 같은 시간에 읽는 낱말의 가짓수를 줄이면 낱말 하나를 만나는 횟수가 늘어요.
낱말 목록으로 동화를 거른다
먼저 타이니스토리즈 학습 글 전체에서 낱말을 세었다(sources/dense/lexicon.py). 낱말은 소문자로 바꾼 글에서 알파벳이 이어진 덩어리로 정했다.
학습 파일 전체 낱말(소문자 [a-z]+) 443,357,273 개, 서로 다른 낱말 36,778 개 (13초)
상위 2,000 낱말이 덮는 낱말 비율 96.97%, 2000번째 낱말 「zipper」 12,349 번
루나 세계 낱말 258 개 가운데 상위 2,000 밖이라 더한 것 55 개:
  art(7,276), belongs(10,949), buns(92), cakes(5,731), calc(0), … college(31), … kindergarten(109), … minjun(0), … seoyeon(0), … upstairs(7,629), wardrobe(12,271), zero(8,743)
낱말 목록 2,055 개 → …
train: 이야기 2,717,495 편 → 남김 423,430 편 (15.58%), 글 279,991,140 바이트 (파일 2,227,753,162 바이트의 12.57%)
서너 살 낱말로 썼다는 동화에 서로 다른 낱말이 3만 6천 개나 있어요?
대신 많이 쓰이는 건 몇 안 돼. 위에서 2,000 개만 골라도 글의 97% 를 덮어.
많이 쓰이는 차례로 2,000 개를 고르고, 루나의 가족과 집과 유치원을 말하는 데 필요한 낱말 가운데 2,000 등 밖인 55 개를 더해 2,055 개의 낱말 목록을 만들었다. 이야기는 고쳐 쓰지 않고, 목록 밖 낱말이 하나라도 든 이야기는 한 편 전체를 뺐더니 423,430 편이 남았다.
지식 글을 섞는다
동화가 빠진 자리에는 루나의 세계를 말하는 글을 넣는다. 가족의 사실, 집과 동네의 장소, 따져 보는 짧은 이야기, 루나 말투의 대화, 수를 세는 이야기를 딥시크에게 낱말 목록 안의 낱말만 써서 새로 쓰게 했고(sources/dense/gen_dense.py), 킨더테일즈 이야기처럼 그동안 만들어 둔 글도 같은 목록으로 걸러서 함께 넣었다. 이 글들을 묶어 지식 글이라고 부른다. 다음은 거르고 남은 한 편이다(sources/dense/filter_dense.out).
In bed, Luna heard a voice. Minjun said, 'Is it a monster?' Luna said, 'No, it is not a monster. Seoyeon is my Mommy.' Then Luna said, 'Good night, Mommy.'
지식 글 29,642 편은 거른 동화보다 훨씬 적어서 다섯 번 되풀이해 넣었고, 그렇게 해서 학습 파일 80,260,591 토큰 가운데 지식 글이 10.13% 가 되었다(sources/dense/pretrain_mix.out). 떼어 둔 337 편은 학습에 넣지 않고 처음 보는 지식 글로 시험에 쓴다.
토큰 표도 이 글에 맞춰 새로 배웠다(sources/dense/tokenizer.py). 낱말이 줄었으니 어휘도 4,096 에서 2,048 로 줄였고, 고른 BPE 로 합친 뒤에 프리트레인 글에서 가장 적게 쓰인 토큰부터 빼서 칸 수를 맞추었다.
가장 적게 쓰인 합친 토큰 160 개를 빼서 2,048 (바이트 256 + 합친 토큰 1,791 + 끝 토큰 1) | 24초
…
합친 토큰 1,791 개 쓰임(조각 무게로 센 프리트레인 글): 0 번 0 개, 100 번 미만 0 개, 1,000 번 미만 0 개. 가장 적은 20 개: '␣bra' 2,752, '␣swe' 2,765, '␣pop' 2,768, …
…
  'Luna: My Daddy is Minjun. Seoyeon is my Mommy.' → Luna : ␣My ␣Daddy ␣is ␣Minjun . ␣Seoyeon ␣is ␣my ␣Mommy .
  거른 검증 글: 2,922,476 바이트 → dense 2,048 752,567 토큰(3.883 바이트/토큰), v1d1 4,096 726,051 토큰(4.025)
합친 토큰 1,791 개 가운데 프리트레인 글에 2,752 번보다 적게 쓰인 칸은 하나도 없다. 「␣Minjun」은 학습 파일에 48,805 번, 「␣Seoyeon」은 48,000 번 나온다. 어휘를 절반으로 줄였는데도 거른 동화는 토큰 하나에 3.883 바이트가 담겨서 옛 표의 4.025 바이트와 큰 차이가 없었는데, 한 번도 안 쓰이던 칸과 목록 밖 낱말의 칸이 사라진 덕분이다.
옛 판과 빽빽한 판
이제 두 프리트레인을 나란히 학습한다. 옛 판은 어휘 4,096 의 표로 타이니스토리즈 전체를 읽고, 빽빽한 판은 어휘 2,048 의 표로 거른 동화와 지식 글을 읽는다. 모델(8층, 폭 512), 스텝 수(14,000), 학습 방법은 같고 시드는 셋이다. 토큰 표가 다른 두 모델은 손실을 그대로 비교할 수 없으므로 같은 글에 대한 바이트당 비트로 비교한다.
예측해 보자. 지식 글은 빽빽한 판이 당연히 잘 읽겠지. 읽은 적이 있으니까. 궁금한 건 처음 보는 글에서도 그런가야.

거른 동화는 빽빽한 판이 이길 것 같아. 낱말이 줄었고 같은 낱말을 더 자주 만나니까.
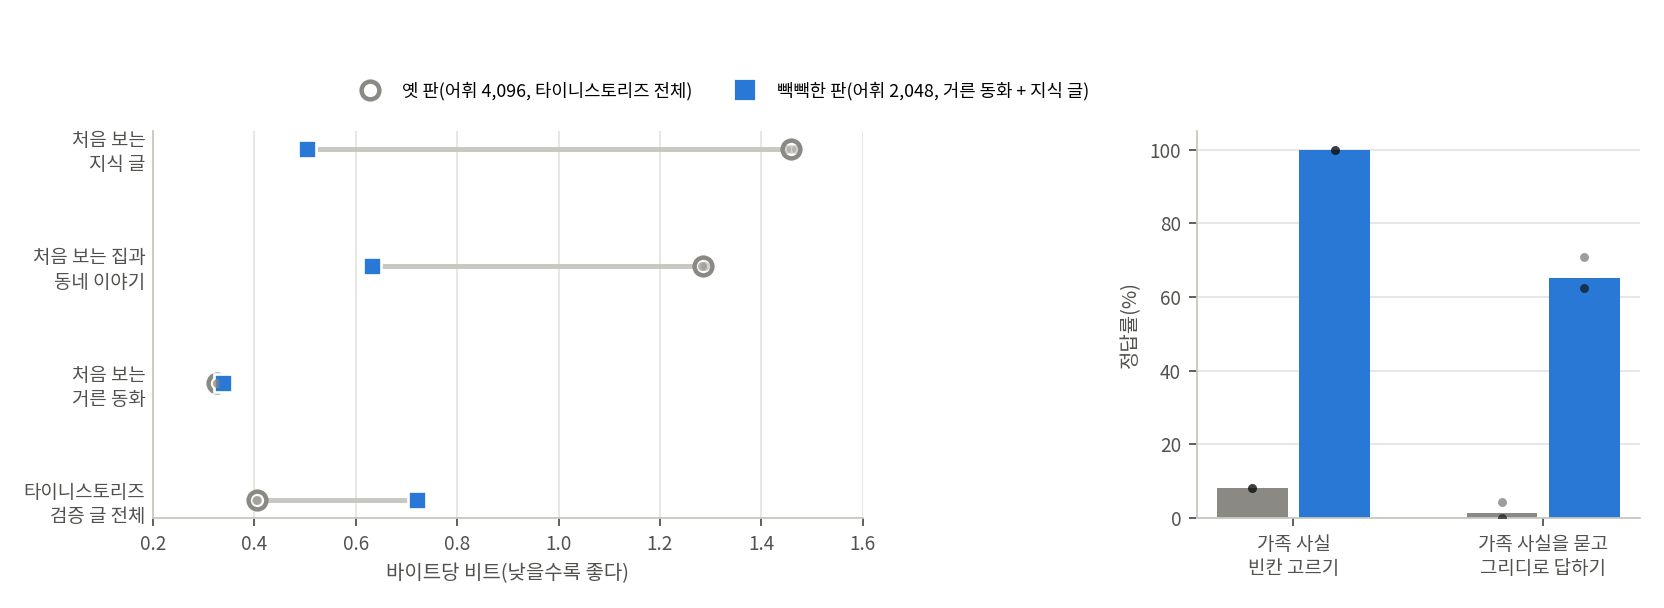
| 프리트레인만 마친 뒤 | 옛 판 | 빽빽한 판 |
|---|---|---|
| 처음 보는 지식 글 337 편(바이트당 비트) | 1.4486~1.4694 | 0.4987~0.5089 |
| 처음 보는 집과 동네 이야기 300 편(바이트당 비트) | 1.2833~1.2889 | 0.6295~0.6332 |
| 가족 사실 빈칸 고르기(1등 정답) | 8 / 8 / 8% | 100 / 100 / 100% |
| 가족 사실을 묻고 그리디로 답하기 | 0 / 4 / 0% | 62 / 62 / 71% |
| 처음 보는 거른 동화(바이트당 비트) | 0.3254~0.3265 | 0.3361~0.3376 |
| 타이니스토리즈 검증 글 전체(바이트당 비트) | 0.4039~0.4049 | 0.7158~0.7232 |
바이트당 비트는 낮을수록 좋고, 값은 시드 셋의 범위이거나 시드 하나하나다(sources/dense/runs/summary.out, 그리디 줄은 sources/mainline/runs/v1d1/P0_s*.out 과 sources/mainline/runs/dense/P0_s*.out). 빈칸 고르기는 「Luna’s Daddy is」처럼 킨더테일즈의 사실 열두 가지를 말하는 문장을 값 바로 앞까지 주고, 보기 가운데 정답에 가장 높은 확률을 주었는지를 센 것이다.
처음 보는 지식 글의 바이트당 비트는 1.45~1.47 에서 0.50~0.51 로 내려갔다. 학습에 넣지 않은 337 편이므로 외운 글을 다시 읽은 값이 아니다. 빈칸 고르기는 열두 문장을 모두 맞혔고, 물음에 답하는 법을 따로 배우지 않았는데도 「What is the name of Luna’s Daddy?」 같은 물음 스물넷 가운데 62~71% 에 맞는 답을 이어 썼다(sources/mainline/runs/dense/panel_eval_facts_P0_s1.json).
What is the name of Luna's Daddy?  →  Luna's Daddy is Minjun. My name is Minjun.\nLuna: Yes. My Daddy is Minjun.\nDaddy: Thank you, Luna.
Who is Luna's Mommy?  →  Luna's Mommy is Seoyeon. Luna calls Seoyeon Mommy. Luna said, Good night, Mommy.
What is the name of Luna's Mommy?  →  Luna's Mommy has a pet rabbit.\nDaddy: A rabbit? No, a rabbit.\nLuna: Mommy's rabbit lives in its little house in the backyard.\nDaddy: Yes.
프리트레인만 했는데 아빠 이름을 대! 옛 판은 이 단계에서 0 이었어.
셋째 줄은 엄마 이름을 물었는데 토끼 얘기를 해. 그래도 내 토끼인 건 맞네.
옛 판이 0 인 것은 프리트레인에서 가족 글을 한 편도 읽지 않았으니 당연한 일이다. 그래서 두 판에 묻는 말에 답하기를 가르치고, 킨더테일즈 이야기와 대화를 비롯한 뒤 단계의 글을 한꺼번에 섞어 6,500 스텝을 더 학습한 뒤에도 측정해 보았다. 처음 보는 지식 글의 바이트당 비트는 옛 판이 1.18~1.22, 빽빽한 판이 0.49~0.50 이었고, 빈칸의 정답에 준 확률은 81~86% 대 98~100% 였다. 가족 글을 둘 다 읽은 뒤에도 프리트레인부터 읽은 판이 앞섰다.
하나 더 측정해 본 것이 있다. 가족의 사실 하나를 주고 같은 사람의 다른 사실을 고르게 하는 물음 40 개에서 빽빽한 판은 68~90% 에서 같은 사람의 사실을 골랐는데(옛 판 48~52%), 가족이 아닌 낯선 사람에게 같은 사실을 붙여 물어도 66~82% 로 같은 답을 골랐다(sources/dense/net_contrast.out). 사실 둘을 이어서 답했다기보다 함께 나오던 낱말을 떠올린 것으로 읽어야 한다.
대가: 목록 밖의 글과 꺼내 말하기
얻은 만큼 잃은 것도 있어서, 두 판을 비교한 표의 마지막 두 줄과 뒤 단계의 값 하나를 숨기지 않고 적는다. 첫째로 타이니스토리즈 검증 글 전체의 바이트당 비트가 0.40 에서 0.72 로 나빠졌다. 검증 글의 대부분은 목록 밖 낱말이 든 이야기이고 빽빽한 판은 그런 이야기를 읽은 적이 없으니, 낱말을 줄이기로 한 순간에 치르기로 한 값이다. 둘째로 뒤 단계의 글을 섞어 학습한 뒤에 「Who is Luna’s Daddy?」 같은 물음에 그리디로 답하게 하면 옛 판이 54~62%, 빽빽한 판이 25~38% 를 맞혔다. 같은 물음을 보기 고르기로 측정하면 29~42% 대 42~54% 로 빽빽한 판이 뒤지지 않으므로, 사실이 안에서 지워진 것은 아니고 말로 꺼내는 일이 나빠진 것이다. 원인은 아직 확인하지 않았다. 아는 것과 꺼내 말하는 것을 따로 측정해야 한다는 점만 여기에 적어 두고, 루나가 대화를 다시 배울 때 그리디 정답률부터 확인한다.
민준의 예측은 빗나갔다. 처음 보는 거른 동화에서 빽빽한 판은 0.3361~0.3376 으로 옛 판의 0.3254~0.3265 보다 0.011 쯤 나빴다. 낱말이 줄었는데 왜 더 못 읽는지는 다음 절에서 푼다.
문제 3. 낱말의 97% 를 덮었는데 이야기는 16% 만 남았다
낱말 목록의 상위 2,000 낱말은 타이니스토리즈의 낱말 443,357,273 개 가운데 96.97% 를 덮는다. 이야기는 2,717,495 편이다. (가) 이야기 한 편은 평균 몇 낱말인가? (나) 낱말 하나하나가 서로 상관없이 96.97% 의 확률로 목록 안에 든다고 하면, 한 편의 모든 낱말이 목록 안일 확률은 얼마인가? (다) 실제로 남은 이야기는 15.58% 다. (나)와 왜 다른가?
(가)는 나누면 163 낱말쯤. (나)는 0.9697 을 163 번 곱하는 거니까… 계산기로 0.0066. 0.7% 밖에 안 돼.

실제는 15.58% 니까 스무 배 넘게 많이 남았어. 「서로 상관없이」가 틀린 거네.
어려운 낱말은 고르게 흩어져 있지 않아요. 기사 이야기 한 편에 knight 가 열 번 나오면, 목록 밖 낱말 열 개가 이야기 한 편에 몰려 있는 거예요.
맞아요. 드문 낱말은 몇몇 이야기에 몰려 나오고, 쉬운 낱말만으로 된 이야기도 그만큼 많아요. 그래도 여섯 편 가운데 다섯 편이 빠진 것은 큰 값이에요. 낱말 하나 때문에 이야기 한 편이 다 빠지니까요. 어떤 낱말 때문에 많이 빠지는지는 뒤에서 다시 봐요.