앞에서만 읽는 모델: A 가 B 의 아버지라면 B 는 누구의 아들일까
이 장의 물음
사람은 「톰 크루즈의 어머니는 메리 리 파이퍼다」를 알면 「메리 리 파이퍼의 아들은 톰 크루즈다」도 안다. 같은 사실을 앞에서 읽든 뒤에서 읽든 하나의 관계이기 때문이다. 그런데 2023년 가을에 나온 한 보고에서, GPT-4 는 유명인의 부모를 묻는 물음에는 79% 를 맞혔지만 같은 부모에게서 자식을 묻는 물음에는 33% 만 맞혔다. 웹 글을 거의 다 읽었다는 모델이 한 사실의 앞면만 알고 뒷면은 모르는 일이 왜 생길까?
우리 루나도 바꿔 쓴 동화로 민준과 서연에 대한 사실을 배웠지만, 그 글들은 모두 「Minjun had a pet turtle」처럼 이름을 먼저 말하고 사실을 뒤에 말했다. 이 장은 같은 사실을 거꾸로 물으면 어떻게 되는지 측정해 보고, 그 원인을 다음 토큰을 맞히는 학습과 마스크에서 찾는다.
- 「X is the father of Y.」만 읽은 모델은 「Y is the son of」 다음에 X 를 쓸 수 있을까?
- 같은 사실을 여러 문장으로 바꿔 써 주면 거꾸로 묻는 물음도 나아질까?
- 한 방향만 배우는 일은 학습의 어디에서 생길까? 마스크와는 어떤 관계일까?
- 거꾸로 쓴 문장을 데이터에 넣으면 고쳐질까? 일부만 넣으면 나머지도 따라올까?
- 관계를 표로 적으면 두 방향이 다 들어 있는데, 루나는 왜 한 방향으로만 조회할까?
역전 저주: 서연이 쿠키를 준 건 아는데, 받은 사람에게 물으면 모른다
바꿔 쓴 동화로 학습한 루나가 민준의 거북이와 서연의 토끼를 맞히자, 민준은 신이 나서 데이터에 넣을 사실을 더 적기 시작했다. 서연은 그 목록 맨 아래에 한 줄을 조용히 보탰다. 「Seoyeon gave Minjun a cookie.」
쿠키? 너 요즘 안 굽잖아.

…동화니까. 동화에서는 줘도 돼.

그럼 이 한 줄만 넣지 말고 선물 이야기를 마흔 개쯤 만들자. 이름 하나로 시험하면 맞혀도 우연인지 모르니까.

사실을 늘릴 거면 관계를 양쪽에서 부르는 말이 분명한 것도 같이 넣어 봐요. 아버지와 아들처럼요. 「누구의 아버지」를 읽힌 다음 「누구의 아들」로 물어볼 수 있게, 지어낸 이름으로 이백 쌍쯤.
이 장이 끝나면 루나는 「Minjun got a cookie from」 다음에 Seoyeon 을 쓰게 되고, 우리는 그러려면 학습 글에 무엇이 들어 있어야 하는지를 숫자로 알게 된다.
한 방향으로만 적은 사실 240 개
실험의 사실은 두 묶음이다. 지어낸 이름 400 개로 아버지와 아들 200 쌍을 만들고(「Fenwick Sallow is the father of Emrys Wexley.」), 지어낸 이름 80 개가 한 번씩 주고받는 선물 40 건을 만들었다(「Seoyeon gave Minjun a cookie.」가 그 가운데 하나다). 이름은 모두 학습 글에 거의 없는 것이라, 루나가 이 관계를 맞히려면 우리가 넣은 문장에서 배워야 한다. 문장은 모두 한 방향, 아버지나 준 사람을 먼저 적었다.
학습은 바꿔 쓴 동화를 가르칠 때와 같은 방식이고, 배치에서 사실 글이 차지하는 줄만 4 줄에서 8 줄로 늘렸다. 동화 GPT(8층, 파라미터 2,760만 개)를 1,000 스텝 이어서 학습하는데, 스텝마다 배치 32 줄 가운데 8 줄은 사실 문장을 여덟 개씩 이어 붙인 글에서 자르고 24 줄은 타이니스토리즈에서 자른다. 공용 모듈 sources/common/continue_train.py 가 두 데이터를 섞는다.
# sources/common/continue_train.py 의 train_mixed 에서 (발췌)
x1, y1 = T.get_batch(ts_tokens, B - n_custom, Tlen, gen, "cpu")   # 타이니스토리즈 24 줄
x2, y2 = custom_batch(stream, n_custom, Tlen, gen)                # 사실 문장 글 8 줄
x, y = torch.cat([x1, x2]), torch.cat([y1, y2])
물어보는 방법도 같다. 시작 문장 뒤에 후보 이름을 하나씩 붙여 모델이 그 이름에 준 로그 확률을 계산하고, 가장 큰 후보를 루나의 답으로 본다. 아버지를 묻는 물음의 후보는 아버지 200 명 전부, 아들을 묻는 물음의 후보는 아들 200 명 전부라서, 아무렇게나 고르면 0.5% 를 맞힌다. 선물은 후보가 40 명이라 2.5% 다.
# sources/common/continue_train.py 의 rank_answer 에서 (발췌)
scores = logprob_of(model, tok, prompt, candidates, dev)       # 후보마다 로그 확률의 합
order = sorted(range(len(candidates)), key=lambda i: -scores[i])
rank = order.index(candidates.index(correct)) + 1                # 1 이면 정답이 1등
시드 0 으로 학습한 루나의 결과다(sources/reversal/run.out).
## 조건: forward
  사실 문장 240 개. 예: Gemma gave Gus a shell.
  [forward 시드 0]
    아버지→아들 (학습 문형)               정답률 100.0%  평균 순위    1.0 / 200
    아버지→아들 (새 문형)                정답률   7.5%  평균 순위   35.1 / 200
    아들→아버지 (거꾸로 문형)              정답률   1.0%  평균 순위  107.9 / 200
    아들→아버지 (새 문형)                정답률   0.0%  평균 순위  103.5 / 200
    준 사람→받은 사람                   정답률 100.0%  평균 순위    1.0 / 40
    받은 사람→준 사람 (거꾸로 문형)          정답률   5.0%  평균 순위   20.3 / 40
    받은 사람→준 사람 (물음)              정답률   2.5%  평균 순위   21.9 / 40
「Fenwick Sallow is the father of」 다음에 아들 이름을 쓰는 물음은 200 쌍을 모두 맞혔고, 선물도 「Seoyeon gave」 다음의 받은 사람을 40 건 모두 맞혔다. 학습한 문장 그대로 앞부분을 주면 뒷부분을 다 외워 쓴다. 그런데 「Emrys Wexley is the son of」 다음에 아버지를 쓰는 물음은 200 쌍 가운데 두 쌍(1.0%)만 맞혔고, 정답 아버지의 평균 순위는 200 명 가운데 107.9 등이었다. 아무렇게나 고른 이름의 평균 순위가 100.5 등이니, 루나는 정답 아버지를 다른 아버지들보다 조금도 그럴듯하게 보지 않는다. 시드 1·2 도 거꾸로 묻는 물음은 0.5%, 0.0% 였다.
서연의 쿠키도 같아서, 그리디 선택으로 이어 쓰게 하면 이렇게 나온다.
    「Seoyeon gave」 다음 이름 위 셋: Minjun 0.797, Maeve 0.071, Hana 0.018
    그리디 이어 쓰기 「Seoyeon gave」 → ' Minjun a cookie. Dashiell D'
    그리디 이어 쓰기 「Minjun got a cookie from」 → ' the kitchen. It was a big cookie with lots of sweet'
부엌에서 받았대. 큰 쿠키에 단 게 잔뜩 들었고. 서연이는 어디 갔어?
「Seoyeon gave」 다음엔 Minjun 을 0.797 로 쓰는데, 「Minjun got a cookie from」 다음엔 내 이름이 위 셋에도 없어.

같은 문장인데 왜 한쪽만 알지. 루나 입장에선 주는 사람만 기억에 남은 건가.
…앞에서만 읽는구나.

응, 그렇지. 다음 토큰만 맞히니까. 근데 그게 왜 거꾸로를 막는지는 아직 잘 모르겠어.
서연은 대답하지 않고 공책의 「Seoyeon gave Minjun a cookie.」 옆에 작은 점 하나를 찍었다.
역사: 같은 가을의 두 보고
2023년 9월, 서로 다른 두 연구진이 같은 현상을 며칠 차이로 아카이브에 올렸다. 먼저 9월 21일에는 루카스 베르글룬드(Lukas Berglund) 팀이 「역전 저주: 'A 는 B 다’로 학습한 LLM 은 'B 는 A 다’를 배우지 못한다(The Reversal Curse: LLMs trained on “A is B” fail to learn “B is A”)」를 올렸다. 교신 저자는 옥스퍼드의 오웨인 에번스(Owain Evans)였다. 그들은 GPT-4 로 지어낸 유명인 30 명의 설명을 만들고(「Daphne Barrington is the director of ‘A Journey Through time’」), 문장마다 바꿔 쓴 글 30 개를 더해 GPT-3 를 파인튜닝했다. 설명을 먼저 적고 이름을 뒤에 적은 묶음은 설명을 주고 이름을 물으면 96.7% 를 맞혔지만, 이름을 주고 설명을 물으면 0.1% 였다. 정답 이름에 준 로그 확률도 아무 이름에 준 것과 차이가 없었고, 이 결과는 모델 크기와 계열을 바꿔도 같았다. 바꿔 쓴 글을 더해도 나아지지 않았는데, 바꿔 쓴 글이 늘 원래 문장과 같은 순서로 이름과 설명을 적었기 때문이다.
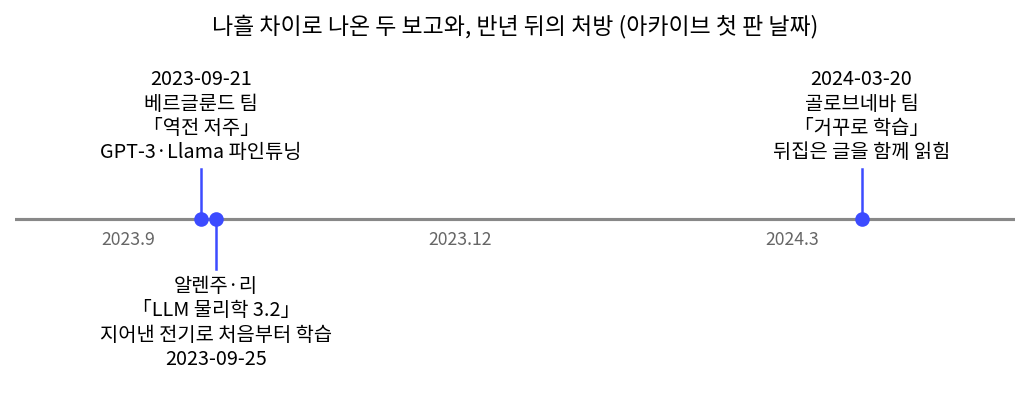
나흘 뒤 메타의 제위안 알렌주와 아부다비 무함마드 빈 자이드 인공지능 대학의 위안즈 리는 「언어 모델의 물리학」 연작의 3.2부 「지식 다루기」를 올렸다. 그들은 바꿔 쓰기 때 본 지어낸 사람 10 만 명의 전기로 GPT-2 형태의 모델을 처음부터 학습한 뒤, 「1996년 10월 2일에 태어난 사람의 이름은?」처럼 사실에서 사람을 찾는 물음을 던졌다. 초록의 말로 그 정답률은 「프롬프트와 상관없이 사실상 0%」였고, 데이터에서 이름을 전기의 뒤쪽으로 옮겨 지식의 순서를 실제로 뒤집었을 때만 나아졌다. 큰 모델도 마찬가지여서, GPT-4 는 『오만과 편견』의 한 문장을 주면 다음 문장을 65.9% 맞혔지만 앞 문장은 0.8% 맞혔다.
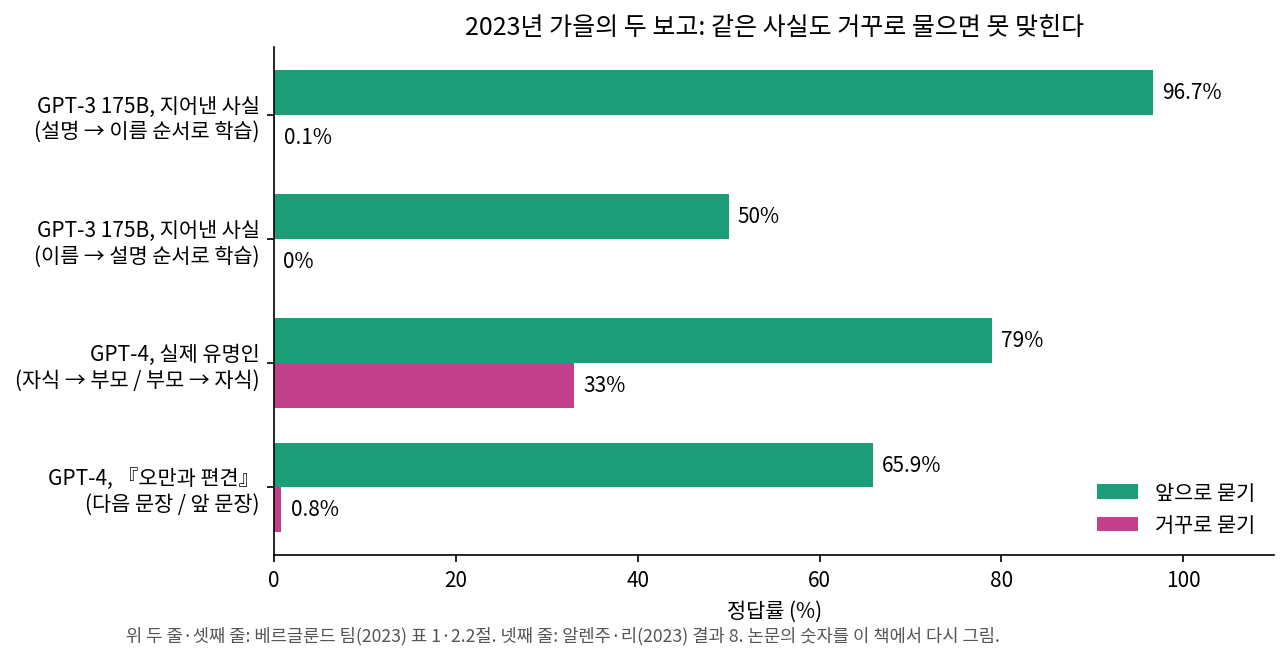
알렌주와 리는 각주에서 같은 시기의 베르글룬드 팀이 이 현상을 「역전 저주」라 불렀다고 적었다. 이 책도 그 이름을 쓴다. 학습 글에 「A 는 B 다」 순서로만 나온 사실을 「B 는 A 다」 순서로 물으면 맞히지 못하는 일을 역전 저주 (한 방향으로만 배운 사실 / reversal curse)라 한다. 베르글룬드 팀은 초록에 하나를 더 적었다. 「A 는 B 다」가 학습 글이 아니라 시작 문장(문맥) 안에 있으면, 모델은 거꾸로 된 관계를 이끌어 낼 수 있다는 것이다.
ML에서: 우리 루나가 보인 것
우리 실험은 베르글룬드 팀과 크기가 많이 다르다. 모델은 GPT-3 175B 의 6,000분의 1 정도이고, 사실은 240 개, 학습은 1,000 스텝이다. 그래도 세 가지가 같았다. 학습한 순서로 물으면 거의 다 맞혔고, 거꾸로 물으면 우연 수준이었으며, 정답에 준 확률도 다른 후보보다 높지 않았다(평균 순위 107.9 / 200). 정보가 루나 안에 없어서 못 맞힌 것은 아니다. 「Fenwick Sallow is the father of」를 주면 「Emrys Wexley」를 200 쌍 모두 쓰니, 두 이름이 이어져 있다는 정보는 파라미터 어딘가에 있다. 그 정보가 한 방향으로만 꺼내진다.
문제 1. 노래 가사의 앞 줄
자주 부르는 노래의 한 줄을 누가 불러 주면 다음 줄은 바로 이어 부를 수 있다. 그런데 같은 줄을 주고 「그 앞 줄은?」이라고 물으면 한참 걸리거나 처음부터 다시 불러야 한다. (가) 두 물음에 쓰는 정보는 같은가? (나) 처음부터 다시 부르면 앞 줄을 찾을 수 있는 이유는 무엇인가? (다) GPT-4 가 『오만과 편견』의 다음 문장을 65.9%, 앞 문장을 0.8% 맞힌 것과 무엇이 닮았는가?
(가)는 같아. 두 줄이 붙어 있다는 사실 하나니까.
근데 꺼내는 방향이 다르잖아. 나는 노래를 늘 앞에서 뒤로만 불렀어. 「이 줄 다음은 저 줄」은 수백 번 연습했는데 「이 줄 앞은 저 줄」은 한 번도 안 해 본 거지.
그럼 (나)는요? 앞 줄은 연습하지 않았는데 처음부터 부르면 찾아지잖아요.

처음부터 부르면 다시 앞에서 뒤로 가니까요. 연습한 방향으로 걷다가 주어진 줄이 나오면 바로 앞에 부른 게 답이에요. 정보를 거꾸로 꺼낸 게 아니라, 앞에서부터 다시 꺼내면서 주어진 줄을 찾은 거예요.

그럼 (다)도 같은 모양이네. 다음 문장은 연습한 방향이고 앞 문장은 아니야. 그런데 GPT-4 는 왜 처음부터 다시 읽지 않았을까? 소설 전체를 외우고 있을 텐데.
좋은 데를 짚었어요. 사람은 처음부터 다시 부르는 방법을 스스로 생각해 내지만, 모델은 한 번 앞으로 계산해서 다음 토큰 하나를 내놓을 뿐이에요. 처음부터 다시 읽는 일은 누가 시키지 않으면 일어나지 않아요. 이 두 사실을 기억해 두고, 루나 안에서는 무엇이 한 방향만 만드는지 보러 가요.
문제 2. 1.0% 는 조금 아는 것인가
한 방향으로만 학습한 루나(시드 0)는 「Y is the son of」 다음의 아버지를 200 쌍 가운데 두 쌍(1.0%) 맞혔고, 시드 1 은 0.5%, 시드 2 는 0.0% 였다. 학습하기 전 동화 GPT 는 같은 물음에서 0.5% 였다. (가) 루나는 거꾸로 된 관계를 「조금은」 배웠다고 말할 수 있는가? (나) 정답률 말고 무엇을 보면 판단할 수 있는가?
시드 0 은 학습 전보다 두 배야. 0.5% 에서 1.0% 로. 거꾸로도 아주 조금은 스며든 거 아닐까?
200 쌍에서 하나 맞히던 게 둘이 된 거잖아. 아무렇게나 골라도 200 쌍이면 한 쌍쯤은 맞고, 운 좋으면 둘도 맞아. 시드 2 는 0 이고.
그래서 하나 더 적어 두었어요. 평균 순위를 보면요?
107.9, 106.0, 106.6. 아무렇게나 고르면 100.5 인데 오히려 조금 뒤쪽이네요. 스며들었으면 정답이 앞으로 와야 하는데, 비슷하거나 더 뒤예요.

맞힌 개수가 아주 적을 때는 우연과 구별이 안 돼요. 그래서 정답 하나를 맞혔는지보다, 정답에 준 확률이 다른 후보들과 비교해 어디쯤인지를 봐요. 베르글룬드 팀이 정답 이름과 아무 이름의 로그 확률을 비교한 것도 같은 이유예요. 여기서는 「거꾸로 된 관계는 배운 흔적이 없다」까지 말할 수 있어요.