앞에서만 읽는 모델: A 가 B 의 아버지라면 B 는 누구의 아들일까
왜 한 방향만 배우나: 다음 토큰 학습과 마스크
루나는 「Seoyeon gave Minjun a cookie.」를 수백 번 읽었다. 그런데 문장을 읽는 동안 루나가 한 일은 토큰마다 다음 토큰을 맞히는 것뿐이었다. 그 맞히기들 가운데 어느 것이 「Minjun 을 보고 Seoyeon 을 떠올리기」를 연습시켰을까? 문장의 손실을 토큰마다 나눠 적어 보면 답이 보인다.
한 이름을 보고 다른 이름을 맞히는 항은 셋째 항 하나뿐이고, 그 항은 앞의 Seoyeon 을 보고 뒤의 Minjun 을 맞히는 확률이다. Seoyeon 은 첫째 항에서 앞에 아무것도 없는 채로 맞혀야 하고, 그때 루나는 뒤에 올 Minjun 을 볼 수 없다. 다음 토큰을 맞히는 동안 뒤 토큰을 보면 정답을 미리 보게 되므로, GPT 를 만들 때 어텐션 점수 표의 뒤쪽 칸을 −∞ 로 바꾸는 마스크를 씌워 두었기 때문이다. 그래서 그래디언트는 「Seoyeon … 다음에 Minjun」을 강하게 만드는 쪽으로만 흐르고, 「Minjun … 다음에 Seoyeon」을 강하게 만드는 항은 손실에 한 번도 나타나지 않는다.
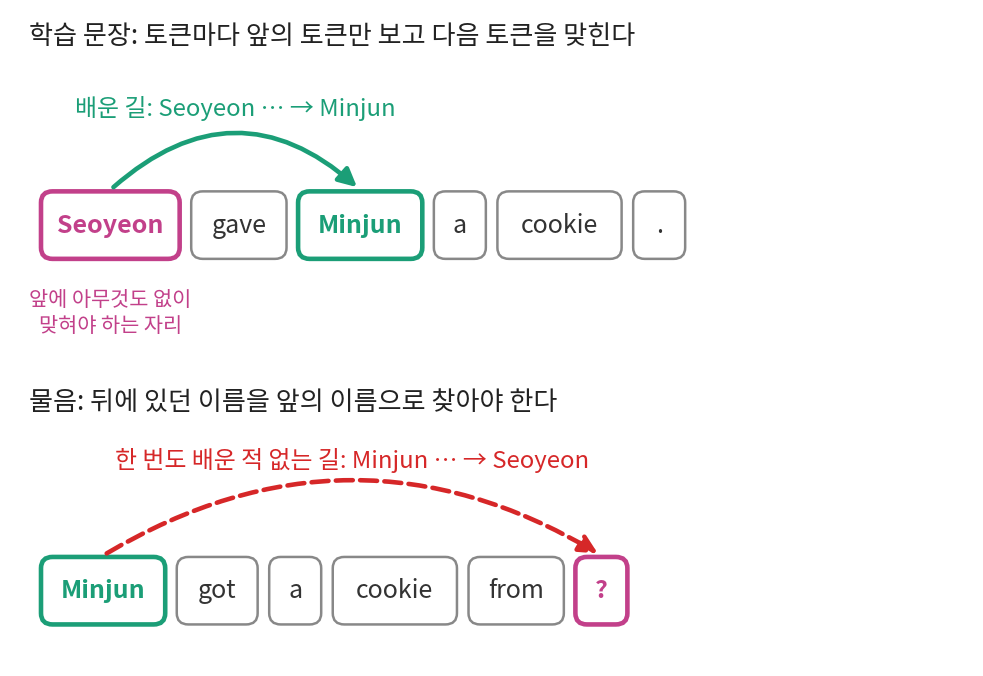
물음 「Minjun got a cookie from」에 답하려면 루나는 Minjun 을 읽은 뒤 Seoyeon 을 써야 한다. 이 계산은 학습 문장의 어느 자리에도 없었다. 「Seoyeon 다음에 Minjun」과 「Minjun 다음에 Seoyeon」은 같은 사실을 담고 있지만, 루나에게는 서로 다른 두 조건부 확률이다.
그럼 루나는 「Minjun 다음에 Seoyeon」을 한 번도 연습한 적이 없는 거네. 사실은 알고 있는데.

아는 게 아니라 한쪽 방향으로만 이어 쓸 줄 아는 거지.

예전 수업에서 조건을 뒤집으려면 숫자가 더 필요하다고 했죠. 루나는 p(Minjun ∣ Seoyeon gave) 를 배웠어요. 거꾸로 묻는 물음은 p(Seoyeon ∣ Minjun got a cookie from) 이고요.

검사 회사 숫자만으로는 양성인 사람이 환자일 확률을 못 구했던 것처럼, 한 방향 확률만으로는 반대 방향이 안 나온다는 거죠.
그래요. 그리고 루나는 그 뒤집는 계산을 해 본 적도 없어요. 다음 토큰의 확률표를 앞 글에서 바로 내놓도록만 배웠으니까요.
사실이 학습 글이 아니라 시작 문장 안에 있으면요? 「Seoyeon gave Minjun a cookie.」를 앞에 두면 그 뒤의 Minjun 자리에서 어텐션이 앞의 Seoyeon 을 볼 수 있잖아요.
베르글룬드 팀이 초록에 적은 경우예요. GPT-3 에 사실 하나와 예시 셋을 주면 거꾸로도 96.67~100 을 맞혔어요. 우리는 시작 문장에 사실을 넣어 주지 않아도 루나가 답하게 하고 싶으니, 학습 글을 고쳐 봐요.
문제 3. 손실 항 가운데 두 이름이 함께 든 것
학습 문장 「Seoyeon gave Minjun a cookie.」의 손실을 토큰마다 쓴 항으로 나눈다(이름은 한 토큰으로 친다). (가) 항은 모두 몇 개인가? (나) Seoyeon 과 Minjun 이 함께 든 항은 몇 개이고, 각각 어느 이름이 조건 쪽에 있는가? (다) 같은 문장을 거꾸로 쓴 「Minjun got a cookie from Seoyeon.」을 더하면 (나)의 답이 어떻게 바뀌는가?
(가)는 토큰 여섯 개라 여섯 항이야. Seoyeon, gave, Minjun, a, cookie, 마침표.

(나)는 Minjun 을 맞히는 항부터 그 뒤의 a, cookie, 마침표를 맞히는 항까지 넷이야. 넷 다 앞 글에 Seoyeon 이 있으니까.
그 넷 가운데 이름을 맞히는 항은요?
아, 「a」랑 「cookie」랑 마침표는 Seoyeon 과 Minjun 을 둘 다 조건 쪽에 두고 다른 토큰을 맞히는 거예요. 이름을 맞히는 항은 p(Minjun ∣ Seoyeon gave) 하나고, 거기서 Seoyeon 은 늘 조건 쪽이에요.
그럼 (다)는 새 문장에 p(Seoyeon ∣ Minjun got a cookie from) 이 생겨. 처음으로 Minjun 이 조건 쪽에 있고 Seoyeon 을 맞혀야 하는 항이야.
그래요. 거꾸로 묻는 물음에 필요한 항이 손실에 들어오려면, 그 순서로 적힌 문장이 학습 글에 있어야 해요. 그 문장을 넣으면 숫자가 어떻게 달라지는지 다음 실습에서 봐요.
문제 4. 학습할 때 마스크를 벗기면
민준이 제안한다. 「마스크 때문에 Seoyeon 자리에서 Minjun 을 못 보니까, 학습할 때만 마스크를 벗기면 Seoyeon 자리도 Minjun 을 보고 배울 수 있잖아.」 (가) 마스크를 벗기고 다음 토큰 손실로 학습하면 Seoyeon 자리의 어텐션은 무엇을 볼 수 있는가? (나) 그렇게 학습한 모델은 글을 쓸 때 어떻게 되는가?
(가)는 문장 전체를 볼 수 있어요. Seoyeon 자리에서 gave, Minjun, cookie 까지 다요.
그 자리에서 맞혀야 하는 토큰은 무엇이었죠?

다음 토큰인 gave 요. 근데 gave 가 바로 옆에 보이네요. 그럼 맞히는 게 아니라 옆에서 베끼는 거잖아요.
손실은 금방 0 에 가까워지겠다. 모든 자리에서 정답이 한 칸 옆에 있으니까. 그런데 글을 쓸 때는 다음 토큰이 아직 없으니 베낄 데가 없어.

그래요. 마스크를 처음 씌운 이유가 그거였어요. 학습 때 정답을 보면 쓸 때 쓸모없는 것을 배워요. 그러니 마스크는 그대로 두고, 루나가 읽는 글 쪽을 바꿔야 해요.
그럼 거꾸로 쓴 문장을 데이터에 넣는 수밖에 없겠네요. 이백사십 개를 다 손으로 쓰긴 싫은데.