데이터를 고치다: 쏠림, 중복, 바꿔 쓰기
이 장의 물음
킨더테일즈를 읽힌 루나의 학습이 돌던 저녁, 세 사람은 랩실 구석 소파로 자리를 옮겼다. 하은이 편의점에서 사 온 컵라면 셋 가운데 하나를 서연 앞에 놓자, 서연은 잠깐 망설이다 뚜껑을 열었다. 하은은 휴대폰으로 아까 받은 거북이 이야기 파일을 넘겨 보다가 고개를 갸웃했다.
근데 선배, 이야기마다 루나 친구가 나오잖아요. 이름이 거의 다 Ben 이에요. 이 동네엔 애가 Ben 하나밖에 없어요?

딥시크가 고른 이름이니까. …내일 도착하는 루나 말투 대화도 그러려나.

도착하면 바로 넣어야지.

세 보고 넣어.
서연은 설정서 공책에 내일 할 일 한 줄 「도착한 대화: 쏠림, 겹침」을 적었다. 하은이 고개를 빼고 들여다보자 서연은 공책을 조금 기울여 보여 주었다.
다음 날, 루나 말투 대화가 다 도착했다. 딥시크에게 1,400 번 주문해서 받은 대화가 거르기를 지나 11,875 개 남아 있었다. 라운지에는 축 짜는 걸 돕겠다던 하은도 와 있었다. 서연은 설정서 공책을 펴 어제 적은 줄 「도착한 대화: 쏠림, 겹침」을 노트북 옆에 놓았다.
세 보고 넣으라며. 겹침부터 볼까?

스크롤 좀 내려 봐. 「Why do we sleep?」 이게 몇 번째야?
서연이 세어 보니 같은 첫 물음이 113 번 나왔고, 「I feel sad today.」도 113 번이었다.

이거 거북이 이야기 한 편을 되풀이해 읽힌 루나랑 똑같잖아. 113 번 읽어도 하나 배우는 거.
같은 이야기 열 번은 한 번이지.

어제 말한 두 가지부터 봐요. 무엇이 너무 많이 나오는지, 무엇이 겹치는지요. 이 데이터는 우리가 주문해서 만든 거라, 고치는 것도 우리가 할 수 있어요.
이 장이 끝나면 우리는 생성한 글에서 쏠림을 세고, 그 쏠림이 루나의 이야기에 옮은 것을 확인하고, 중복을 찾아 지우고, 이야기 속 이름을 고르게 바꿔 쓴 데이터로 루나의 쏠림을 고친다.
이 장의 줄기 물음은 하나다. 루나가 넷에 하나꼴로 Tim 만 부르는 쏠림을, 데이터만 고쳐서 풀 수 있을까?
- 딥시크가 쓴 대화와 루나가 읽은 동화에는 어떤 이름이 많이 나올까?
- 데이터의 쏠림은 루나가 짓는 이야기에 그대로 옮을까?
- 「같은 대화」는 어디까지를 같다고 봐야 할까? 글자가 조금 다른 것은 어떻게 찾을까?
- 같은 물음에 답이 다른 대화는 중복일까?
- 이야기는 그대로 두고 이름만 고르게 바꾸면, 루나의 이름 쏠림이 풀릴까?
무엇이 쏠렸나: 이야기 속 이름
쏠림은 하은이 본 친구 이름부터 센다. 그러려면 먼저 무엇을 이름으로 셀지 정해야 한다. 민준은 대문자로 시작하는 낱말을 모두 이름으로 세자고 했지만, 그러면 「Will you …」의 Will 이나 문장 맨 앞의 Red 가 이름으로 잡힌다. 그래서 두 가지만 센다. 하나는 「named Tim」처럼 이야기가 이름을 처음 소개하는 문장이고, 다른 하나는 이야기나 대화마다 문장 맨 앞이 아닌 자리에 처음 나온 이름 하나다. 무엇이 이름인지는 타이니스토리즈에서 「named X」로 50 번 넘게 소개된 낱말로 정했다.
# sources/data-fix/bias.py 에서
for m in WORD.finditer(u):              # u = 이야기 한 편 또는 대화 하나
    w = m.group()
    if w in names:                      # 타이니스토리즈에서 「named X」로 50 번 넘게 나온 이름
        pre = u[:m.start()].rstrip()
        if pre and pre[-1] not in '.!?"':   # 문장 맨 앞은 건너뛴다
            first[w] += 1
            break
같은 방법으로 루나가 읽은 동화 전부(타이니스토리즈 V2, 271만 편)와 딥시크가 쓴 두 묶음에 걸었다. 하나는 곧 넣을 루나 말투 대화이고, 다른 하나는 성적표의 논리 칸을 채우려고 미리 주문해 둔 논리 이야기다. 논리 이야기는 아직 루나에게 읽히지 않았다.
## 타이니스토리즈 V2 학습 글(GPT-4)  (단위 2,717,700)
  「named X」 2,057,913 번, 서로 다른 이름 4,503, 1등 Tim 27.1%
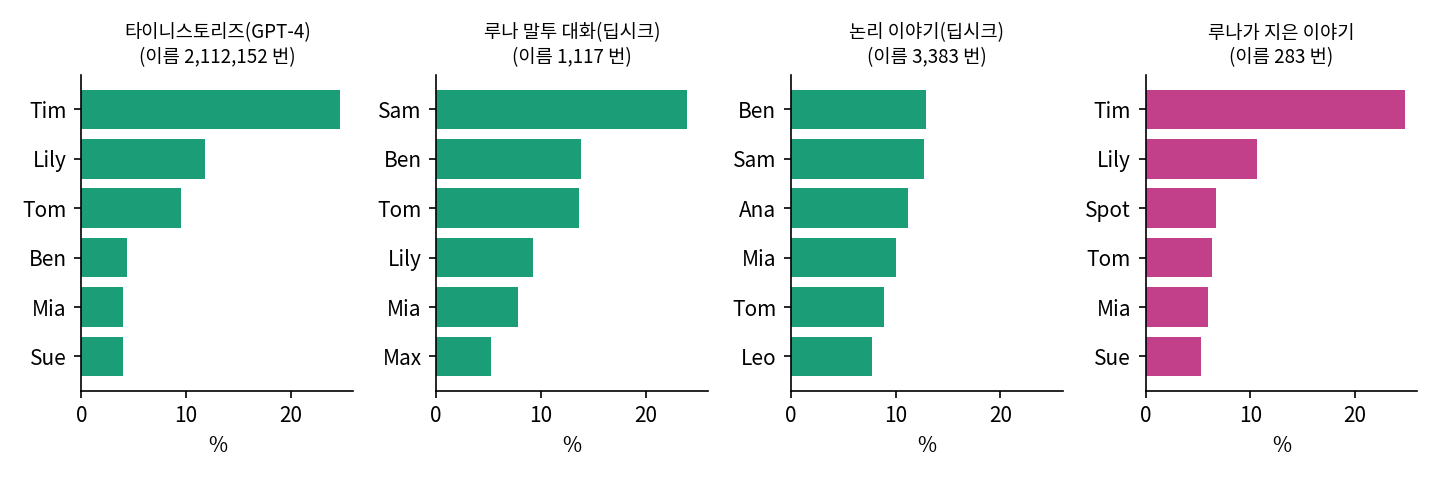
  처음 나온 이름(이름 있는 단위 2,113,487): Tim 24.6%, Lily 11.8%, Tom 9.5%, Ben 4.3%, Mia 3.9%, Sue 3.9%, Max 3.9%, Lucy 3.7%
## 일반 대화 판 2, 루나 말투(딥시크)  (단위 11,875)
  처음 나온 이름(이름 있는 단위 1,131): Sam 23.7%, Ben 13.6%, Tom 13.4%, Lily 9.1%, Mia 7.7%, Max 5.2%, Ana 4.6%, Anna 3.1%
## 논리 이야기(딥시크, 받은 만큼)  (단위 5,664)
  처음 나온 이름(이름 있는 단위 3,384): Ben 12.9%, Sam 12.7%, Ana 11.2%, Mia 10.1%, Tom 8.9%, Leo 7.7%, Lily 5.9%, Pip 5.0%
이름이 나오는 동화 넷 가운데 하나는 Tim 이 처음 나오고, 여덟 가운데 하나는 Lily 가 처음 나온다. 서로 다른 이름이 4,503 개나 있는데도 위의 셋(Tim, Lily, Tom)이 46% 를 차지한다. 타이니스토리즈는 GPT-4 가 쓴 동화이니, 이 쏠림은 GPT-4 가 아이 이야기에 넣을 이름을 고르는 습관에서 왔다. 딥시크는 다른 이름을 자주 고른다. 루나 말투 대화에서는 Sam 이 1등이고, 논리 이야기에서는 Ben, Sam, Ana, Mia 가 비슷하게 나눠 갖는다. 같은 딥시크라도 주문한 글이 대화냐 이야기냐에 따라 쏠림의 모양이 달랐다.
이름이 사천 개가 넘는데 넷 중 하나가 Tim 이야?
대화에는 Ben 이 2등이네요. 킨더테일즈 친구들이 다 Ben 이던 거랑 같은 거죠?
킨더테일즈의 Ben 도 그렇게 생겼어요. 주문서에 「이름을 고르게」라는 말이 없으면, 쓰는 모델이 자주 고르는 이름으로 채워져요. GPT-4 에게는 그게 Tim 이고, 딥시크에게는 Sam 과 Ben 이에요.
문제 1. 고양이 이름 짓기
(가) 반 친구 스무 명에게 「새끼 고양이 이름을 지어 줘」라고 하면 나비가 여덟 번 나왔다. 이 반이 기르는 고양이들의 이름은 어떤 모양이 될까? (나) 타이니스토리즈에서 이름이 처음 나오는 동화 2,113,487 편 가운데 Tim 이 24.6% 다. 이 동화만 읽은 모델에게 「이야기를 하나 해 줘」라고 백 번 물으면 Tim 이 대략 몇 번 나올 거라고 짐작할 수 있을까? (다) 딥시크가 쓴 대화에서 처음 나오는 이름은 Sam 이 23.7% 다. 이 대화로 지도 파인튜닝한 루나는 Tim 과 Sam 가운데 어느 쪽을 더 많이 쓸까?
(가)는 쉬워. 나비가 반쯤 되겠지. 이름을 짓는 사람들이 자주 고르는 이름이 고양이들의 이름이 되는 거야.

(나)는 스물다섯 번 안팎. 읽은 대로 쓸 테니까.
(다)는요?
마지막에 읽은 게 대화니까… Sam?
동화는 271만 편이고 대화에 나온 이름은 천 개를 조금 넘어. 나는 Tim.
(다)는 다음 절에서 측정한다.